大型語言模型導論
課程概述
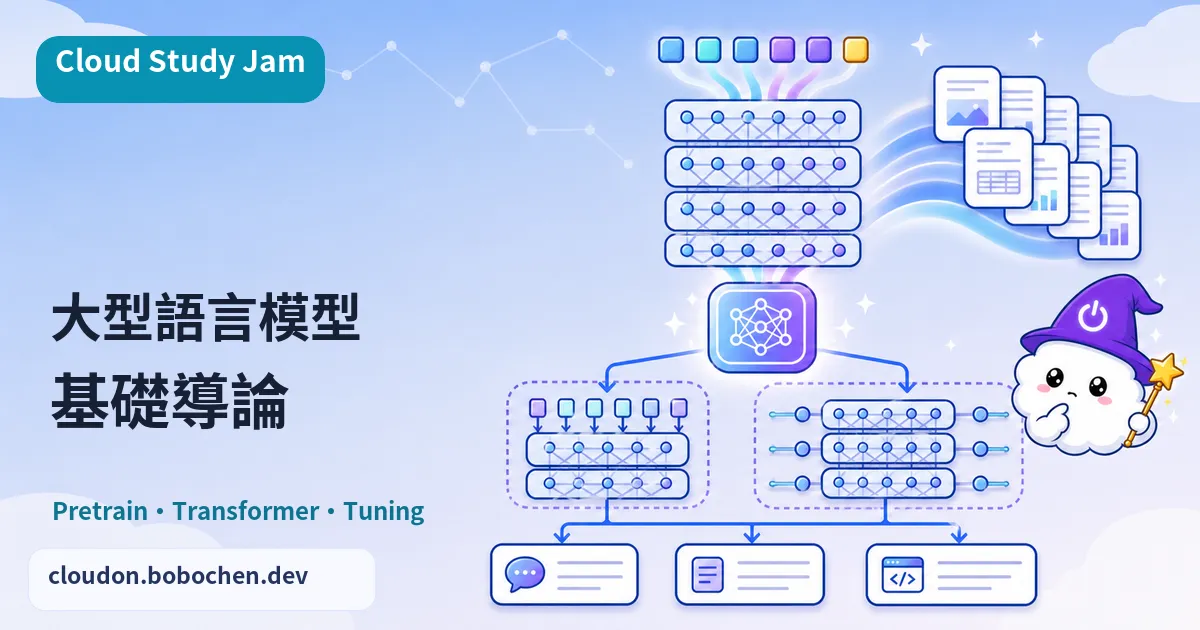
LLM 看起來像在聊天,背後卻是在依上下文預測接下來的 Token。模型先經過預訓練,實際使用時還可以靠提示或額外訓練調整表現。這篇沿著「訓練、調整、部署」的順序走一遍,釐清每個階段在改什麼。
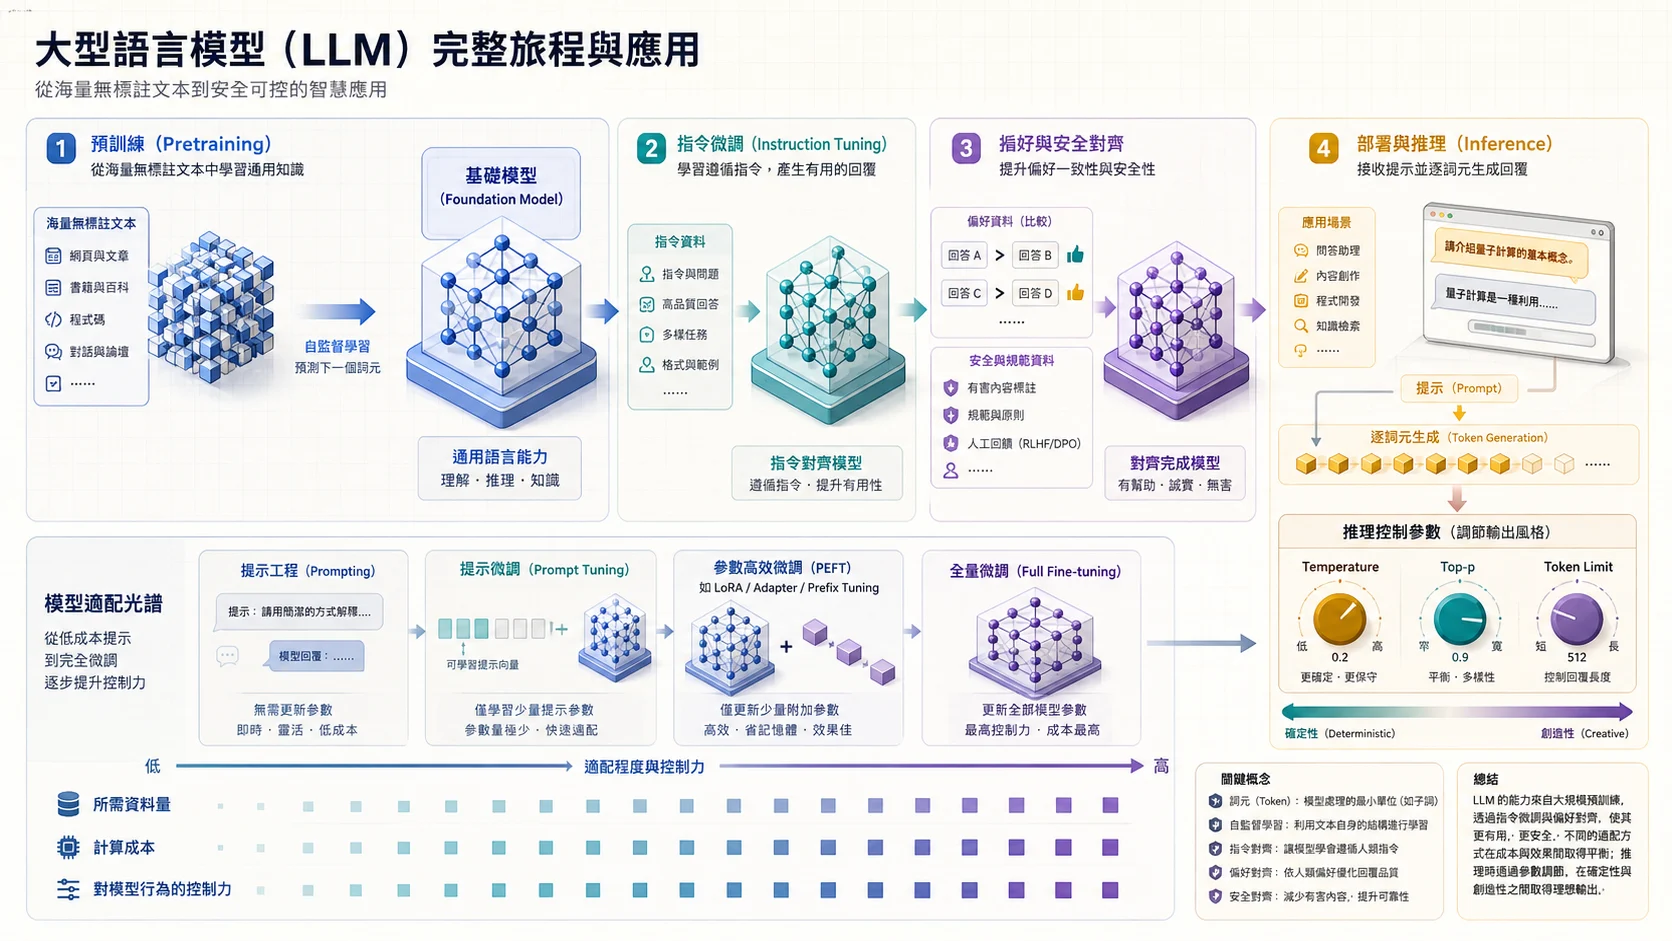
LLM 的能力來自預訓練,實用性來自指令微調,安全與偏好則在對齊階段補上。應用調整先從低成本 Prompt 開始,只有需要更強行為控制時才往 PEFT 或全量微調前進;推論參數再決定穩定與創意的取捨。
你將學到
- 說明 LLM 的訓練流程:預訓練、指令微調與 RLHF
- 區分 Prompt Tuning、Parameter-Efficient Fine-tuning 與 Full Fine-tuning
- 理解 LLM 的關鍵參數:Temperature、Top-K、Top-P 對輸出的影響
- 認識 Google Cloud 的 LLM 產品:Gemini、Model Garden 中的開源模型,以及已退役的前一代模型 PaLM 2
核心概念
LLM 的訓練三階段
LLM 的訓練通常分三個階段。第一階段是「預訓練」(Pre-training),讓模型從大量文字資料中學會語言模式。第二階段是「指令微調」(Instruction Tuning),餵它整理過的指令與回應配對,讓它比較能照需求完成任務。最後再用人類或 AI 的偏好資料做對齊,校準模型行為,盡量減少有害或有偏誤的輸出。RLHF(Reinforcement Learning from Human Feedback)就是常見做法之一。
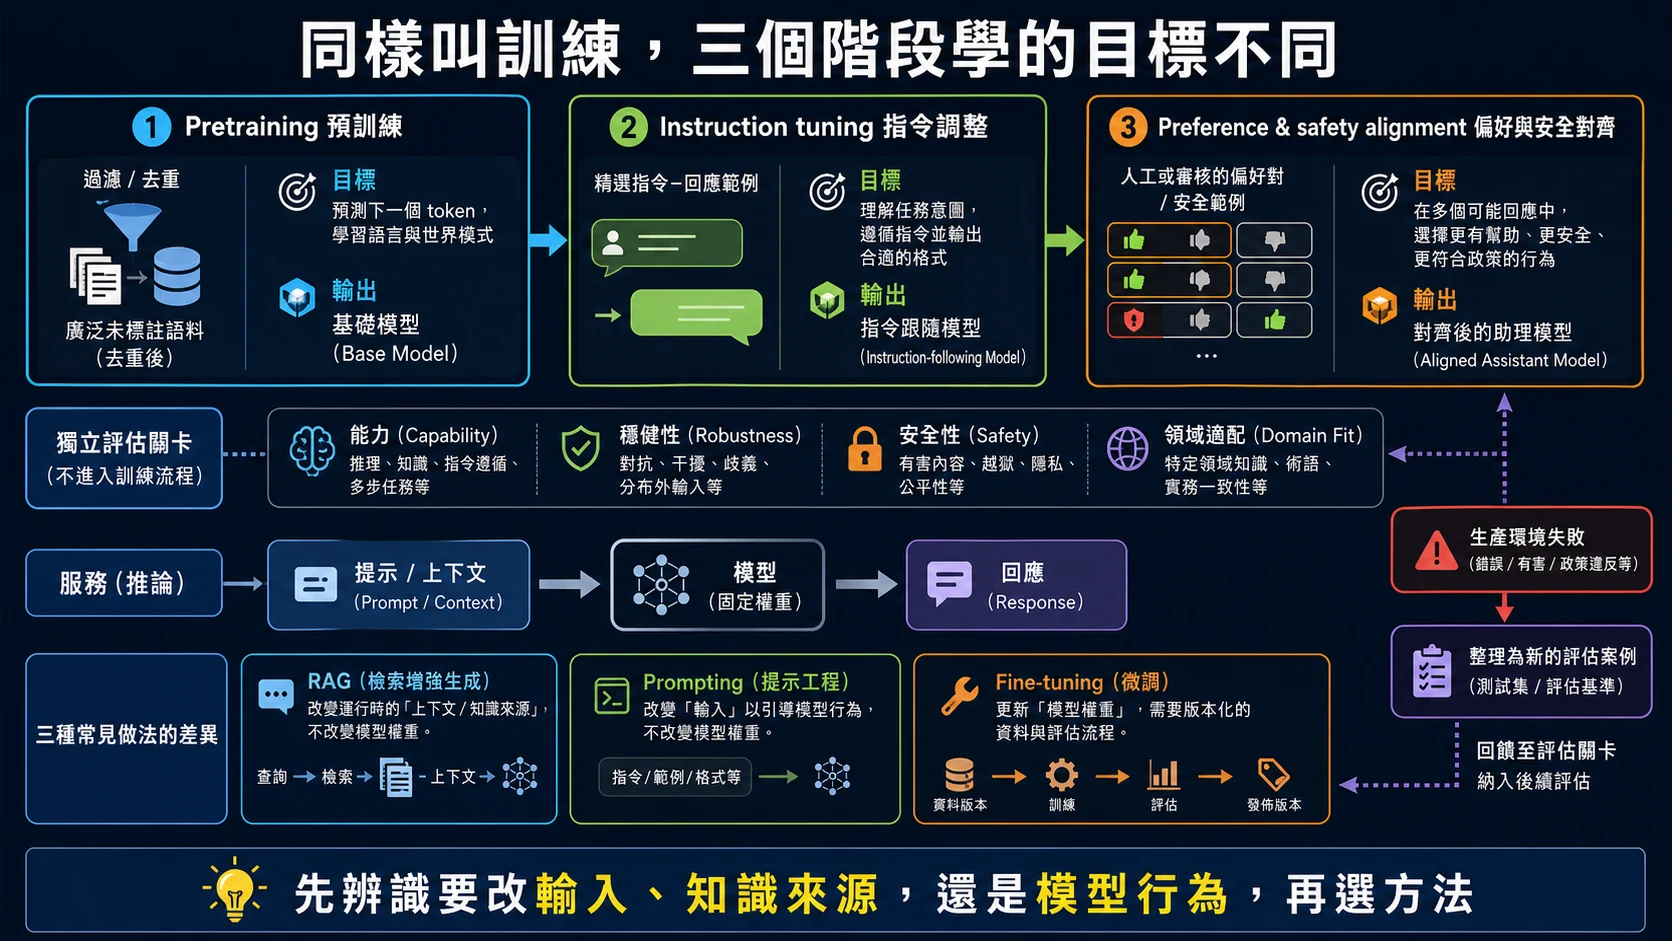
三個階段的目標不同:預訓練建立通用能力,指令微調讓模型能遵循任務,偏好與安全對齊則校準可接受的行為。Prompt、RAG 與推論參數屬於應用端調整,不應和模型訓練混為一談。
模型調整技術的光譜
從最輕量到最重量的調整方式:
| 調整方式 | 訓練資料量 | 額外訓練成本 | 適用場景 |
|---|---|---|---|
| Prompt Engineering | 不需訓練 | 無 | 一般性任務、快速原型 |
| Prompt Tuning | 依任務而定 | 低 | 特定任務的輸出風格調整 |
| LoRA / Adapter Tuning | 依任務而定 | 中 | 領域特化,保留通用能力 |
| Full Fine-tuning | 依任務而定 | 高 | 全面轉換模型行為 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
這裡的「無」只代表不用另外訓練模型,實際呼叫模型做推論仍會有用量與費用。訓練資料要準備多少沒有通用門檻:以 Gemini Enterprise Agent Platform(原 Vertex AI)的 Gemini 監督式微調為例,官方建議先從 100 筆範例開始,需要時再擴充到數千筆,並強調資料品質比數量重要;官方也說明,參數高效微調(adapter tuning)能用比全量微調小的資料集調整模型(查證日 2026-10-12)。
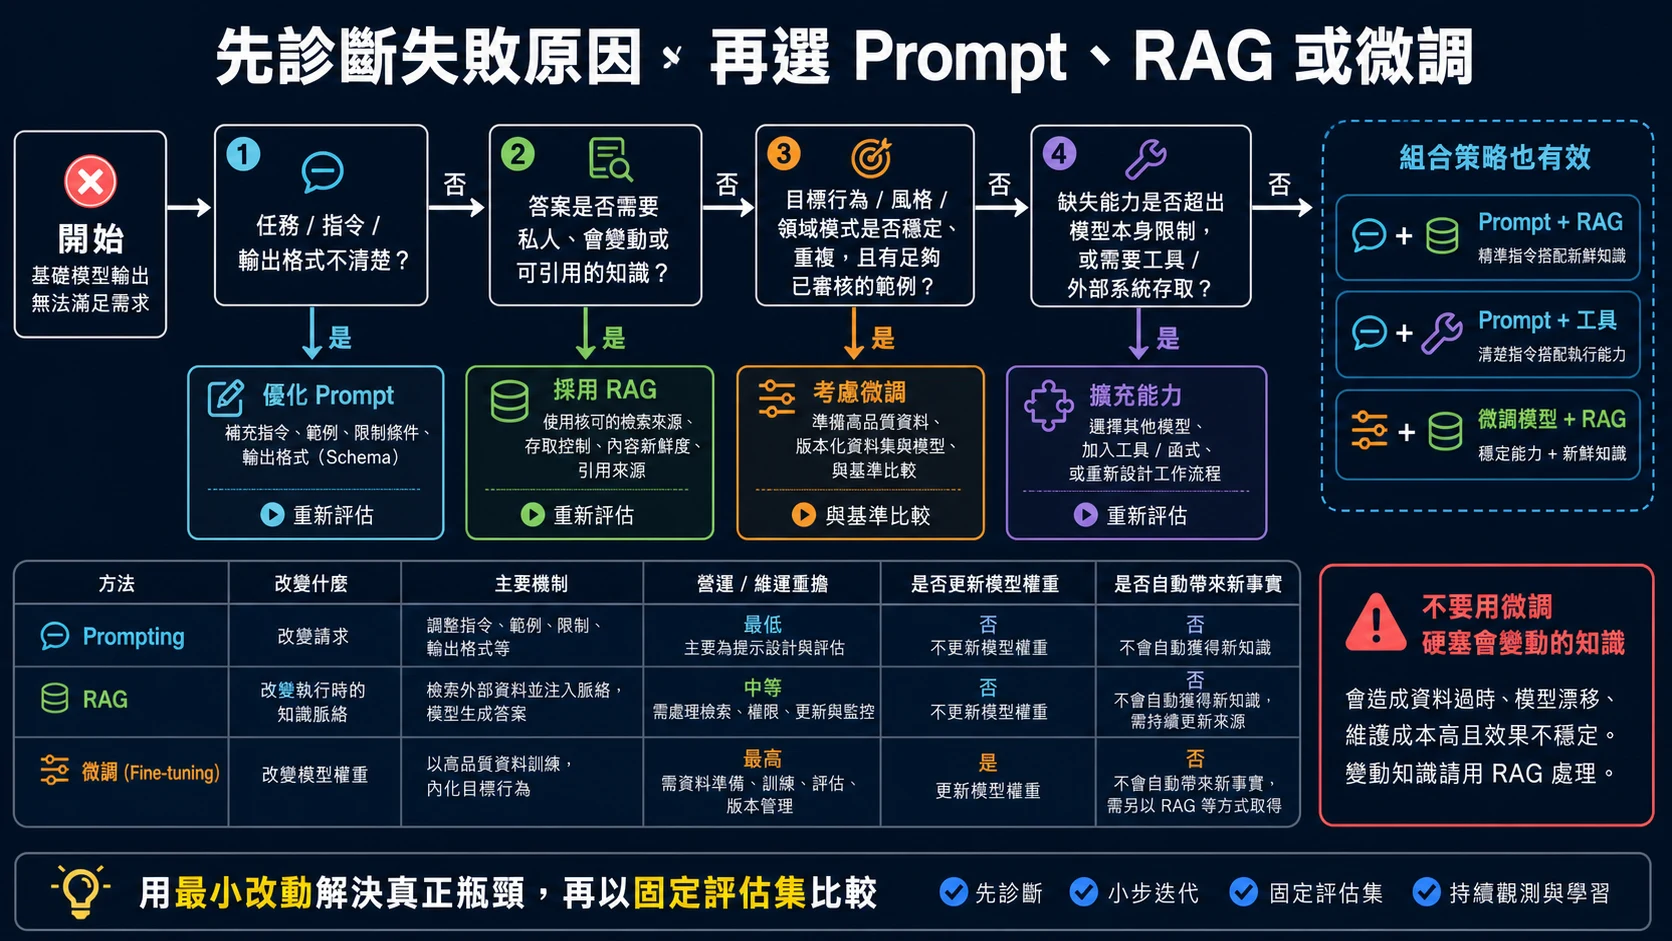
不要看到回答不好就直接微調。任務描述不清先改 Prompt;缺少最新或私有知識、需要引用時用 RAG;只有在輸入已有足夠資訊、卻仍需穩定改變模型行為時,才評估微調。
生成參數的調控
Temperature 管的是輸出有多隨機:調低通常比較穩定、保守,調高則比較有變化。Top-K 限制每次取樣時要考慮幾個候選 token,Top-P(Nucleus Sampling)則設定累積機率門檻。要特別注意,低 Temperature 只能讓答案比較穩定,不會把錯誤資訊自動變成正確答案。這三個參數是通用概念,實際能不能調要看模型:Gemini 的 Temperature 範圍是 0.0 到 2.0、預設 1.0,官方對 Gemini 3 強烈建議維持預設值,Gemini 3.6 Flash 起的 Flash 系列模型與 3.5 Flash-Lite 更會直接忽略自訂的 temperature、top-K、top-P(查證日 2026-10-12)。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32}}}%%
flowchart TB
  subgraph PREP["① 準備與預測"]
      direction LR
      INPUT["Prompt 與目前<br/>已產生內容"] --> TOKENIZE["轉成 token"]
      TOKENIZE --> MODEL["計算下一個 token<br/>的機率分布"]
  end
  subgraph SAMPLE["② 篩選與取樣"]
      direction LR
      FILTER["Top-K/Top-P<br/>縮小候選範圍"] --> TEMP["Temperature<br/>調整分布"]
      TEMP --> PICK["選出下一個 token"]
  end
  MODEL --> FILTER
  PICK --> STOP{"遇到停止條件?"}
  STOP -->|"還沒"| APPEND["把 token 接回上下文"]
  APPEND -.-> MODEL
STOP -->|"是"| RESULT["回傳完整結果"] Google Cloud LLM 產品定位
Gemini 是 Google 目前的旗艦多模態基礎模型,文字、圖片、影片、程式碼都能當輸入。PaLM 2 是前一代的旗艦文字模型,已於 2025-04-21 在當時的 Vertex AI(現稱 Gemini Enterprise Agent Platform,簡稱 Agent Platform)上退役(text-bison/Codey 等版本同步淘汰),請改用 Gemini。Model Garden 則收了第三方和開源模型(像 Llama、Mistral),可以直接在 Agent Platform 上部署。(另註:Model Garden 沿用原名、僅併入新主控台架構。課程影片若仍顯示舊名,指的是同一個產品。)
實作重點
- 在 Agent Studio(原 Vertex AI Studio)的 Model settings 面板看看所選模型提供哪些設定(依模型而定),用同一個 prompt 比較不同設定下的輸出差異。不要預期一定調得到 Temperature、Top-K、Top-P:官方模型頁列的預設值是 Temperature 1.0、Top-P 0.95,Top-K 固定為 64,Gemini 3.6 Flash 起的 Flash 系列模型與 3.5 Flash-Lite 會忽略自訂值,官方改用 thinking level 與結構化輸出控制穩定度(查證日 2026-10-12)
- 比較 Gemini Pro 與 Gemini Flash 在相同任務下的回應速度與品質(截至 2026 年中,Google 已迭代到 Gemini 3 系列,Pro/Flash 分層邏輯不變)
- 了解 Token 的概念:模型的輸入輸出通常以 Token 計算用量;實際數量取決於模型使用的 tokenizer,不要直接拿中文字數估算費用
- 注意模型的 Context Window(上下文視窗)大小,這決定了單次請求能處理的最大內容量
課程導讀
課程連結:Introduction to Large Language Models — Google Skills
依課程頁,這門課由一段影片、一份閱讀和一個測驗組成,沒有實作 Lab。重點先掌握 LLM 的幾個定義特徵(大規模訓練資料、海量參數、Transformer 架構),還有不同微調方式各自適合用在哪。做測驗前先確認自己分得出 Prompt Tuning 跟 Full Fine-tuning 差在哪,以及 Temperature 會把輸出往哪個方向帶。
延伸學習
- 概念深入:什麼是生成式 AI? — 回顧 AI 基礎概念
- 負責任的 AI 導論 — 了解使用 LLM 時的倫理考量
- Agent Platform(原 Vertex AI)Prompt 設計 — 學習如何設計有效的 Prompt
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣