GenAI 的 MLOps 實踐
課程概述
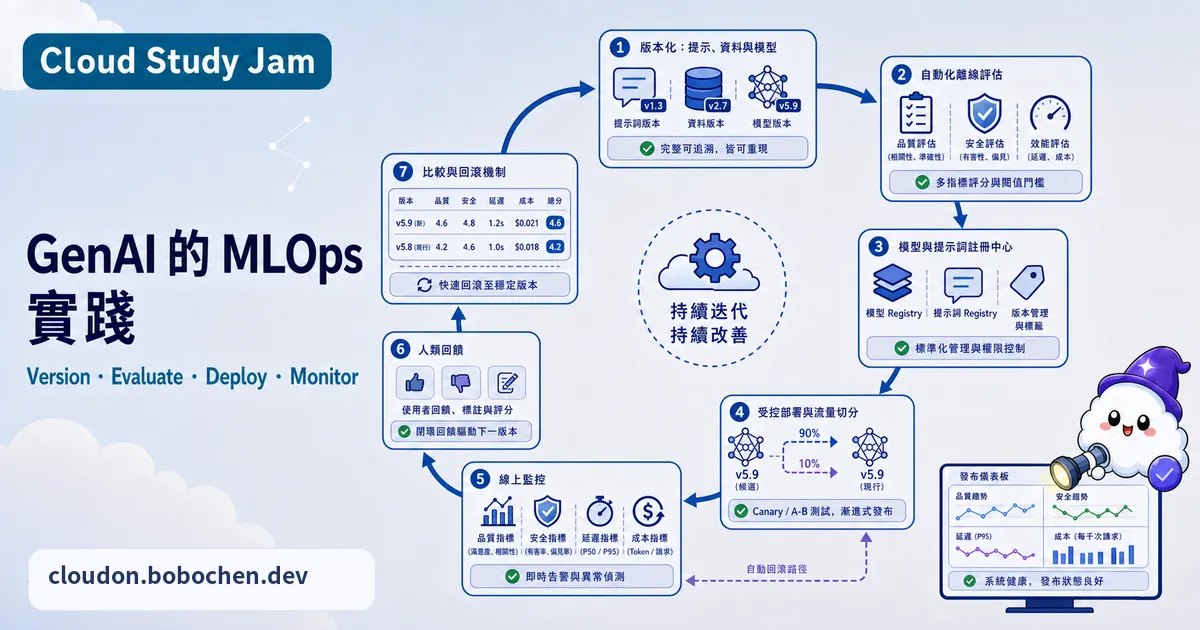
把 GenAI 應用推上線只是開始。過幾週後,可能是供應商換了模型版本、Prompt 被改過、知識庫更新不完整,或工具 API 的格式變了;使用者只會看到「回答怎麼跟昨天不一樣」。這堂課會把這些會一起影響行為的資產綁成可重現版本,再用離線評估、發布閘門、小流量上線、監控與回滾,把每次變更控制在團隊看得見的範圍內。
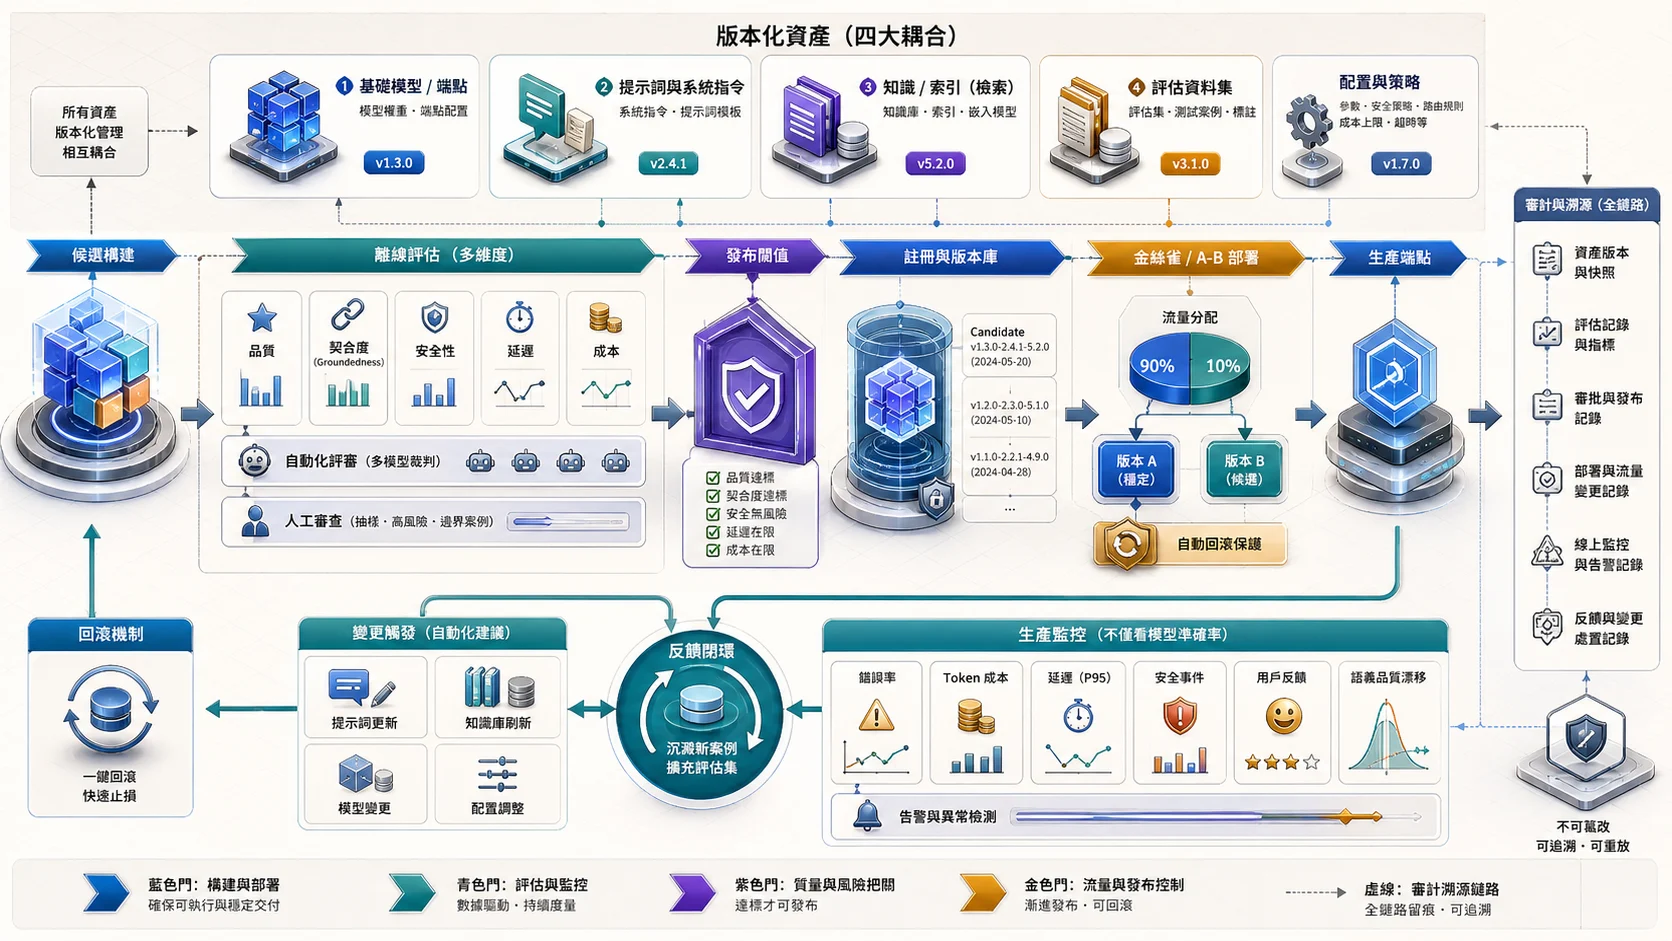
GenAI 發布的不是單一模型,而是一整組彼此牽動的設定。離線評估過閘後先小流量上線,生產環境持續看錯誤、Token 成本、延遲、安全與抽樣品質;失敗案例再回到評估集,讓下一次改版有固定基準可比。
你將學到
- 盤點一個 GenAI 版本真正需要固定的模型、Prompt、檢索、工具與政策設定
- 分清楚 Model Registry(原 Vertex AI Model Registry)、Prompt Management 與應用發布清單的責任
- 用 Agent Platform Pipelines(原 Vertex AI Pipelines)編排可重複的評估與部署工作
- 建立離線評估、人工覆核、Canary 與回滾的發布閘門
- 同時監看可靠度、品質、安全、延遲與成本,而不只看流量
核心概念
GenAI MLOps vs 傳統 MLOps
傳統 MLOps 常圍繞資料、訓練程式、模型成品與 Endpoint;GenAI 應用通常還要固定 模型 ID 與版本、System Instruction、Prompt 模板、生成參數、檢索語料與索引、Embedding 與 Chunking 設定、工具 Schema 與權限、安全政策、評估資料與評分規則。其中任何一項改變,都可能讓答案不同。正式發布時應產生一份不可變的 Release Manifest,把這些版本和應用程式 Commit 綁在一起,才知道線上到底跑的是哪一組。
Model Registry 只管模型,不會替你保存整套 GenAI 發布狀態
Model Registry是集中管理自訂模型、AutoML 與支援模型資源生命週期的地方,可建立版本、Alias、評估資訊並部署到 Endpoint。改一份 Prompt 不會自動產生 Model Registry 版本;呼叫受管 Gemini 模型時,也不能把供應商模型 ID 當成自己上傳的模型成品。
Prompt 可使用 Gemini Enterprise Agent Platform(簡稱 Agent Platform,原 Vertex AI)的 Prompt Management 保存與建立版本;官方 SDK 已提供列出與取回Prompt 版本的能力。至於模型 ID、Prompt、索引、工具、政策與程式碼的完整對應,仍建議寫進 Git 或團隊的設定/Artifact 系統。真正能回滾的,是一份可重新部署的完整清單,不只是一個 Registry Alias。
GenAI 的評估挑戰
分類模型也不該只看單一指標,而 GenAI 又多了開放式輸出的變異。評估資料要包含正常、邊界、對抗與過往事故案例,再依產品需求看正確性、相關性、Groundedness、工具呼叫、安全、格式、延遲與成本。能用程式判斷的先做 Deterministic Check,例如 JSON Schema、引用存在與工具參數;語意品質再用人工或 Judge Model 評分。
Agent Platform 的 Gen AI evaluation service 目前把評估方法分成 Adaptive rubrics(官方建議)、Static rubrics、計算式指標與自訂函式,詳見官方總覽。SDK 有兩套介面:官方建議的 GenAI Client 目前標示 Preview;較舊的 evaluation module(EvalTask,GA)仍提供 Pointwise、Pairwise 與計算式指標,但官方說明它已不再積極開發,也不支援 Adaptive rubrics。Judge Model 可以擴大測試量,但它也會有偏好、位置效應與判錯,不能直接當 Ground Truth。高風險指標應拿一批人工標註資料校準 Judge,定期檢查與人工評分的一致程度;換 Judge、Rubric 或評估 Prompt 時,也要當成評估系統改版。
Agent Platform Pipelines 自動化
Agent Platform Pipelines能以 Kubeflow Pipelines 或 TFX 定義可重複的工作,串起載入測試集、執行候選與基準版本、計算指標、保存 Artifact 和部署等步驟。Pipeline 只會照團隊寫下的規則執行,不會自己判斷風險是否可接受。低風險版本可以在門檻通過後自動進 Canary;涉及醫療、金融、人事或大範圍代理工具權限時,應在部署前加入明確的人工核准。
生產監控與告警
上線後至少要分四層看:可靠度包含錯誤率、逾時與工具失敗;品質與安全包含抽樣人工評分、引用是否足以佐證回答、拒答與安全事件;使用情況包含任務完成率、升級人工比例與申訴;成本與效能則包含延遲、Token、檢索和工具費用。按讚率與 Safety Filter 觸發率只能當訊號,前者容易有選擇偏差,後者升高也可能只是流量組成改變。
Model Monitoring(原 Vertex AI Model Monitoring)的現行文件主要處理數值與類別輸入特徵的 Skew/Drift,不能據此宣稱它會自動判斷 LLM 回答的語意品質或安全。GenAI 應用需要自己送出結構化遙測、用 Cloud Monitoring 或資料倉儲設告警,再排程抽樣評估。還要監看受管模型的版本與退場日期,因為即使應用程式沒改,底層模型生命週期仍可能逼你遷移。
A/B 測試不是所有版本的第一站
先用離線評估擋掉明顯退步,再用 Shadow 或 Canary 觀察整合、延遲與成本。只有在候選版本已達安全底線,而且把實驗曝光與停止條件寫清楚時,才適合把真實使用者隨機分到 A/B 組。涉及高風險決策、敏感資料或有副作用的工具操作時,不應為了收集偏好而讓未驗證版本直接接觸所有功能。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32, "wrappingWidth": 600}}}%%
flowchart TB
  subgraph FREEZE["① 先凍結這次候選版本"]
      direction LR
      MANIFEST["建立 Release Manifest<br/>模型、Prompt、檢索、工具與政策"] --> DATA["固定評估資料、Rubric<br/>Judge 與人工基準"]
  end
  subgraph EVAL["② 評估與發布閘門"]
      direction LR
      AUTO["跑格式、正確性、依據<br/>安全、延遲與成本檢查"] --> HUMAN["人工覆核高風險案例<br/>校準 Judge 結果"]
      HUMAN --> GATE{"必要門檻與核准<br/>都通過了嗎?"}
      GATE -->|"未通過"| HOLD["不發布,保留結果<br/>回到下一個候選版本"]
  end
  DATA --> AUTO
  subgraph RELEASE["③ 漸進上線與回復準備"]
      direction LR
      CANARY["Shadow 或 Canary<br/>限制流量與工具權限"] --> WATCH["監看 SLO、抽樣品質<br/>安全、成本與申訴"]
      WATCH --> DECIDE["符合條件才擴大<br/>異常就停用或回滾"]
      DECIDE --> LEARN["把失敗案例匿名化後<br/>加入下一版評估集"]
  end
GATE -->|"通過"| CANARY 實作重點
- 為一個候選版本產生 Release Manifest,列出模型 ID、Prompt、參數、索引、工具與政策版本
- 分別在 Model Registry、Prompt Management 與 Git/Artifact 系統保存各自負責的內容
- 建構 Pipeline 載入固定測試集,執行候選與基準版本,保存逐筆與彙總評估結果
- 先用人工資料校準 Pointwise 或 Pairwise Judge,再把必要門檻寫進發布閘門
- 把安全篩選率、引用檢查與抽樣人工品質做成自訂遙測,不假設 Model Monitoring 會自動理解
- 定義 Canary 的流量、觀察期、停止條件和回滾負責人,通過後才考慮 A/B 測試
課程導讀
課程連結:Machine Learning Operations (MLOps) for Generative AI — Google Skills
這是整條學習路徑的收尾課。課程頁目前沒有列出動手 Lab,內容是五支影片。若影片把 Model Registry、Pipeline 或 Model Monitoring 講得像是會自動管理整套 GenAI 應用,請用本文的 Release Manifest 重新整理責任邊界。自己動手練習時至少留下一份可重跑的評估資料、一筆候選與基準比較結果,以及明確的發布/回滾條件;這三樣比只把流程跑綠更接近真正的維運工作。
延伸學習
- Gemini 貫穿軟體開發生命週期 — AI 在開發流程中的整合
- 負責任 AI:隱私與安全 — 在 MLOps 管線中整合安全檢查
- Agent Studio(原 Vertex AI Studio)入門 — 回顧 Agent Platform 的核心工具
- 建構 GenAI 應用 — 從開發到部署的完整流程回顧
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
負責任 AI:隱私與安全
沿著資料生命週期做好最小化、去識別、權限與輸入輸出防護,並釐清差分隱私、聯邦學習與 Google Cloud 安全工具的邊界