
Transformer 與 BERT 模型
課程概述
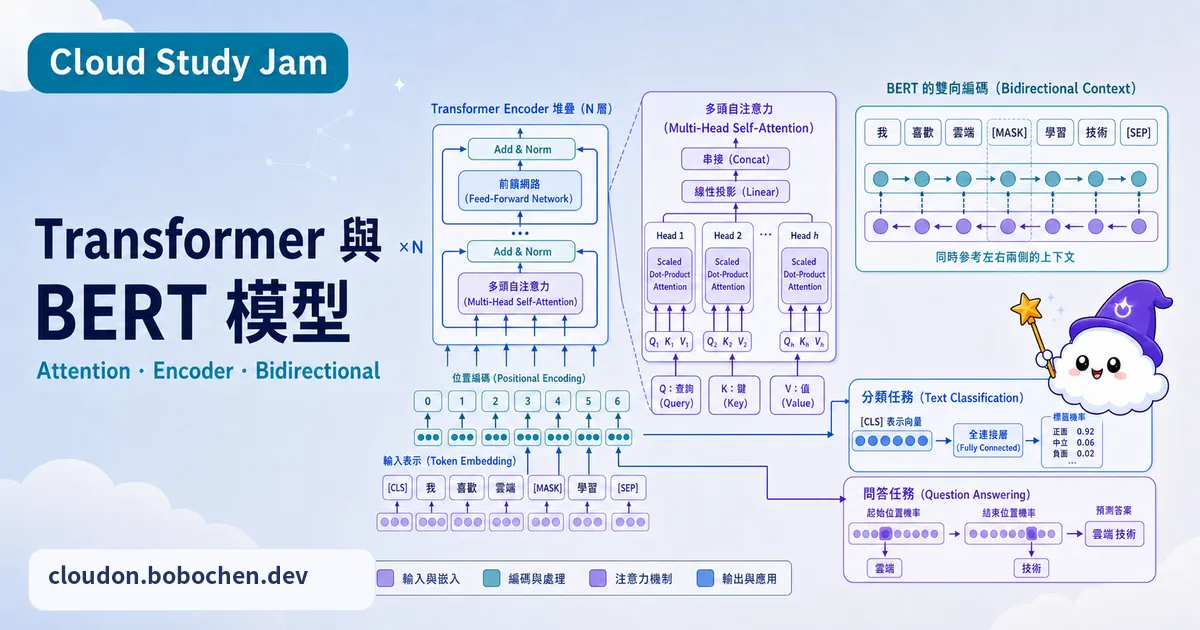
Transformer 不是單一模型,而是一組可以依任務重新組合的積木。BERT 採用 Encoder-only 架構,特別適合把一段文字整理成上下文化表徵;生成式模型常見的 Decoder-only,則用因果遮罩逐 Token 往下寫。這堂課會先看共同元件,再用 BERT 當例子,釐清「雙向理解」到底指什麼。
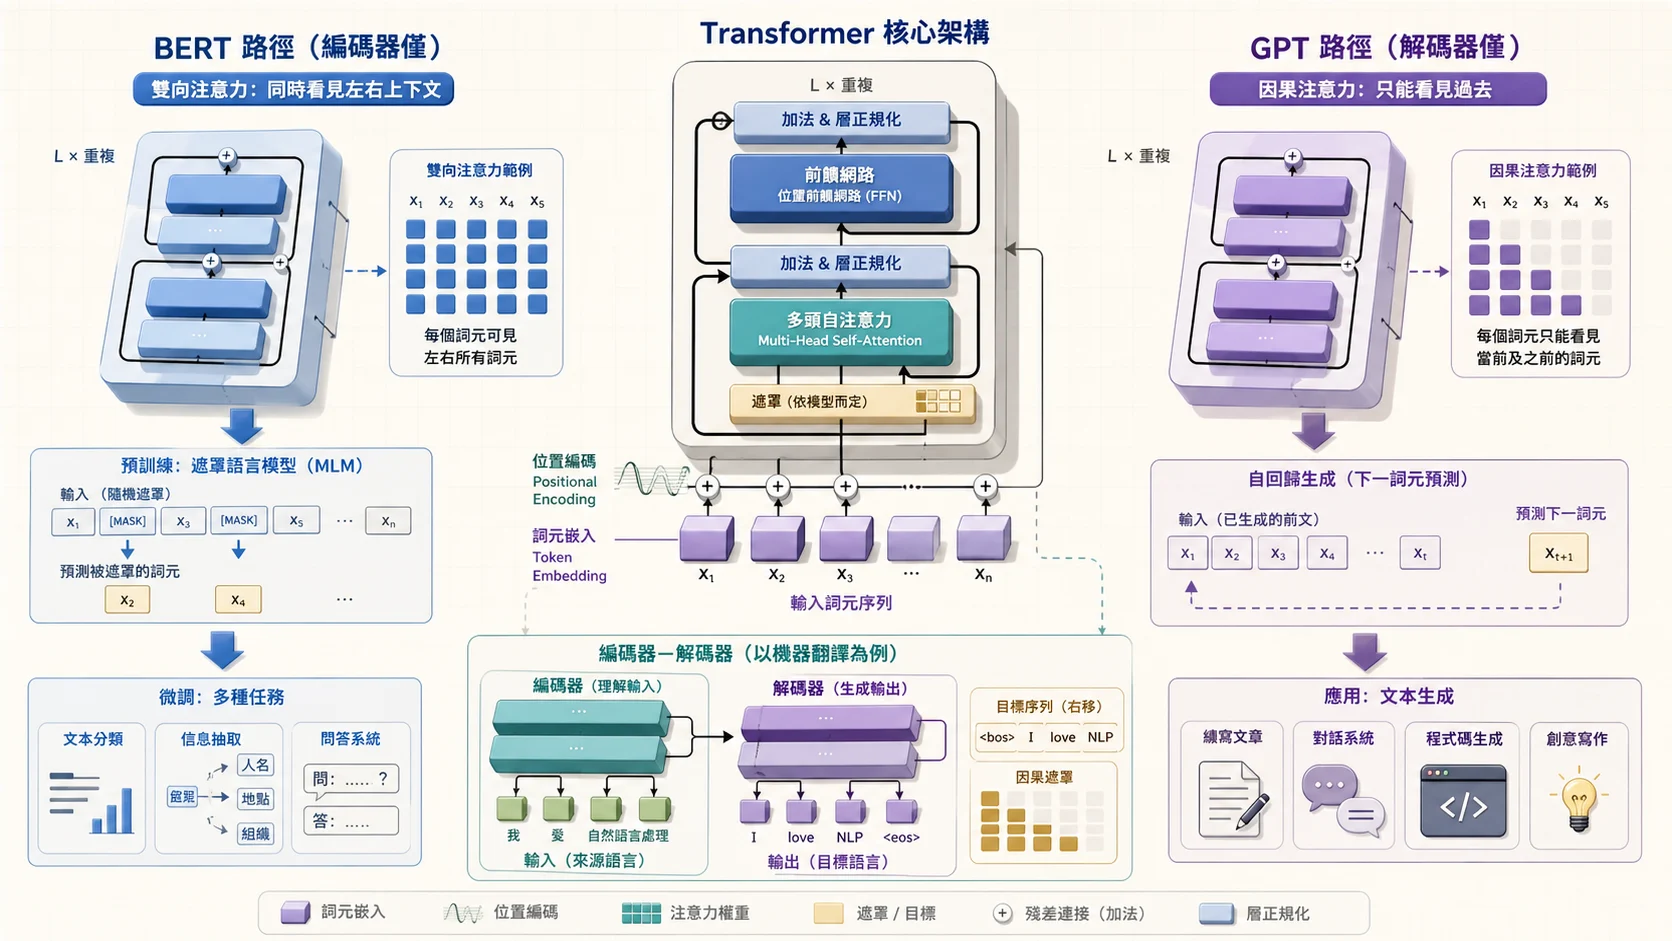
Transformer 的核心積木相近,注意力遮罩與堆疊方式會改變資料能往哪裡流。BERT 在編碼時可同時使用左右文;Decoder-only 模型以因果遮罩限制每個位置只能看先前內容;Encoder–Decoder 則另外用 Cross-Attention 連接來源與目標。
你將學到
- 說明 Transformer 常見的注意力、前饋、殘差與正規化元件
- 解釋 Positional Encoding 如何為模型提供序列位置資訊
- 理解原始 BERT 的 MLM 與 NSP 預訓練任務
- 區分 Encoder-only、Decoder-only 與 Encoder–Decoder 的資料流
- 了解 BERT 如何接上任務輸出層進行微調
核心概念
Transformer 有哪些共同積木?
大多數 Transformer 會先把 Token 轉成向量,再加入或套用位置資訊。每個 Block 裡常見 Multi-Head Attention、逐位置的前饋網路、殘差連接與 Layer Normalization。最後接什麼輸出層要看任務:生成模型可能接詞彙表投影,分類模型可能只取特定位置再接分類器,向量模型則會產生 Embedding。因此「Transformer 一定有六個固定元件」比較像教學口訣,不是每個架構都照同一張圖長。
Positional Encoding 的必要性
單看 Self-Attention,若把 Token 的排列一起換掉,輸出也只會跟著換位置,模型本身不知道誰先誰後。所以需要另外注入位置訊息,才能分辨「我喜歡貓」和「貓喜歡我」。原始 Transformer 使用固定的正弦/餘弦位置編碼;BERT 使用可學習的絕對位置 Embedding;不少較新的 Decoder-only 模型則採用 RoPE,把位置關係作用在 Query、Key 上。各方法能支援的長度與外推特性不同,不能只把名稱換掉就期待上下文自動變長。
BERT 的設計哲學
BERT(Bidirectional Encoder Representations from Transformers)是 Encoder-only 模型。它在建立某個 Token 的表徵時,可以同時使用左右兩邊的內容,適合分類、命名實體辨識、檢索特徵或抽取式問答。這裡的「雙向」指的是注意力可讀取兩側上下文,不代表模型會像人一樣完整理解語意。
BERT 的預訓練策略
原始 BERT 論文用了兩個預訓練任務。**MLM(Masked Language Model)**會挑出約 15% 的 Token 位置做預測,輸入不一定全部直接換成 [MASK],目的是讓模型利用兩側線索還原內容。**NSP(Next Sentence Prediction)**則判斷第二段是否接在第一段後面。這是原始 BERT 的做法,不代表所有後續 Encoder 模型都保留 NSP;有些研究移除或替換它,仍能得到不錯的結果。細節可回看 BERT 原始論文。
BERT vs GPT 的設計對比
| 維度 | BERT 類 Encoder-only | GPT 類 Decoder-only |
|---|---|---|
| 注意力範圍 | 每個位置可參考左右文 | 因果遮罩限制只能參考目前與先前位置 |
| 典型訓練目標 | 預測被遮住的 Token | 預測下一個 Token |
| 常見用途 | 分類、抽取、檢索表徵 | 續寫、對話、程式碼與工具呼叫 |
| 常見調整方式 | 加任務輸出層後微調 | Prompt、上下文學習或微調 |
這張表是起點,不是硬性邊界。Decoder-only 模型也能做分類,Encoder-only 模型也能成為生成系統的檢索元件;真正選型時仍要看資料量、延遲、成本與評估結果。
流程圖暫時無法顯示,請重新整理頁面後再試。
實作重點
- 從 Model Garden 或模型文件確認 BERT 類模型的授權、輸入格式、部署方式與支援狀態
- 實際組出
[CLS]、Token 序列與[SEP],觀察 Token、位置與 Segment Embedding 如何相加 - 用同一份資料比較 BERT-base 與 BERT-large,連同延遲和記憶體一起記錄,不只看準確率
- 載入支援的 BERT 實作做文字分類,並把 Attention 圖當分析線索,不直接當成模型解釋
Lab 導讀
Lab 連結:Transformer Models and BERT Model — Google Cloud Skills Boost
這個 Lab 會把前兩課的 Attention 和 Encoder-Decoder 組回完整架構。建議先確認「資訊能看哪裡」:BERT 沒有因果遮罩,因此能同時利用左右文;Decoder-only 有因果遮罩,因此適合下一 Token 預測。只要資料流先看懂,後面的模型名稱就不會全混在一起。
延伸學習
相關文章
您可能也會對這些文章感興趣
Transformer 與 BERT 模型
拆解 Transformer 的共同積木,理解 BERT 的雙向編碼器與原始預訓練方法,並比較常見架構適合的任務
圖片說明生成模型
理解圖片說明生成的技術原理、視覺 Encoder 與語言 Decoder 如何協作,並學會依需求選擇 Cloud Vision、Gemini 或專用模型
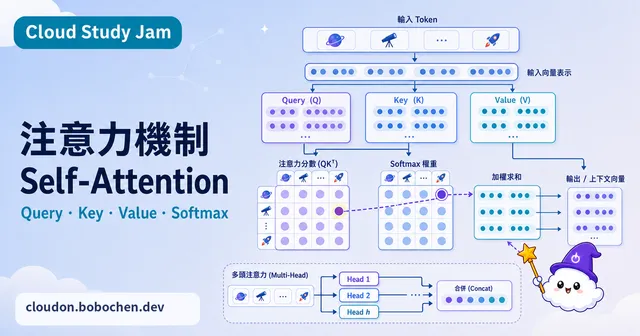
注意力機制
深入理解 Attention Mechanism 的數學原理與實作方式,認識 Self-Attention 如何成為 Transformer 的核心創新
