向量搜尋與嵌入技術
課程概述
智慧搜尋、推薦系統和 RAG 經常用到向量搜尋(Vector Search)與嵌入(Embedding),但把資料轉成向量並不代表搜尋就會自動變準。這堂課先建立語義距離的直覺,再帶你看切片、模型、索引、篩選與評估怎麼一起影響最後結果。
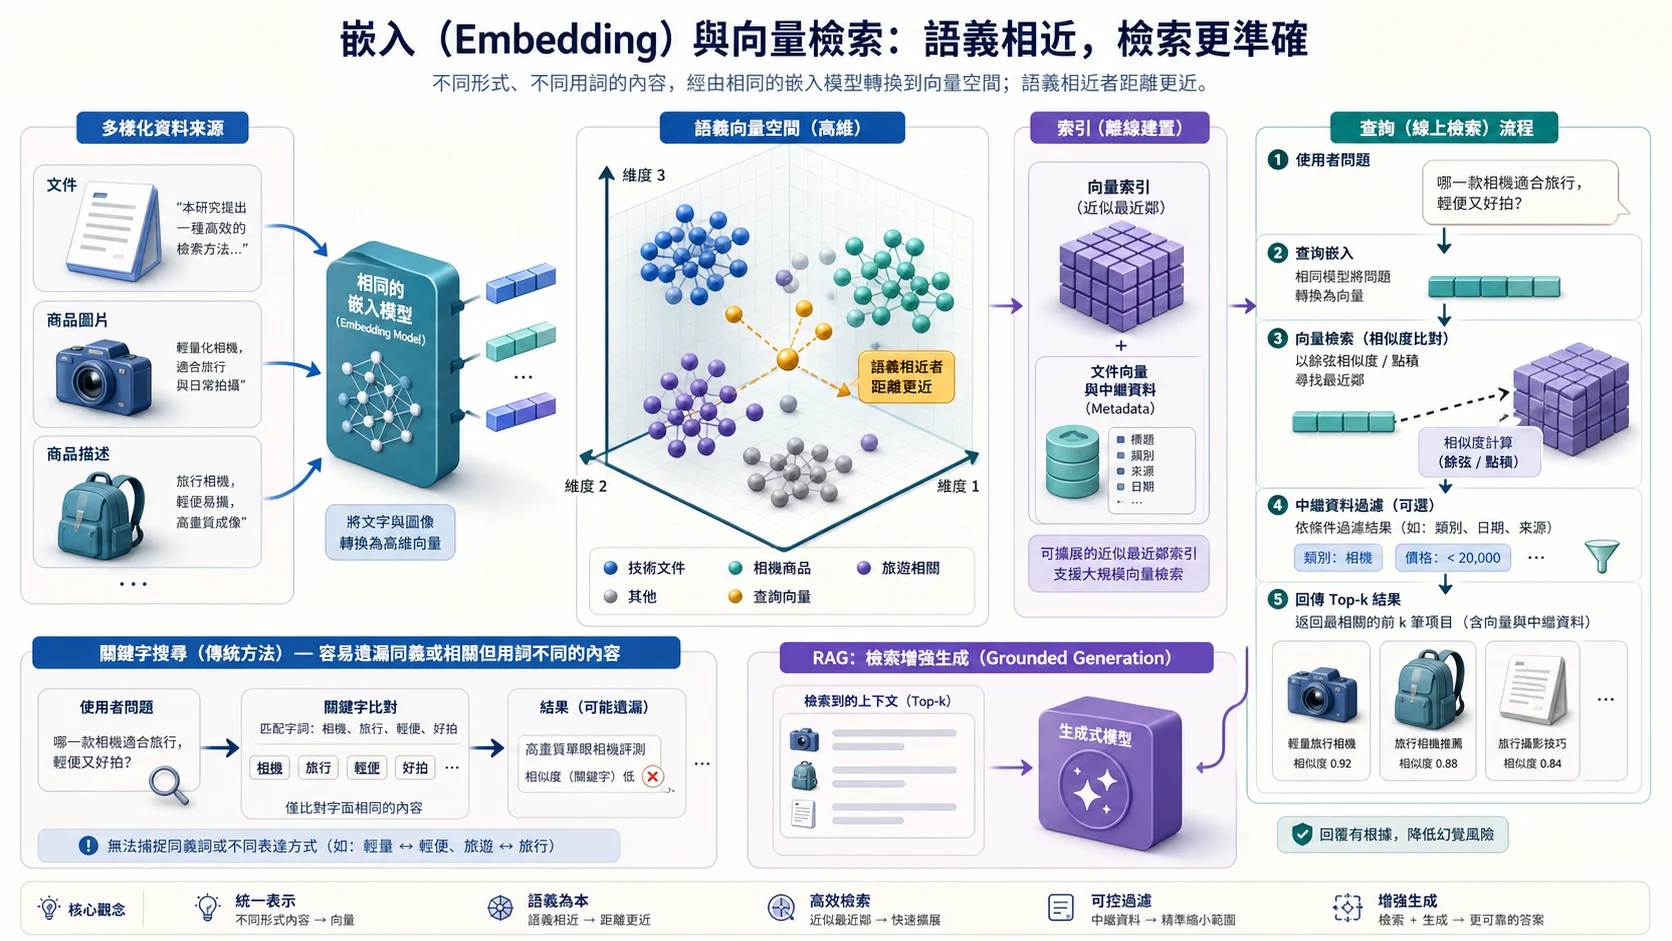
Embedding 把不同形式與措辭映射到同一語義空間,意思相近者距離更近,因此能找到關鍵字搜尋漏掉的同義內容。索引負責快速近鄰搜尋,Metadata 負責精準篩選,Top-k 結果則成為 RAG 的可追溯依據。
你將學到
- 解釋 Embedding 的數學直覺:高維空間中的語義距離
- 比較文字 Embedding、圖片 Embedding 與多模態 Embedding 的差異
- 使用 Gemini Enterprise Agent Platform(原 Vertex AI)的 text embeddings API 將文字轉換為向量
- 建構基於 Vector Search(原 Vertex AI Vector Search)的近似最近鄰搜尋系統
核心概念
為什麼需要 Embedding?
只靠關鍵字匹配時,你搜尋「如何退款」,可能漏掉標題寫成「申請退費流程」的文件。Embedding 會把內容映射成向量,讓意思相近、用字不同的內容在向量空間裡靠得比較近。不過語意搜尋也可能找回「看起來相關、其實不能回答」的段落,所以正式系統通常會把關鍵字、向量、中繼資料篩選與重新排序搭配使用。
Embedding 的維度與模型
不同 Embedding 模型會產生不同長度的向量。gemini-embedding-001 預設為 3072 維,也能透過 output_dimensionality 指定較短的輸出;向量越短,通常越省儲存與查詢成本,但是否影響召回品質,得用自己的查詢集實測。最重要的是文件與查詢要使用相容的模型、維度與前處理設定,不能只改查詢端就期待舊索引照常運作。實作方式可參考官方 Embedding 文件。
向量相似度的計算
衡量兩個向量有多像,常見方法有三種。餘弦相似度(Cosine Similarity)比較方向,歐幾里得距離(L2 Distance)比較直線距離,內積(Dot Product)則同時受到方向與向量大小影響。不能看到大家常用 Cosine 就直接照抄,索引端和查詢端必須採用一致、且符合模型建議的距離方式。
Vector Search 架構
Vector Search 是 Google Cloud 的代管向量搜尋服務。傳統架構常見的元件包括 Index(存放與組織向量)、Endpoint(承接線上查詢)和 Approximate Nearest Neighbor(ANN,近似最近鄰)。ANN 用部分召回精度換取查詢速度與規模,但不是調完一個參數就結束,還要一起測 Top-k、篩選條件、延遲與實際查詢命中率。另一個產品是 Agent Retrieval(原 Vector Search 2.0,2026 年 3 月 5 日正式發行,同年 4 月 22 日改用現名):它不再以 Index 為主要資源,而是把資料存成 Collection 裡的 Data Object,並提供自動產生 Embedding、混合搜尋與內建的語意重新排序。實作舊 Lab 時要留意介面與 Agent Retrieval 不完全相同。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 46}}}%%
flowchart TB
  subgraph SAMPLE["① 依序排查檢索管線"]
      direction TB
      START["記錄問題、預期文件<br/>實際 Top-k 與使用者權限"] --> FOUND{"預期文件有進入索引,<br/>而且權限允許看嗎?"}
      FOUND -->|"沒有"| INGEST["修正匯入、權限或<br/>Metadata 篩選"]
      FOUND -->|"有"| CHUNK{"切片是否保留<br/>完整語意,<br/>沒有太碎<br/>或混入太多主題?"}
      CHUNK -->|"不理想"| RECHUNK["調整 Chunk<br/>大小、重疊<br/>標題與結構化欄位"]
      CHUNK -->|"合理"| SAME{"文件與查詢使用相容的<br/>模型、維度<br/>與距離方式嗎?"}
      SAME -->|"不一致"| REINDEX["統一設定並重建索引"]
      SAME -->|"一致"| RANK["比較向量、<br/>關鍵字、篩選<br/>Top-k<br/>與重新排序組合"]
  end
  subgraph VERIFY["② 用固定查詢集驗證"]
      INGEST --> TEST["重跑代表性查詢<br/>計算 Recall 與延遲"]
      RECHUNK --> TEST
      REINDEX --> TEST
      RANK --> TEST
      TEST --> PASS{"關鍵證據有穩定<br/>出現在前幾名嗎?"}
      PASS -->|"有"| SHIP["小流量上線並持續收集<br/>無結果與錯誤點擊"]
  end
PASS -->|"沒有"| START 實作重點
- 使用 text embeddings API 將一組中文句子轉成向量,確認文件與查詢採用相同的模型與維度
- 建立一個小型的 Vector Search Index,載入自己的文件資料
- 比較精確搜尋(Brute-force)與近似搜尋(ANN)在速度與準確度上的差異
- 設計 Embedding 更新策略:資料或模型版本變動時,如何標記版本、重建索引並安全切換
Lab 導讀
Lab 連結:Vector Search and Embeddings — Google Skills
這個 Lab 會用 text embeddings API 產生向量,再建立 Vector Search 索引跑語意搜尋。操作時除了等索引完成,也要記下模型、維度、距離方式與資料版本,否則結果有問題時很難追。做測驗前先複習 Embedding、相似度,以及 ANN 和精確搜尋的取捨;實務上還要多補一份固定查詢集,才知道調整後究竟有沒有變好。
延伸學習
- Gemini 多模態 RAG 文件檢索 — Vector Search 在 RAG 架構中的核心應用
- GenAI 基礎概念解鎖 — 回顧 Embedding 的基礎概念
- RAG 架構 — 登雲學院 GenAI Leader 課程的 RAG 專題
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
GenAI 的 MLOps 實踐
把模型、Prompt、檢索、工具與評估案例綁成可重現版本,透過發布閘門、漸進上線、監控與回滾維運 GenAI 應用
負責任 AI:隱私與安全
沿著資料生命週期做好最小化、去識別、權限與輸入輸出防護,並釐清差分隱私、聯邦學習與 Google Cloud 安全工具的邊界