負責任的 AI 導論
課程概述
模型能回答問題,不代表答案一定公平、安全,也不代表使用者知道資料被拿去做什麼。這篇用 Google 的 AI 原則當起點,看看開發一個應用時,該在哪些地方檢查偏差、保護資料,並讓人知道系統的限制。
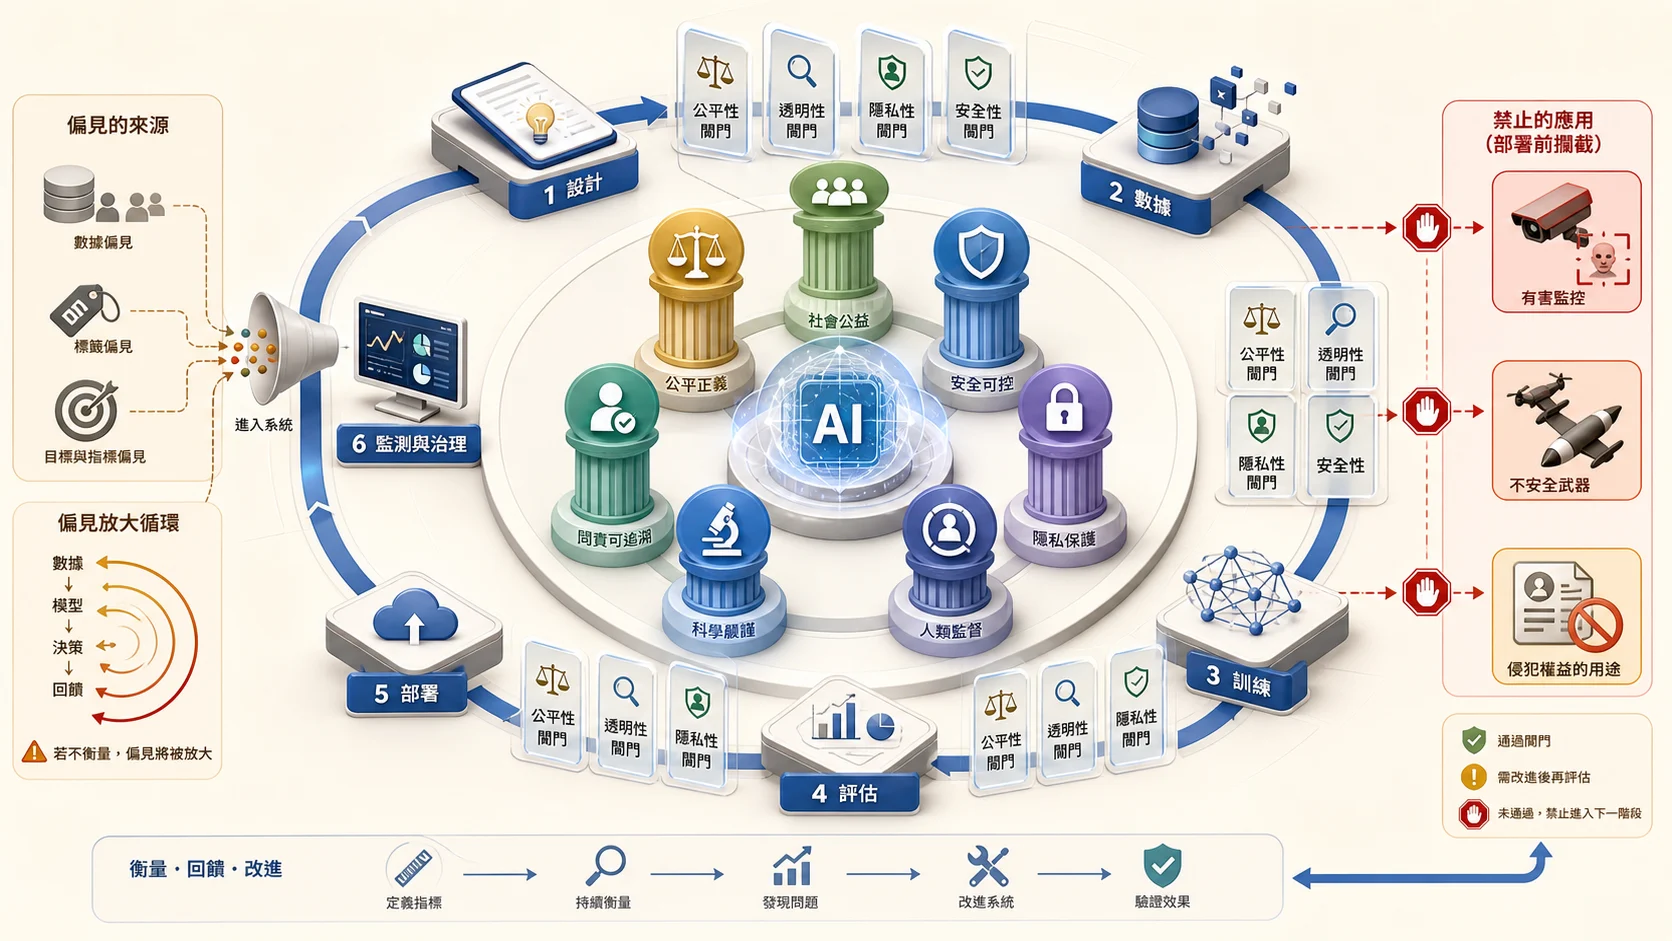
Responsible AI 不是上線前的一次性檢查,而是貫穿設計到監控的連續閘門。資料、標籤和目標裡的偏差會被模型與回饋迴路放大,因此必須量測、阻擋禁止用途,並讓人類對高影響決策負責。
你將學到
- 列舉並解釋 Google 的 AI 七大原則
- 識別 AI 開發中的四類不應觸碰的領域
- 理解偏差(Bias)在 AI 系統中如何產生與擴大
- 認識 Google Cloud 提供的 Responsible AI 工具與資源
核心概念
先分清楚:課程版本與現行原則不同
這門課沿用的是 Google 2018 年發布的七項 AI 原則,下面這份清單是本文整理的這七項原則。不過實務上別把它當成現行版本:Google 已在 2025 年把官方框架更新為「大膽創新」、「負責任地開發與部署」和「攜手合作、共同進步」三大主軸。準備舊課程時先理解七項原則,做新專案時則要回頭查看現行官方原則。
- 對社會有益(Be socially beneficial) — AI 應用應為社會帶來正面價值
- 避免產生或強化不公平偏見(Avoid creating or reinforcing unfair bias) — 積極防範對弱勢群體的歧視
- 為安全而建構與測試(Be built and tested for safety) — 在部署前進行全面的安全性評估
- 對人負責(Be accountable to people) — 提供適當的機制讓人類能監督與干預
- 融入隱私設計(Incorporate privacy design principles) — 從設計階段就納入隱私保護
- 堅守高科學標準(Uphold high standards of scientific excellence) — 以嚴謹的研究方法為基礎
- 以符合原則的方式提供使用(Be made available for uses that accord with these principles) — 限制可能違反原則的用途
AI 不應觸碰的領域
在 2018 年版 AI 原則中,Google 曾列出四類不會投入的用途,包括可能造成整體傷害的技術、主要目的或實作方式會造成傷害的武器、違反國際規範的監控,以及違反國際法與人權基本原則的應用。這段「Applications we will not pursue」已不在 2025 年更新後的現行原則中,所以讀到考題時要知道它是在問舊版課程,不能直接說成 Google 現在的承諾。
偏差的來源與影響
AI 偏差可能來自好幾個環節:訓練資料的採集偏差(Sampling Bias)、標註過程的人為偏好(Annotation Bias)、模型架構的內建假設,還有評估指標的設計盲點。在生成式 AI 裡,偏差會直接反映在模型輸出的內容上,所以更需要有系統地去檢測跟緩解。
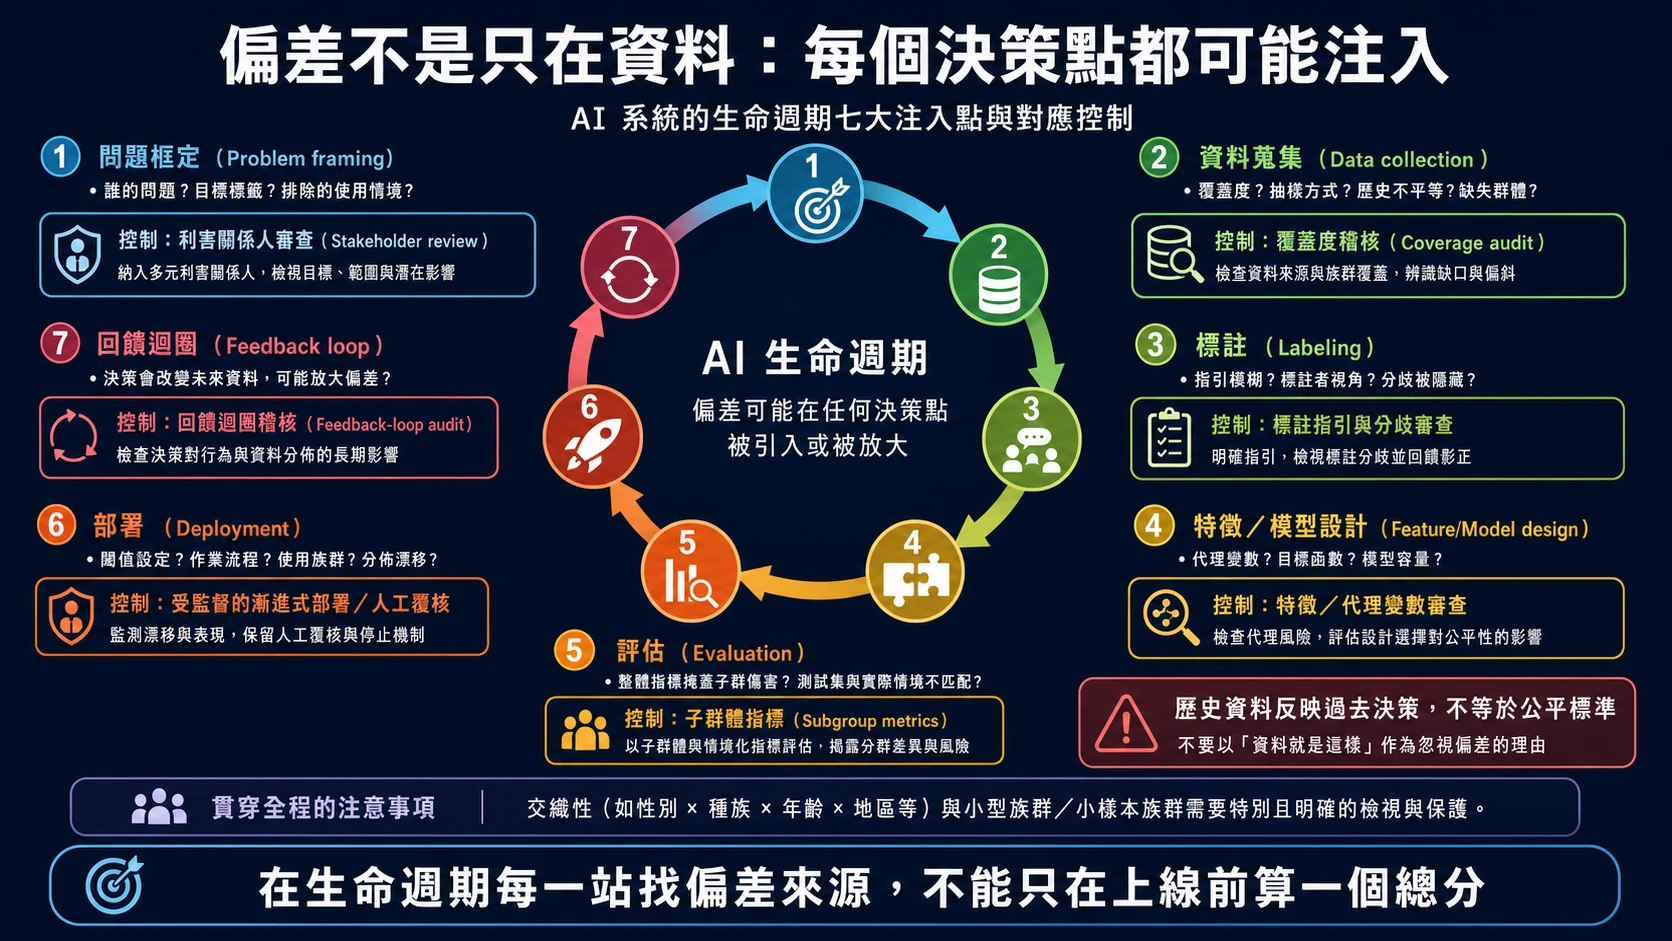
偏差不只存在訓練資料:目標怎麼定義、誰被納入、標籤怎麼產生、門檻與介面怎麼設計,都可能改變不同群體承受的錯誤。每一個決策點都需要證據、分群評估與負責人。
實踐 Responsible AI 的方法
實際開發時,Responsible AI 不是做完再回頭打勾的檢查清單,而是要貫穿整個開發生命週期、一路做下去的事。從需求定義階段就要納入利害關係人的多元觀點;在模型選擇跟訓練的過程中做偏差審計;部署之後也要持續盯著模型行為的公平性指標。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32}}}%%
flowchart TD
  USE["定義使用情境、使用者<br/>以及可能受影響的人"] --> HARM{"用途是否違法、受政策禁止<br/>或可能造成不可接受傷害?"}
  HARM -->|"是"| STOP["停止開發或重新設計用途"]
  HARM -->|"否"| IMPACT{"會影響權利、健康、財務<br/>就業或其他重要決定嗎?"}
  IMPACT -->|"是"| HIGH["採高風險流程:獨立審查、<br/>分群測試、人員覆核與申訴機制"]
  IMPACT -->|"否"| DATA{"是否使用敏感資料<br/>或直接對外產生內容?"}
  DATA -->|"是"| MEDIUM["加入隱私、安全、內容篩選<br/>與人工抽查"]
  DATA -->|"否"| BASIC["基本品質測試、文件與監控"]
  HIGH --> EVIDENCE{"風險與控制證據<br/>都達到門檻嗎?"}
  MEDIUM --> EVIDENCE
  BASIC --> EVIDENCE
  EVIDENCE -->|"否"| FIX["補測試、降權限或重新設計"]
  FIX --> EVIDENCE
EVIDENCE -->|"是"| RELEASE["核准上線並持續監控"] 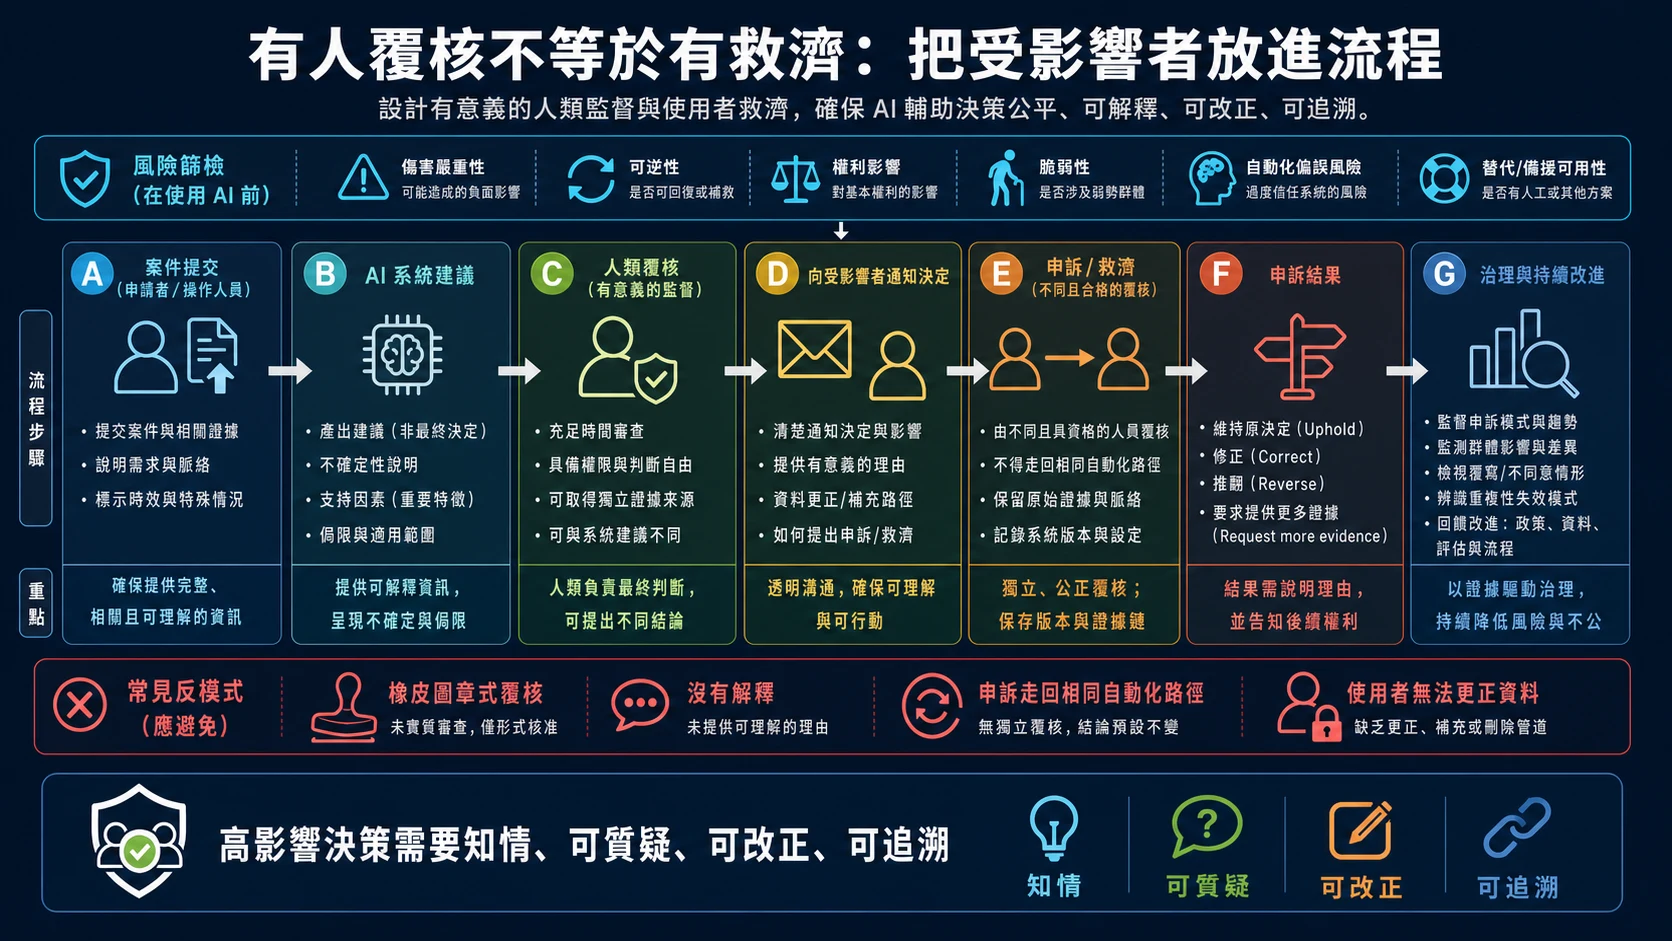
「有人在流程裡」不一定形成有效監督。覆核者必須看得到證據、有時間與權限改變結果;受影響者也要知道 AI 如何參與決策,並能補正資料、申訴與取得後續回覆。
實作重點
- 瀏覽 Google 的 AI Principles 官方網站,理解現行三大原則;準備課程測驗時,再把它和本文整理的 2018 年版七項原則對照
- 在選擇基礎模型時,檢視 Model Card 了解模型的訓練資料、已知限制與適用範圍
- 養成為每個 GenAI 應用建立「風險評估清單」的習慣,涵蓋偏差、隱私與安全面向
- 了解 Gemini Enterprise Agent Platform(原 Vertex AI)的安全篩選器(Safety Filters)怎麼分工:不可調整的篩選器會攔截 CSAM 等禁止內容;可設定的內容篩選器依設定的門檻阻擋,預設門檻依模型而定,不要假設平台預設就會擋(查證日 2026-10-12)
Lab 導讀
Lab 連結:到 Google Skills 搜尋「Introduction to Responsible AI」。截至 2026 年 10 月,目錄中找不到同名課程,可能已改版或下架。
這門課的課程頁目前打不開,沒辦法對照現在的單元安排;依本文整理的課程主題,重點放在搞懂 Google AI 原則。複習時確認自己對七大原則熟不熟,還有遇到具體場景時,怎麼判斷符不符合 Responsible AI 的要求。建議特別留意那些看起來合理、其實可能踩到原則的邊緣案例。
延伸學習
- 概念深入:什麼是生成式 AI? — 回顧基礎概念
- Google Cloud AI 負責任原則實踐 — 進一步了解如何在 Google Cloud 上實踐這些原則
- 負責任 AI:公平性與偏差 — 聊聊公平性議題的技術解方
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
負責任 AI:隱私與安全
沿著資料生命週期做好最小化、去識別、權限與輸入輸出防護,並釐清差分隱私、聯邦學習與 Google Cloud 安全工具的邊界