經典架構拆解 · 02 — Uber 即時派單架構
上一篇看 Netflix 怎麼送影片,這次換成位置一直變的派單系統。乘客和司機會移動,空車狀態也會更新;系統得在這些資訊變動時持續找出可用的配對。
Uber 的公開工程案例可以用來觀察兩件事:位置資料怎麼按地理範圍處理,以及派單後的狀態變化怎麼交給工作流程管理。
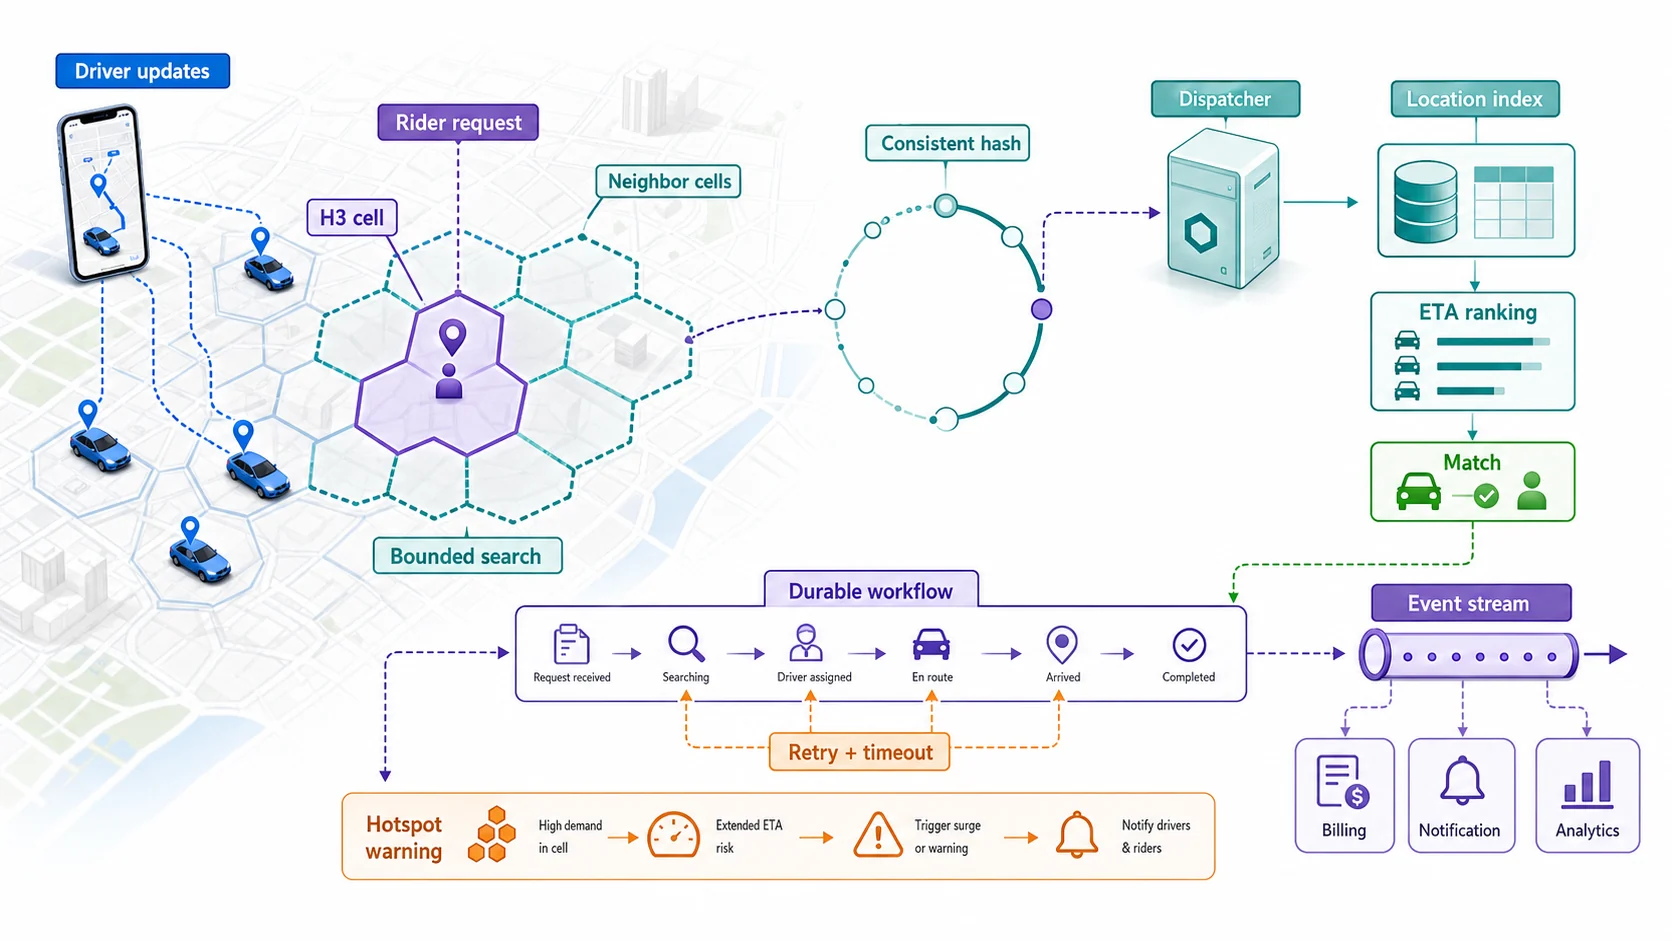
即時地理系統先縮小搜尋空間,再談資料庫:H3 把「全城掃描」變成乘客所在格和鄰格查詢,一致性雜湊把同一分片穩定導到對應節點。配對成功後,持久工作流負責跨步驟狀態、逾時與重試;事件串流只負責把狀態解耦扇出,兩者不能混成同一個元件。
為什麼值得拆解
Uber 的派單系統,遠遠不只是「一個大型的 matching engine」。它要同時扛住三件事:
- 即時位置流:全球所有司機每 4 秒上報一次 GPS。
- 地理查詢:以乘客為中心,在地圖上找出符合車種、評分、路況的候選司機。
- 配對工作流:司機接受、拒絕、取消、到場、上車、下車——每一步都可能失敗,需要一個就算中途斷線也能接著跑的狀態機。
這三件事,剛好對到架構設計裡容易被忽略的三個能力:水平分片策略、低延遲 NoSQL 選型、長流程(long-running workflow)建模。下面我們就順著這三條線拆下去。
商業規模與壓力
先看一下這套系統到底在扛多大的量。根據 Uber 2024 年 Q4 財報,Uber 平台在 2024 年全年完成約 113 億次行程(Trips),月活躍平台使用者約 1.71 億。光是把這些行程跑起來,背後的派單系統就得處理每秒數百萬次的地理查詢,遇到尖峰時段(跨年夜、機場外大型活動散場),還得再吞下 10 倍以上的流量。
數字大家看過就好,重點是這種量級會逼出哪些設計上的硬限制:
- 單一資料庫表撐不住:一張「司機位置」表如果沒分片,查詢幾分鐘就會把整個系統拖垮。
- 地理查詢不能用 SQL
WHERE distance < X:就算掛了空間索引,跨 region 一路掃過去的延遲也沒辦法接受。 - 每一趟行程都是一個長流程:可能跨 30 分鐘、橫跨好幾個城市,中間還會碰到網路斷線跟伺服器重啟。
這三條,後面每一條都對應到一個架構決策,我們一個個看。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  D["Driver 每數秒上報 GPS"] --> H["映射成 H3 cell"]
  H --> I["更新對應 cell 的位置索引"]
  R["Rider request+車種條件"] --> C["取得所在 cell+<br/>Neighbor cells"]
  C --> Q["只查局部位置索引"]
  I --> Q
  Q --> E["計算 ETA、評分與供需條件"]
  E --> M["候選司機排名與配對"]
架構演進簡史
Uber 的派單架構經過多次調整。把幾個公開的里程碑放在一起看,比較容易理解每次改動想解決的規模或維運問題:
| 年份 | 里程碑 | 意義 |
|---|---|---|
| 2014–2015 | 舊版 Dispatch(DISCO)用 Google S2 空間索引 | 城市數量增加後,單一 DB 成為瓶頸 |
| 2015 | 自研 Ringpop 一致性雜湊(consistent hashing) | 讓同一城市的請求永遠落到同一組節點,避免跨節點查詢 |
| 2016–2017 | Cadence workflow 開源 | 把派單、費用結算等長流程從「ad-hoc state machine」改為宣告式 workflow |
| 2018 | H3 地理索引開源 | 把地球切成六角形格子(hexagon),取代經緯度矩形分片 |
| 2019 | Temporal 從 Cadence 分支(後繼專案) | 原 Cadence 作者另起爐灶,成為日後的主流 workflow engine |
| 2021+ | 全站事件匯流改用 Apache Kafka 為主幹 | 解耦下單、配對、計費、通知等子系統 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
把上面的決策畫成一張圖,派單的資料流大致是這樣走的:
Uber 即時派單:請求經 API Gateway 進派單服務,用 geo-sharding(H3)配上低延遲位置庫做供需配對,事件走 Kafka 串起計費/通知/ETA。
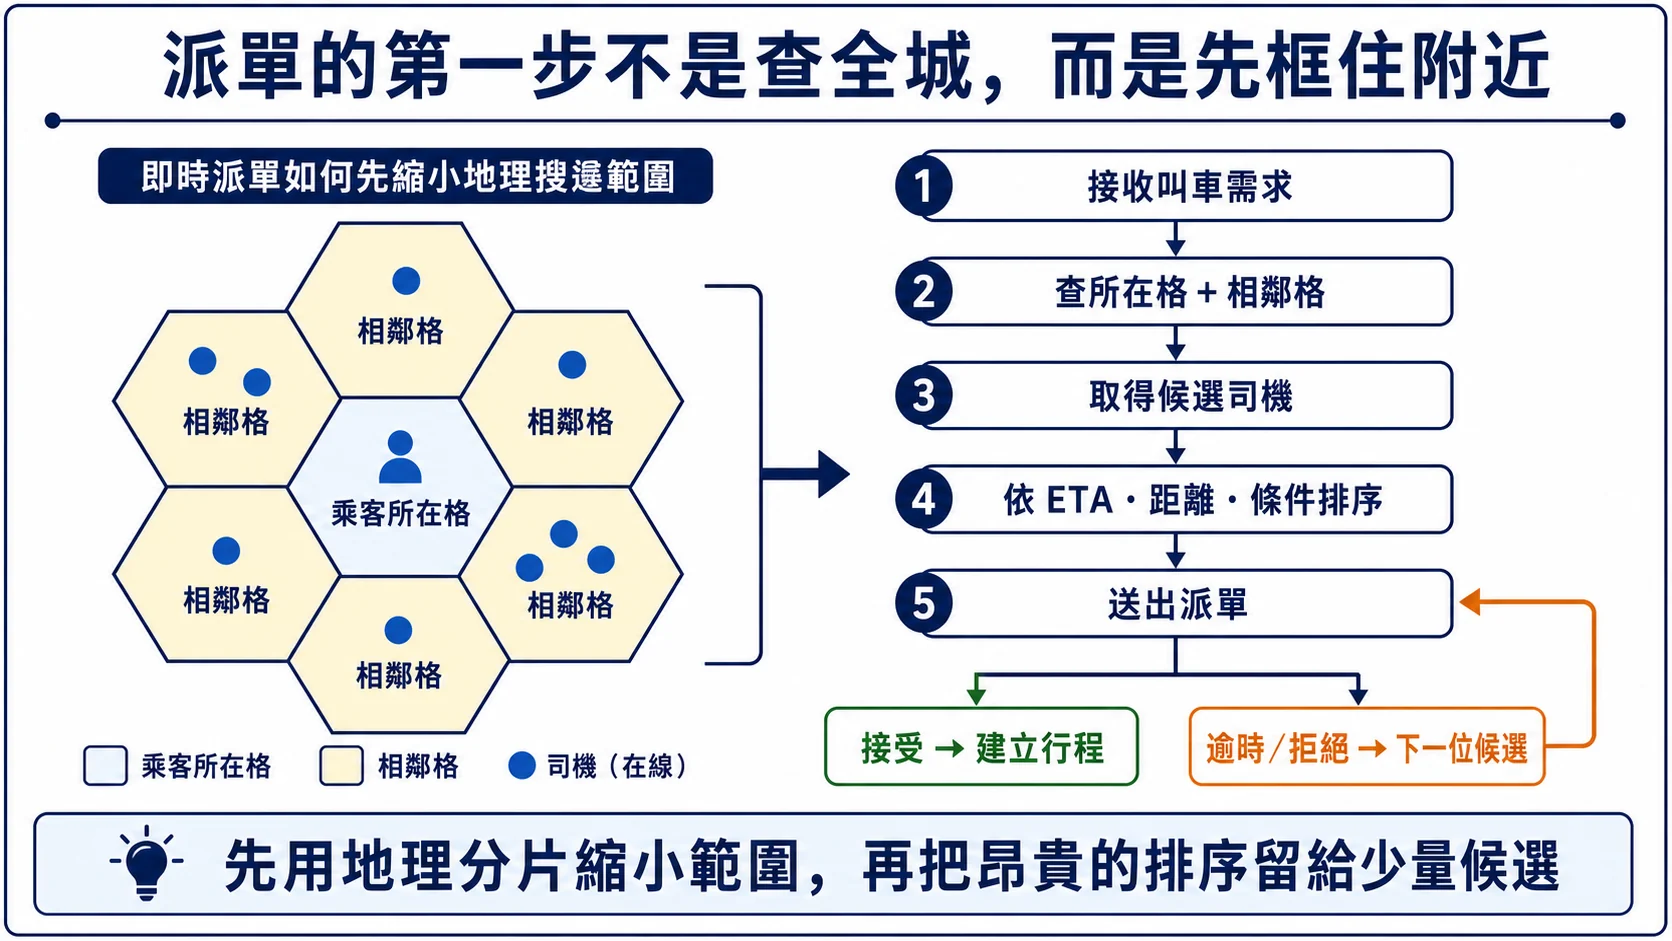
這張圖把地理分片的價值拆成步驟:先用所在格與相鄰格縮小搜尋範圍,再依 ETA、距離與條件排序。候選人拒絕或逾時時,只需沿排序結果往下一位走,不必重新查整座城市。
核心技術決策
| 決策 | 為何這樣選 | 替代方案與為何沒選 |
|---|---|---|
| 用 H3 六角形格子做地理分片 | 六角形的相鄰距離一致,比經緯度矩形更公平;可分多層級,從城市到街角都能表達 | 純經緯度矩形:邊界扭曲(極區特別嚴重)、相鄰距離不均 |
| Ringpop 一致性雜湊定位服務節點 | 當節點增減時,只有 1/N 的請求需要重新路由,不用全體重分配 | 傳統 sharding key:節點擴容時大量熱點漂移,連線風暴 |
| Cadence/Temporal 管理派單流程 | 派單是跨小時、跨服務、跨失敗的長流程,用一般訊息佇列無法描述「下一步等多久才 timeout」 | 自建 state machine:每種失敗路徑都要自己寫重試與 timeout 邏輯 |
| 位置資料用 in-memory NoSQL + 分層持久化 | 司機位置寫入頻率極高、讀取延遲要求壓到幾十毫秒(業界常見量級,非官方公布值),用 SSD 資料庫撐不住 | 直接寫 PostgreSQL:寫入熱點會馬上打爆 |
| 事件匯流用 Kafka | 下單、配對、計費需要強順序保證;消費者可以獨立擴容 | RabbitMQ 或純 REST:無法保證城市內事件順序或回放能力 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
「先分片、再選 DB」可以用附近騎手查詢來理解。起初用 PostgreSQL 加 PostGIS 查半徑,也許足以應付;當位置回報與查詢量增加,就要先縮小每次搜尋的範圍,例如把地圖切格,只查乘客所在格與相鄰格。這時候要檢查的,不只是資料庫夠不夠快,還有每次查詢碰到多少資料。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart LR
  K["Routing key<br/>city/H3 cell"] --> R["Consistent hash ring"]
  R --> N1["Dispatcher node A"]
  R --> N2["Dispatcher node B"]
  R --> N3["Dispatcher node C"]
  X["新增 node D"] --> R
  R -. "只重映射相鄰的一小段 key" .-> X
  N1 --> L["同一地理分片保有<br/>cache 與 data locality"]
  N2 --> L
  N3 --> L
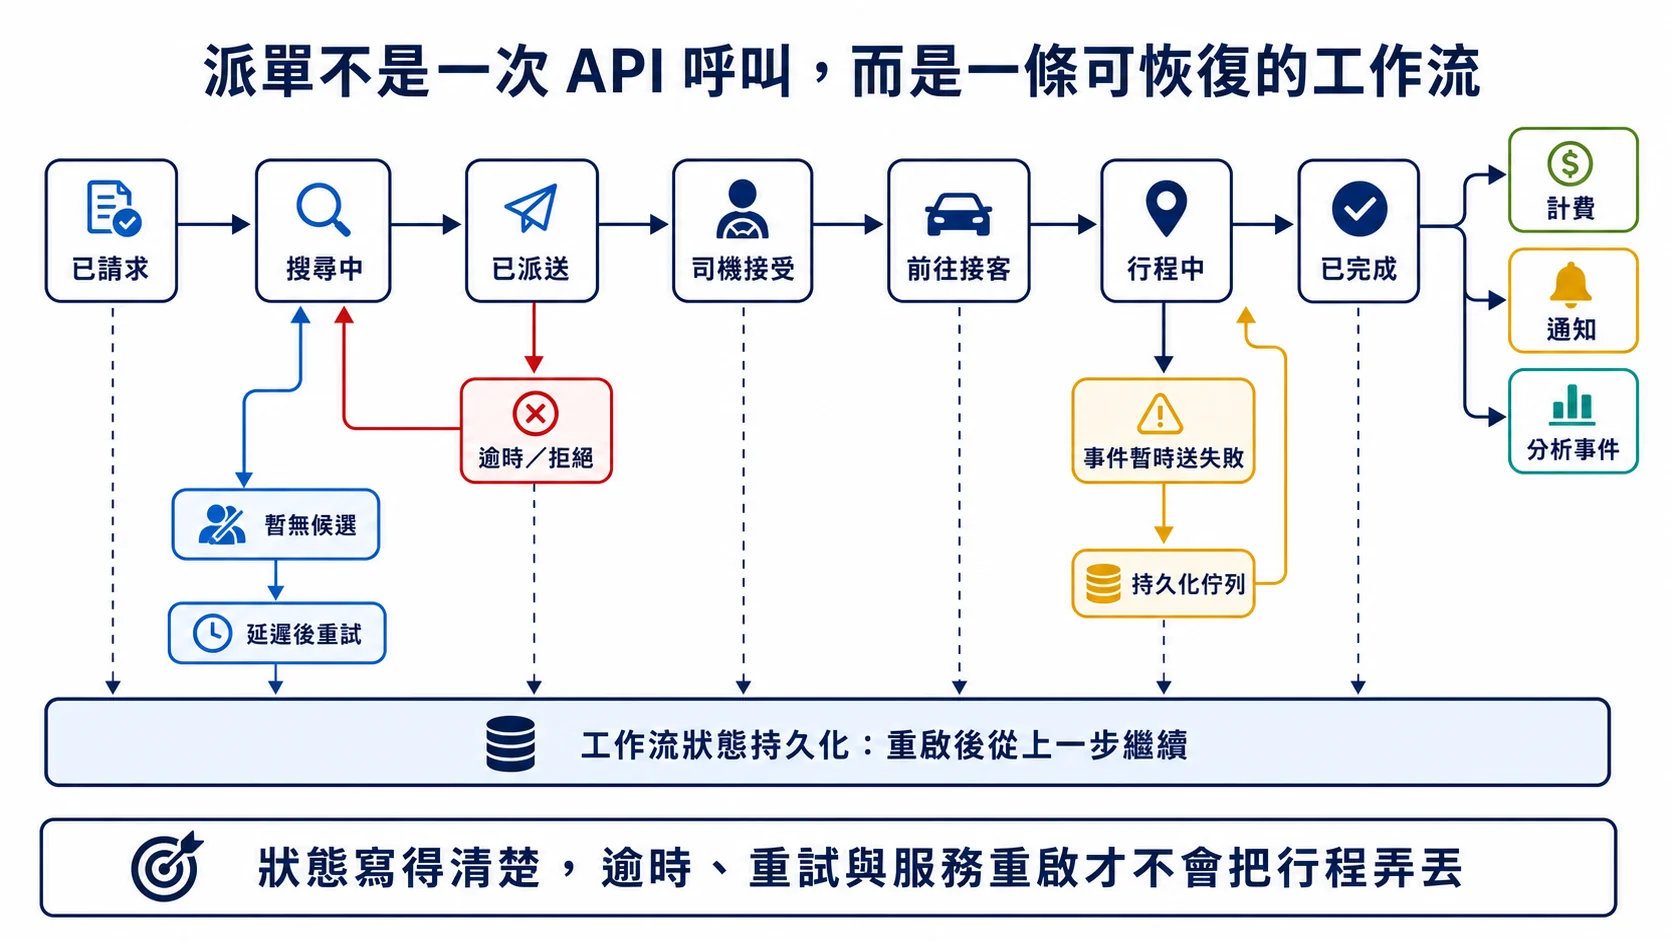
派單是跨服務、跨失敗的長流程,而不是一次 API 呼叫。把每一步持久化成明確狀態,服務重啟後才能接著走;逾時、拒絕與事件暫時送失敗也各自有可預期的恢復路徑。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
stateDiagram-v2
  [*] --> Requested
  Requested --> Searching: 建立地理候選
  Searching --> Offering: 選出司機並送出邀請
  Searching --> Waiting: 暫無候選
  Waiting --> Searching: 退避後重試
  Offering --> Searching: 拒絕或 timeout
  Offering --> Accepted: 司機接受
  Accepted --> PickedUp: 接到乘客
  PickedUp --> Completed: 行程結束
  Requested --> Cancelled: 乘客取消
  Searching --> Cancelled: 乘客取消
  Offering --> Cancelled: 乘客取消
  Accepted --> Cancelled: 取消並執行補償
  Completed --> [*]
  Cancelled --> [*]
如果用 GCP 重新蓋
那如果今天要在 GCP 上重蓋一套,會長怎樣?這部分對備考也有用:PCA 考試指南 Section 1.3 列的就是為網路、儲存與運算資源選型(例如選擇合適的儲存類型、把運算需求對應到平台產品)。一個個對過去:
- 即時地理索引: Bigtable 作為 geo index 主力,使用 H3 cell ID 當作 row key,利用其 lexicographic 排序特性做範圍查詢;熱資料另用 Memorystore(Redis)加速。
- 配對與 dispatcher 服務: GKE(regional)部署 dispatcher,搭配 Cloud Service Mesh(前身為 Anthos Service Mesh)做區域親和性路由,對應 Ringpop 的角色。
- 長流程工作流: Cloud Workflows 適合輕量編排;真的要處理 Cadence 等級的持久狀態機,可自架 Temporal on GKE,因為 Temporal 就是 Cadence 的後繼專案。
- 事件匯流: Pub/Sub(或 Kafka on GKE / Confluent Cloud)。需要嚴格順序與長期保留時用 Kafka;純解耦用 Pub/Sub。
- 跨 region 交易資料: Spanner 存行程、帳單、付款紀錄,利用它的 multi-region 強一致能力。
- 離線分析: BigQuery 處理歷史行程與供需熱力圖。
這張表是在把 Uber 的需求轉成 GCP 上的候選方案,不是說每個即時地理系統都該用 Bigtable。若資料要高頻寫入並按地理區塊掃描,就先驗證 row key 能否支援查詢;若流程跨越數小時、途中會重試,則要有地方保存步驟與狀態。先把這些條件講清楚,再比較服務才有根據。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart LR
  A["新的非同步需求"] --> B{"重點是把事件<br/>扇出給獨立消費者?"}
  B -->|"是"| C{"需要嚴格順序<br/>或長期回放?"}
  C -->|"否"| D["Pub/Sub<br/>解耦與 fan-out"]
  C -->|"是"| E["Kafka<br/>順序與歷史保留"]
  B -->|"否"| F{"流程會跨很久,且要記住<br/>timeout、retry 與目前步驟?"}
  F -->|"是,輕量編排"| G["Cloud Workflows"]
  F -->|"是,複雜持久狀態"| H["Temporal on GKE"]
F -->|"否"| I["一般服務呼叫或 Cloud Tasks"] 把架構選擇放回需求裡看
Uber 的案例可以拆成三種需求:附近車輛的低延遲查詢、派單事件的分發,以及跨多個步驟的行程流程。它們不一定該交給同一個服務處理。
📝 考場提點
地理分區與資料分片要先回答「附近」的範圍怎麼定義,以及位置更新與查詢各有多少流量。H3 能把地圖切成網格,方便縮小候選範圍;Bigtable、關聯式空間索引或快取則要按資料量、查詢模式和延遲目標比較。若用 Bigtable,Row Key 必須配合常用查詢與寫入分布設計;不能只因為需要低延遲,就把快取當成唯一資料來源。
📝 考場提點
事件分發與流程編排也要分開。計費、通知和 ETA 若要各自接收同一個事件,可評估 Pub/Sub;若流程必須記住目前進度、等待外部回應並處理重試,則要評估 Cloud Workflows 或其他工作流程系統。訊息順序、保存時間和回放能力都要單獨列出需求,再比較 Pub/Sub、Kafka 等方案,而不是只憑「事件驅動」四個字決定工具。
常見誤解
下面幾個概念容易混在一起:
- 「派單有空間索引就夠了」 —— 空間索引能幫忙找附近車輛,但還得處理位置更新頻率、候選範圍與尖峰流量。規模變大後可評估分區或分片;是否需要、怎麼切,仍要拿實際查詢分布驗證。
- 「Cadence 就是 cron job」 —— Cadence/Temporal 會記錄工作流程的進度,讓跨多個步驟、可能等待很久的任務在失敗後能恢復與重試。Cron 主要負責按時啟動工作;後續步驟的狀態仍要另行管理。
- 「一致性雜湊只是負載均衡技巧」 —— 它也能讓同一類 key 的請求較穩定地落在同一組節點,降低重新分配時的搬移量。若要用它提升快取命中率,還得看 key 怎麼設計與請求是否真的重複。
再看一個訂單流程:下單後要扣庫存、通知出貨,最後等物流回報。如果只靠排程腳本觸發下一步,服務恰好在「扣完庫存、尚未通知」時重啟,就得自行查出流程停在哪裡、能否安全重試。Workflow engine 的用途,是記錄每一步的狀態與重試條件;它和定時啟動工作的 cron 解的是不同問題。
來源與延伸閱讀
- Uber Engineering Blog — 派單、H3、Ringpop、Cadence 的原始公開文章。
- H3 官方文件 — 六角形地理索引的開源專案與論文。
- Ringpop 專案頁 — 一致性雜湊實作與設計原則。
- Cadence / Temporal 官方文件 — workflow engine 的設計哲學與 API。
- Uber Q4 2024 Earnings Release — 年度行程數與活躍使用者引用來源。
下一篇:從「即時地理系統」切換到另一個經典問題 —— Stripe 的 API 冪等性設計,看他們如何讓「重複付款」在架構層面就不可能發生。
🎯 換你練習
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
經典架構拆解 · 06 — Discord 百萬人頻道與 NoSQL 選型
Discord 的頻道很熱鬧時,訊息、連線和語音怎麼撐住?從資料庫遷移與服務調整看它的選擇。
經典架構拆解 · 05 — Airbnb 搜尋排名與金流分帳
房源搜尋要排序,下單又要處理付款與信任問題。從 Airbnb 的公開案例看這幾套系統怎麼分工。