
經典架構拆解 · 04 — Slack 即時訊息與已讀同步
在 Slack 發一則訊息,對方可能在手機、桌面和網頁上同時看到。訊息傳送之外,已讀位置還得跨裝置同步,舊訊息也要能搜尋。這幾件事放在一起,才看得出即時系統的設計難點。
這是經典工程架構拆解系列的第四篇。和上一篇的付款重試一樣,這裡也要面對重送與一致性,只是這次使用者等的是訊息。
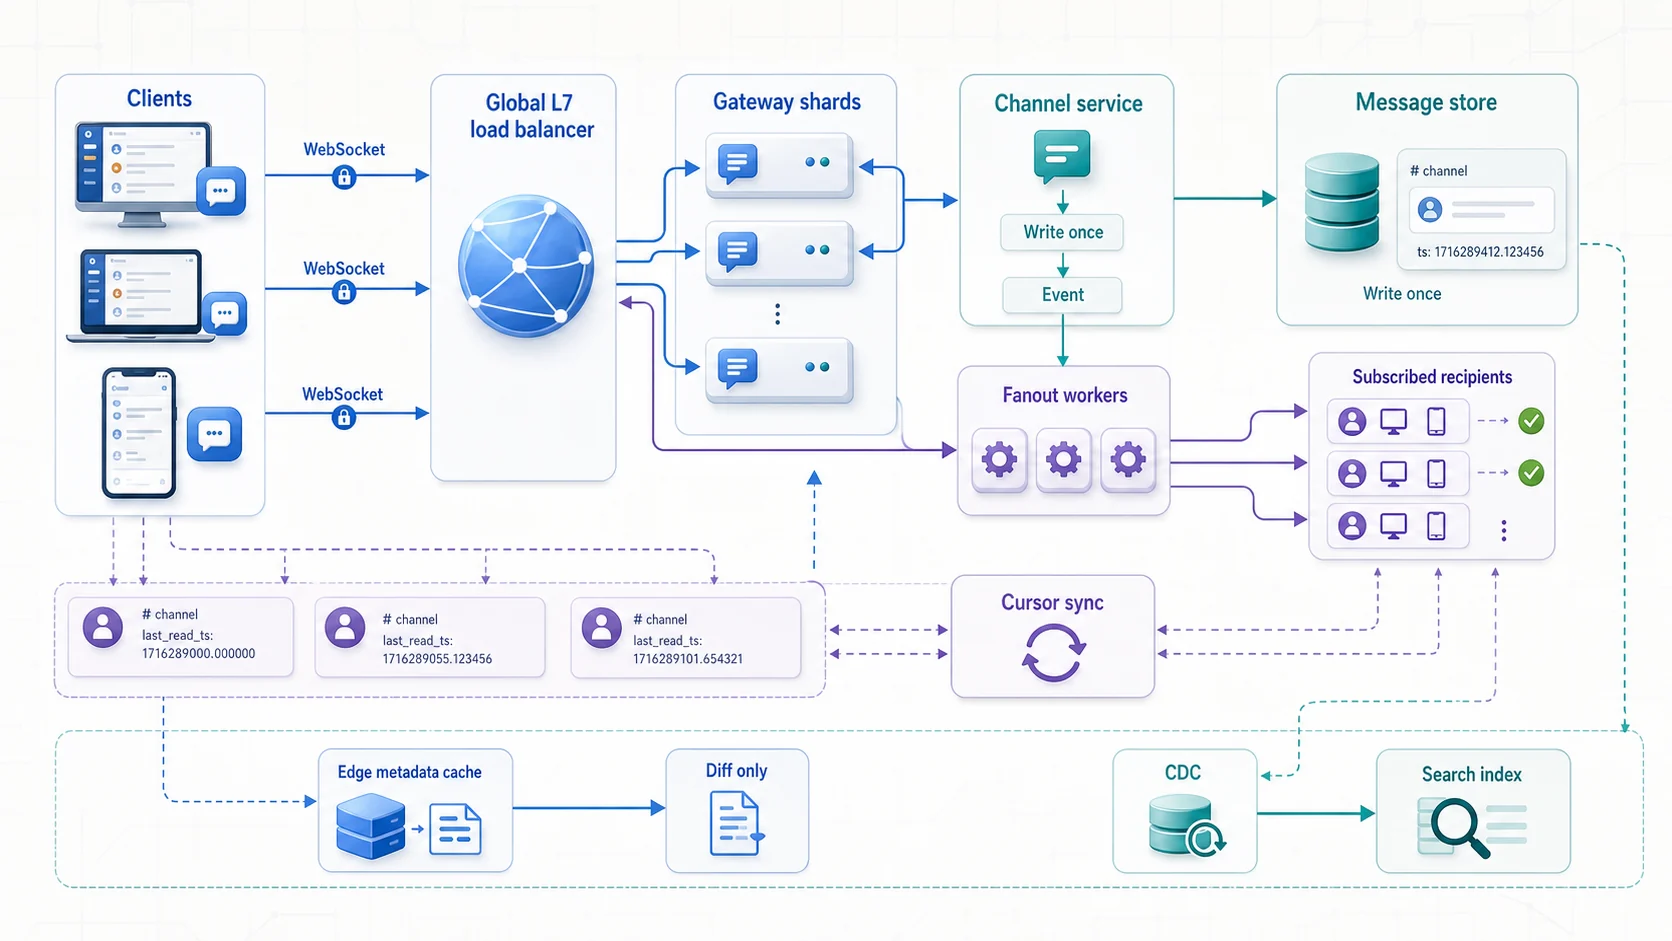
核心儲存以 channel 為單位只寫一份,fanout 是傳輸,不是替每位使用者複製 inbox;Gateway 只推給自己維護的已訂閱連線。已讀只存每位使用者/頻道的 last_read_ts,把儲存量從「訊息 × 使用者」降為「頻道 × 使用者」;搜尋索引與 metadata cache 則走獨立非同步路徑。
為什麼值得拆解
Slack 把看起來很簡單的「聊天」做成了企業級協作平台。它的架構正好點出三個關鍵問題:怎麼維持數百萬條長連線而不讓伺服器爆掉?一個 channel 有上萬人時,訊息要怎麼送?搜尋和即時訊息這兩種差很多的工作負載,要怎麼共存?
這三個問題拆開來,剛好對到設計訊息系統時要做的三個決定——服務選型(Pub/Sub、Cloud Tasks、WebSocket)、event-driven 架構、一致性 vs 可用性的取捨。Slack 是真的拿幾百萬使用者在跑這套系統。
商業規模與壓力
根據 Slack 官方歷年公開資訊與第三方統計:
- 每日活躍使用者(DAU)官方最後一次公布是 約 1,200 萬以上(2020 年;Salesforce 併購後財報就不再單獨揭露 Slack DAU),近年第三方估算的數字更高,但屬估算而非官方財報;付費組織則超過 20 萬家1。
- 高峰期維持超過 數百萬條同時在線的 WebSocket 連線(根據 Slack Engineering Blog 2017 年的 “How Slack Built Shared Channels” 與後續演講)2。
- 單一 workspace 最多可達上萬使用者,單一 channel 訂閱者規模從數人到數萬人都有(Slack Help Center 官方文件)3。
壓力點:訊息平均延遲得壓在 幾百毫秒內,不然使用者馬上就「感覺到卡」。企業客戶還要求 SLA 99.99%。
訊息延遲不只影響等待時間,也會影響使用者行為。若送出後遲遲看不到回應,使用者可能重新整理或重送,讓重複訊息更難處理。即時系統除了量測送達延遲,也要讓介面清楚顯示訊息是否正在傳送、已送達或失敗。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
sequenceDiagram
  participant S as Sender
  participant G as WebSocket Gateway
  participant C as Channel service
  participant M as Message store
  participant E as Event bus/Fanout workers
  participant R as Subscriber Gateways
  S->>G: send message
  G->>C: 驗證身分與 channel membership
  C->>M: 只寫一份 canonical message
  M-->>C: committed+sequence
  C-->>S: ack
  C->>E: publish message event
  E->>R: 只送到持有訂閱連線的 shards
  R-->>R: 推給線上裝置
  E-->>E: 離線裝置更新未讀/推播
架構演進簡史
| 階段 | 年份(約) | 關鍵變化 |
|---|---|---|
| 單體 PHP + MySQL | 2013–2015 | 每個 workspace 一組 MySQL shard,訊息從 DB 撈再推 |
| 加入 Job Queue | 2015 | 用自家 Job Queue(後來換成 Kafka)做非同步 fanout |
| Flannel Edge Cache | 2017 | 邊緣節點快取每個使用者的 channel 清單,降低登入延遲 2 |
| 全面 Vitess 化 | 2020 | MySQL 改跑 Vitess,解決單 shard 容量瓶頸(Slack Engineering Blog 2020)4 |
| Search 分離為獨立服務 | 2016–至今 | 用 Solr / 自家 indexer 做全文搜尋,與即時訊息分流 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
有意思的是,這條線上沒有「打掉重練」這一格。Slack 一路是在能跑的系統上一塊一塊換——先把 fanout 抽到 queue、再把登入慢的部分用 edge cache 擋掉、最後才動到最底層的資料庫分片。這種「邊飛邊修引擎」的順序不是巧合,而是任何還在成長的線上服務的常態:你沒有停機半年重寫的本錢,只能挑當下最痛的那一塊先解。
把這些選擇收斂成一張圖,訊息與已讀的流向大概是這樣:
Slack 即時訊息:用戶端走 WebSocket 長連線,Channel 服務把訊息寫一次再扇出推播,已讀只存 last_read_ts 游標。
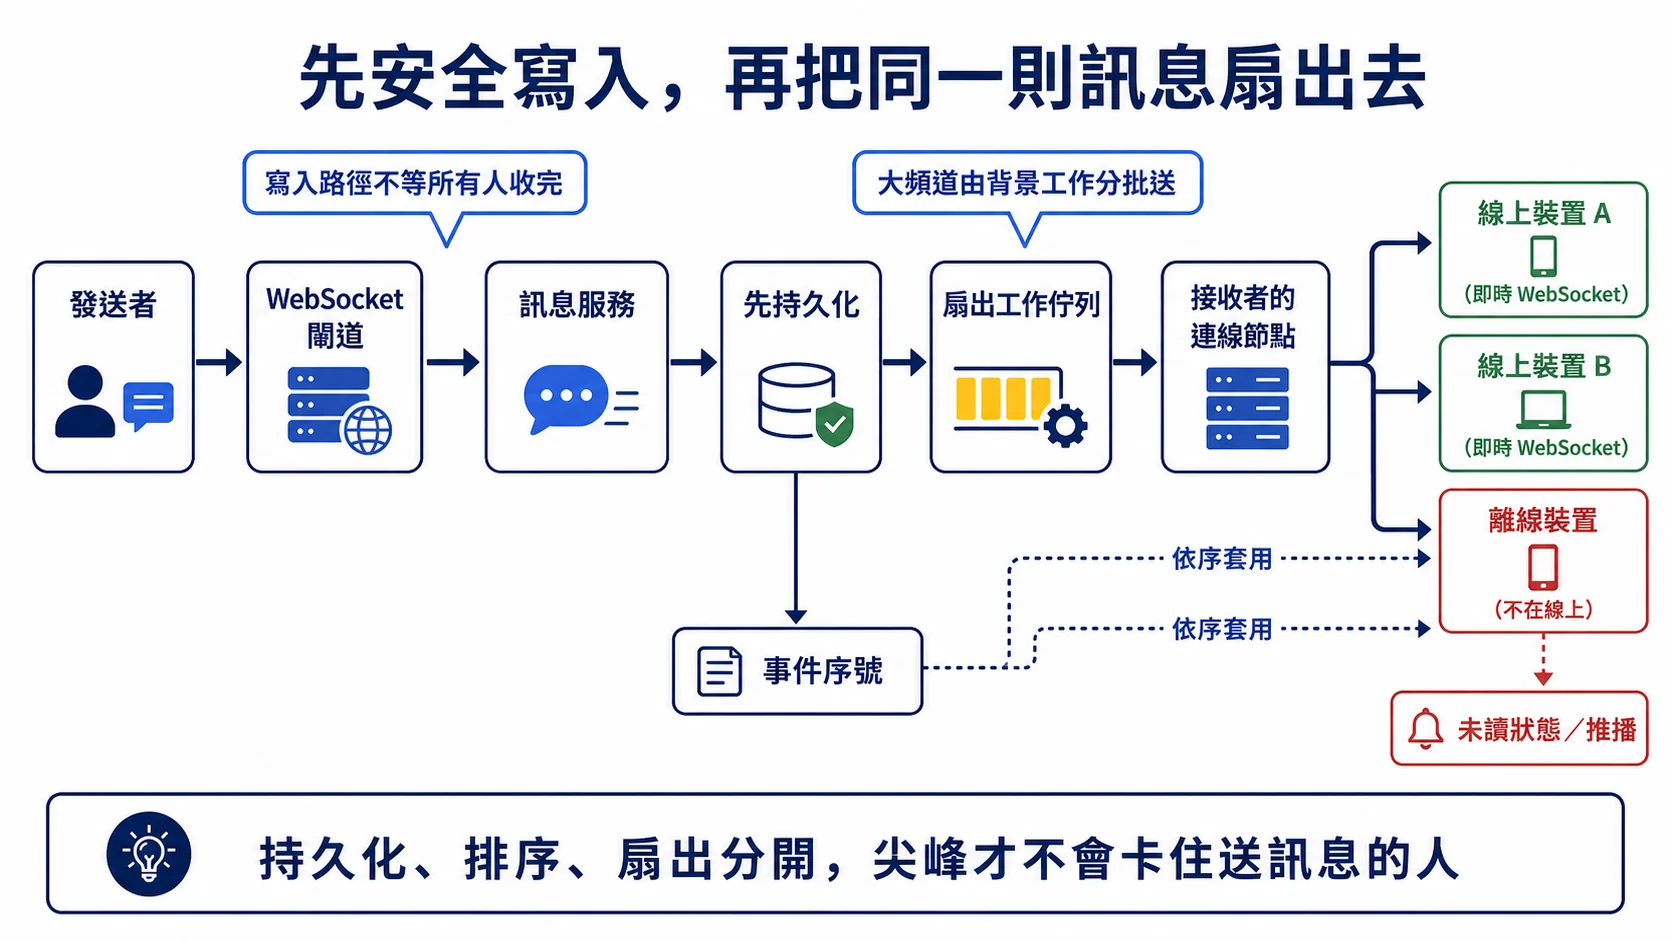
這是通用的即時訊息模型:寫入路徑先安全保存訊息,不等待所有接收者;排序與多人扇出交給後續工作。線上裝置走長連線,離線裝置則留下未讀狀態並視需要推播。
核心技術決策
| 決策 | 為何 | 替代方案 |
|---|---|---|
| WebSocket 長連線 | 推訊息延遲低於 polling,省頻寬 | HTTP long-polling(早期用過)、Server-Sent Events |
| 每 workspace 一組 shard | 資料隔離清楚、好做 compliance | 全局分散式資料庫(成本與一致性代價太高) |
| Edge cache(Flannel) | 登入一次要傳的 channel/user metadata 太大,邊緣快取後只同步 diff 2 | 每次從核心服務撈(延遲高) |
| Job Queue 做 fanout | 大 channel 要把一則訊息複製給上萬人,同步做會卡住寫入 | DB trigger(無法橫向擴充) |
| 讀取游標(read cursor)只存「最後已讀的 ts」 | 不用為每則訊息存「誰讀過」,節省儲存 | per-message read receipt(像 WhatsApp,代價大太多) |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
最後那一條——已讀游標的設計——是整張表裡最值得停下來看的,因為它示範了一個很省力的取巧。Slack 的「已讀」不是一條一條記,而是只存一個 last_read_ts(最後已讀時間戳)。客戶端切換 channel 時,WebSocket 上送一個事件,後端更新游標,再推到使用者其他裝置同步。
差別有多大?如果為每則訊息記「誰讀過」,資料量是 O(訊息 × 使用者);只存一個游標,立刻降到 O(channel × 使用者)。一個上萬人、每天幾萬則訊息的 channel,這兩種做法的儲存量差好幾個數量級。
這背後其實是一個值得內化的提問:使用者真的需要那麼精確的資訊嗎?「你在這個 channel 讀到哪了」99% 的情況下夠用,沒人會去追「第 4,217 則訊息你到底點開沒」。先想清楚使用者真正要的那條線,再決定資料怎麼存,往往能省掉一整層複雜度——這個直覺在考場跟實務都一樣值錢。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  M["Channel messages<br/>依 timestamp 排序"] --> C["Client 打開 channel"]
  C --> R["更新 user+channel<br/>的 last_read_ts"]
  R --> D["同步同一使用者的其他裝置"]
  M --> U{"message.ts 大於<br/>last_read_ts?"}
  R --> U
  U -->|"是"| N["顯示未讀"]
  U -->|"否"| Y["已讀"]
X["不用保存每則訊息 ×<br/>每位使用者的回條"] -.-> R 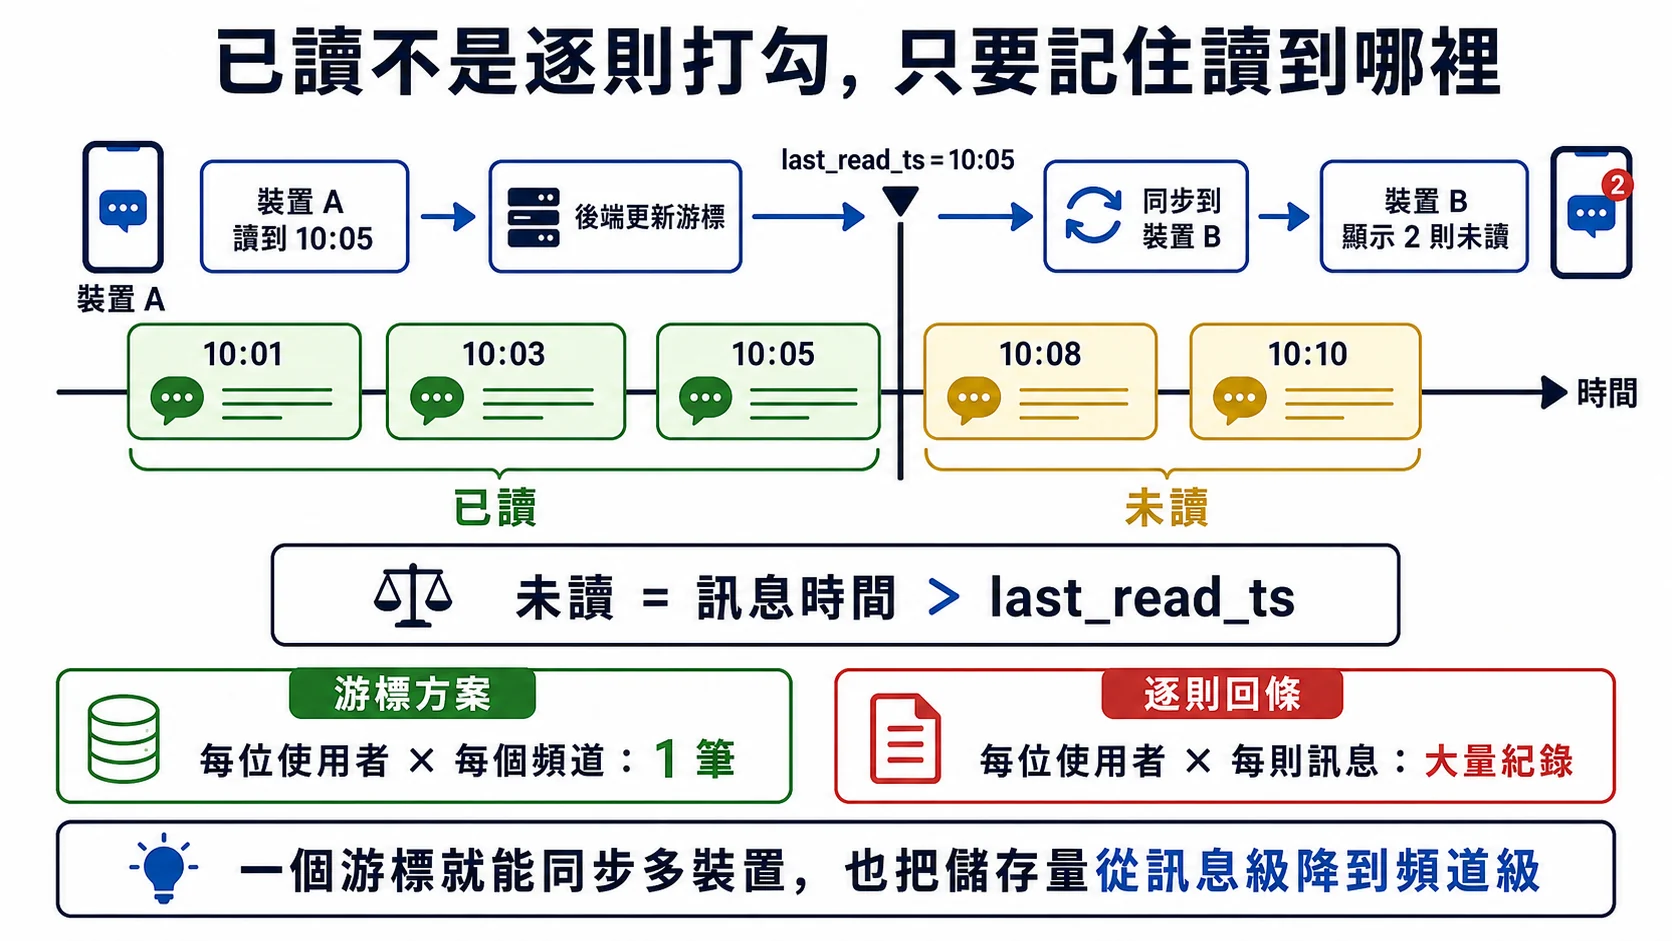
每位使用者在每個頻道只保存一個 last_read_ts
。時間晚於游標的訊息就是未讀;其他裝置同步同一游標即可得到一致結果,不必為每則訊息建立一筆已讀回條。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  C["Clients"] --> L["Global External<br/>Application LB<br/>HTTP Upgrade+<br/>L7 routing"]
  L --> G1["GKE Gateway shard A<br/>持有一組長連線"]
  L --> G2["GKE Gateway shard B<br/>持有另一組長連線"]
  E["Channel event"] --> F["Fanout router"]
  F -->|"只送有訂閱者的 shard"| G1
  F -->|"只送有訂閱者的 shard"| G2
  G1 --> U1["Online users"]
  G2 --> U2["Online users"]
  G1 -. "drain/reconnect" .-> G2
如果用 GCP 重新蓋
| Slack 元件 | GCP 對應 |
|---|---|
| WebSocket gateway | GKE 跑自家 gateway(Cloud Run 自 2021 年 6 月 GA 起即支援 WebSocket,但長連線仍偏好 GKE 管控更細) |
| 訊息儲存 | Cloud Spanner 或 Bigtable(超大量選 Bigtable;需跨 channel 交易選 Spanner) |
| 已讀游標 | Firestore 或 Memorystore for Redis(低延遲讀寫,每使用者 per-channel 一筆) |
| 訊息 fanout | Pub/Sub 做 topic per workspace 或 per channel;超大 channel 用 fan-out worker 拆 |
| 搜尋索引 | Dataflow 做 CDC(change data capture)管線 → Agent Search(前身為 Vertex AI Search)或自建 Elasticsearch on GKE |
| Edge cache | Cloud CDN + Memorystore 做 per-user metadata cache |
| 檔案附件 | Cloud Storage + 簽章 URL |
| 稽核與合規 | Cloud Logging + BigQuery 做分析、Sensitive Data Protection(原 Cloud DLP)掃敏感資料 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
WebSocket gateway 的難處在於連線建立後會持續佔用後端資源,擴縮或部署時還得處理斷線與重連。GKE 讓團隊較細地控制節點、連線分配和終止流程;Cloud Run 也能處理 WebSocket,但要測試請求逾時、並行數與重連行為。這張表採用 GKE,是因為案例希望自行掌握長連線生命週期,不代表所有 WebSocket 服務都必須用 GKE。
入口與後端是兩個不同決策。若需要依 HTTP 路徑分流,這裡選 Global External Application Load Balancer;後面的 gateway 則負責連線狀態與訊息處理。下方再比較不同負載平衡器和訊息服務各自處理哪一段。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  I["Idle WebSocket<br/>connections"] --> C["連線記憶體<br/>與 heartbeat 成本"]
  M["Messages per second"] --> F["每則訊息的訂閱者數"]
  F --> O["Fanout deliveries<br/>per second"]
  O --> S["序列化、網路<br/>與 Gateway CPU"]
  C --> P["容量規劃"]
  S --> P
  P --> A["分離連線容量與訊息扇出容量的 autoscaling 指標"]
📝 考場提點
若 WebSocket 入口需要依 HTTP 路徑或 Host 分流,可評估 Global External Application Load Balancer。Proxy Network Load Balancer 也能承載 TCP/SSL 上的 WebSocket 流量,但不會替你做 HTTP 層的路由;Cloud CDN 則主要處理可快取的內容,不能替代長連線入口。入口選好後,再看後端:Cloud Run 與 GKE 都需要評估連線時長、狀態管理、擴縮和部署切換,不能只用「有 WebSocket」決定平台。
📝 考場提點
訊息分發和工作排程也要分開:一個事件要讓多個下游各自處理,可評估 Pub/Sub;若要把工作交給指定的 HTTP 目標,並控制排程與重試節奏,可評估 Cloud Tasks。兩者都可能重複投遞,不能把「工作只執行一次」當成平台保證。至於已讀狀態、訊息順序與交易金額,各自需要的延遲和一致性不同,應先訂清楚資料語意,再選 Firestore、Spanner 或其他儲存方式。
常見誤解
- 「每則訊息都要為每位收件者存一份。」 Slack 公開的 channel 架構把共用訊息與推播分開處理2。做類似系統時,先分清訊息的權威儲存與連線上的扇出;若另有個人化收件匣需求,再評估是否需要額外的資料副本。
- 「有即時需求就全部改用 WebSocket。」 頻繁的雙向訊息適合長連線;登入或上傳等一次性操作,HTTP 往往更單純。WebSocket 仍要維護連線、重連與部署切換,不能只比較單次請求延遲。
- 「只看連線數就能估容量。」 閒置連線與高頻發訊的連線消耗不同。除了同時連線數,還要測每秒訊息量、扇出對象、序列化成本和重連尖峰,才知道瓶頸落在哪裡。
來源與延伸閱讀
- Flannel: An Application-Level Edge Cache — Slack Engineering — 2017 年邊緣快取設計原文。
下一篇:經典架構拆解 · 05 — Airbnb 搜尋與金流,來看一個完全不一樣的負載類型(搜尋排名 + 多幣別帳本)怎麼設計。
想看 PCA 現行的四個官方案例?到 PCA 案例研究庫 對照 Google 官方 case study。
🎯 換你練習
想動手設計類似系統?到 架構師設計工作坊 用這套思考步驟走一遍。
Footnotes
-
Slack reaches 10 million daily active users — Slack(官方最後一次公布 DAU 約在 2019–2020 年的 1,000–1,200 萬量級;Salesforce 併購後財報不再單獨揭露 Slack DAU)。付費組織與近年估算可參考 Slack Statistics — Business of Apps(第三方彙整,非官方財報數字)。 ↩
-
How Slack Built Shared Channels — Slack Engineering — 官方部落格解釋跨 workspace 的 channel 設計與 fanout。 ↩ ↩2 ↩3 ↩4
-
Slack Help Center — Workspace Limits — 官方文件列出的 workspace 與 channel 規模上限。 ↩
-
Scaling Datastores at Slack with Vitess — Slack Engineering — Slack 從 MySQL 轉 Vitess 的工程記錄。 ↩
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
經典架構拆解 · 06 — Discord 百萬人頻道與 NoSQL 選型
Discord 的頻道很熱鬧時,訊息、連線和語音怎麼撐住?從資料庫遷移與服務調整看它的選擇。
經典架構拆解 · 05 — Airbnb 搜尋排名與金流分帳
房源搜尋要排序,下單又要處理付款與信任問題。從 Airbnb 的公開案例看這幾套系統怎麼分工。
經典架構拆解 · 03 — Stripe API 冪等性設計
付款請求逾時後重送,怎麼避免重複扣款?從 Stripe API 的冪等鍵與 webhook 重試看做法。