經典架構拆解 · 01 — Netflix 全球串流架構
看影片時按下播放鍵,背後要解決的是「內容怎麼穩定送到使用者附近」。Netflix 的公開工程資料提供了不少例子,能拿來觀察快取、服務拆分與故障處理如何配合。
這是經典工程架構拆解系列的第一篇。閱讀時可以留意:每個技術選擇在解決哪一個使用者問題。
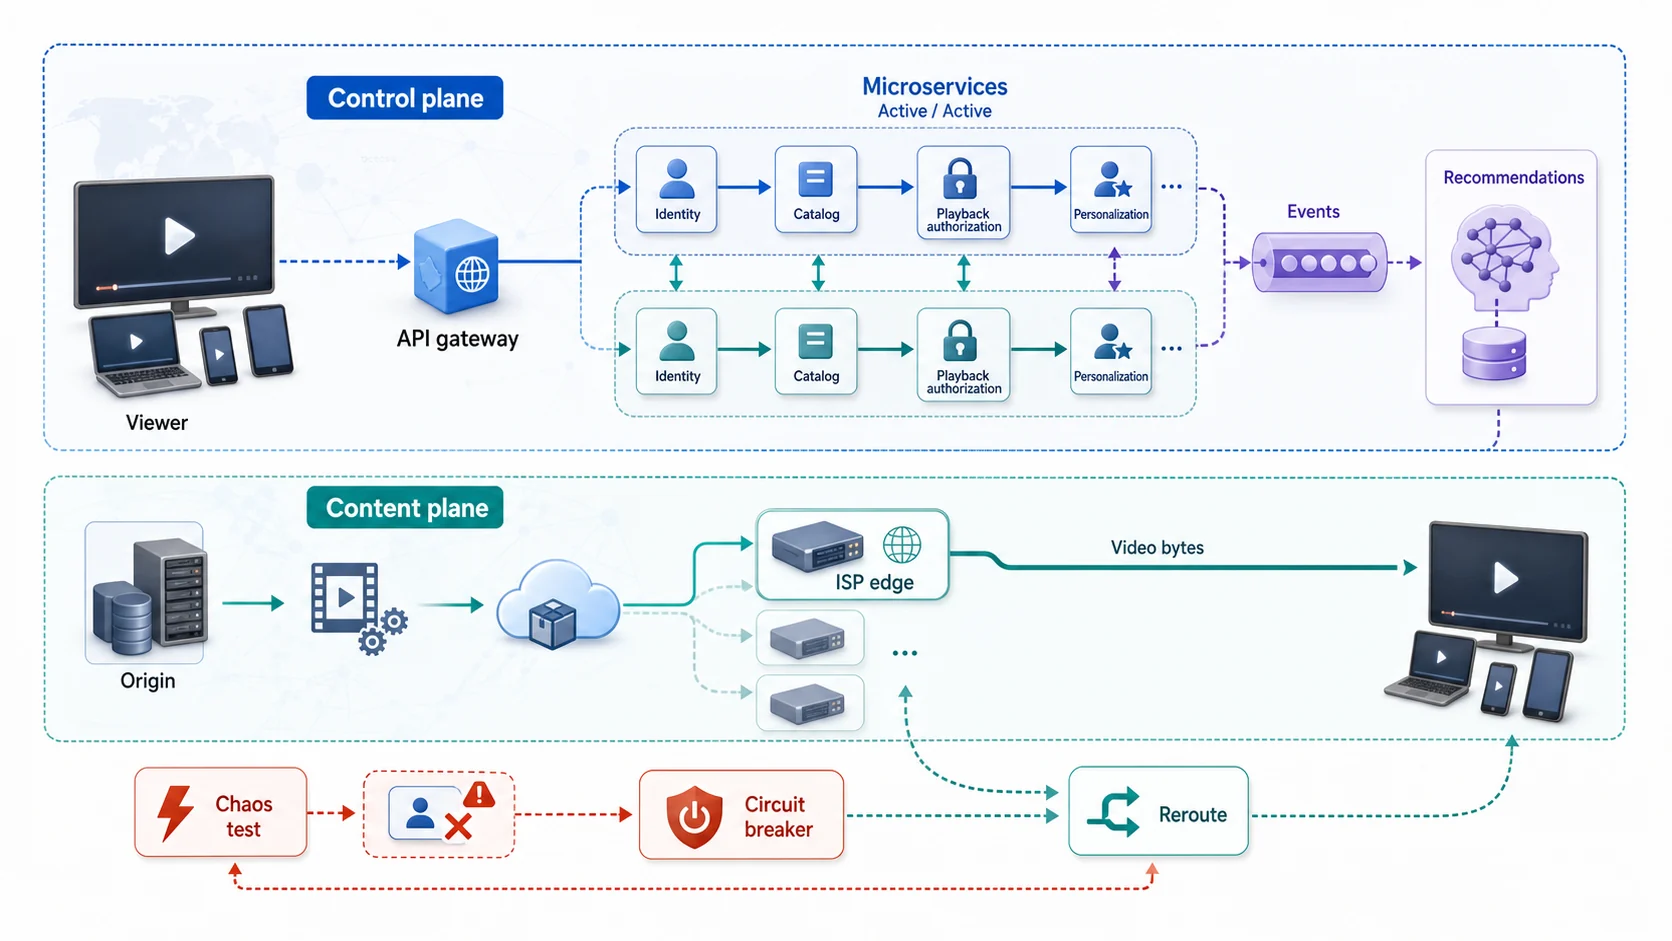
這套架構最重要的分界是「控制」與「內容」:控制面決定誰能播、播什麼並收集事件;占頻寬最大的影片位元則從 ISP 邊緣快取直送,不穿過微服務。Active-Active、熔斷與常態混沌測試處理的是控制面故障隔離,CDN 預熱與改道則保護內容交付路徑。
為什麼值得拆解
Netflix 從 2008 年資料庫崩潰那一刻開始,花了 7 年把自家服務搬上 AWS,後來又花了更久的時間,把整個平台拆成上千個微服務(microservices)。他們公開聊過的那些架構模式,像是 Open Connect CDN、Chaos Engineering、Zuul gateway、Hystrix 熔斷器(circuit breaker),幾乎都成了整個產業的教材。
這個案例適合拿來練習三件事:全球流量分散(global load distribution)、active-active 容錯、事件驅動架構(event-driven architecture)。閱讀時可以留意 Netflix 如何把影片交付與控制面的故障分開處理,再想想類似需求放到 Google Cloud 時,哪些設計原則能沿用,哪些產品選擇需要重新評估。
商業規模與壓力
根據 Netflix 2024 年 Q4 財報公開揭露,付費訂閱戶在 2024 年底超過 3.01 億,全球約 190 個國家有服務;單季營收約 102 億美元。根據 Sandvine 於 2023 年公開發表的《Global Internet Phenomena Report》,Netflix 流量長期占據北美下行網際網路頻寬前三名,部分時段可達總量的 14% 以上。
這種規模代表什麼意思?
- 任何一個微服務若失效 5 分鐘,就可能影響數百萬同時觀看的使用者。
- 單一資料中心(data center)無論多大,都裝不下全球的 ISP 流量,必須把內容推到離使用者最近的地方。
- 晚間尖峰時段,單一熱門影集(例如《魷魚遊戲》)可以在同一小時內被數千萬帳號同時點播。
規模大本身沒什麼好學的,真正要學的是怎麼把這種規模拆成一個個管得動的架構決策。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
sequenceDiagram
  participant V as Viewer
  participant C as 控制面 API
  participant M as Metadata/Recommendation
  participant E as ISP Edge Cache
  participant O as Origin
  V->>C: 登入、片單、播放授權
  C->>M: 讀取 catalog 與個人化結果
  M-->>C: 可播放內容與 manifest
  C-->>V: 授權+最近 edge 位置
  V->>E: 請求影片片段
  alt Edge cache hit
    E-->>V: 直接傳送影片 bytes
  else Edge cache miss
    E->>O: 回源取得片段
    O-->>E: 回傳並寫入快取
    E-->>V: 傳送影片 bytes
end 架構演進簡史
| 年份 | 里程碑 | 意義 |
|---|---|---|
| 2008 | 資料庫大規模損壞事件 | Netflix 決定不再自建資料中心,開始搬上 AWS |
| 2011 | 發布 Chaos Monkey | 首次把「主動讓 EC2 隨機關機」變成正式工程實踐 |
| 2013 | Zuul gateway 開源 | 把前端路由、認證、限流統一收攏到 API gateway |
| 2016 | 完成 AWS 遷移 | 最後一個地端資料中心關機,七年上雲計畫結束 |
| 2017–今 | Open Connect 深度嵌入 ISP | 全球 1,000+ ISP 直接在機房放 Netflix 快取盒 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
把這條演進線收斂成一張圖,整個系統的骨架大概長這樣:
Netflix 核心架構:影片走 Open Connect 直送各地 ISP;控制流經 Zuul 進入 AWS 上的微服務,行為事件走 Kafka 做離線推薦;Chaos Monkey 常態注入故障。
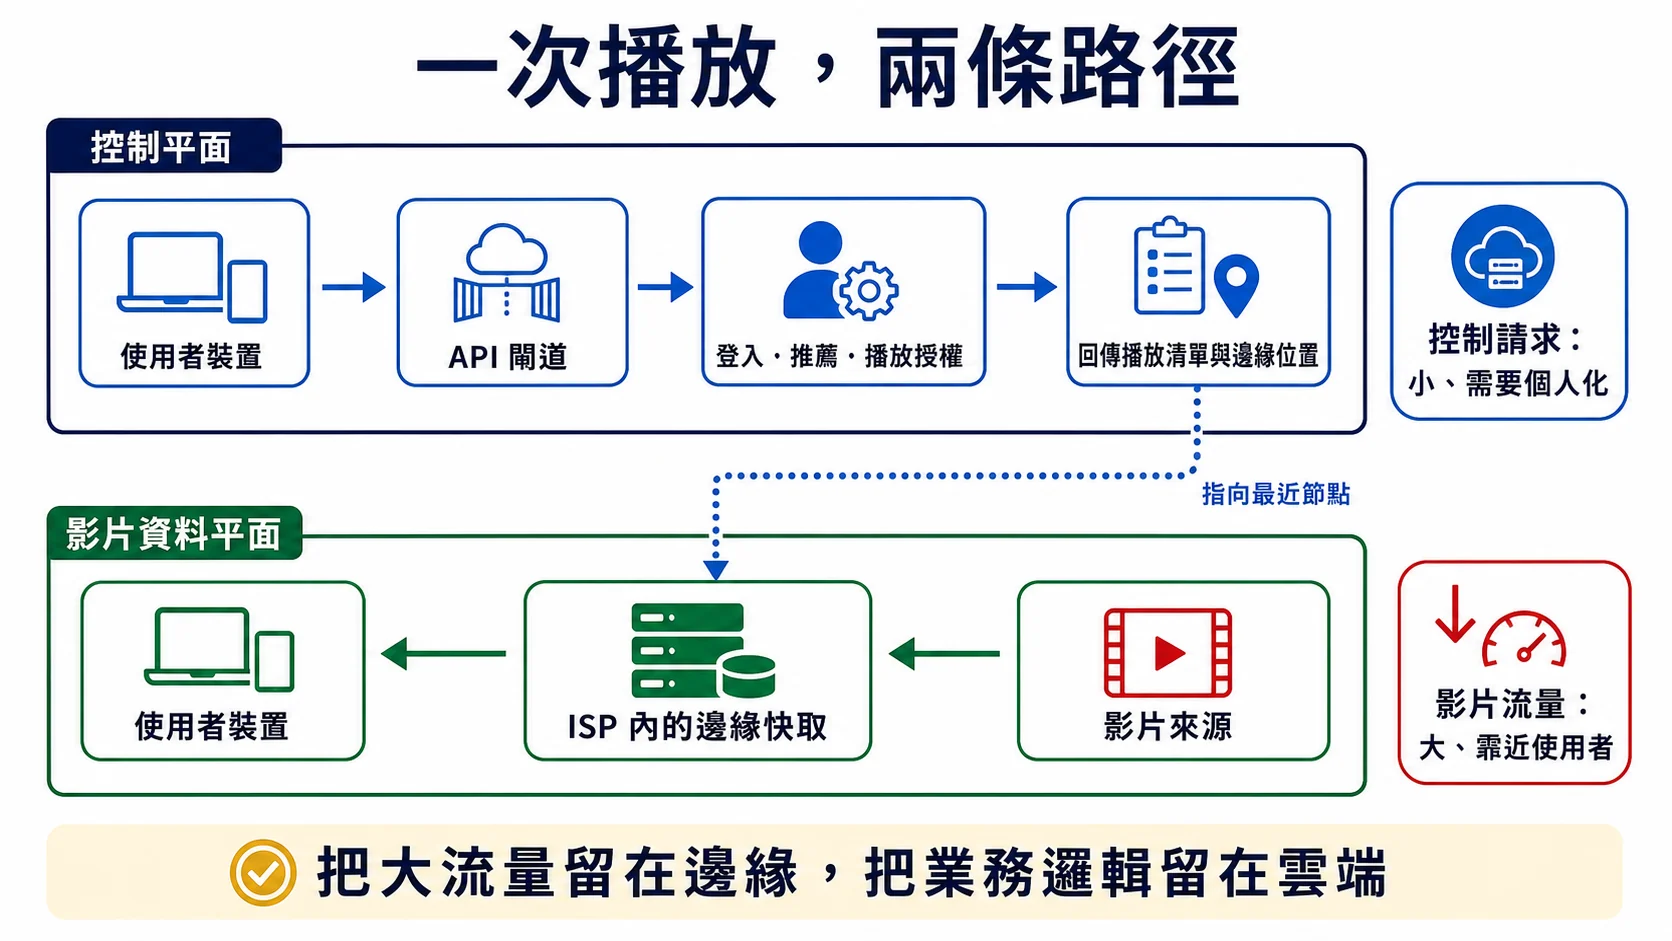
這是便於理解的概念模型:控制平面處理登入、推薦與播放授權;大流量影片則盡量由靠近使用者的邊緣快取供應。兩條路徑分開後,業務邏輯與媒體傳輸才能各自擴充。
核心技術決策
| 決策 | 為何這樣選 | 替代方案與為何沒選 |
|---|---|---|
| 影片走 Open Connect(與 ISP 合作部署快取) | 把熱門內容放得更靠近觀眾,減少長距離傳輸並改善播放體驗 | 只靠遠端來源傳影片:需要更多跨網路傳輸 |
| 播放控制服務使用 AWS | 播放請求先由控制服務判斷要取哪些檔案,再引導用戶端向合適的 Open Connect Appliance 取片段 | 讓每個邊緣節點獨立決策:較難統一控制與觀測 |
| 微服務 + Zuul gateway | 拆到幾千個服務,讓不同團隊能獨立部署;gateway 統一處理路由、認證、限流 | 單體或粗粒度 SOA:部署頻率被互相阻擋 |
| 主動混沌工程(Chaos Monkey / Simian Army) | 與其被動等故障發生,不如每天在正式環境(production)隨機拔插頭,強迫所有服務具備容錯 | 僅做 staging 測試:staging 永遠無法重現真實流量與依賴圖 |
| 推薦與個人化用 event-driven + 離線訓練 | 使用者行為量太大,無法同步處理;用 Kafka 匯流後離線建模、線上推論 | 全線即時:延遲與成本都不可行 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
這張表提醒我們,影片流量增加時,傳輸成本和播放體驗會一起受到影響。若一個媒體網站直接從物件儲存對外提供熱門影片,流量突然增加時,對外傳輸費用也可能跟著上升。加入 CDN 後,重複觀看的片段可從邊緣快取提供;但能省多少,仍取決於快取命中率、取回費用與使用者分布。Netflix 的規模不同,Open Connect 也不只是替普通網站「加一層 CDN」;這裡借它提醒我們,設計影片服務時要把內容放在哪裡與流量怎麼走一起算。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  A["新影片完成多規格編碼<br/>與切片"] --> B["依地區需求預測熱門度"]
  B --> C["離峰時預先填入 ISP Edge"]
  U["Viewer 請求下一個片段"] --> D{"Edge cache hit?"}
  C --> D
  D -->|"是"| E["從近端直接傳送"]
  D -->|"否"| F["回 Origin 取片"]
  F --> G["回傳 Viewer 並寫回 Edge"]
G --> D 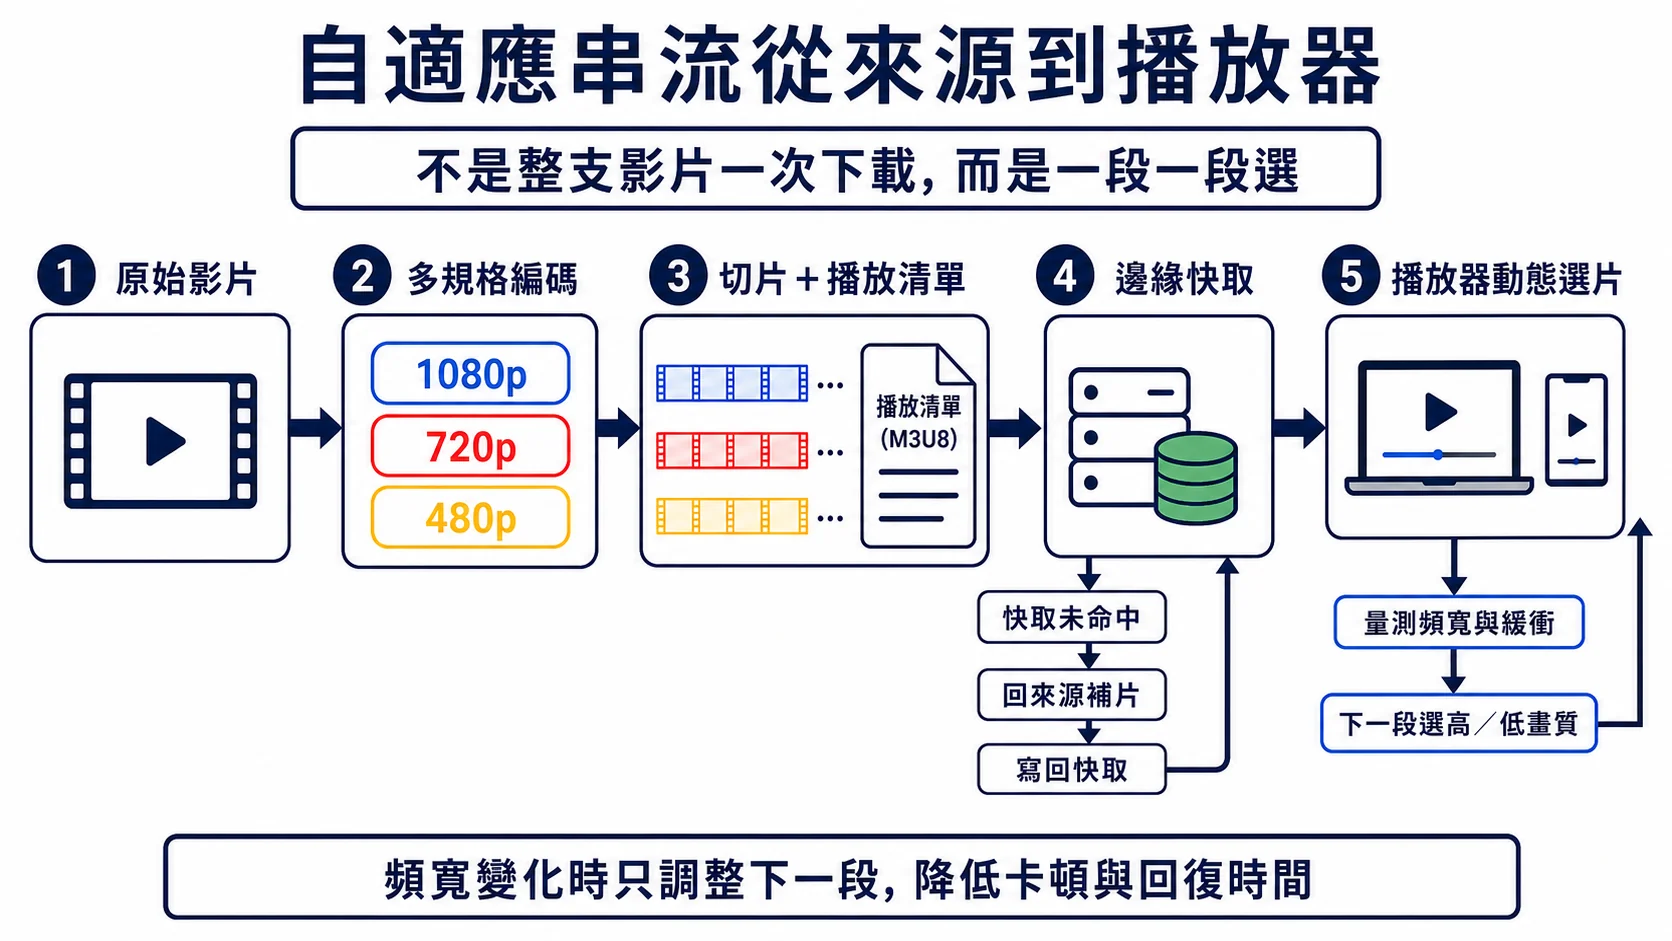
自適應串流不會一次下載完整影片,而是把內容切成短片段。播放器每次量測頻寬與緩衝,只調整下一段的畫質;邊緣快取未命中時才回來源補片並寫回快取。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  A["量測目前頻寬、buffer<br/>與最近下載時間"] --> B{"下一段可安全使用<br/>哪個 bitrate?"}
  B -->|"頻寬下降/buffer 偏低"| C["選較低畫質片段"]
  B -->|"狀況穩定"| D["維持目前畫質"]
  B -->|"頻寬充足/buffer 健康"| E["嘗試較高畫質片段"]
  C --> F["下載並播放下一段"]
  D --> F
  E --> F
F --> A 如果用 GCP 重新蓋
若今天要在 GCP 上重蓋類似平台,可以這樣對應:
- 邊緣內容分發: Cloud CDN + Media CDN,搭配 Cross-Cloud Interconnect 拉到主要 ISP;真正重度的 ISP 嵌入仍需自建,GCP 端提供來源(origin)層。
- 微服務平台: GKE(regional cluster)+ Cloud Service Mesh(原 Anthos Service Mesh),用 Istio 做統一路由、mTLS、限流,取代 Zuul + Hystrix 的角色。
- 事件匯流: Pub/Sub 作為行為日誌與服務間事件的主幹線。
- 中繼資料(metadata): Spanner(強一致、多區)存影片 catalog、使用者狀態;Bigtable 存 time-series 的觀看事件。
- 離線分析與推薦訓練: BigQuery + Dataflow + Gemini Enterprise Agent Platform(原 Vertex AI)。
- 容錯演練: GCP 沒有對等 AWS Fault Injection Service 的原生託管服務,可用 Chaos Toolkit(含 GCP driver)或自建 Kubernetes 層 chaos controller(如 Chaos Mesh)。
這份對應表的用途,是練習把業務需求轉成架構選擇。換到另一朵雲時,先找相同的責任分工,再查服務限制與實際操作方式,不必從產品名稱開始硬背。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  A["定義可接受影響與 SLO"] --> B["選擇 instance、zone<br/>或 dependency 故障"]
  B --> C["在受控範圍注入故障"]
  C --> D["觀察 reroute、retry、<br/>circuit breaker<br/>與使用者影響"]
  D --> E{"SLO 仍達標?"}
  E -->|"否"| F["修正隔離、容量、<br/>降級與 runbook"]
  F --> A
  E -->|"是"| G["擴大下一輪<br/>實驗範圍"]
G --> A 📝 考場提點
全球使用者感到延遲時,先分清慢的是影片等內容交付,還是登入、推薦等動態請求。可快取的大型內容可以評估 Cloud CDN/Media CDN;跨區域的動態流量則可評估全域外部 Application Load Balancer 與多區域後端。兩者處理的流量不同,通常要搭配,而不是互相替代。
若打算用多個區域入口加 DNS 導流,還要自行處理健康檢查、切換時間與快取行為;若只擴大單一資料中心,遠端使用者的網路距離也不會因此縮短。選方案前先量測各地延遲,再確認瓶頸落在哪一層。
常見誤解
- 「Netflix 的影片都由 AWS 直接傳給觀眾」 —— 播放控制服務會選擇檔案來源,但影片片段可由 Open Connect Appliance 直接提供。分清控制請求與內容傳輸,才看得懂網路成本和快取策略。(參考:Netflix Open Connect 總覽)
- 「做過一次故障演練就夠了」 —— 服務、依賴和流量會改變。容錯設計需要持續驗證,而不是只保留一份曾經通過的測試結果。
- 「微服務越多越好」 —— 拆分能讓團隊各自開發,但也增加服務發現、路由、逾時和故障追蹤工作。先確認團隊有沒有能力承擔這些工作,再決定切多細。
想像訂單 API 在同一條請求裡同步呼叫寄信服務:只要郵件供應商變慢,結帳回應也會跟著拖延。確認信若不必在交易完成前送達,就可以改由佇列和背景工作處理。判斷是否需要解耦,重點是下游失敗時,上游能不能先完成自己的工作。
📝 考場提點
若案例要求整個 region 故障後仍快速服務,先確認 RTO、RPO 和切換時是否允許部分請求失敗。Active-Active 可以縮短切流量的時間,但資料怎麼同步、故障區恢復後怎麼對帳,仍需另外設計;不是前面加了 global LB、後面換成 Spanner 就自動完成 DR。自動切換也要定期演練。
若下游變慢會拖住使用者請求,先問這一步是否真的需要同步完成。可以延後處理的通知或索引更新,才適合改用 Pub/Sub 等非同步方式;付款、庫存確認等路徑,仍要設計清楚何時能回覆使用者,以及失敗後如何補償。
來源與延伸閱讀
- Netflix TechBlog — Netflix 公開工程部落格,Open Connect、Hystrix、Chaos Monkey 原始說明皆在此。
- Netflix Open Connect 官網 — Netflix 對 ISP 說明自家 CDN 的官方頁面,含硬體規格與嵌入流程。
- Chaos Monkey GitHub — 開源 repo 與設計文件。
- Sandvine Global Internet Phenomena Report 2023 — 公開引用的全球網路流量年度報告,內含 Netflix 占比數據。
- Netflix Q4 2024 Shareholder Letter — 訂閱戶、營收等財報數字引用來源。
下一篇:規模一樣大,但問題完全不同的Uber 即時派單架構,看他們怎麼用地理分片,搞定「每秒鐘成千上萬次的司機與乘客配對」。
🎯 換你練習
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
經典架構拆解 · 06 — Discord 百萬人頻道與 NoSQL 選型
Discord 的頻道很熱鬧時,訊息、連線和語音怎麼撐住?從資料庫遷移與服務調整看它的選擇。
經典架構拆解 · 05 — Airbnb 搜尋排名與金流分帳
房源搜尋要排序,下單又要處理付款與信任問題。從 Airbnb 的公開案例看這幾套系統怎麼分工。