
經典架構拆解 · 05 — Airbnb 搜尋排名與金流分帳
Airbnb 一邊連著房東,一邊連著房客。使用者要先找到合適的房源,接著確認能不能訂、款項怎麼處理,平台還得處理信任與安全。這些流程相連,背後卻需要不同的資料與交易設計。
這是 經典工程架構拆解 系列的第 5 篇,上一篇看了 Slack 的 WebSocket 與已讀同步。
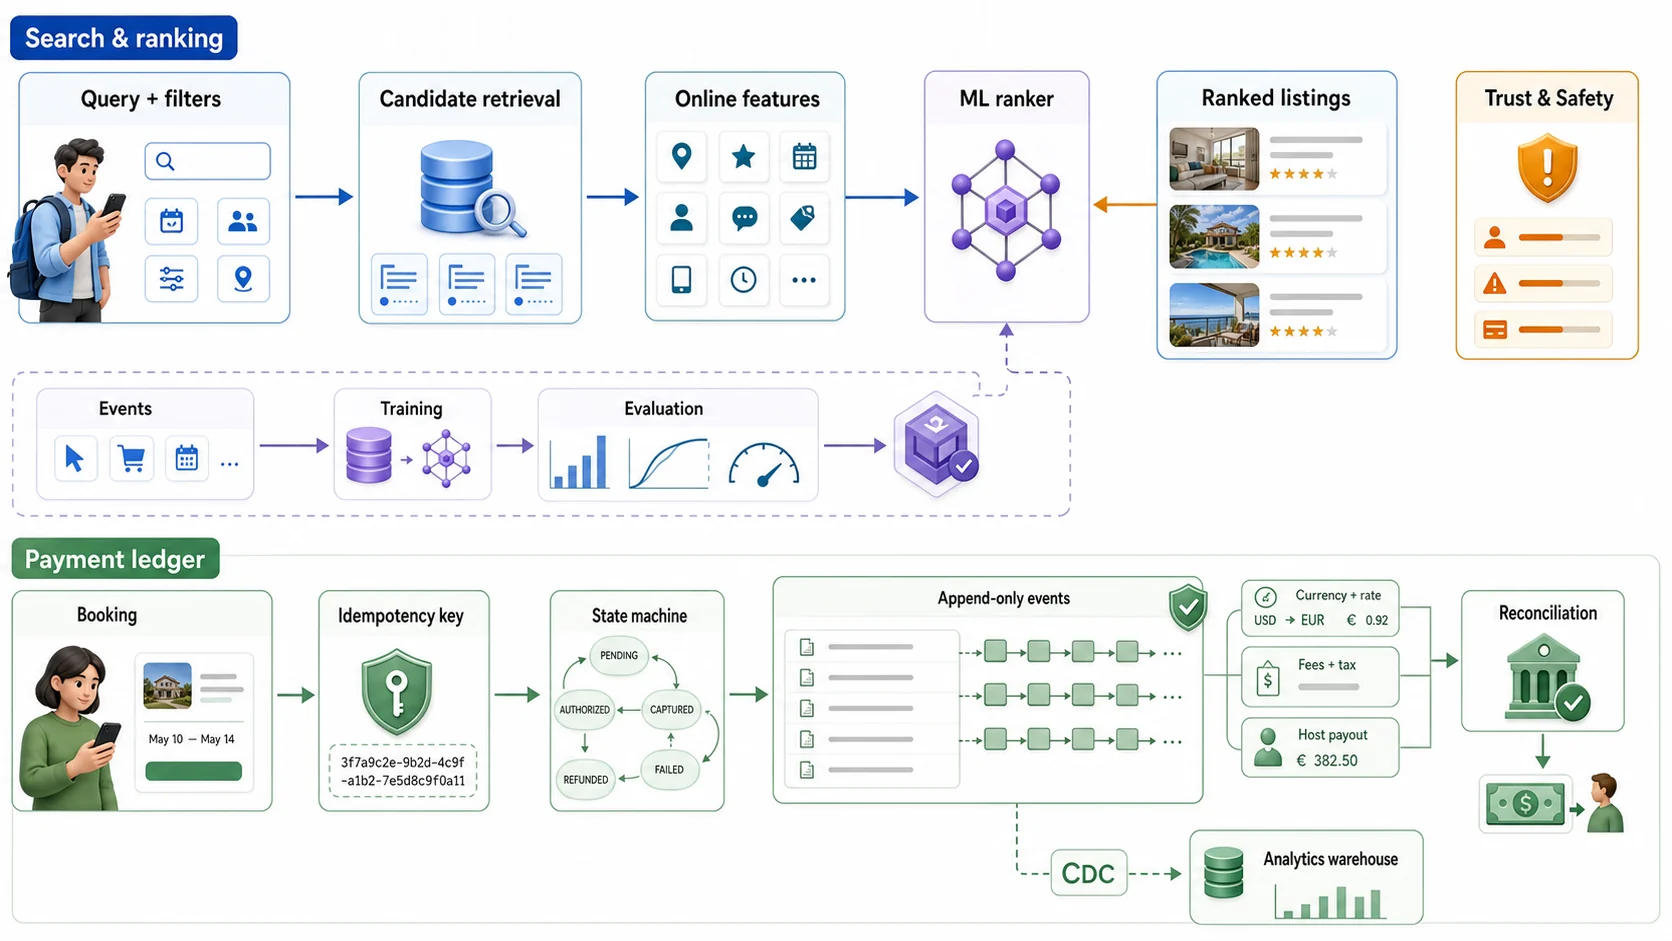
搜尋先召回候選,再以線上特徵與 ML 排名,離線訓練回饋模型;它與要求強一致的付款交易是兩條獨立路徑。金流以冪等鍵保護重試,狀態機約束轉移,append-only ledger 才是不可竄改的帳務事實來源;分析資料由 CDC 複製,不反向承擔交易責任。
為什麼值得拆解
找住宿不只是在房源文字裡比對關鍵字。房客選的日期、地點與人數會影響哪些房源可訂,價格和排序還可能受其他條件影響。因此搜尋結果要同時顧及資料新鮮度與回應速度;這也是 Airbnb 案例值得拆解的地方。
付款這側還要處理不同幣別、平台費用、稅費與房東收款。訂單成立和款項分配不是同一個動作;把兩者的狀態與失敗處理分開,才能看清楚「訂到房了,但付款或撥款沒完成」時該怎麼補救。
商業規模與壓力
根據 Airbnb 2023 年報與公開技術演講:
- 全球掛牌房源超過 770 萬間,分佈在 10 萬個城市(Airbnb 2023 10-K 年報)1。
- 2023 年全年訂房夜與體驗數超過 4.48 億晚,代表平均每秒約 14 筆預訂(同上年報)1。
- 支援超過 40 種結算幣別,信用卡收單橫跨多個地區的 PSP(payment service provider)(Airbnb Engineering Blog 多篇)2。
搜尋與付款面對的壓力不同:搜尋要在可接受的等待時間內篩選、排序房源,還要處理價格與空房資訊的變動;付款則要把狀態、重試與對帳記清楚。兩段流程可以互相交換結果,但不適合只用同一套延遲和一致性要求衡量。接下來分開看它們各自要解決的問題。
架構演進簡史
| 階段 | 年份(約) | 關鍵變化 |
|---|---|---|
| Monolithic Rails + MySQL | 2008–2014 | 整個 Airbnb.com 跑在一套 Rails monolith 上 |
| SOA(Service Oriented Architecture) | 2014–2018 | 拆成數百個服務,內部稱為 “Great Migration”(Airbnb Engineering Blog 公開系列)3 |
| Search ML 導入 GBDT → Deep Learning | 2015–2019 | 搜尋排名從手寫權重改用 Gradient Boosted Decision Tree,後改 Deep Learning(Airbnb KDD 2018 論文)4 |
| Payment Ledger 獨立服務 | 2015 以後 | 把所有金流狀態變動抽成 event-sourced ledger(Airbnb Engineering Blog “Avoiding Double Payments”)5 |
| Data Mesh 與 Dataportal | 2019 以後 | 資料治理平台 Dataportal,讓搜尋與 ML 特徵共享 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
整理成一張圖,搜尋與金流這兩條主線的關係就清楚了:
Airbnb 搜尋與金流:搜尋走 ML 排名,訂房寫入帶冪等的 Payment Ledger 再落交易資料庫,並串接 Trust & Safety 風控。
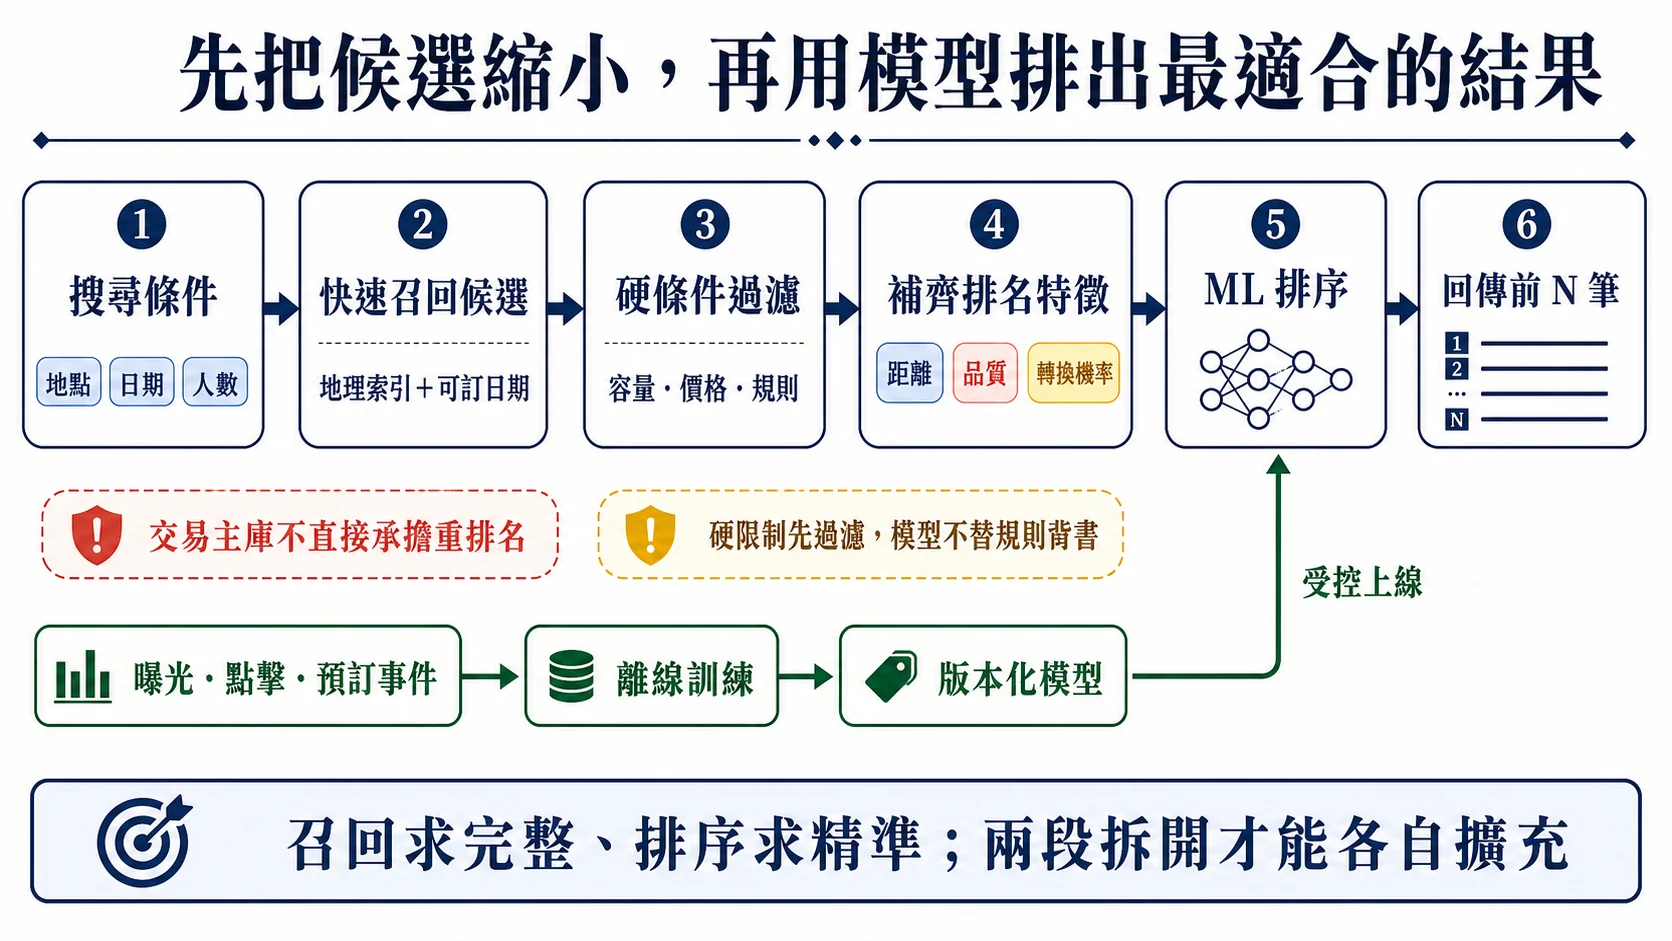
搜尋管線把「找得到」與「排得好」拆成兩段:召回階段追求完整,先縮小候選;排序階段才用較昂貴的特徵與模型追求精準。曝光、點擊與預訂事件則回到離線訓練,經版本化後受控上線。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  Q["Query+日期+<br/>地點+篩選條件"] --> R["Candidate retrieval<br/>地理、可訂、<br/>價格、關鍵字"]
  R --> C["數百筆候選房源"]
  U["User/trip context"] --> F["Online features"]
  L["Listing quality、<br/>歷史互動、<br/>host 與市場訊號"] --> F
  C --> M["Learning-to-rank model"]
  F --> M
  M --> S["排序分數"]
  S --> P["政策與業務規則後處理"]
  P --> O["可顯示的搜尋結果"]
核心技術決策
| 決策 | 為何 | 替代方案 |
|---|---|---|
| 搜尋排名用 learning-to-rank | 規則太多,手寫權重無法維護 | 純關鍵字比對(體驗差) |
| Payment Ledger 採 event sourcing | 金流要能回溯、對帳、合規稽核 | 直接改餘額(無法追蹤歷史) |
| 跨服務付款用冪等 key + 狀態機 + 三階段 RPC | 訂單成立與扣款必須一致,且要能安全重試 5 | 兩階段提交(2PC,Airbnb 未採用,協調者單點且難擴展) |
| 搜尋走專屬 ML 服務 | 排名計算重,與交易型資料庫分流 | 把排名計算放在主庫查詢(容易與交易負載爭用資源) |
| 多幣別在 ledger 層處理 | 避免每個服務自己轉匯、誤差累積 | 每個服務各自轉(最後對不起來) |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
金流的關鍵設計: Airbnb Engineering Blog 那篇 “Avoiding Double Payments in a Distributed Payments System” 講得很清楚,他們是用冪等 key + 狀態機 + retry這組合來防重複扣款。思路其實跟 Stripe 的冪等性設計很像,只是搬到雙邊市場來用5。
小型平台也會遇到類似的對帳問題。假設付款成功就直接改使用者餘額,卻沒有留下每次加減的紀錄;碰到重複送出、支付閘道重試或退款時,很難追查目前的餘額是怎麼算出來的。
Ledger 的做法是保留每筆金額變動,再由交易紀錄推導或核對餘額。這讓退款、重試和對帳都有跡可循;即使另外儲存目前餘額,也能用不可變的紀錄檢查它是否正確。Airbnb 的規模與多幣別需求更複雜,但「變動要留痕跡」這個原則相同。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  B["Booking confirmed"] --> P["追加 Guest payment event"]
  P --> F["追加 Platform<br/>fee event"]
  F --> H["追加 Host<br/>payable event"]
  X["Refund/Adjustment"] --> E["追加新事件<br/>不覆寫舊紀錄"]
  P --> L["Immutable ledger"]
  F --> L
  H --> L
  E --> L
  L --> G["摺疊事件得到<br/>Guest balance"]
  L --> A["摺疊事件得到<br/>Platform balance"]
  L --> O["摺疊事件得到<br/>Host balance"]
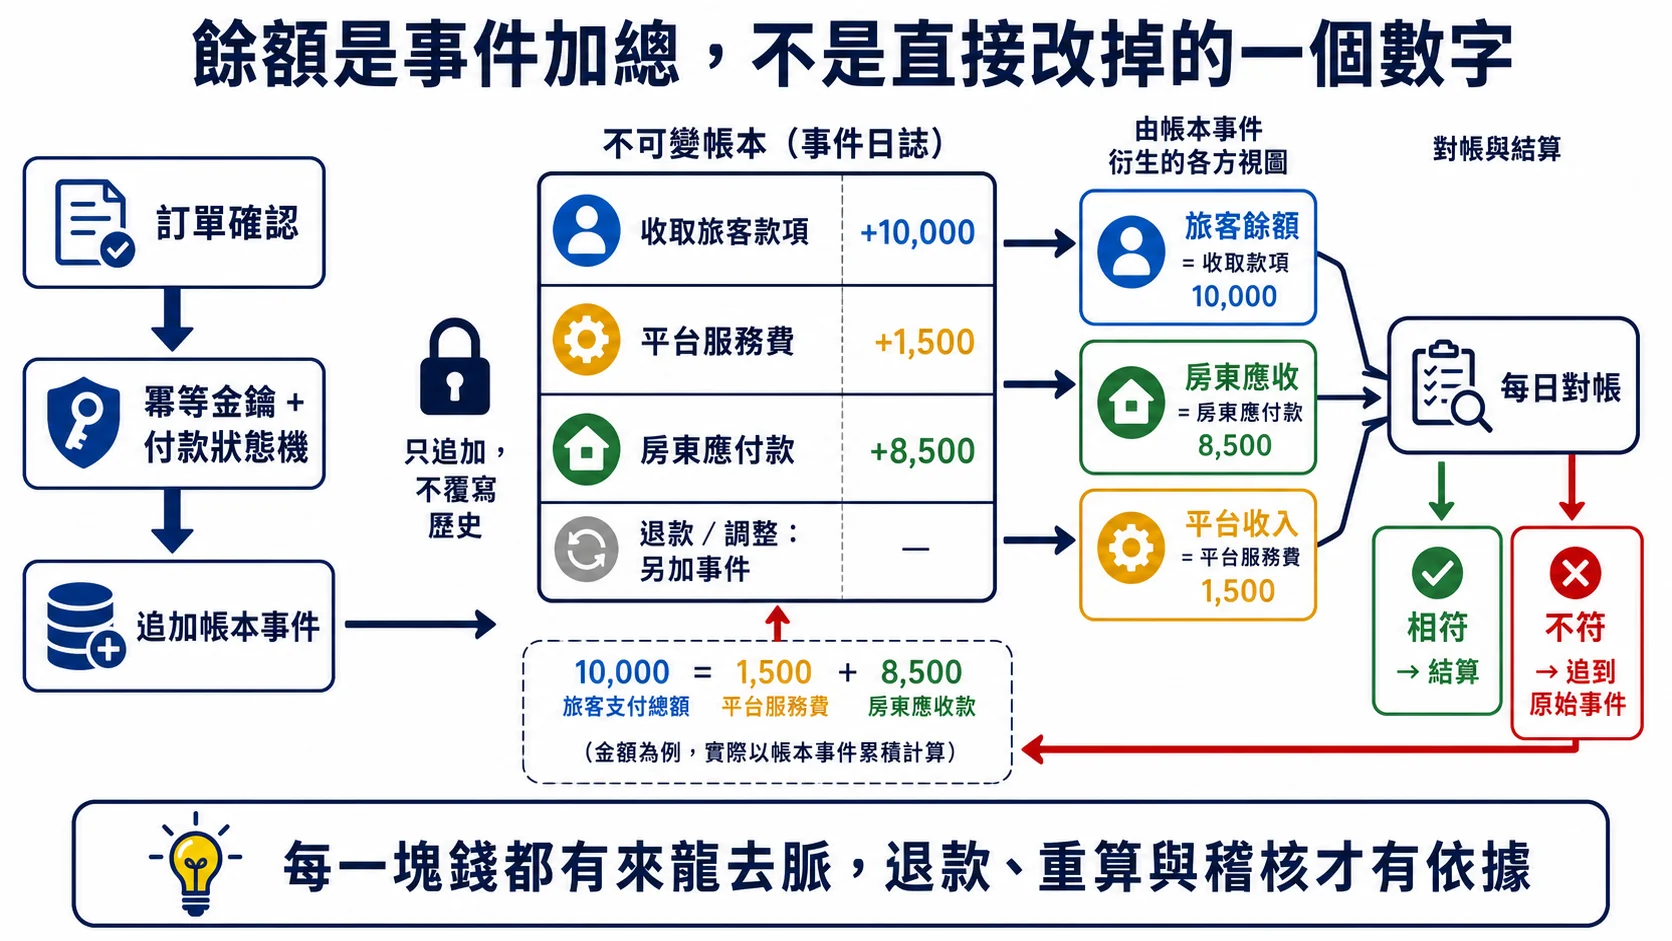
這是簡化的雙邊市場帳本模型,圖中金額僅為示例。餘額由不可變事件累積而成,退款與調整也以新事件追加;對帳不符時便能一路追到原始紀錄,而不是猜哪次覆寫出了錯。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  L["Internal ledger events"] --> I["依 currency、<br/>processor、date 匯總"]
  P["Payment processor<br/>settlement"] --> X["取得外部清算明細"]
  I --> C{"金額、筆數與狀態<br/>是否一致?"}
  X --> C
  C -->|"是"| S["標記 reconciled"]
  C -->|"否"| D["定位 missing、<br/>duplicate、timing<br/>或 FX difference"]
  D --> R["追加調整事件或人工處理"]
R --> C 如果用 GCP 重新蓋
| Airbnb 元件 | GCP 對應 |
|---|---|
| 搜尋排名 ML 模型訓練 | Agent Platform Managed Training(原 Vertex AI Training),特徵存 BigQuery + Feature Store |
| 線上推論 | Agent Platform Inference(原 Vertex AI Prediction)或 GKE + TensorFlow Serving |
| 候選房源索引 | Elasticsearch on GKE 或 Agent Search(前身為 Vertex AI Search) |
| Payment Ledger | Cloud Spanner(跨 region 強一致 + 交易) |
| 訂單資料 | Spanner 或 Cloud SQL(依跨 region 需求) |
| 分析與對帳 | BigQuery + Dataflow 做 CDC 抽 ledger |
| 信任與風控 | Gemini Enterprise Agent Platform(簡稱 Agent Platform,原 Vertex AI)訓練詐欺偵測模型 + reCAPTCHA Enterprise |
| PII 保護 | Sensitive Data Protection(原 Cloud DLP)掃信用卡號、身分證;CMEK(客戶自管金鑰)加密 |
| 多區影像與房源照片 | Cloud Storage + Cloud CDN + Imagen API 做自動描述 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  A["Booking/Payment/Ledger writes"] --> S["Spanner/Cloud SQL<br/>OLTP 強一致交易"]
  S --> C["CDC/Dataflow"]
  C --> B["BigQuery<br/>OLAP 報表、<br/>對帳與歷史分析"]
  B --> D["Dashboard/Finance/ML features"]
  D -. "新模型與業務洞察" .-> A
  Q["大量分析查詢"] -. "不直接壓在交易資料庫" .-> B
把案例拿來練選型
這個案例同時有交易、分析和搜尋需求。把它們拆開看,比直接找一套「全包」產品更有幫助。
📝 考場提點:先界定哪些交易真的要跨區
若多個地區都要更新同一份交易資料,且提交後必須維持一致,Spanner 值得比較。但「有全球用戶」不代表每筆交易都跨區寫入;還要問資料模型、寫入地點、延遲和成本。
營收報表和線上交易也不必擠在同一條查詢路徑。可以從交易來源同步到 BigQuery 等分析系統;中間是否需要 Dataflow,取決於變更資料怎麼取得、更新延遲和轉換複雜度。先分清 OLTP 與 OLAP 的工作負載,不必預設固定的三個產品組合。
📝 考場提點:分開看模型部署與資料存取
搜尋排名、推薦與詐欺偵測都會用到模型,但訓練、線上推論和特徵管理是不同階段。若團隊想減少平台維運,可先評估 Agent Platform 的對應服務;若有特定框架、硬體或部署限制,再比較自建環境。先把需求拆開,才不會把整條 ML 流程當成一個產品來選。
分析團隊若需要使用資料,卻不應看到信用卡號或身分證等個資,可以評估去識別化與欄位層級權限。是否要另外產生資料副本,還得考慮同步、保存期限與存取控管;不能只因為資料已遮罩,就認為後續不必保護。
常見誤解
- 「搜尋排名就是 Elasticsearch。」 搜尋系統通常先找出符合條件的候選房源,再依相關性與業務目標排序。Airbnb 的公開論文把候選召回與後續 ML 排序分開討論4;不能只看搜尋引擎,就以為已經理解整套排名流程。
- 「多幣別只要在下單時查匯率。」 還要保存交易當時使用的匯率、原始幣別和結算幣別,讓日後退款與對帳能回到同一筆交易的計算依據;不能事後用新的匯率重新推算舊帳。
- 「把事件寫進 Kafka 就是 event sourcing。」 Event sourcing 要把事件當成權威紀錄,並定義如何依事件重建狀態;Kafka 可以參與傳遞事件,卻不會自動替你處理事件版本、重播與稽核。是否保存快照,也是實作時要另外決定的事。
來源與延伸閱讀
下一篇(本系列最終篇):經典架構拆解 · 06 — Discord 百萬人頻道與 NoSQL 選型,看另一種極端的即時通訊架構怎麼從 Cassandra 換到 ScyllaDB。
需要對照官方 case study?到 PCA 案例研究庫。
🎯 換你練習
想動手設計類似系統?到 架構師設計工作坊 用這套思考步驟走一遍。
Footnotes
-
Airbnb 2023 Annual Report (10-K) — 官方財報中揭露的房源數、訂房晚數、營收規模。 ↩ ↩2
-
Airbnb Engineering Blog — 官方工程部落格,搜尋、金流、ML 多篇公開文章來源。 ↩
-
Our Journey Towards a Production-Ready Service-Oriented Architecture — Airbnb Engineering — Monolith 拆 SOA「Great Migration」的工程記事。 ↩
-
Real-time Personalization using Embeddings for Search Ranking at Airbnb — KDD 2018 論文 — 搜尋 embedding 與排名架構的正式論文。 ↩ ↩2
-
Avoiding Double Payments in a Distributed Payments System — Airbnb Engineering — 官方介紹冪等性與狀態機如何避免重複扣款。 ↩ ↩2 ↩3
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
經典架構拆解 · 06 — Discord 百萬人頻道與 NoSQL 選型
Discord 的頻道很熱鬧時,訊息、連線和語音怎麼撐住?從資料庫遷移與服務調整看它的選擇。
經典架構拆解 · 03 — Stripe API 冪等性設計
付款請求逾時後重送,怎麼避免重複扣款?從 Stripe API 的冪等鍵與 webhook 重試看做法。