負責任 AI:隱私與安全

課程概述
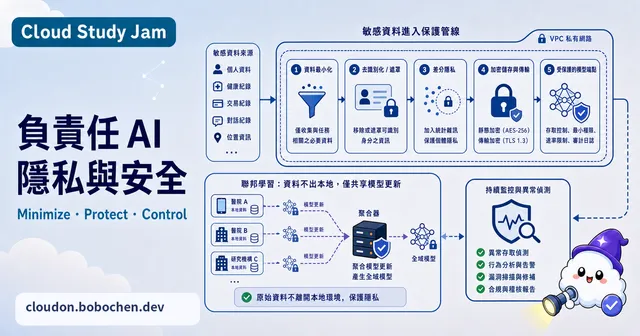
做 AI 不代表所有使用者資料都該收、都該拿去訓練。隱私設計的第一步通常是少收一點、用途說清楚、保存時間縮短,再依風險決定要不要去識別、加上差分隱私或把資料留在本地。這堂課會沿著資料從收集、處理、訓練、推論到刪除的路徑,說清楚每一道防護在擋什麼,又有哪些事情不能只靠雲端工具代勞。
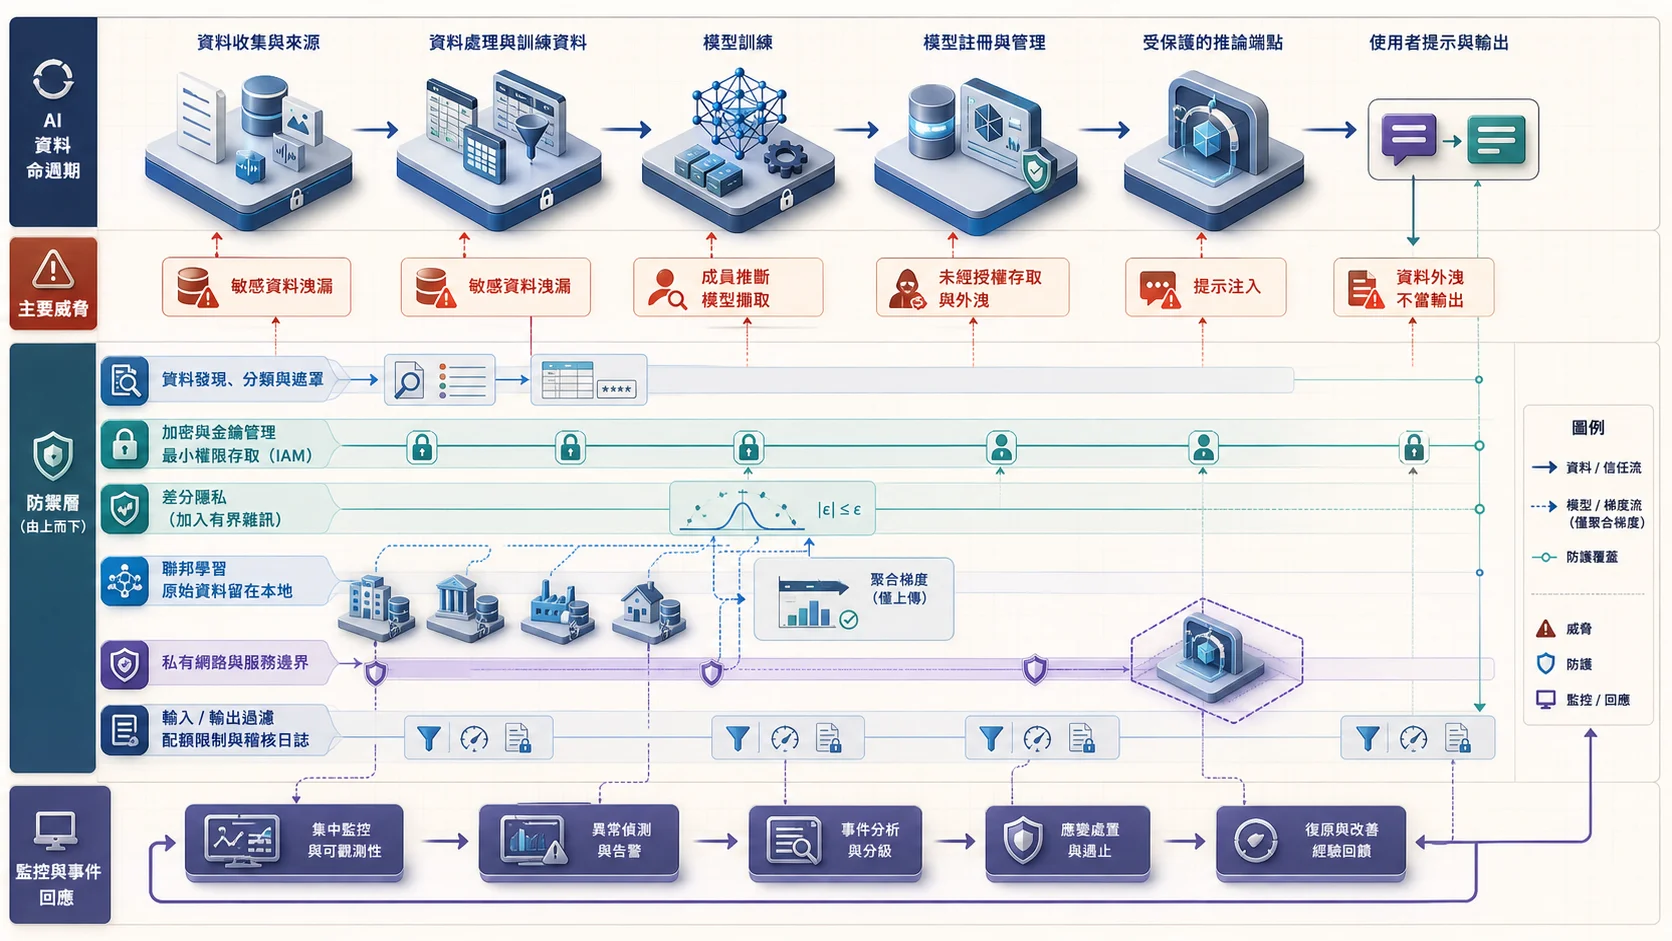
隱私與安全要沿資料生命週期分層處理:先做資料最小化與去識別,再用加密、最小權限和服務邊界保護存取;到了推論端,Prompt、工具和輸出仍要另外驗證。沒有任何一層可以單獨包辦全部風險。
你將學到
- 分清楚隱私風險、機密性風險與模型完整性風險
- 理解差分隱私的隱私預算與效用取捨,以及聯邦學習的限制
- 使用 Sensitive Data Protection 偵測、分類與去識別敏感資料
- 搭配 IAM 與 VPC Service Controls 建立縱深防禦
- 正確判讀 Vertex AI 的訓練限制、資料保留條件與自身合規責任
核心概念
先把不同風險分開看
**模型反推(Model Inversion)與成員推論(Membership Inference)**關心的是能否從模型行為推回敏感特徵,或猜出某筆資料是否在訓練集中。Prompt Injection則是把不可信內容偽裝成指令,試圖影響模型或代理程式,進而讀取上下文、呼叫工具或外傳資料;它不等於一定能取得訓練資料。**資料投毒(Data Poisoning)**主要破壞模型或知識庫的完整性,也可能留下後門。分類清楚後,才不會拿資料遮蔽去解權限問題,或把安全篩選器誤當成隱私保證。
差分隱私(Differential Privacy)
差分隱私不是承諾「完全不會洩漏任何人」,而是用 ε(epsilon)與 δ(delta)界定:加入或移除一個人的資料時,輸出分布最多能改變多少。訓練常見做法是限制每筆樣本的梯度,再加入校準過的噪聲,同時累計整個流程花掉的隱私預算。通常預算越嚴格,需要的噪聲越多,模型效用也可能下降;如果 clipping、取樣或預算會計做錯,寫著「使用差分隱私」也不代表保證成立。
聯邦學習不是差分隱私的同義詞
聯邦學習讓原始資料留在裝置或各機構端,中央端接收模型更新或彙整結果。它能減少集中搬運原始資料,卻不代表更新內容本身無法洩漏資訊,也擋不住惡意參與者。實務上常搭配安全彙整、差分隱私、裝置驗證與更新異常偵測,並釐清誰能參與、更新保存多久以及如何撤回。
機密資料保護(Sensitive Data Protection,原 Cloud DLP)的角色
Sensitive Data Protection 可以發現、分類與去識別 Google Cloud 內外的敏感資料,支援預先定義的 infoType,也能設定自訂偵測條件。轉換方式包含遮蔽、刪除、取代、分桶與 Tokenization。它適合放在資料落地或訓練前,也能檢查日誌、Prompt 與模型輸出;但偵測會有誤判與漏判,設定也應依台灣身分證字號、公司內部代碼等實際資料校準,而不是掃過一次就當成合規。
VPC Service Controls
VPC Service Controls 能替支援的 Google Cloud 服務建立情境式服務邊界,限制資料跨出信任範圍,並降低外洩風險。它和 IAM 解的問題不同:IAM 管「哪個身分能做什麼」,VPC Service Controls 再管請求來自哪裡、資料能往哪裡走。兩者應一起用,也要先以 Dry Run 看實際流量。不是所有服務與操作都支援,錯誤的 IAM、應用程式本身的漏洞和已獲准身分的濫用,也不能只靠服務邊界消失。
Google Cloud 的資料承諾要連條件一起讀
依Vertex AI 資料保留說明,Google 不會在未經客戶事先允許或指示下,用客戶資料訓練或微調 AI/ML 模型,這項限制涵蓋 Vertex AI 上的受管模型。不過「不拿來訓練」和「完全不保留」是兩件事;部分功能可能因濫用監控、快取、Grounding 或其他服務條件而有限期保留資料,要達到零資料保留也可能需要另外設定或申請例外。正式上線前仍要逐項確認使用的模型、地區、功能、合約與保存政策。
Prompt 與工具要當成不可信輸入處理
Prompt Injection 不是 GenAI 才出現的第一種注入問題,但 LLM 會把自然語言、外部文件和工具操作接在一起,讓攻擊面變得更複雜。做法包括把系統指令與不可信內容清楚分隔、不要在 Prompt 放 Secrets、替工具設最小權限與參數 Allowlist、對高影響操作要求使用者再次確認,並驗證輸出後才執行。Google Cloud AI/ML 安全指引建議把所有輸入視為不可信,也可視需求加入 Model Armor 等輸入輸出掃描層;單靠一段「忽略惡意指令」的 System Instruction 不夠。
流程圖暫時無法顯示,請重新整理頁面後再試。
實作重點
- 用合成資料測試 Sensitive Data Protection,調整 infoType、信心門檻與自訂偵測器
- 在訓練資料、Prompt、模型輸出和日誌各安排一次檢查,記錄誤判、漏判與處理方式
- 先以 VPC Service Controls Dry Run 觀察流量,再和 IAM、Private Access 與 Audit Logs 一起驗證
- 只在隔離環境用假的 Secrets 測 Prompt Injection,確認工具 Allowlist、輸出驗證與人工確認真的擋得住
- 針對差分隱私記錄 clipping、噪聲、ε、δ 與效用變化,不只記一個功能開關
- 核對實際使用服務的資料保留與地區條件,再交由法務或隱私負責人確認合規需求
Lab 導讀
Lab 連結:Responsible AI for Developers: Privacy & Safety — Google Cloud Skills Boost
這個 Lab 會帶你操作 DLP API 與雲端安全控制。進行攻擊測試時,請只用隔離環境、合成個資和假的 System Instruction,不要拿正式憑證或客戶資料試。操作完也別只記得按鈕位置,請用「這個控制保護哪個資產、擋哪類風險、失敗時誰收到訊號」整理筆記,介面改版後才依然用得上。
延伸學習
- 負責任 AI:公平性與偏差 — Responsible AI 的公平性面向
- 負責任 AI:可解釋性與透明度 — 透明度如何支撐隱私保護
- GenAI 的 MLOps 實踐 — 在 MLOps 管線中整合安全檢查
相關文章
您可能也會對這些文章感興趣