
注意力機制
課程概述
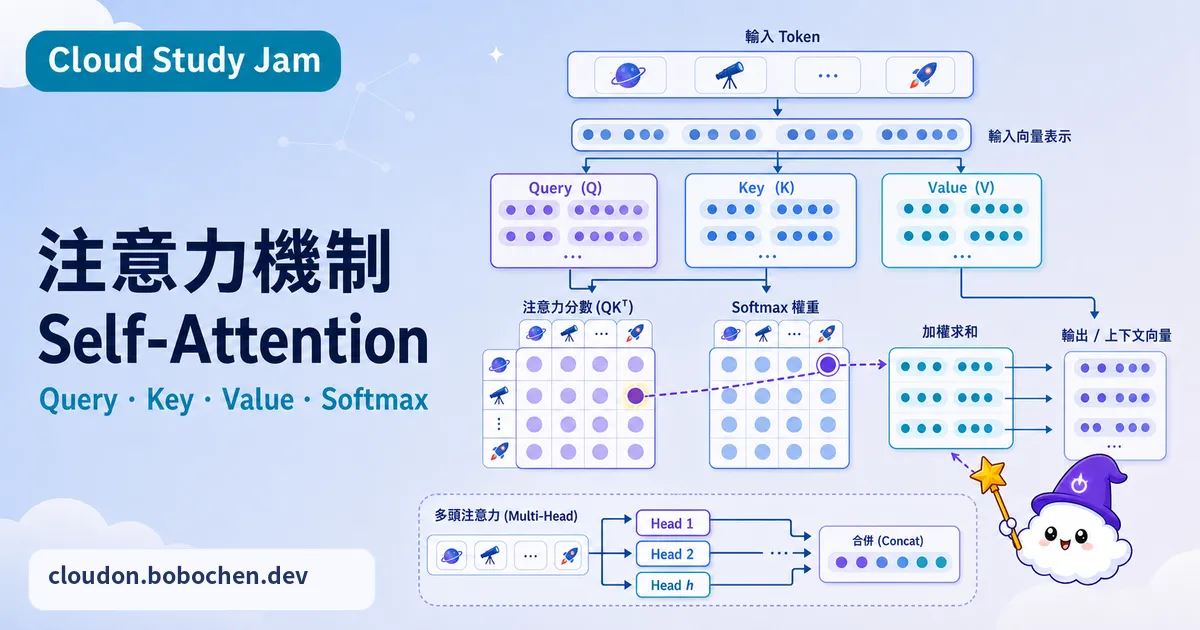
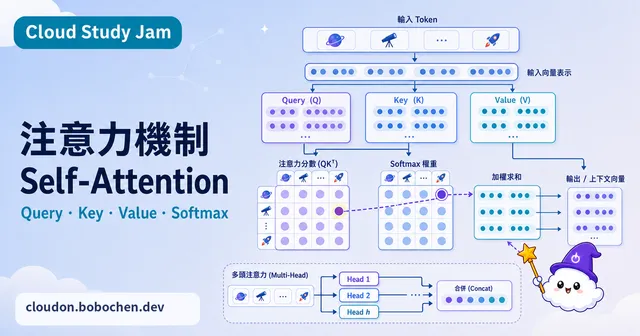
注意力機制(Attention)是 Transformer 最重要的積木之一。它做的事沒有「真的理解」那麼玄:模型會替每個 Token 算出該參考哪些位置,再把相關資訊加權整理回來。這堂課會從這個直覺出發,把 Query、Key、Value 和縮放公式一步步拆開,也會補上 Attention 擅長與不擅長的地方。
Query 表示「這個位置想找什麼」、Key 表示「每個位置有哪些線索」,Value 則是最後要彙整的內容。這套比喻很好記,但 Q、K、V 實際上都是模型從輸入向量學出來的投影,不是人工指定的標籤。
你將學到
- 解釋傳統 RNN/LSTM 的序列處理限制與 Attention 的解決方案
- 描述 Scaled Dot-Product Attention 的 Query-Key-Value 機制
- 理解 Multi-Head Attention 如何捕捉多面向的語義關係
- 區分 Self-Attention 與 Cross-Attention 的應用場景
核心概念
為什麼會需要 Attention?
早期沒有 Attention 的 RNN Encoder-Decoder,常把整段來源資訊濃縮到固定大小的狀態,再交給 Decoder。句子一長,前面的細節就很容易在傳遞過程中變淡;循環結構還得照順序算,訓練也不容易平行化。Attention 讓每個查詢位置直接參考來源的多個位置,不必只靠最後一個狀態。不過標準 Self-Attention 需要建立位置兩兩之間的分數矩陣,序列越長,記憶體與運算成本也會快速增加。
Query-Key-Value 的直覺解釋
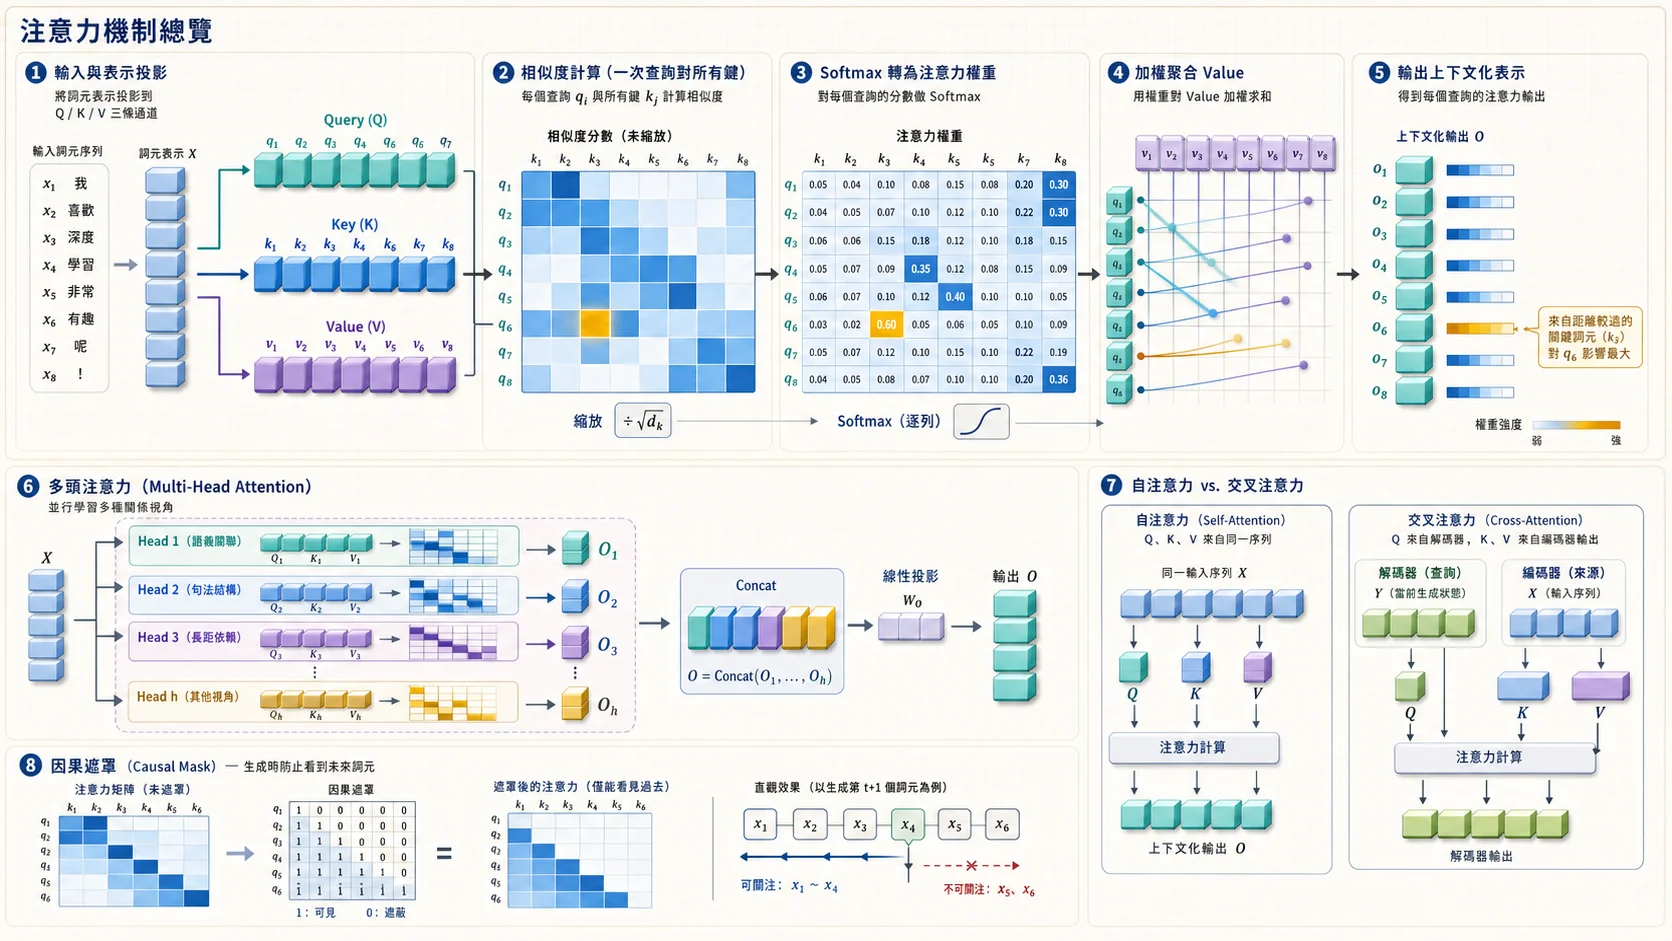
可以把 Attention 想成在圖書館找資料。Query(查詢)是「我現在需要什麼」,Key(鍵)像每份資料的索引線索,Value(值)則是要帶回來的內容。模型拿一個 Query 跟所有 Key 比對,算出相對權重,再依權重混合 Value。寫成數學就是 Attention(Q, K, V) = softmax(QK^T / sqrt(d_k)) V。重點是「依目前需求動態取資料」,而不是永遠把整段內容壓成同一個摘要。
Scaled Dot-Product Attention
先算 Q 和 K 的內積,再除以 sqrt(d_k),也就是每個 Key 向量維度的平方根。這個縮放能避免維度變大時分數幅度跟著膨脹,讓 Softmax 不至於太早集中在少數位置。若是自迴歸生成,還要先套上因果遮罩,擋住尚未生成的未來 Token;Softmax 之後得到每個位置的權重,最後才用這些權重彙整 V。
Multi-Head Attention
Multi-Head Attention 會把 Q、K、V 投影到多組較小的子空間,各自計算 Attention,再把輸出串接並投影回模型維度。不同 Head 因此有機會學到不同模式,但不能直接認定某一個 Head 就固定負責語法、另一個專門做指代;這類解讀要靠實驗驗證。Head 也不是越多越好,總維度、每個 Head 的維度、資料量和運算預算都會互相影響。
Self-Attention vs Cross-Attention
Self-Attention 的 Q、K、V 來自同一組序列表徵,讓每個位置整理同一序列裡的上下文。Cross-Attention 則讓 Q 來自目前正在處理的序列,K、V 來自另一組表徵。以翻譯模型來說,Decoder 目前的位置會用 Query 去讀取 Encoder 保留下來的來源語句表徵,兩端就是這樣接起來的。
流程圖暫時無法顯示,請重新整理頁面後再試。
實作重點
- 用 NumPy 手動實作一次 Scaled Dot-Product Attention,逐步檢查矩陣形狀與權重總和
- 在 TensorFlow/Keras 中用
tf.keras.layers.MultiHeadAttention建構一個簡單的 Attention 層 - 視覺化 Attention 權重矩陣,觀察不同輸入與遮罩如何改變權重分布
- 比較不同 Head 數量時固定總模型維度,避免把參數量增加誤當成 Head 本身的效果
Lab 導讀
Lab 連結:Attention Mechanism — Google Cloud Skills Boost
這個 Lab 以理論和圖解為主,也是整個系列裡數學比較密的一段。第一次看時不用急著背矩陣公式,先確認三件事:Query 在找什麼、權重怎麼來、Value 怎麼被加總。接著拿一個只有三個 Token 的小例子手算,通常會比重看好幾次公式更有感。
延伸學習
- 編碼器-解碼器架構 — Attention 在 Encoder-Decoder 中的應用
- Transformer 與 BERT 模型 — 完整的 Transformer 架構解析
- GenAI 基礎概念解鎖 — 回顧 Attention 的入門說明
相關文章
您可能也會對這些文章感興趣
Transformer 與 BERT 模型
拆解 Transformer 的共同積木,理解 BERT 的雙向編碼器與原始預訓練方法,並比較常見架構適合的任務
圖片說明生成模型
理解圖片說明生成的技術原理、視覺 Encoder 與語言 Decoder 如何協作,並學會依需求選擇 Cloud Vision、Gemini 或專用模型
注意力機制
深入理解 Attention Mechanism 的數學原理與實作方式,認識 Self-Attention 如何成為 Transformer 的核心創新
