
建構 GenAI 應用
課程概述
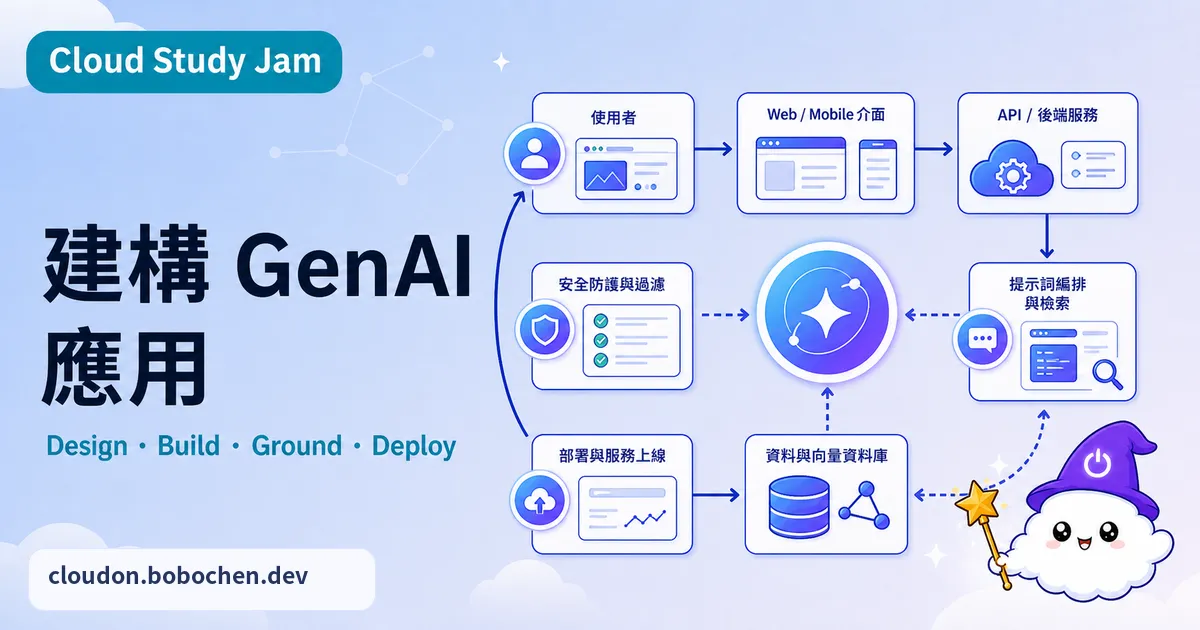
把 Gemini API 接上畫面,很快就能做出 Demo;難的是讓它面對真實流量、錯誤輸入和模型暫時不可用時,還能安全地運作。這門課會從前端、應用後端到模型服務逐層拆解,並補上原型最常漏掉的驗證、權限、成本與監控。
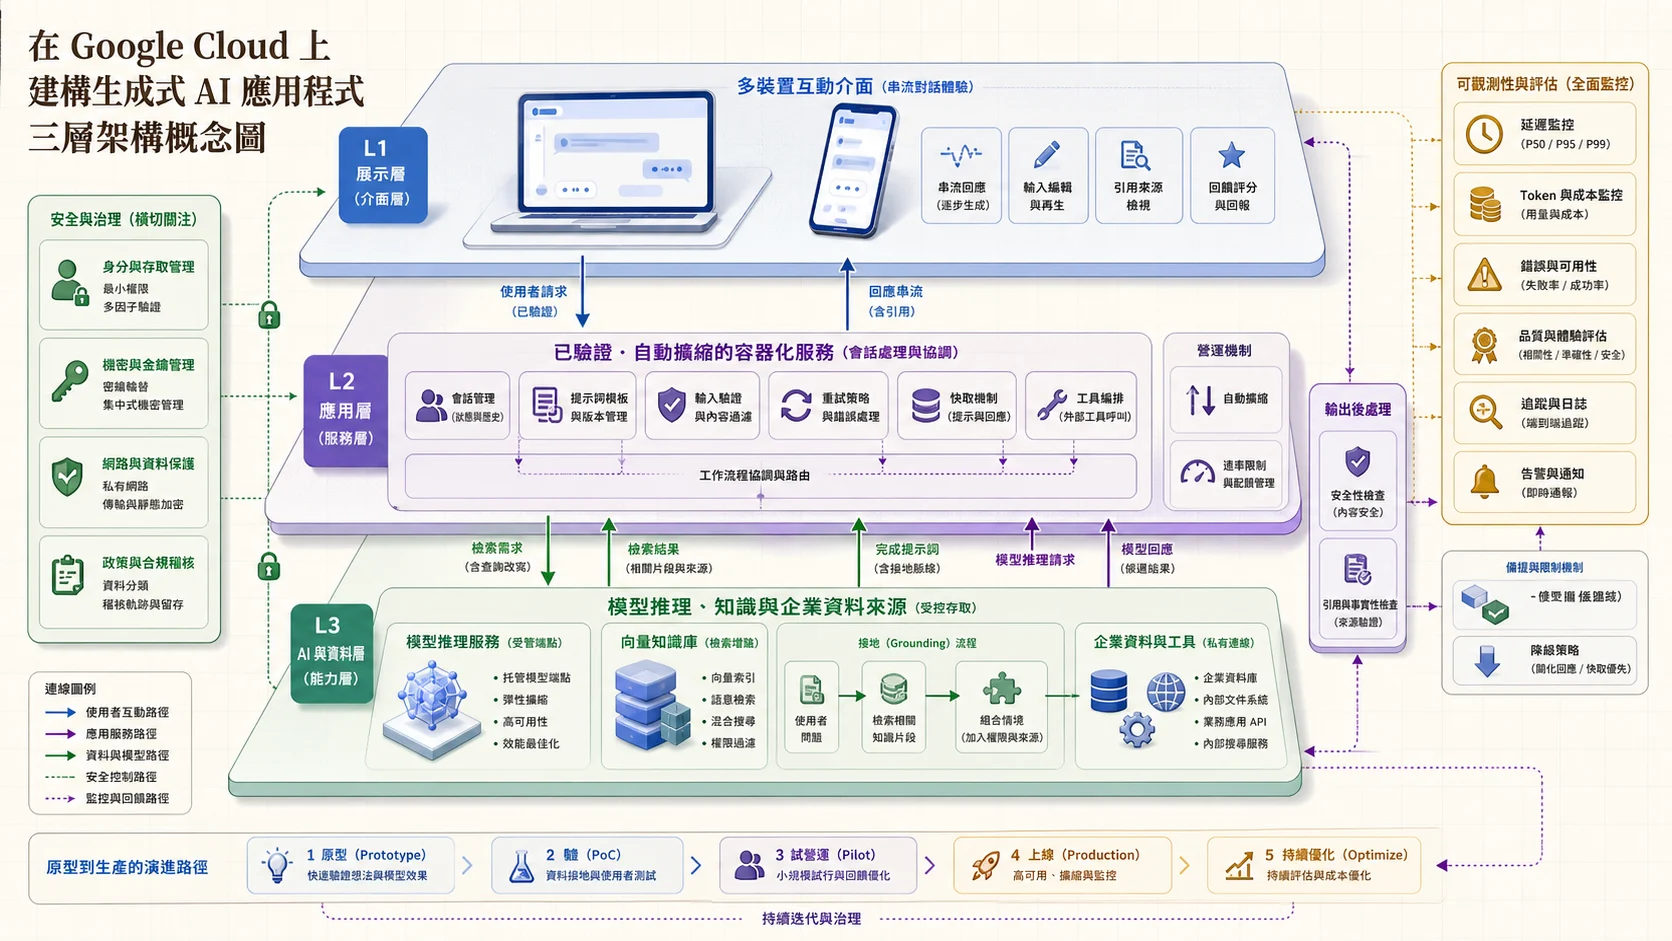
真正的 GenAI App 不只是前端加一次模型呼叫。應用層必須管理狀態、Prompt、重試、快取與工具,資料層負責 Grounding 和企業來源;安全檢查、引用、延遲、Token 成本、錯誤和品質監控共同決定能否上線。
你將學到
- 設計 GenAI 應用的參考架構:前端、後端、模型層的分層
- 使用 Google Gen AI SDK(
google-genai)建構 GenAI 後端服務 - 在 Cloud Run 上部署可自動擴展的 GenAI API 服務
- 處理 API 限流、錯誤重試與超時等生產環境問題
- 實作基本的輸入驗證與輸出安全篩選
核心概念
GenAI 應用的三層架構
常見的 GenAI 應用可以先拆成三層。前端層負責輸入、串流呈現和使用者操作;應用層負責驗證、權限、Prompt 版本、模型呼叫、工具與錯誤處理;AI/資料層則包含模型、檢索來源與企業 API。分層不是為了多畫幾個方框,而是避免瀏覽器直接握有敏感憑證,也讓模型或前端日後更換時,不必連商業規則一起重寫。
Prompt 管理策略
正式環境需要知道每次回應用了哪一版 Prompt。模板可以放在程式庫、設定服務或資料庫,但都應有不可變的版本 ID、審查紀錄和回退方式。後端不必每次都讀取「最新內容」;較穩妥的做法是讓一個服務版本綁定已核准的 Prompt 版本,載入後快取,再透過受控發布或實驗分流更新。這樣出問題時才找得到原因。
Cloud Run 部署架構
Cloud Run 適合部署容器化的 GenAI API,支援依請求自動擴展、HTTPS、最小/最大實例數和每個實例的並行設定。請求逾時不要因為模型偶爾很慢就一律拉長,而要從使用者可接受的等待時間反推;互動式回答可用串流降低等待感,長時間工作則考慮非同步工作與查詢狀態。Cloud Run 預設逾時為 5 分鐘、上限 60 分鐘,但這是平台範圍,不是建議值,詳見官方逾時設定。
生產環境的必備機制
上線前至少要補四類控制:限流與配額,避免單一租戶吃完模型額度;逾時與重試,只對可重試錯誤使用指數退避,並防止同一個工具動作執行兩次;輸入與輸出控制,限制長度、檔案類型和高風險內容;可觀測性,記錄模型與 Prompt 版本、延遲、Token、錯誤類型與品質回饋。完整 Prompt 和回應可能含個資或機密,不應預設全部寫進日誌;需要除錯時也要遮罩、取樣並設定保存期限。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32}}}%%
flowchart TB
  subgraph DEFINE["① 先把成功與失敗都定義清楚"]
      direction TB
      START["建立代表性測試集<br/>品質、延遲與成本門檻"] --> ACCESS{"已驗證身分、租戶、權限<br/>以及可使用的資料嗎?"}
      ACCESS -->|"還沒"| AUTH["把認證、授權與資料邊界<br/>放進應用層"]
      ACCESS -->|"有"| EVAL{"模型與 Prompt 版本固定,<br/>測試結果達到門檻嗎?"}
      AUTH --> EVAL
  end
  EVAL -->|"沒有"| IMPROVE["補資料、Prompt、檢索<br/>或重新選模型"]
  IMPROVE --> EVAL
  EVAL -->|"有"| FAILURE{"模型逾時、被限流、拒答<br/>或工具失敗時有退路嗎?"}
  subgraph OPERATE["② 確認服務能長期營運"]
      direction TB
      FAILURE -->|"沒有"| FALLBACK["加入逾時、有限重試、<br/>降級、取消與冪等處理"]
      FAILURE -->|"有"| OBSERVE{"能追蹤版本、延遲、<br/>Token、錯誤與品質,<br/>又不洩漏資料嗎?"}
      FALLBACK --> OBSERVE
      OBSERVE -->|"能"| PILOT["先讓少量使用者試用<br/>設停止條件與回退版本"]
      PILOT --> RELEASE["逐步放量並定期重跑評估集"]
  end
  OBSERVE -->|"不能"| TELEMETRY["補上遮罩後的遙測、告警<br/>與資料保存政策"]
TELEMETRY --> OBSERVE 實作重點
- 用 Python Flask 或 FastAPI 建構一個呼叫 Gemini API 的後端服務
- 將服務容器化並部署到 Cloud Run,依壓測結果設定並行、最大實例數與逾時
- 實作串流回應的 SSE(Server-Sent Events)端點,提升使用者體驗
- 加入輸入長度限制、內容安全篩選與 API Key 驗證等基本安全機制
- 使用 Cloud Logging 記錄經遮罩的模型版本、延遲、Token、錯誤類型與請求追蹤 ID
Lab 導讀
Lab 連結:Create Generative AI Apps on Google Cloud — Google Skills
課程頁目前列出兩個 Lab:一個在 Agent Studio(原 Vertex AI Studio)練習 Prompt 設計與多模態分析;另一個用 AlloyDB 當向量資料庫,做出 LLM+RAG 的聊天應用,其中負責查資料的 MCP Toolbox 部署到 Cloud Run,聊天應用本身在 Lab 準備好的 VM 上執行。除了讓功能跑起來,建議刻意測三種失敗:Prompt 太長、模型回傳限流、使用者中途取消。再檢查憑證是否放在 Secret Manager 或服務身分裡,而不是映像檔、前端或版本庫中。
延伸學習
- GenAI 驅動網站現代化 — GenAI 在前端應用中的整合模式
- Gemini + Streamlit 開發 GenAI App — 快速原型的替代方案
- Gemini 開發者指南 — 回顧 Gemini API 的核心功能
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
Gemini + Streamlit 開發 GenAI App
用 Streamlit 接上 Gemini 做原型很快,但多人使用時要補什麼?從本機實驗一路看到 Cloud Run 部署。
負責任 AI:隱私與安全
沿著資料生命週期做好最小化、去識別、權限與輸入輸出防護,並釐清差分隱私、聯邦學習與 Google Cloud 安全工具的邊界