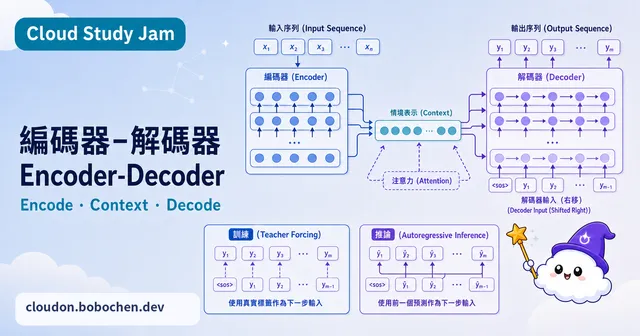
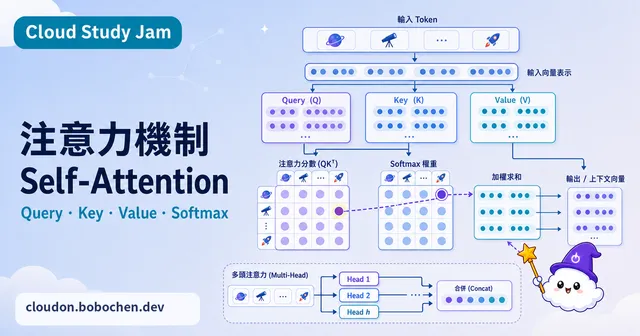
圖片說明生成模型
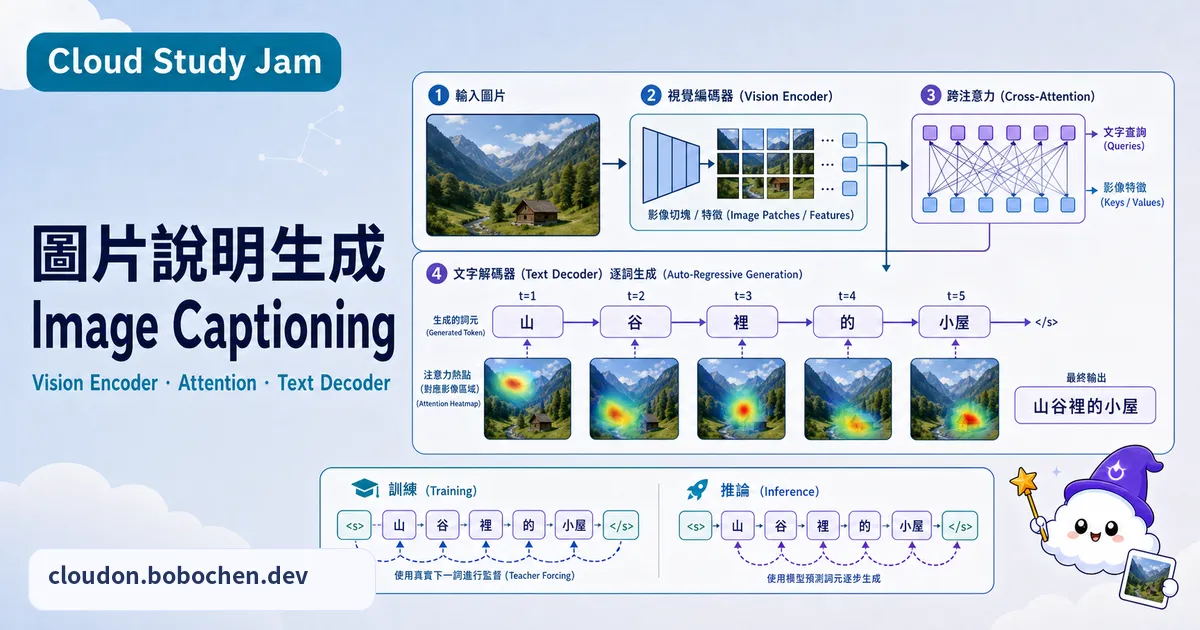
課程概述
圖片說明生成(Image Captioning)會把圖片轉成一段文字,是很適合拿來理解多模態模型的例子。不過「產出一句很順的描述」不等於內容一定正確:模型可能漏掉重要細節,也可能把不存在的物件講得煞有其事。這堂課除了拆架構,也會比較 Cloud Vision、Gemini 和專用模型各自適合什麼需求。
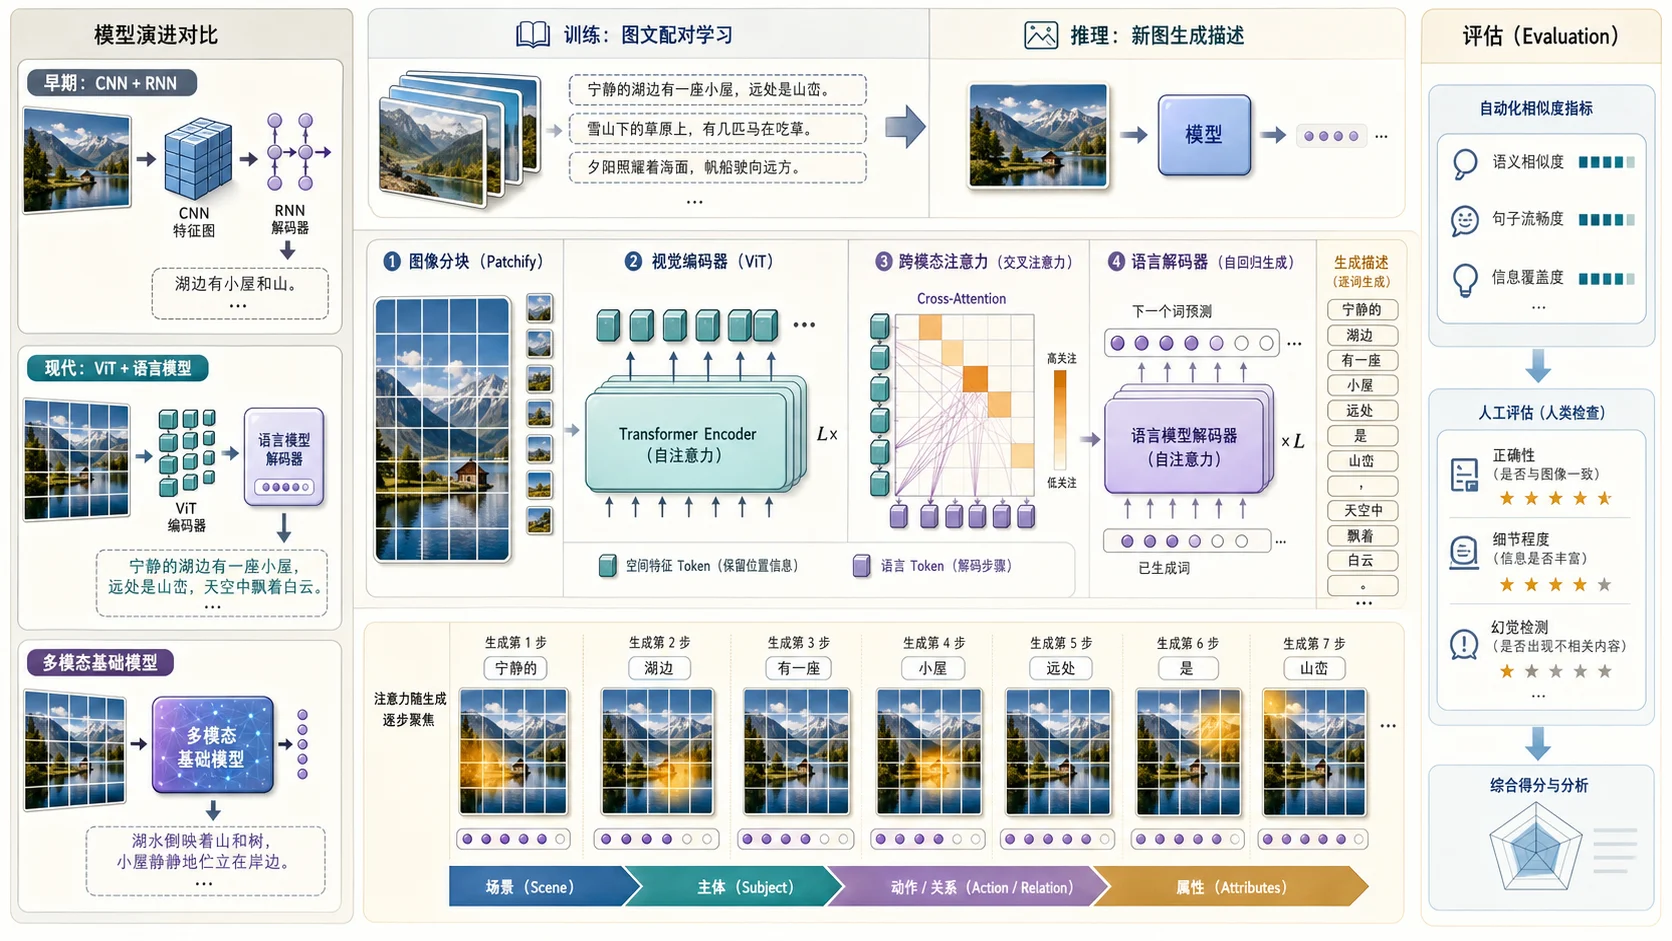
Captioning 是視覺表徵加上語言生成:Encoder 保留圖片特徵,Decoder 產生文字時再讀取相關區域。圖中的注意力分布可以協助分析,但不一定等於完整的因果解釋;正式評估也不能只看句子像不像參考答案。
你將學到
- 說明 Image Captioning 從 CNN + RNN 到 Transformer 類架構的演進
- 理解視覺 Encoder 如何從圖片中提取特徵
- 解釋語言 Decoder 如何根據視覺特徵生成描述文字
- 依輸出格式、品質、延遲與成本選擇 Cloud Vision、Gemini 或專用模型
核心概念
Image Captioning 的架構演進
常見的早期做法是用 CNN(例如 ResNet)提取圖片特徵,再交給 RNN 或 LSTM 逐詞生成;之後加入 Attention,讓 Decoder 每一步都能重新讀取不同圖片區域。較新的系統常採用 Vision Transformer、Transformer Decoder,或直接以大量圖文資料預訓練多模態模型。這不是整齊的三代淘汰史:CNN 和混合架構仍可能在固定任務、裝置限制或成本敏感的場景更實用。
視覺 Encoder 的角色
視覺 Encoder 會把像素轉成一組可供後續模型使用的特徵。在 CNN 架構裡,特徵圖保留不同區域的訊息;ViT 類架構通常把圖片切成 Patch,再轉為視覺 Token 交給 Transformer 處理。Patch 大小、輸入解析度與壓縮方式都會影響小字、細小物件和空間關係能不能被保留下來。
Cross-Modal Attention
在典型 Encoder-Decoder Captioning 模型裡,語言 Decoder 的 Query 來自目前的文字狀態,Key 和 Value 則來自視覺特徵。生成「狗」時,某些注意力權重可能集中在狗所在的區域;但權重集中不保證描述就一定正確,也不能單靠熱圖證明模型為什麼下這個判斷。
Gemini 的多模態理解
Gemini 可直接接收圖片與文字提示,能做圖片說明、分類、視覺問答等任務,不一定要先訓練一個 Captioning 模型,詳見官方圖片理解說明。但「比較方便」不代表所有情境都該選它:若只需要固定格式的標籤、物件位置或 OCR,Cloud Vision 的結構化回應通常比較好串;若要離線、極低延遲、固定領域或可控輸出,專用模型也可能更合適。
評估指標
BLEU、METEOR、CIDEr 等指標會比較生成文字與參考描述的重疊或共識,適合追蹤模型版本,但同一張圖本來就可能有很多種正確說法。正式評估要再加入語意正確性、重要物件是否遺漏、幻覺率、偏誤和人工評分;若是無障礙替代文字,還要檢查描述是否真的幫助使用者,而不是把所有畫面細節流水帳列一遍。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32, "wrappingWidth": 600}}}%%
flowchart TB
  PICK["① 先定義輸出、品質、延遲、成本與資料限制<br/>結構化偵測 → Cloud Vision | 開放式理解 → Gemini | 特殊部署限制 → 專用模型"]
  PICK --> TEST["② 用同一批真實圖片測正常、模糊、遮擋與邊界案例"]
  TEST --> GATE{"正確性、幻覺、隱私<br/>延遲與成本都過關?"}
  GATE -->|"是"| RELEASE["保留版本與回退方案<br/>逐步上線並抽樣複查"]
GATE -->|"否"| ADJUST["調整提示、解析度、模型<br/>或換服務後重新測試"] 實作重點
- 使用 Cloud Vision 的
LABEL_DETECTION與OBJECT_LOCALIZATION取得結構化結果,可參考官方功能範例 - 用 Gemini 對同一批圖片做開放式問答,要求回答「看不清楚」時明確說明不確定
- 比較兩種服務的輸出格式、漏判、誤判、延遲與每張圖片成本
- 用小型 CNN + LSTM Captioning 模型走一次訓練流程,理解它和通用多模態 API 的取捨
課程導讀
課程連結:Create Image Captioning Models — Google Skills
課程頁目前列的是概覽影片、Lab Walkthrough 影片、測驗與 Lab Resources 連結,沒有另外列出動手 Lab;課程說明提到的重點是 Encoder、Decoder 這些組件,以及怎麼訓練與評估模型。跟著示範練習時可以固定同一張圖片,每換一種做法就問:視覺特徵留在哪裡、Decoder 每一步讀了什麼、錯誤是看漏了還是文字亂補。最後別只比較 BLEU 分數,至少人工檢查幾張「描述很順但內容不對」的案例。
延伸學習
- 編碼器-解碼器架構 — Encoder-Decoder 的完整架構說明
- 圖片生成技術導論 — 從圖片理解到圖片生成的反向任務
- Gemini 多模態 RAG 文件檢索 — 多模態理解的實際應用
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
Transformer 與 BERT 模型
拆解 Transformer 的共同積木,理解 BERT 的雙向編碼器與原始預訓練方法,並比較常見架構適合的任務