生成式 AI 導論
課程概述
聽到「AI 會寫文章、畫圖」,很容易以為它和以前做分類、預測的 AI 是兩回事。其實它們有共同的技術基礎,只是要解的問題不同。這篇先把 AI、機器學習、深度學習和生成式 AI 的關係說清楚,再看它適合做哪些事。
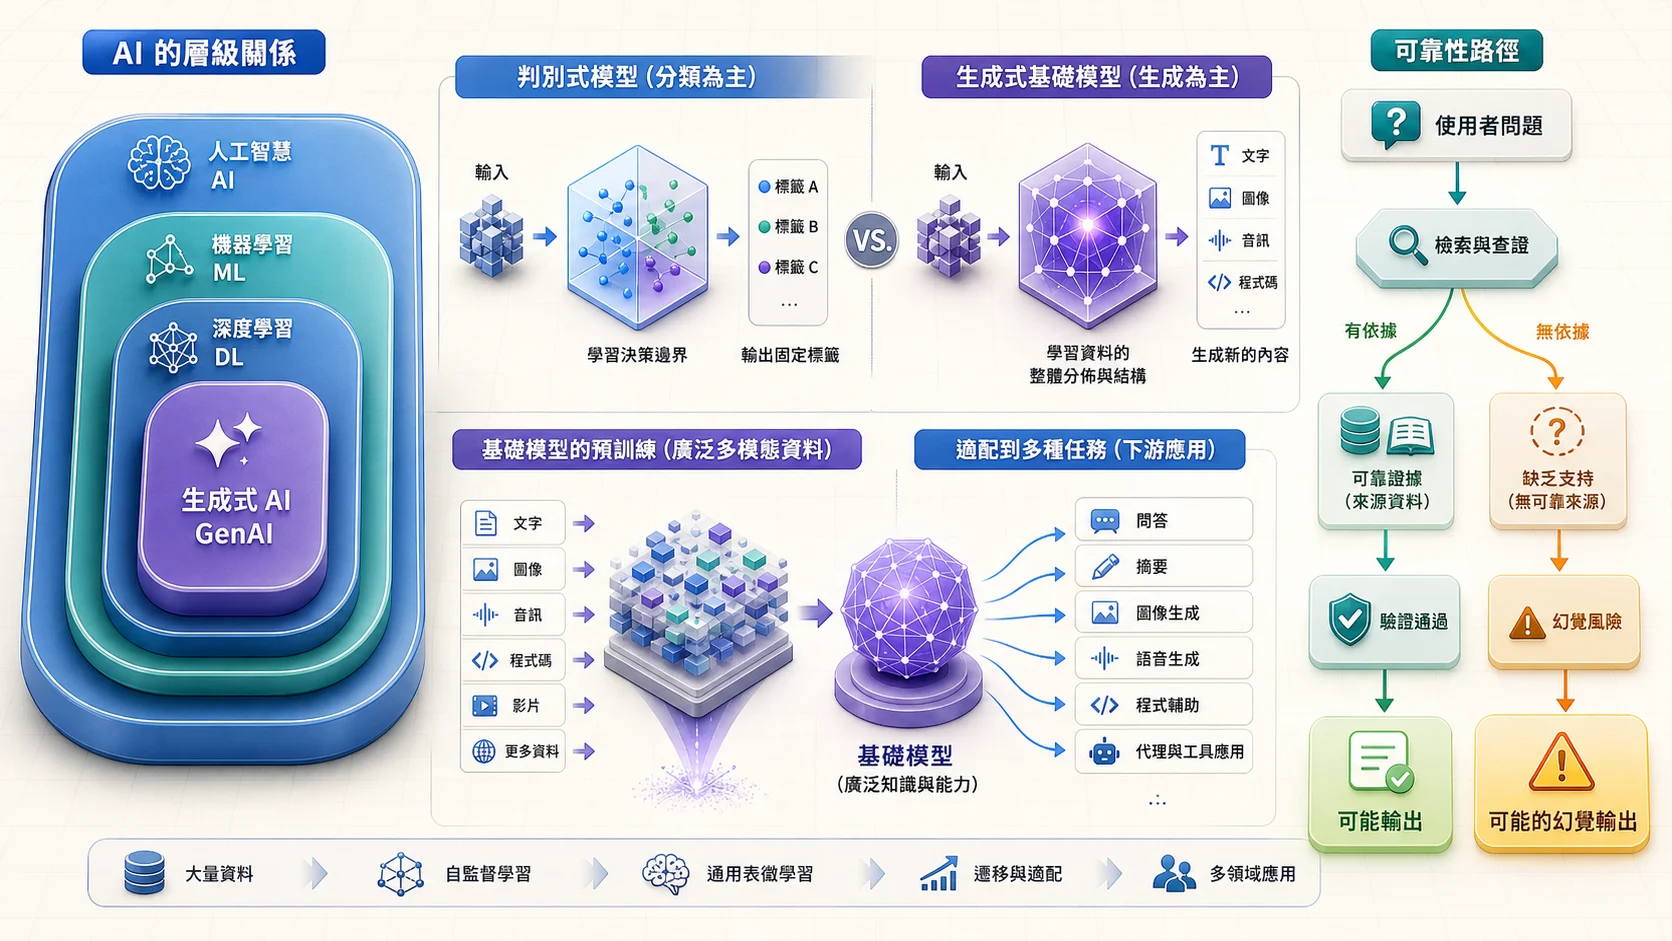
生成式 AI 是 AI/ML/深度學習層次中的一支:判別式模型學決策邊界,生成式基礎模型則學資料分布並適配多種任務。輸出若能檢索並查證來源就較可靠,缺乏依據時則要把幻覺當成系統性風險。
你將學到
- 區分 AI、機器學習(ML)、深度學習(DL)與生成式 AI 的層次關係
- 解釋生成式 AI 的運作原理:從訓練資料到內容生成
- 認識 Google Cloud 在生成式 AI 領域的關鍵產品與定位
- 了解 Foundation Model(基礎模型)與 Fine-tuning(微調)的差異
- 掌握生成式 AI 的主要應用類型:文字、圖片、程式碼與多模態
核心概念
AI 的層次結構
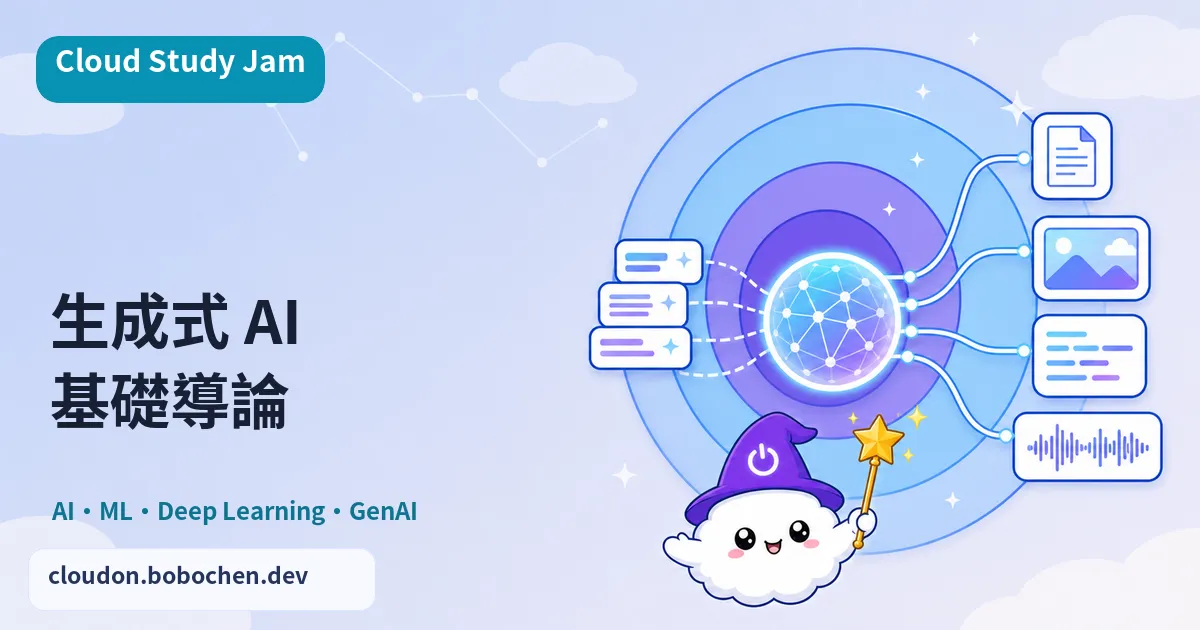
人工智慧(AI)是範圍最大的概念,講的是讓機器模擬人類智慧。機器學習是 AI 底下的一塊,重點在用資料學出規律,而不是把規則一條一條寫死。深度學習又更進一步,用多層神經網路來處理複雜的資料模式。生成式 AI 則是深度學習的其中一個應用方向,專門用來產生全新的內容。
生成式 AI 與判別式 AI 的差異
判別式模型(Discriminative Model)學的是分類邊界,回答的是「這是貓還是狗?」這種問題。生成式模型(Generative Model)學的是資料的整體分佈,所以它能回答「畫一隻貓給我看」。就是這個根本差異,讓兩者的應用場景差很多。
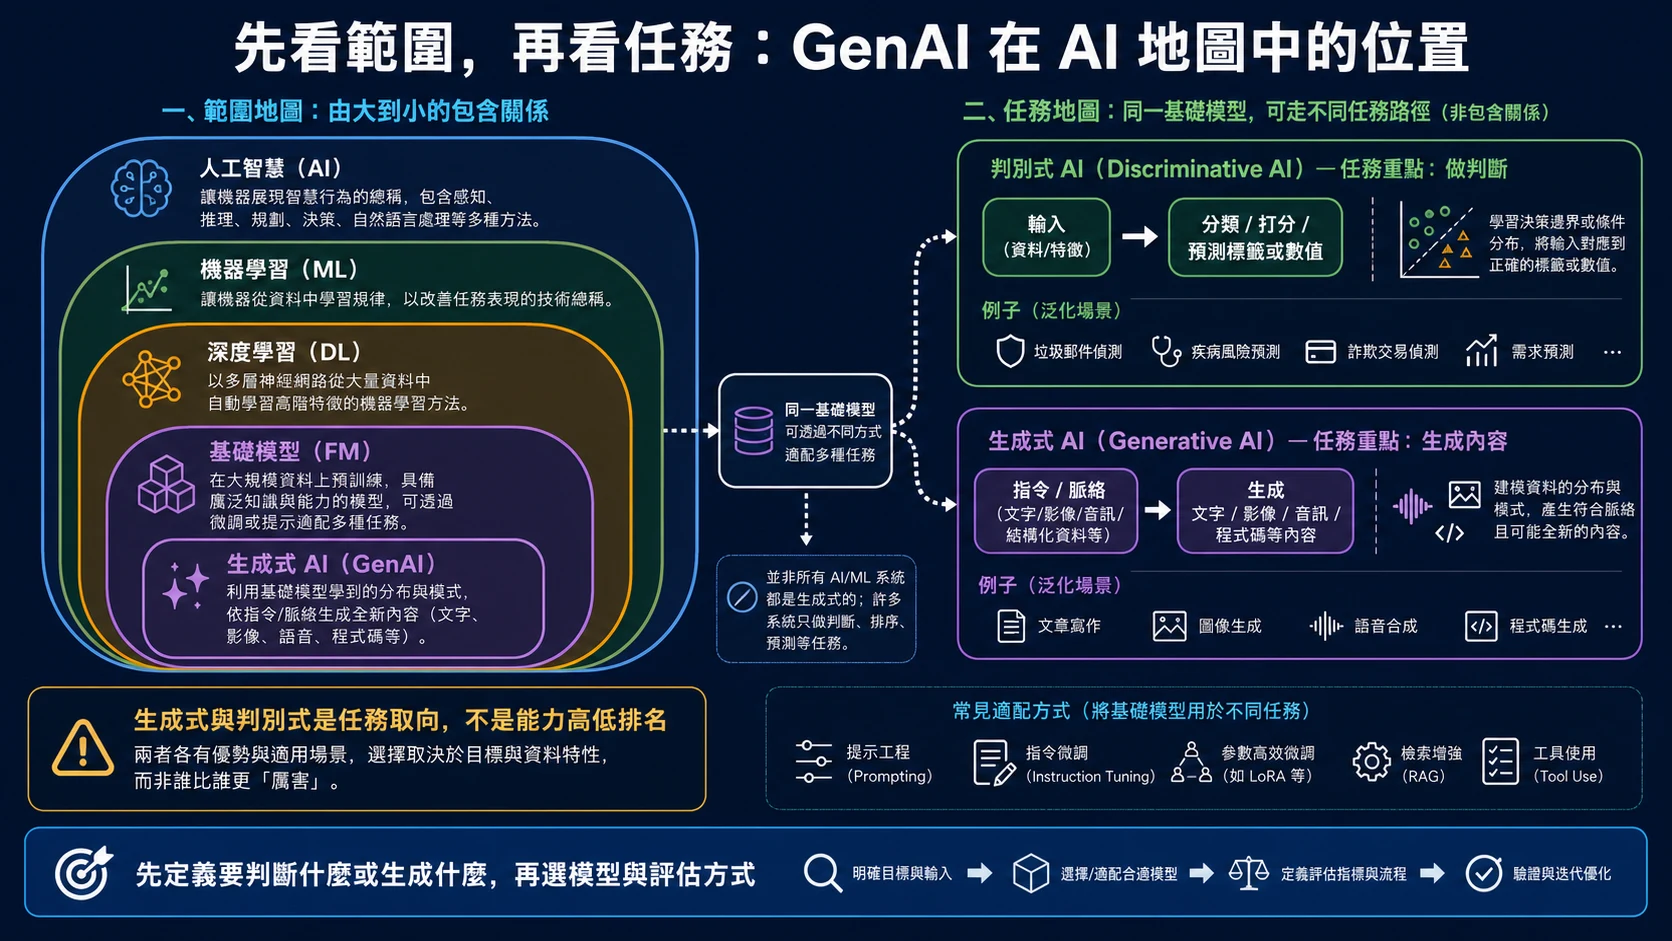
先分清技術範圍,再辨認任務:分類、排序與預測多半是在既有候選中判斷,文字、圖片與程式碼生成則是在條件下產生新內容。基礎模型可支援兩類任務,不能只看產品名稱判斷。
Foundation Model 的重要性
基礎模型是用大規模資料集預訓練出來的通用模型,知識面廣、能做的事也多。開發者可以用 Prompt Engineering(提示工程)直接拿來用,也可以用 Fine-tuning(微調)針對特定領域調整,不用從零開始訓練一個模型。Google 的 Gemini 就是這類基礎模型的代表。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32}}}%%
flowchart TD
  NEED["先說清楚要解決的問題"] --> OUTPUT{"需要產生新內容嗎?"}
  OUTPUT -->|"不用,只要分類、排序或預測"| PREDICT["先評估規則、傳統分析<br/>或判別式機器學習"]
  OUTPUT -->|"需要"| MODALITY{"要產生哪種內容?"}
  MODALITY -->|"文字/程式碼"| LLM["選擇語言或多模態模型"]
  MODALITY -->|"圖片/音訊/影片"| MEDIA["選擇對應的生成模型"]
  LLM --> EVIDENCE{"內容需要最新事實或引用嗎?"}
  MEDIA --> REVIEW["檢查授權、安全與品牌規範"]
  EVIDENCE -->|"需要"| GROUND["接上可信資料來源,再產生草稿"]
  EVIDENCE -->|"不需要"| DRAFT["直接產生草稿"]
  GROUND --> REVIEW
  DRAFT --> REVIEW
  REVIEW --> HUMAN["由人確認品質與風險後交付"]
PREDICT --> VERIFY["用測試資料驗證是否真的比較好"] Hallucination(幻覺)現象
生成式 AI 有時會生出看起來很合理、但其實是錯的內容,這就叫「幻覺」。原因在於模型本質上是在做機率性的預測,並不是去查一個事實資料庫。搞懂這個限制,是用對生成式 AI 的關鍵。
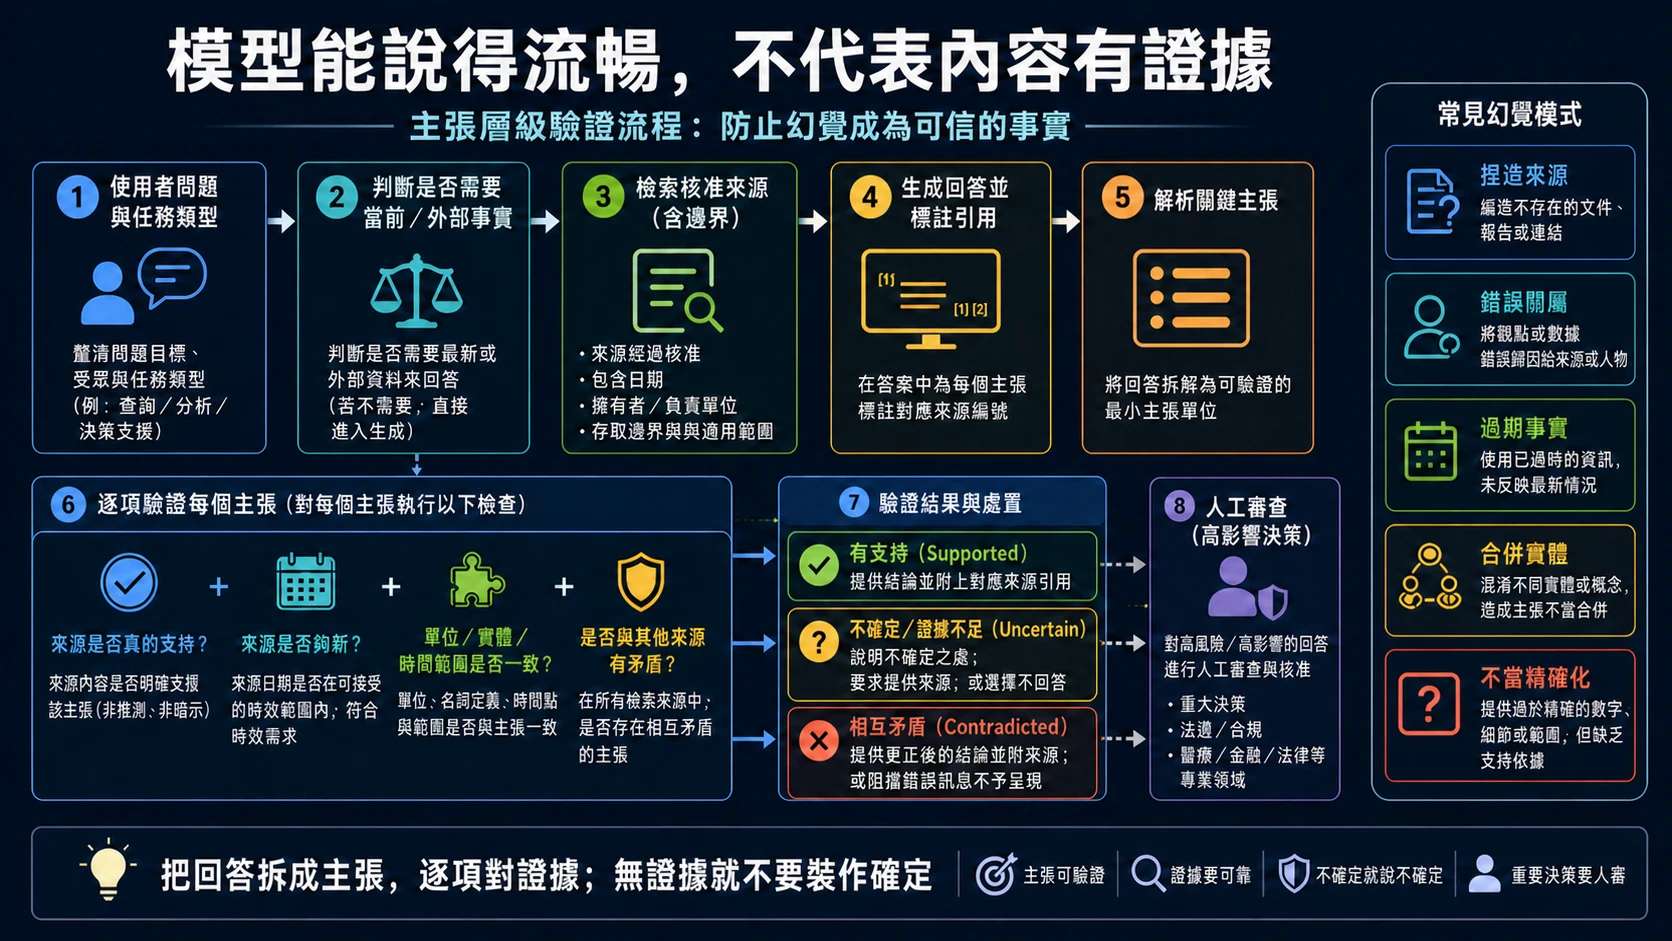
降低幻覺不能只靠一句「請勿捏造」,而要把回答拆成可驗證的最小主張,逐項核對來源、時效、單位與彼此是否矛盾。沒有證據就標示不確定,高影響決策則交由人員審查。
實作重點
- 在 Google Cloud Console 中開啟 Gemini Enterprise Agent Platform(課程錄影中的舊名稱是 Vertex AI),瀏覽 Model Garden 中可用的基礎模型
- 嘗試使用 Agent Studio(原 Vertex AI Studio)的文字提示功能,直觀感受生成式 AI 的輸出能力
- 注意觀察不同 prompt 會如何影響模型輸出的品質與方向
- 區分 Zero-shot、One-shot 與 Few-shot 提示的差異對輸出的影響
課程導讀
課程連結:Introduction to Generative AI — Google Skills
依課程頁,這門課由影片、小測驗和一份閱讀組成,沒有實作 Lab。建議觀看時特別留意 AI 層次結構的圖示說明,以及 Google 如何定位自家的生成式 AI 產品。做測驗前先確認自己說得出:生成式 AI 的定義、與傳統 ML 的差異、以及 Hallucination 的概念。
延伸學習
- 概念深入:什麼是生成式 AI? — 登雲學院 GenAI Leader 課程的基礎介紹
- 大型語言模型導論 — 下一課深入了解 LLM 的架構與運作
- Google Cloud AI/ML 產品總覽 — 完整的 Google Cloud AI 產品佈局
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣