GenAI 從輸入到回答:幾個基本概念
課程概述
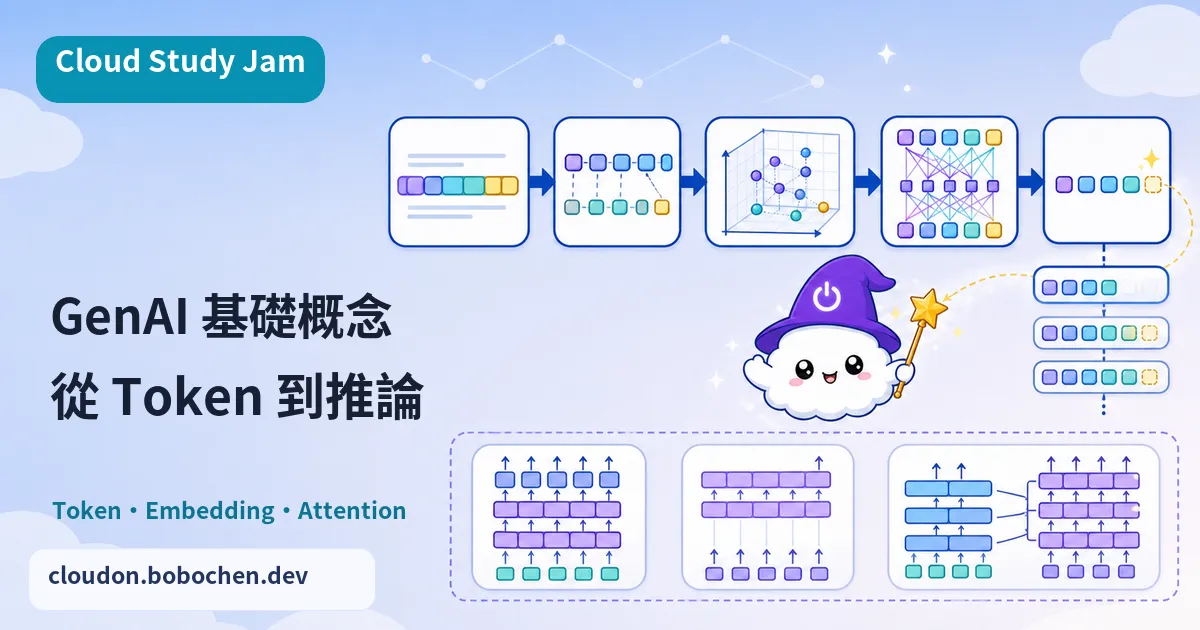
你輸入一句話,模型為什麼不是直接「讀懂文字」就回答?中間還有切 Token、轉成向量、逐步產生輸出的過程。這篇不先推公式,而是沿著一次請求的路徑,把常見名詞放回它們真正工作的地方。
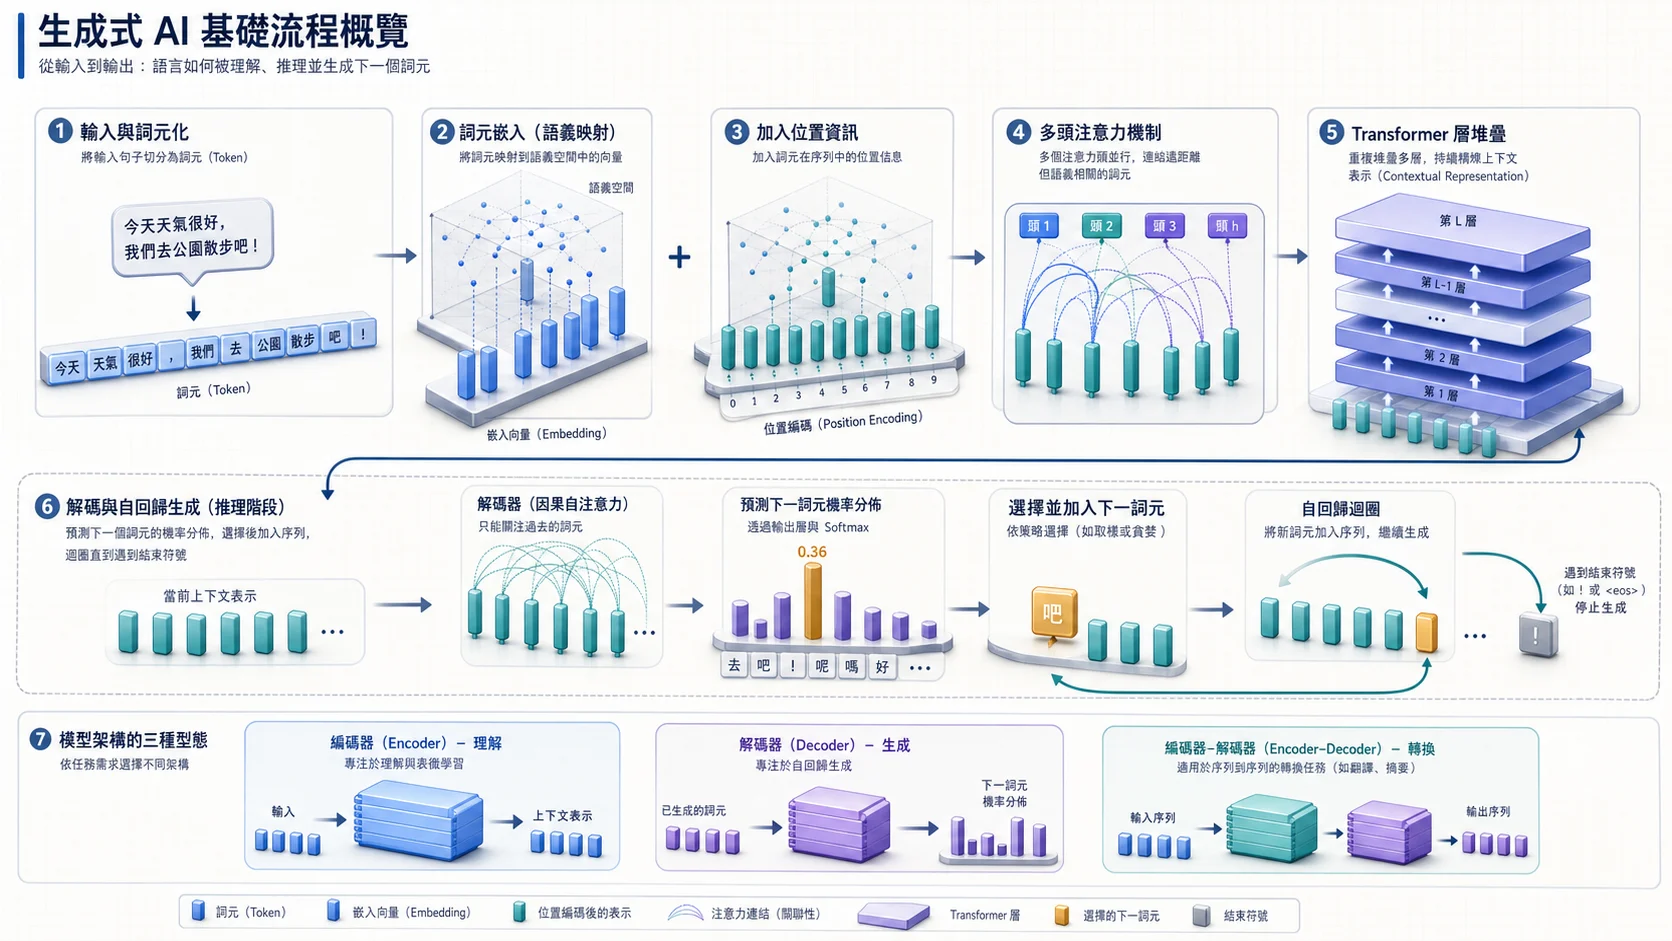
文字先變成 Token 和語義向量,再由位置編碼與 Attention 建立跨距離關係;Transformer 層反覆精煉上下文,解碼器才有條件逐詞生成。Encoder 擅長理解、Decoder 擅長生成,Encoder–Decoder 則擅長序列轉換。
你將學到
- 解釋 Tokenization 的過程與其對成本和效能的影響
- 理解 Embedding 如何將文字轉換為數學表徵
- 掌握 Inference(推論)過程中的關鍵步驟
- 區分不同模型架構的適用場景:僅解碼器、僅編碼器、編碼器-解碼器
核心概念
Tokenization:文字的數位化
模型會先用 tokenizer 把輸入拆成 Token,再進行後續運算。Token 不等於固定的一個字或一個詞;同一句話換成不同模型,切法和數量都可能不同。中文、英文、程式碼、圖片和影片也各有不同的計算方式,所以別拿字數硬猜成本。要知道實際數量,最穩的方法是用目標模型的 CountTokens API 或 SDK tokenizer 先算一次。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32}}}%%
flowchart TD
  PROMPT["組好系統指令、對話歷史、<br/>檢索內容與使用者輸入"] --> COUNT["用目標模型的 tokenizer<br/>計算輸入 Token"]
  COUNT --> LIMIT{"超過 Context Window<br/>或預留輸出後太接近上限嗎?"}
  LIMIT -->|"沒有"| SEND["送出請求"]
  LIMIT -->|"有"| SPLIT{"內容可以分段獨立處理嗎?"}
  SPLIT -->|"可以"| CHUNK["分段或批次處理,<br/>最後再合併結果"]
  SPLIT -->|"不適合"| RETRIEVE["刪掉重複歷史,只檢索<br/>與問題最相關的片段"]
  CHUNK --> COUNT
  RETRIEVE --> COUNT
  SEND --> USAGE["從回應的 usage metadata<br/>記錄實際用量與輸出長度"]
USAGE --> TUNE["依品質、延遲和費用<br/>調整下一版 Token 預算"] Embedding:語義的數學表徵
Embedding 會把 Token 轉成高維度的數字向量,讓語義相近的概念在向量空間裡靠在一起。舉例來說,「國王」和「女王」的向量距離,會比「國王」和「蘋果」近很多。搜尋、推薦、分類這些應用都建立在 Embedding 上,它也是 RAG(檢索增強生成)架構的核心組件。
Attention 機制簡介
Attention(注意力)機制讓模型在處理每個 Token 時,能「關注」整段輸入裡所有相關的 Token,而不是只看附近的上下文。這就像你在讀一段文字時,會自動把代名詞「他」連回前面提過的人名。Self-Attention 是 Transformer 架構最關鍵的突破,讓模型能抓到跨越很長距離的語義關聯。
模型架構的三大類型
| 架構類型 | 代表模型 | 擅長任務 |
|---|---|---|
| 僅編碼器(Encoder-only) | BERT | 分類、命名實體辨識、情感分析 |
| 僅解碼器(Decoder-only) | GPT、Gemini | 文字生成、對話、程式碼生成 |
| 編碼器-解碼器(Encoder-Decoder) | T5、BART | 翻譯、摘要、問答 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
現在的生成式 AI 大多用僅解碼器架構(像 Gemini),靠 Autoregressive(自迴歸)的方式,一個 Token 接一個 Token 把輸出生出來。
實作重點
- 使用 Gemini Enterprise Agent Platform 的 SDK tokenizer 或 CountTokens API,觀察不同語言的文字如何被拆解為 Token
- 透過 Embeddings API 取得文字的向量表徵,計算不同句子之間的相似度
- 注意 Context Window 的大小限制;依目前官方模型文件,Gemini 3.1 Pro 的上限是 1,048,576 Token
- 理解模型代號與發布階段:官方模型清單分成正式發行(GA)與預覽(Preview)兩類,Gemini 3.1 Pro 目前仍是預覽版,Model ID 是
gemini-3.1-pro-preview(查證日 2026-10-12);呼叫前先到模型頁確認代號,再依需求選 GA 版或預覽版
課程導讀
課程連結:Gen AI: Unlock Foundational Concepts — Google Skills
這門課是 Gen AI Leader 學習路徑的第二門,課程頁列出的活動是互動教材和小測驗,沒有實作 Lab。三個單元是核心概念(AI、ML 與生成式 AI 的差別、資料類型、學習方式)、基礎模型(怎麼選模型、模型的限制與克服做法),以及安全且負責任地建構 AI。課程頁的單元與活動標題沒有列 Tokenization、Embedding 或模型架構,這幾段是本文補充的技術背景。建議邊讀邊把每個概念的關鍵定義抄下來,因為這些術語後面的課程會一直反覆出現。
延伸學習
- 探索 GenAI 生態系統 — 了解 GenAI 產業的全貌
- 向量搜尋與嵌入技術 — 看看 Embedding 實際怎麼用
- 注意力機制 — Attention 的數學原理與實作
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣