
負責任 AI:可解釋性與透明度
課程概述
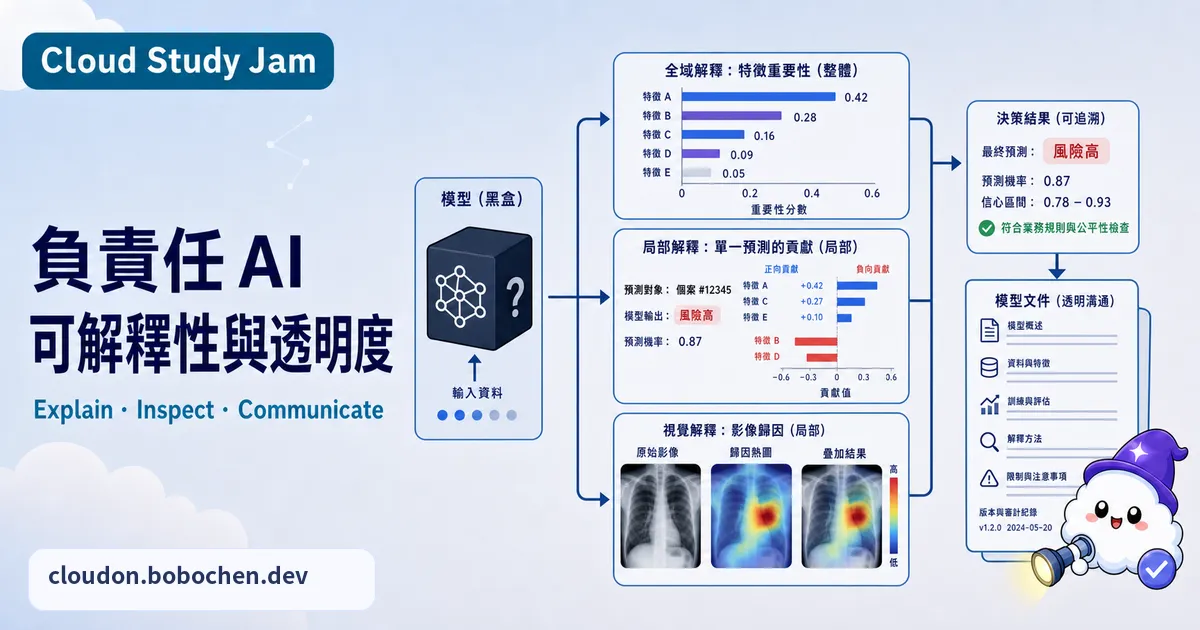
「為什麼會得到這個結果?」開發者、稽核人員和被系統影響的使用者,想知道的其實不太一樣。有人要除錯,有人要確認流程合規,也有人只想知道能不能申訴。這堂課不把解釋當成一張漂亮的特徵圖,而是從解釋要給誰看、要支援哪種決策開始,選方法後再檢查它是否穩定、忠實又不洩漏資料。
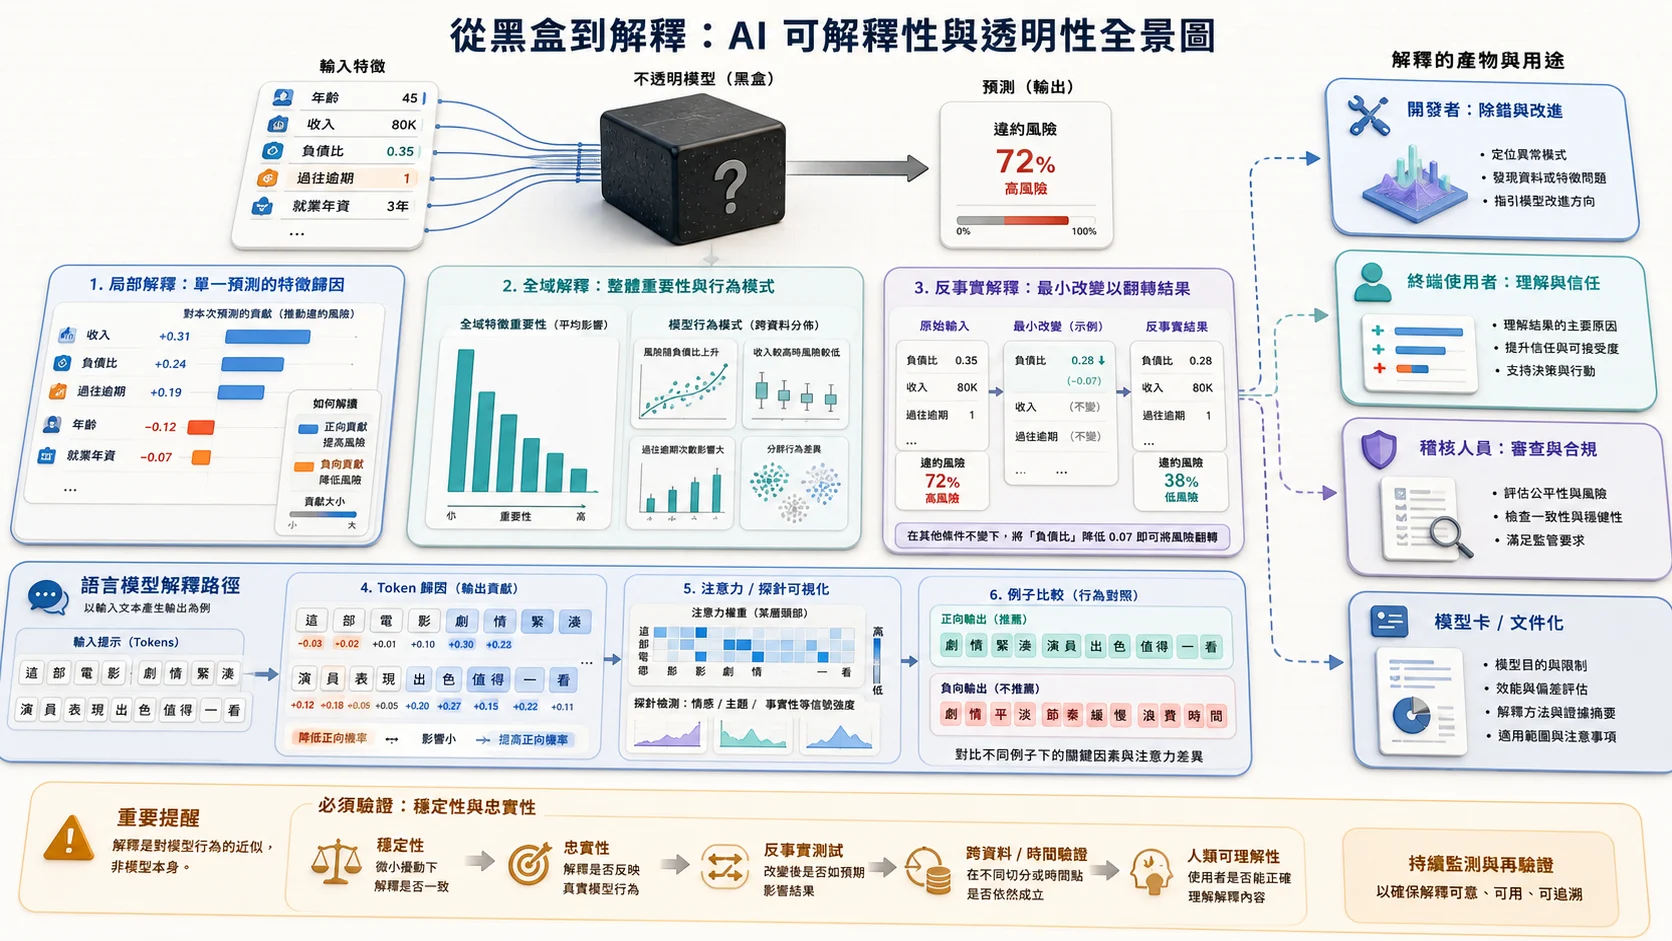
局部歸因回答「哪些輸入影響這一筆」,全域分析整理模型在一批資料上的行為,反事實則測試「改什麼可能讓結果不同」。這些都是對模型行為的觀察或近似,不是模型內在推理的逐字還原。
你將學到
- 理解 Interpretability 與 Explainability 常見的區分,以及術語重疊之處
- 依讀者需求選擇特徵歸因、範例式或反事實解釋
- 驗證解釋的忠實度、穩定性、可行性與隱私風險
- 認識 Vertex AI Explainable AI 的淘汰時程與替代規劃
- 使用 LIT 以互動方式比較資料、預測、歸因與反事實結果
核心概念
可解釋性與可說明性,不是硬切成兩個世界
實務上常把 Interpretability 用在「模型結構本身較容易理解」,例如小型決策樹或稀疏線性模型;Explainability 則常指用事後方法描述複雜模型的行為。不過學術與產品文件的用法會重疊,不必把兩個詞當成唯一標準。比較重要的是說清楚:你在解釋單筆結果、整體規律,還是系統流程?這份解釋要幫誰做什麼決定?
三大類解釋技術
(1)特徵歸因(Feature Attribution):估算各輸入特徵相對於某個基準,對這次預測的影響。Sampled Shapley 用抽樣近似特徵的邊際貢獻;Integrated Gradients 則從基準輸入沿路徑累積梯度。基準值、取樣方式、特徵相關性與模型平滑度都會改變結果,所以看到排名後,還要用遮蔽、擾動或重複執行確認是否穩定。
(2)範例式解釋(Example-based Explanation):找出與目前輸入相似、能幫忙比較的案例。例如「這筆交易與哪些已確認案例相近」。這種方式直觀,但「相似」不等於「原因」,而且直接展示訓練案例可能洩漏個資或機密內容。交付前要做存取控制、去識別化,也要確認相似度用的是對任務有意義的特徵。
(3)反事實解釋(Counterfactual Explanation):找出哪些輸入改動可能讓預測翻轉。數學上改動很小,不代表現實中做得到,也不代表這是結果改變的因果原因。像年齡不能改,收入也未必能短期增加;若把不可行或不公平的條件包裝成建議,反而會誤導使用者。好的反事實要加上可行性、因果與政策限制,也要避免變成繞過風控的操作手冊。
Vertex AI Explainable AI 已進入淘汰期
這點是舊教材最需要更新的地方:Vertex AI Explainable AI 官方文件已標示服務自 2026 年 3 月 16 日起淘汰,並將在 2027 年 3 月 16 日停止存取。現有使用者應盤點 Sampled Shapley、Integrated Gradients、XRAI 或範例式解釋的用途,保留測試資料與接受門檻,再規劃替代方案;新專案不宜把它當成長期依賴。
即使在仍可使用的期間,解釋也不是每次一般預測都免費附帶的真相。歸因請求需要相應設定與運算,會增加時間和成本;局部歸因也不能直接代表模型的全域規則。官方同樣提醒,歸因可能無法區分問題來自模型還是資料,也可能受到對抗性輸入影響。
LIT 適合互動探索,不是訓練或合規裁判
Learning Interpretability Tool(LIT)是開源、框架無關的互動分析工具,可用於文字、圖片與表格資料,並提供資料切片、模型比較、Salience、Embedding 與反事實等元件。它適合在評估或推論階段探索模型行為,不會代替訓練流程,也不會自動證明模型合規。注意力或 Salience 圖只表示某種計算訊號,不能直接當成模型「思考過程」。
生成式 AI 要解釋什麼?
對 LLM,請模型寫一段理由,不等於看見它真正如何得出答案,也不該要求或保存私密的逐步思考內容。對使用者,可提供簡短的依據、引用來源、主要限制與申訴管道;對開發者,則用受控擾動、替換證據、工具呼叫紀錄與失敗案例,驗證回答是否真的依賴宣稱的資訊。要稽核系統時,模型版本、Prompt、檢索文件、工具權限、評估資料和人工決策紀錄,通常比一段流暢的自我說明更可靠。
流程圖暫時無法顯示,請重新整理頁面後再試。
實作重點
- 若 Lab 仍提供 Explainable AI,記錄方法、基準值、取樣設定、延遲與成本,並同步規劃淘汰後的替代方式
- 比較 Sampled Shapley 與 Integrated Gradients,透過重複執行和特徵擾動檢查結果是否穩定
- 用 LIT 載入文字分類模型,比較切片、Salience 與反事實結果,不把注意力權重直接當成原因
- 檢查範例式解釋是否會帶出訓練資料中的個資、營業秘密或受限內容
- 對 LLM 保留來源與工具呼叫紀錄,再用移除證據或替換條件的方式測試回答是否忠實
Lab 導讀
Lab 連結:Responsible AI for Developers: Interpretability & Transparency — Google Cloud Skills Boost
這個 Lab 若仍帶你操作 Explainable AI,可以把它當成理解歸因方法的練習,但要記得服務已進入淘汰期。動手時別只看圖是否合理:改一個基準值、重跑取樣、遮掉高分特徵,再觀察結論會不會改變。若畫面與教材不同,則用 LIT 或自己的評估程式重做同一個驗證問題。
延伸學習
- 負責任 AI:公平性與偏差 — 可解釋性如何輔助偏差診斷
- 負責任 AI:隱私與安全 — Responsible AI 的隱私面向
- Google Cloud AI 負責任原則實踐 — 回顧整體框架
相關文章
您可能也會對這些文章感興趣
負責任 AI:可解釋性與透明度
從讀者與使用情境選擇特徵歸因、相似案例或反事實方法,並學會驗證解釋的忠實度、穩定性與隱私風險
Google Cloud AI 負責任原則實踐
學習如何在 Google Cloud 平台上將 Responsible AI 原則落實到 AI 開發工作流中,涵蓋工具、流程與組織層面的實踐方法
負責任 AI:隱私與安全
沿著資料生命週期做好最小化、去識別、權限與輸入輸出防護,並釐清差分隱私、聯邦學習與 Google Cloud 安全工具的邊界
