Google Cloud AI 負責任原則實踐
課程概述
看懂 Responsible AI 原則只是第一步,真正有挑戰的是把它放進每天的開發流程。官方課程講的是 Google Cloud 自己怎麼把 AI 原則落實成治理與審查流程,以及一路累積的做法;這篇再補上平台工具這一面,看看工具和團隊制度要怎麼搭配,讓 AI 應用從設計、開發、部署到監控,每一段都有能被檢查的安全措施。
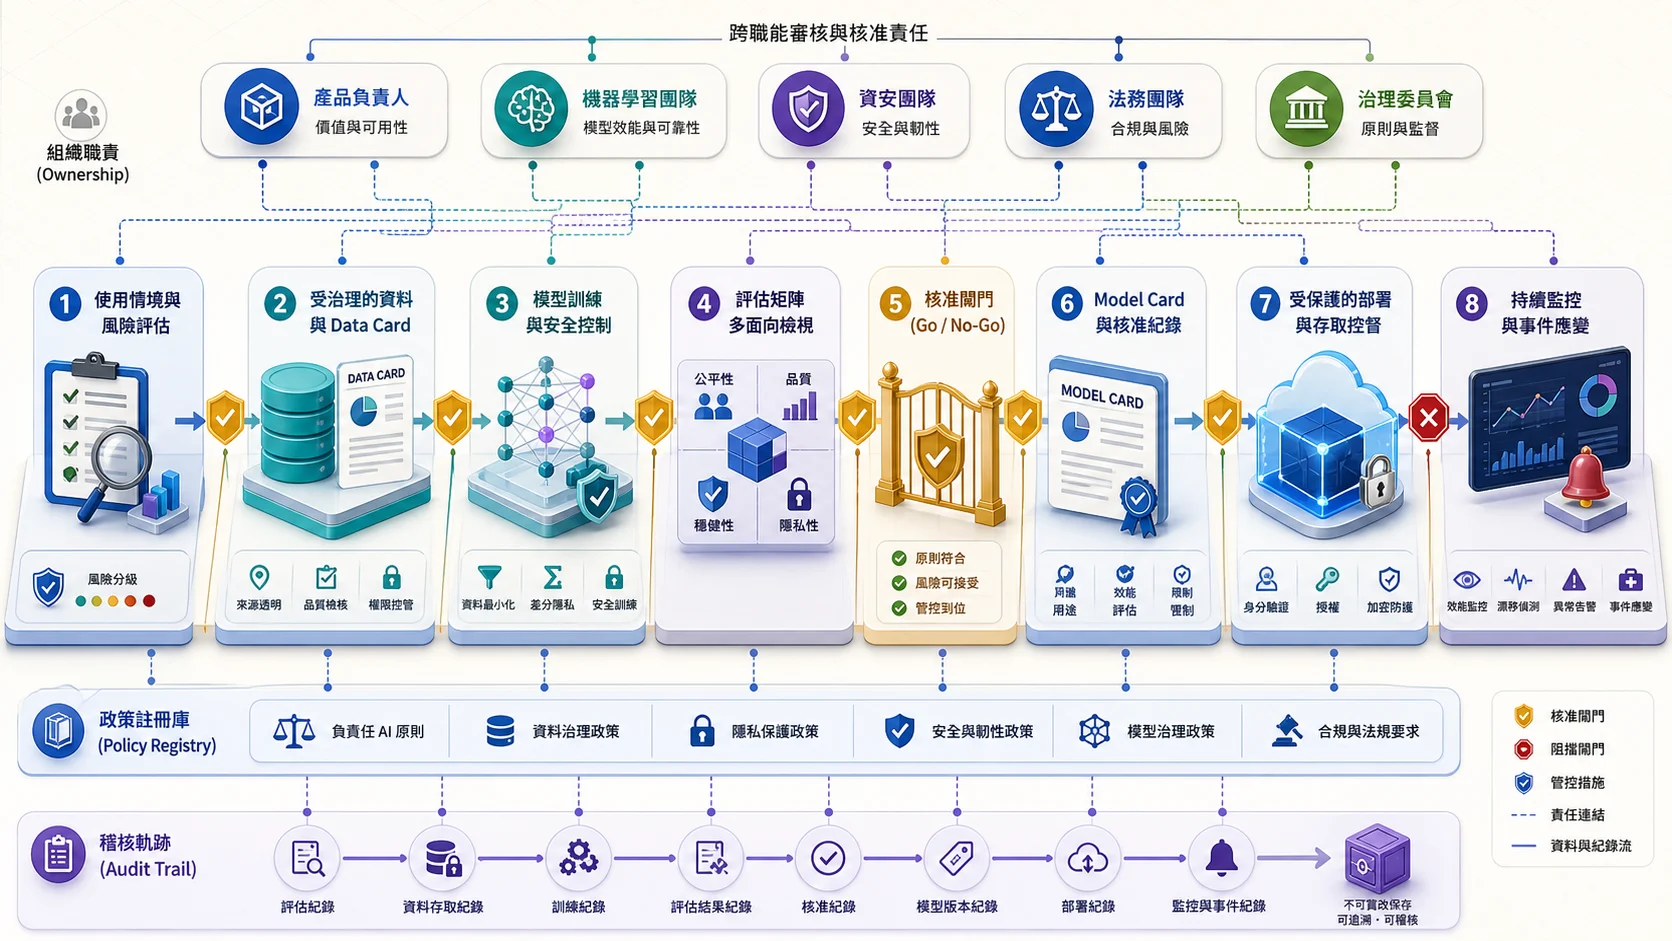
原則要靠可稽核流程落地:Data Card 說明資料、Model Card 說明模型,品質與風險評估決定能否過閘。政策註冊、責任分工與不可竄改的稽核軌跡,讓部署後的事件也能追溯到決策與版本。
你將學到
- 運用 Google Cloud 的 Responsible AI 工具進行模型評估
- 建立 AI 開發流程中的 Responsible AI 檢查點
- 理解 Model Card 與 Data Card 的用途與重要性
- 設計涵蓋公平性、安全性與隱私保護的 AI 治理框架
核心概念
從原則到實踐的橋梁
這篇把 Responsible AI 原則的落實整理成三個實踐層面:技術工具(Tooling)、流程治理(Governance)跟組織文化(Culture)。技術工具就是偏差檢測、可解釋性分析、安全篩選這些;流程治理是在 MLOps pipeline 裡塞進自動化的合規檢查;組織文化則是跨職能團隊要怎麼一起協作、持續學習。
平台的安全功能
Gemini Enterprise Agent Platform(課程中的舊名稱是 Vertex AI)提供多層安全機制。不可調整的篩選器會攔截特定禁止內容;可設定的內容篩選器則可依仇恨言論、騷擾、情色露骨與危險內容等類別設定門檻。要注意預設不一定會擋:官方的門檻說明寫 gemini-3.5-flash 起的模型預設值是 OFF(不自動阻擋,也不回傳中繼資料),主控台列的預設也是 Off,但同一頁的 REST 範例仍把 BLOCK_MEDIUM_AND_ABOVE 標成預設(查證日 2026-10-12);要確定會阻擋,就自己把各類別的門檻明確設好,不要依賴預設值。Grounding 能讓回答參照可信資料來源,Safety Ratings 會回傳風險類別與機率。這些工具是防線的一部分,不代表開啟後就能省略紅隊測試、權限控管與人工覆核。
Model Card 與 Data Card
Model Card 就像模型的「身分證」,記錄它的預期用途、訓練資料概述、效能指標、已知限制跟倫理考量。Data Card 則記錄訓練資料集的來源、處理方式、已知偏差跟使用限制。這些文件對模型的可審計性(Auditability)和可重現性(Reproducibility)很關鍵。在 Model Garden 挑模型時,記得先翻一下它的 Model Card。
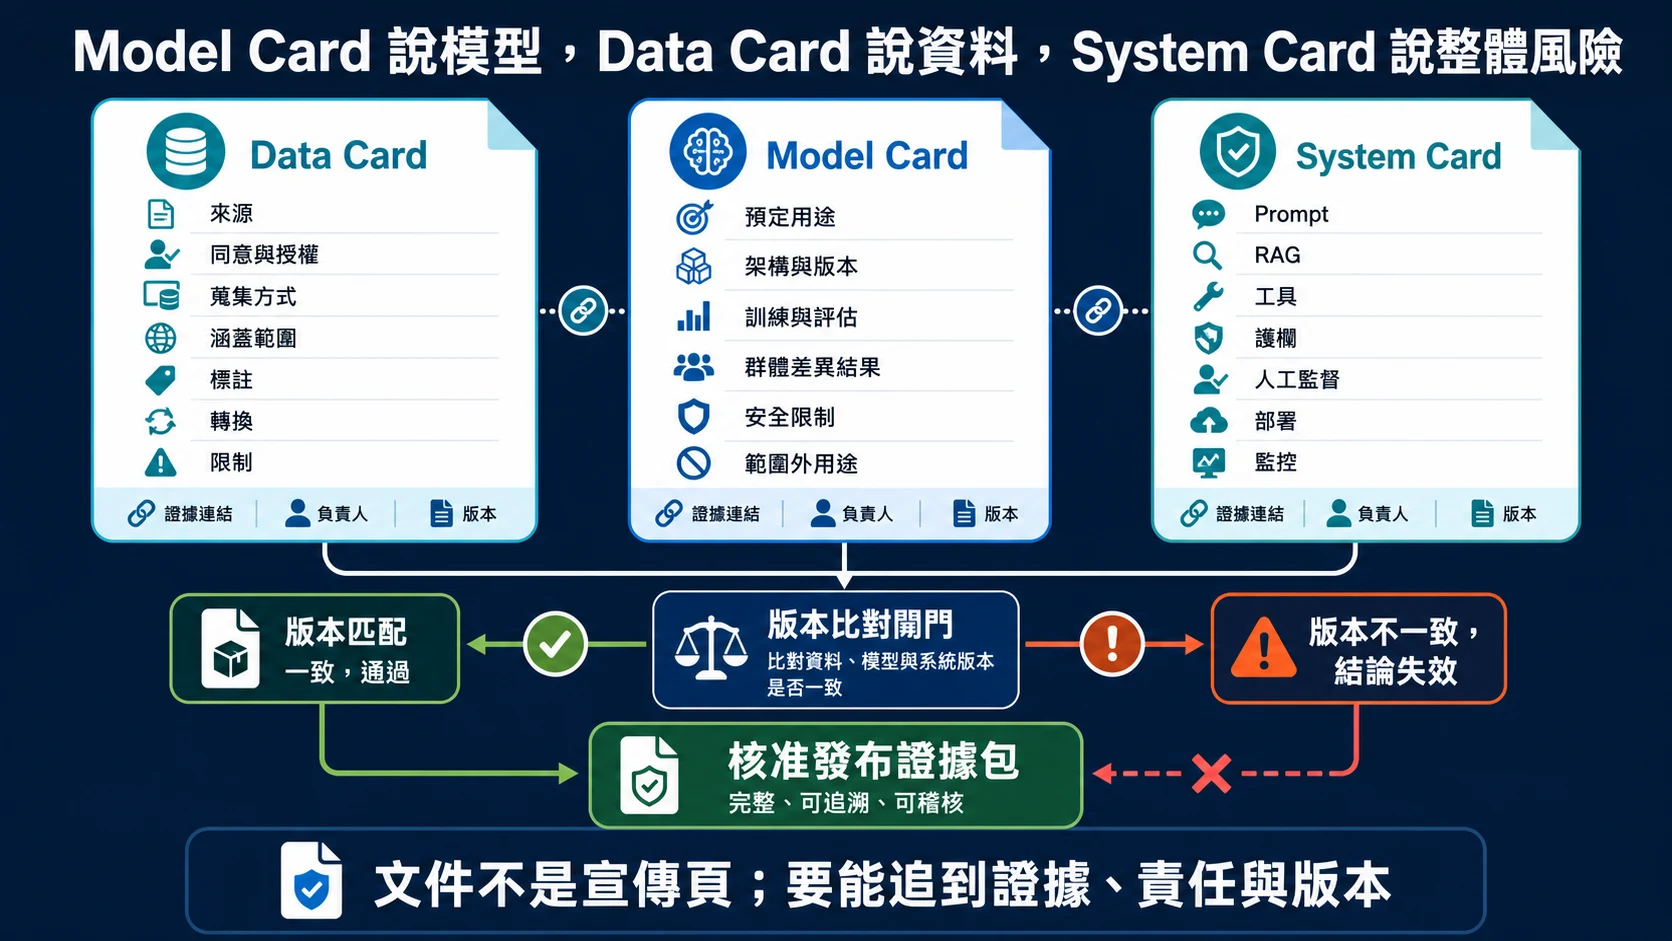
Data Card、Model Card 與 System Card 回答的是不同層次的問題,三者要用證據、責任人與版本串起來。只要資料、模型或部署設定版本不一致,原先的評估結論就不能直接沿用。
AI 治理框架
企業導入 GenAI 時,最好先把 AI 治理框架定清楚,包括:AI 使用政策(哪些用途允許、哪些禁止)、風險評估流程(每個 AI 應用都做分級評估)、人機協作規範(什麼時候需要人來審核)、還有事件應對計畫(萬一 AI 產出不當內容,要怎麼處理)。
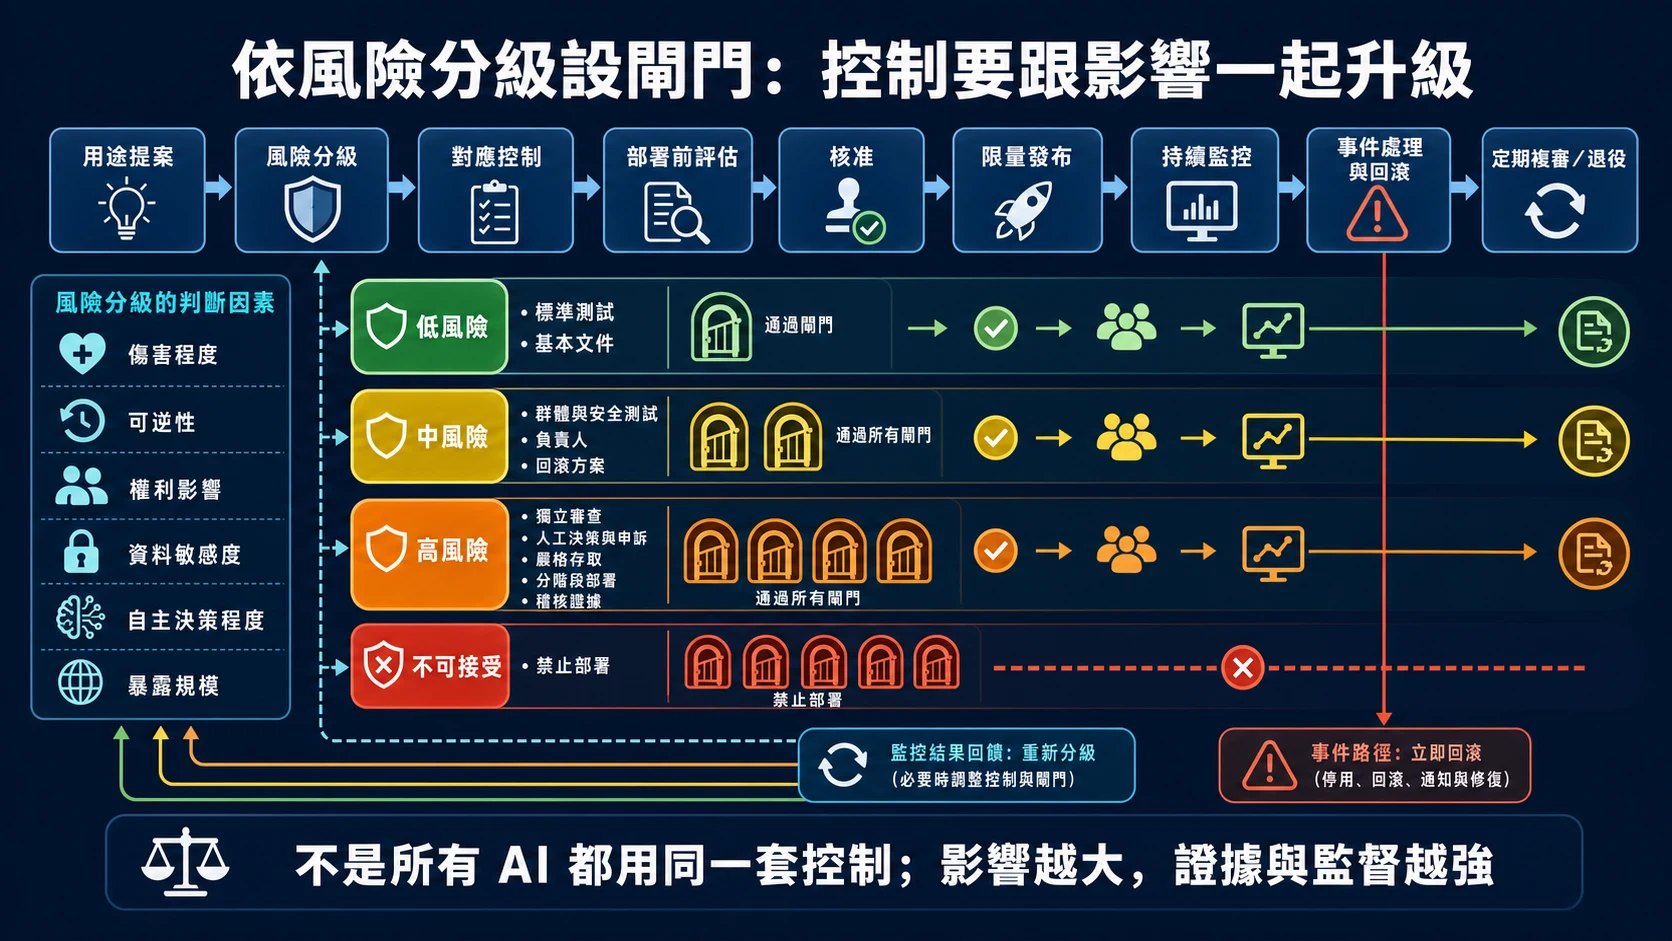
治理強度要隨影響升級:低風險保留基本測試與文件,中高風險增加安全評估、獨立審查、申訴與回滾證據,不可接受的用途則直接停止。監控發現情境改變時,必須回到重新分級。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32}}}%%
flowchart TB
  subgraph DETECT["① 發現與分流"]
      direction LR
      SIGNAL["監控、回報或稽核<br/>發現異常"] --> TRIAGE["保留輸入、輸出<br/>與各項版本"]
      TRIAGE --> SEVERITY{"可能造成重大或<br/>持續性傷害嗎?"}
  end
  SEVERITY -->|"是"| CONTAIN["先停用功能、降權限、<br/>切回安全版本或人工處理"]
  SEVERITY -->|"否"| QUEUE["限制影響範圍並排入修正"]
  CONTAIN & QUEUE --> CAUSE
  subgraph REPAIR["② 找根因並驗證修正"]
      direction LR
      CAUSE["找出資料、模型、Prompt、<br/>權限或流程的根因"] --> FIX["修正控制措施<br/>並補回歸測試"]
      FIX --> REVIEW{"獨立審查確認<br/>可以恢復嗎?"}
  end
  REVIEW -->|"否"| FIX
  REVIEW -->|"是"| RESTORE["分階段恢復並加強監控"]
  subgraph RECOVER["③ 恢復與學習"]
      direction LR
      RESTORE --> LEARN["更新事件紀錄、Model Card、<br/>政策與團隊操作手冊"]
end 實作重點
- 在 Gemini Enterprise Agent Platform 中檢視模型的 Safety Settings,了解各安全類別與篩選門檻
- 先在 Agent Studio 的 Safety settings 確認各類別的門檻(官方文件列的主控台預設是 Off,不自動阻擋),把其中一個類別調到 Block few 以上,再輸入可能觸發安全篩選的 Prompt,觀察平台的回應機制
- 檢視 Model Garden 中至少兩個模型的 Model Card,比較它們的限制說明
- 思考你正在開發或計畫開發的 AI 應用,列出可能存在的偏差風險點
課程導讀
課程連結:Responsible AI: Applying AI Principles with Google Cloud — Google Skills
依課程頁,這門課由七個單元的影片和一份資源連結文件組成,沒有列測驗,也沒有實作 Lab。內容依序是 Google 的 AI 原則、負責任 AI 的商業理由、技術考量與倫理疑慮、AI 原則怎麼訂出來、Google Cloud 的治理與審查流程(含名人辨識的案例研究),以及怎麼盤點潛在的倫理議題(issue spotting)與落實原則的心得。看案例時別只看技術面,也想想社會影響跟利害關係人的角度。
延伸學習
- 負責任的 AI 導論 — 回顧 Google AI 七大原則
- 負責任 AI:公平性與偏差 — 談談公平性的技術實踐
- 負責任 AI:可解釋性與透明度 — 了解如何讓 AI 決策可理解
- 負責任 AI:隱私與安全 — 隱私保護的技術方案
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
負責任 AI:隱私與安全
沿著資料生命週期做好最小化、去識別、權限與輸入輸出防護,並釐清差分隱私、聯邦學習與 Google Cloud 安全工具的邊界