圖片生成技術導論
課程概述
圖片生成很容易讓人有「輸入一句話,圖片就自己跑出來」的印象,但真正要拿來做產品或行銷素材,還得處理構圖、文字、品牌一致性、安全與授權。這堂課會先拆解 Diffusion Model 的基本原理,再把焦點拉回實務:怎麼產生、檢查、修改,最後才交付一張能用的圖。
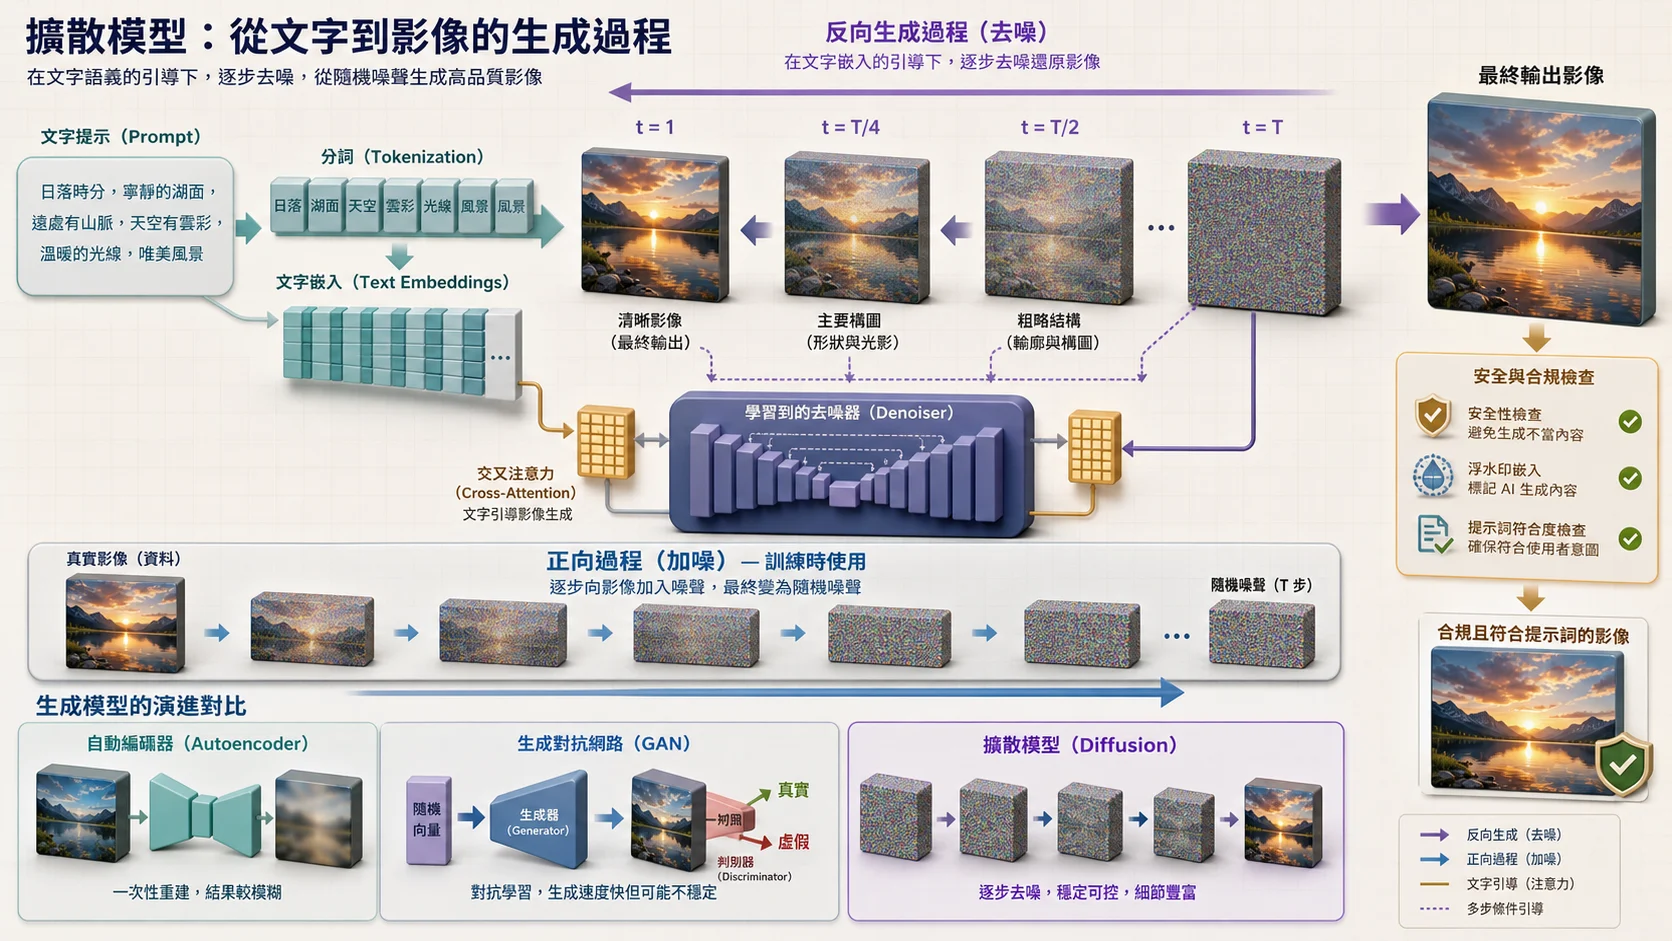
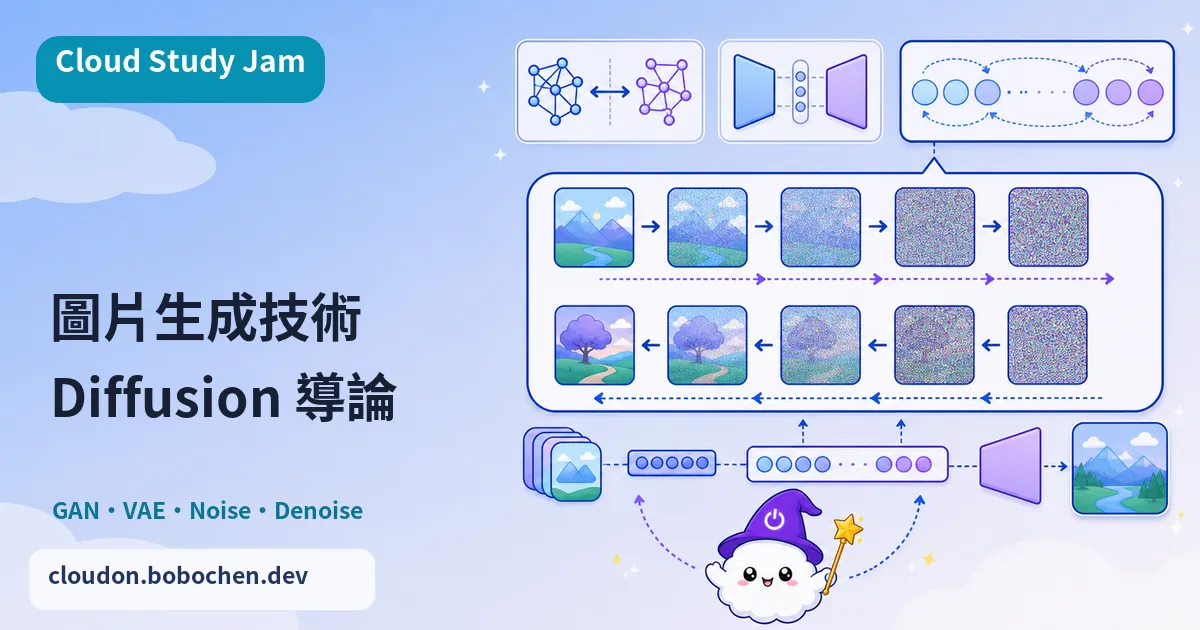
Diffusion 的生成是反覆去噪,不是一次畫完:文字語義在每一步引導構圖與細節,模型從純雜訊逐步收斂。相較 Autoencoder 與 GAN,Diffusion 較穩定且細節豐富;輸出仍要經安全、浮水印與 Prompt 符合度檢查。
你將學到
- 追溯圖片生成技術的演進:從 GAN 到 VAE 再到 Diffusion Model
- 解釋 Diffusion Model 的正向擴散與逆向去噪過程
- 理解文字到圖片(Text-to-Image)的技術架構
- 掌握 Google Imagen 在 Vertex AI 上的使用方式與限制
核心概念
圖片生成的三代技術
常見的生成架構包括 VAE(變分自編碼器)、**GAN(生成對抗網路)**與 Diffusion Model(擴散模型)。VAE 擅長學出連續的潛在空間,但早期生成結果常偏模糊;GAN 透過生成器和判別器對抗訓練,能做出銳利影像,卻比較難訓練,也可能發生模式崩潰;Diffusion 則靠逐步去噪生成圖片,訓練通常較穩定,也成為近年高品質圖片模型的重要路線。這不是單純的三代淘汰史,不同技術仍可能一起出現在現代系統裡。
Diffusion Model 的運作原理
Diffusion Model 的直覺不難。訓練時,正向過程(Forward Process)逐步替圖片加入噪聲,模型則學著預測每一步該去掉什麼。生成時再反過來,從隨機噪聲開始一輪一輪去噪。若加入文字條件(Text Conditioning),文字語義就能在過程中引導主體、構圖與風格。實際模型的數學和工程細節更複雜,但先抓住「不是一次畫完,而是反覆修正」就夠用了。
Text-to-Image 的技術架構
典型的潛在擴散系統可以先拆成三個部分:文字編碼器把描述轉成語義表示;去噪模型在潛在空間裡依照文字條件逐步生成;解碼器再把潛在表示還原成像素影像。這個拆法有助於理解 Diffusion,但不要把它當成所有圖片模型都完全相同的內部實作,尤其是能同時理解與產生圖片的原生多模態模型。
Google Imagen 的特色
Imagen 是 Google 的圖片生成模型家族,曾在 Vertex AI 上提供生成、編輯與放大等不同端點。使用代管模型時,除了畫質,也要確認模型版本、可用區域、人物生成設定、安全篩選與輸出來源標記。這些能力不一定集中在同一個模型或端點,開發前要以當下的模型文件為準。
時效提醒:Google 已棄用多個 Imagen 生成端點,官方要求在 2026 年 6 月 30 日前遷移,並建議改用受支援的 Gemini 圖片模型。新專案不要照抄舊 Lab 的模型 ID,請先查看Vertex AI 版本資訊與目前可用的模型。本文保留 Diffusion 原理作為技術背景,不代表 Gemini 圖片模型的內部架構與 Imagen 完全相同。
流程圖暫時無法顯示,請重新整理頁面後再試。
實作重點
- 在目前的 Studio 中確認可用圖片模型,再進行文字到圖片的生成實驗
- 嘗試不同風格的 Prompt(寫實照片、插畫、3D 渲染),觀察模型的風格適應能力
- 若所選模型支援 Negative Prompt,測試它對排除元素的影響;不支援時改用正向約束與後續編修
- 檢查所選模型的人物生成、安全篩選、輸出標記與資料使用限制,不要假設所有圖片模型設定相同
Lab 導讀
Lab 連結:Introduction to Image Generation — Google Cloud Skills Boost
這個 Lab 以技術原理為主,搭配視覺化演示說明 Diffusion Model 怎麼運作。測驗常比較 GAN、VAE、Diffusion,以及 Forward/Reverse Process 的差異。與其背「哪個一定最好」,不如記住各自怎麼生成、訓練時容易遇到什麼問題,以及為什麼逐步去噪能帶來穩定且細緻的結果。
延伸學習
- 向量搜尋與嵌入技術 — Embedding 在圖片搜尋中的應用
- 圖片說明生成模型 — 從生成圖片到理解圖片的反向任務
- Gemini 多模態 RAG 文件檢索 — 多模態模型的進階應用
相關文章
您可能也會對這些文章感興趣