
一張發票寄進信箱後,我們可能會做三件事:判斷它是不是異常、擷取金額與日期,再寫一封回覆供應商的信。
前兩件事偏向「辨識與預測」,第三件事才是「生成」。這個差別看起來很小,卻會直接影響模型選擇、測試方法,以及上線後該防哪些風險。
這一課先不碰程式碼。我們先把幾個容易混在一起的概念拆開。
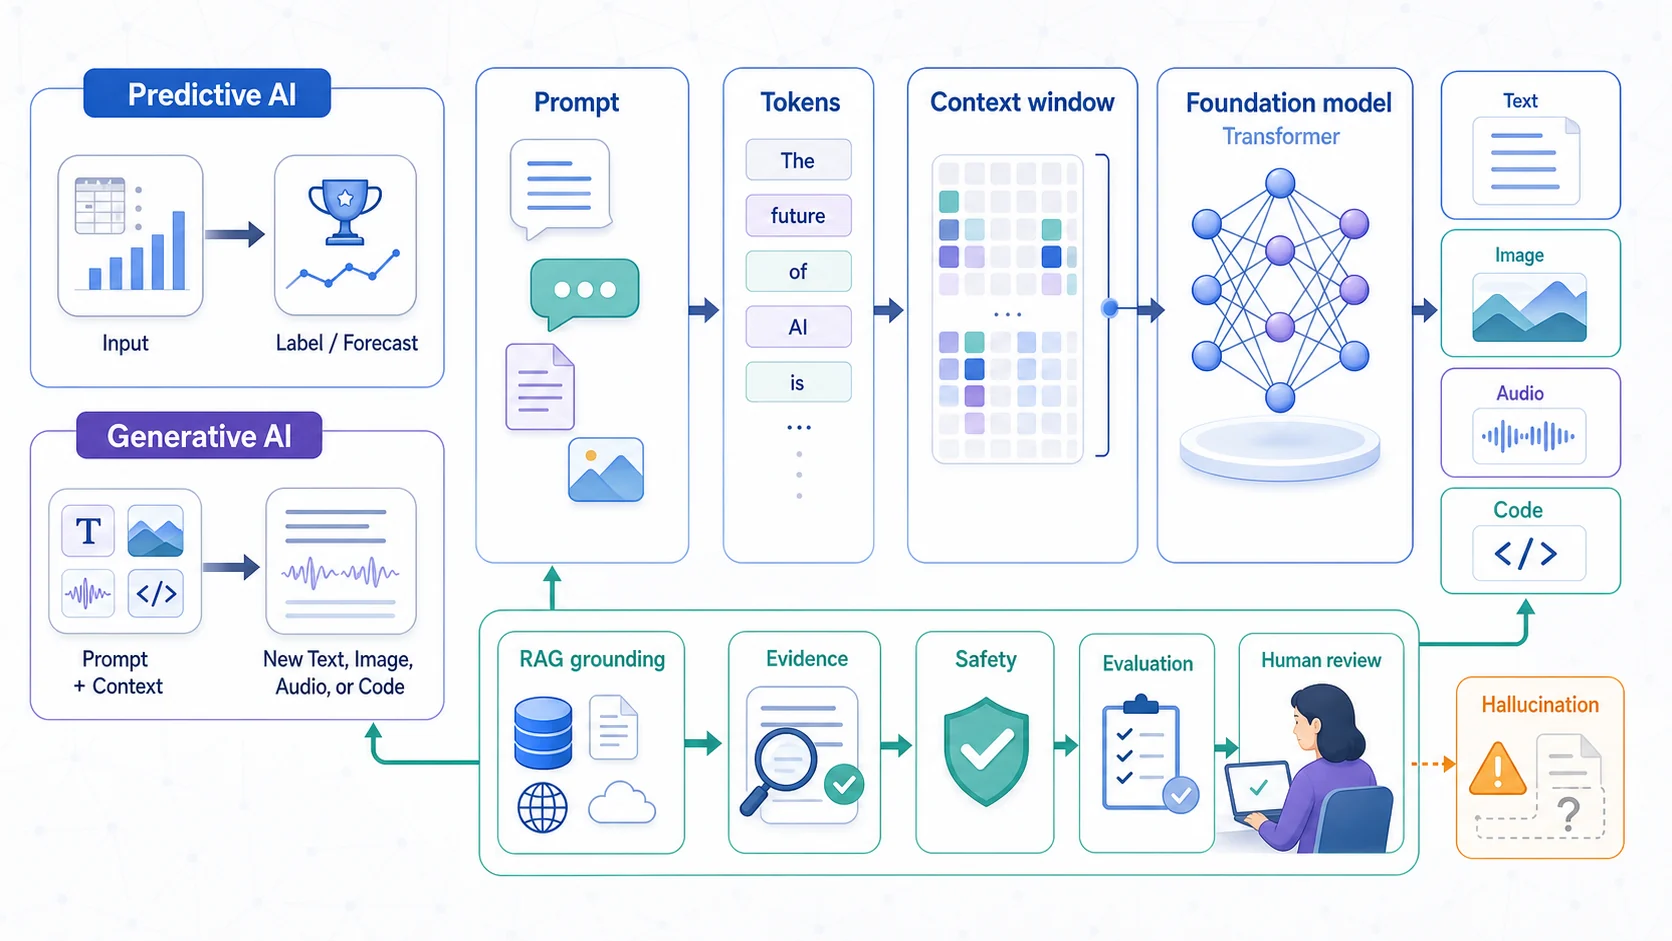
預測式 AI 主要輸出類別、分數或數值;生成式 AI 則根據 Prompt、上下文與機率分布產生新內容。模型輸出不是資料庫查詢,也不保證正確;RAG 提供證據,安全控制、評估與人工覆核再依風險層層把關。
預測式 AI 和生成式 AI 差在哪裡?
傳統機器學習常回答的是:
- 這封信是垃圾郵件嗎?
- 這筆交易有多大機率是詐騙?
- 下個月的需求量大約是多少?
模型從既有資料找出規律,再輸出類別、分數或數值。這類工作通常稱為預測式 AI。
生成式 AI 回答的則是:
- 幫我整理這份會議記錄
- 根據產品規格草擬客服回覆
- 把一段需求轉成程式碼或測試案例
- 依照文字描述產生圖片、語音或影片
它不是從資料庫找一段現成答案貼回來,而是根據輸入與訓練過的模式,逐步產生新的內容。
兩者並不是互相取代。實務上常把它們接在一起:先用模型判斷風險,再讓生成式模型整理理由,最後交給人員確認。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  I["輸入資料<br/>交易、郵件、影像、數值"] --> P["預測式 AI<br/>分類、分數、數值預測"]
  P --> D{"風險或條件<br/>需要說明?"}
  D -->|"是"| G["生成式 AI<br/>摘要、理由、回覆草稿"]
  D -->|"否"| A["一般程式執行規則"]
  G --> V["規則驗證/<br/>來源核對/人工覆核"]
  A --> O["業務結果"]
V --> O 一次看懂生成流程
可以先把生成式 AI 想成這條流程:
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  A["Prompt+Context<br/>文字、圖片、音訊、程式碼"] --> B["Tokenization"]
  B --> C["Foundation model<br/>依上下文逐步生成"]
  C --> D["候選輸出<br/>文字、圖片、音訊或程式碼"]
  D --> E{"有足夠證據且<br/>符合規則?"}
  E -->|"否"| F["拒答、補資料<br/>或人工處理"]
E -->|"是"| G["顯示、儲存<br/>或進入下一步"] 其中有幾個詞會一直出現。
基礎模型
基礎模型(foundation model)是在大量資料上預先訓練的模型。它已經具備通用能力,團隊不必每次都從零訓練。
大型語言模型(LLM)是基礎模型的一種,主要處理語言與程式碼。Gemini 則是多模態模型家族,能處理的輸入不只文字,也可能包含圖片、音訊、影片與 PDF;實際支援範圍仍要看個別模型版本。
Token
模型不會直接用「一句話」來計算,而是先把內容切成 Token。Token 數量會影響三件事:
- 輸入能放多少內容
- 回應最多能產生多長
- API 使用成本
所以把整個知識庫一次塞進提示詞,通常不是好主意。內容越長,不只成本變高,模型也可能更難抓到真正重要的資訊。
上下文窗口
上下文窗口是模型一次能處理的 Token 總量,包含輸入、對話歷史與輸出空間。
窗口很大,不代表什麼都該塞進去。正式系統仍要挑選相關內容、控制對話歷史,並保留足夠的輸出空間。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart LR
  S["System instruction"] --> W["Context window<br/>總 Token 上限"]
  H["對話歷史"] --> W
  R["檢索文件/圖片"] --> W
  U["本次使用者輸入"] --> W
  W --> O["必須保留的輸出空間"]
  W --> C["延遲與 API 成本"]
Transformer
目前主流語言模型多半建立在 Transformer 架構上。你不必先會推導數學公式,但要知道它擅長從上下文判斷詞與詞之間的關係,因此能延續語意、改寫內容,也能根據範例模仿格式。
Embedding
Embedding 會把文字、圖片或其他內容轉成向量。語意相近的內容,在向量空間裡通常也比較接近。
它常被用在語意搜尋與 RAG(Retrieval-Augmented Generation,檢索增強生成):先從你提供的資料裡找出與問題最相關的片段,再交給生成模型根據這些片段回答。模型原本不知道的內部文件或最新資料,就是靠這一步補進來。第五課會把完整流程拆開。
生成式 AI 適合做什麼?
它很適合當「第一版產生器」或「資訊整理助手」,例如:
- 摘要長文件,列出待確認事項
- 從客服訊息擷取主題、情緒與產品名稱
- 根據既定資料草擬回覆
- 產生程式碼骨架、測試案例或文件初稿
- 把相同內容改寫成不同受眾能理解的版本
判斷一個需求是否適合導入,可以先問四個問題:
- 輸出錯誤時,後果有多大?
- 有沒有可靠資料可以核對?
- 能不能用規則、測試或人工覆核驗證?
- 這項工作真的需要生成內容,還是搜尋與傳統程式就夠了?
低風險、可驗證,而且目前很耗人力的工作,通常比較適合作為第一個導入案例。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  A["候選工作"] --> B{"真的需要產生新內容?"}
  B -->|"否"| C["搜尋、規則或傳統 ML"]
  B -->|"是"| D{"錯誤後果可控?"}
  D -->|"否"| E["縮小範圍並加入人工核准"]
  D -->|"是"| F{"有資料、規則或測試<br/>可以驗證?"}
  F -->|"否"| G["先建立評估與證據來源"]
F -->|"是"| H["從低風險、<br/>高耗時流程試點"] 它會在哪裡出錯?
生成模型的目標是產生合理的下一段內容,不是保證每句話都是真的。常見問題包括:
- 內容看起來合理,但事實錯誤:這通常被稱為幻覺。
- 相同輸入不一定得到完全相同的答案:生成具有機率性。
- 不知道公司的內部資料:除非你把資料安全地提供給模型,或接上檢索系統。
- 可能受到惡意指令影響:外部文件或使用者輸入可能藏有 Prompt Injection。
- 可能輸出敏感或不合規內容:權限、資料遮罩、記錄與人工審核仍然重要。
RAG、結構化輸出與安全防護能降低風險,但沒有任何單一技術能保證答案永遠正確。下圖還會出現 Grounding 這個詞:它指的是讓模型的回答接上可查證的資料來源,例如企業文件或搜尋結果,RAG 是其中最常見的做法。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  I["不受信任的<br/>輸入與文件"] --> M["生成模型"]
  M --> O["候選輸出"]
  A["IAM/<br/>資料最小權限"] -. "限制可取得資料" .-> I
  G["Grounding/RAG"] -. "提供可追溯證據" .-> M
  S["Schema/<br/>業務規則"] -. "檢查格式與範圍" .-> O
  E["測試集/持續評估"] -. "量測品質與攻擊案例" .-> O
  H["人工核准"] -. "攔截高風險動作" .-> O
Google Cloud 在這張圖裡扮演什麼角色?
先記住三個入口就夠了:
- Gemini:Google 的多模態模型家族。
- Gemini Enterprise Agent Platform(原 Vertex AI):在 Google Cloud 上建置、評估、治理與執行 AI 工作負載的平台,2026 年 4 月起改用現在的名字。你在舊教材、Console 部分頁面與 SDK 參數裡仍會看到 Vertex AI,指的是同一個平台。
- Model Garden:瀏覽與選用 Google、合作夥伴及開放模型的入口。
下一課會把這些產品放回實際情境:要快速試 Prompt、呼叫 Gemini、找其他模型,或替企業資料建立搜尋與 Agent,各自該從哪裡開始。
和 Generative AI Leader 認證的關係
Google Cloud 的 Generative AI Leader 認證不要求先有實作經驗,考的也不只是模型名詞。官方考綱目前分成四個領域:
- 生成式 AI 基礎(Fundamentals of gen AI,約 30%)
- Google Cloud 的生成式 AI 產品(Google Cloud’s gen AI offerings,約 35%)
- 改善模型輸出的技巧(Techniques to improve gen AI model output,約 20%)
- 商業策略(Business strategies for a successful gen AI solution,約 15%)
這門課的五堂對應前三個領域:這一課是領域 1,第 2、3 課是領域 2,第 4、5 課的 Prompt 與 RAG 是領域 3。後三堂偏實作,要寫 Python、呼叫 API,比考試要求的深;只準備認證的話,讀懂觀念就夠,程式可以先跳過。領域 4 的導入步驟、Secure AI 與 Responsible AI 沒有專門一堂,要回官方認證頁的考試指南補。
整門課的重點不是背產品清單,而是能說清楚「為什麼選它」以及「怎麼確認結果可信」。
10 分鐘離線判讀:活動助手應該做到哪一步?
用紙筆即可完成,不需帳號或模型 API。以下資料、草稿與規則都是本站編寫的合成情境,並非真實活動。先寫下你的判斷,再展開答案。
社區館想做一個活動助手,承辦已核准這份 A 場次資料卡,作為本輪公告的來源;時間均指活動場地的當地時間。
| 欄位 | 本輪已知資料 |
|---|---|
| 活動 | 天文觀測入門 |
| 時間 | 週六 18:30–19:30 |
| 地點 | 社區館二樓教室 |
| 總名額 | 20 人 |
| 報名流程 | 先登記,再由承辦確認入場資格 |
| 尚未提供 | 目前剩餘名額、已確認名單、候補規則 |
| 工具權限 | 可讀取資料卡、產生待審草稿;不能改名額、核准資格或寄出通知 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
現在有三段工作:
- 使用者輸入場次編號,回傳時間、地點與總名額。
- 把資料卡改寫成一段容易閱讀的公告。
- 回覆「我登記了,可以保證入場嗎?」並寄出確認通知。
另外,某份候選草稿寫道:
週六 19:00 來戶外觀星!活動還有 20 個位置,登記就保證入場,候補者也都能參加。
先交出三項成果:
- 替每段工作選擇查詢/規則、生成草稿或人工確認的分工,說明你用什麼驗收。
- 指出草稿至少三個無法由資料卡支持的說法,再改寫成兩句可核對的公告;未知資訊要保留為未知。
- 說明即使草稿附上資料卡連結,第三段工作仍缺哪些證據或授權。
寫完再展開:方法、事實與執行權限要分開核對
第一段已有明確欄位,可以優先用查詢或程式直接回傳。若使用模型擷取,也要逐欄核對來源;產生一段流暢文字本身不算驗收。第二段有改寫需求,可讓生成式模型提供候選公告,再核對時間、地點、名額及報名狀態。第三段需要最新的個別資格與承辦核准,寄出通知還需要執行權限;本輪工具只能交出待審草稿。
候選草稿的問題包括:開始時間應為 18:30、地點是二樓教室而非已確認的戶外活動、20 是總名額而非剩餘名額、登記不等於已核准,以及資料卡沒有提供候補規則。語氣可以自由改寫,這些事實不能跟著改。
一份可接受的修正版是:
週六 18:30–19:30,社區館二樓教室將舉辦天文觀測入門,總名額 20 人。請先登記並等候承辦確認;目前剩餘名額與候補方式尚待確認。
也可以採用不同措辭,或省略未知欄位,但不能把未知寫成保證。對已登記的詢問者,可回覆「登記後仍需承辦確認,目前沒有資料可以核對你的入場資格」,並交由承辦處理。
資料卡連結讓人能追溯來源,仍要檢查文字是否真的受到來源支持。Grounding/RAG 可提供可追溯資訊並降低憑空生成的風險;個別資格、來源內容與可執行動作仍要分別核對。可對照官方 Grounding 說明。
改一個條件:現在有已核准名單了
承辦新增一份本輪已核准的確認表,提供這批要通知的五筆登記 ID:R01、R03、R05、R08、R09;這份表未提供完整名額帳目或其他登記狀態。其他條件不變,工具仍只有草稿權限。助手現在可以多做什麼?哪些事仍不能推論或執行?
參考判斷與最低完成條件
現在可以依確認表,為這五筆 ID 產生個別的確認通知草稿,並核對每份草稿只引用對應的核准狀態。仍不能自行寄出、替其他 ID 核准,或把未列入者一律判為已拒絕;也不能只用總名額減去五筆,就宣稱剩餘名額為 15,因為本題沒有提供完整且即時的名額狀態。
完成前,檢查自己的答案是否做到:
- 說明三段工作的分工與驗收,包含至少一段可直接查詢的工作。
- 修正至少三個有具體來源依據的錯誤,且修正版沒有新增入場、候補或剩餘名額保證。
- 分清楚「登記」「已核准」與「已寄出」,指出本輪工具停在草稿。
- 新增名單後能更新這五筆的判斷,同時保留其他資格、名額狀態與寄送權限的界線。
只寫「加上 RAG 就好」或「全部交給人工」還不能表明你已分清每段任務。若卡在分工,回〈生成式 AI 適合做什麼?〉;若卡在來源核對,回〈它會在哪裡出錯?〉。
課後檢查
讀完後,你應該能用自己的話回答:
- 分類詐騙交易和草擬客服回覆,為什麼是不同類型的 AI 任務?(答不出來就回到預測式 AI 和生成式 AI 差在哪裡?)
- Token 與上下文窗口會如何影響成本和答案品質?(回到 Token 與上下文窗口)
- 哪些工作可以直接讓模型產生初稿,哪些一定要加上驗證或人工覆核?(回到生成式 AI 適合做什麼?)
- RAG 想解決的是哪一類問題?(回到 Embedding 與它會在哪裡出錯?)
下一課會整理 Google Cloud 的產品地圖,並用幾個需求快速判斷該從哪個服務開始。