
這一課的目標很單純:把 Gemini 從網頁上的試玩介面,接進一支能重複執行的 Python 程式。
本課使用 gemini-3.5-flash 作為固定範例。如果你在較晚的時間閱讀,請先查看官方模型版本與生命週期,確認 Model ID 和可用區域仍相同。
平台現在的正式名稱是 Gemini Enterprise Agent Platform(原 Vertex AI,以下簡稱 Agent Platform)。API 與 IAM 仍可看到舊識別字 aiplatform.googleapis.com、roles/aiplatform.user。本課依目前 SDK 使用 enterprise=True 與 GOOGLE_GENAI_USE_ENTERPRISE,不要把不同年代的環境設定混在同一段程式裡。
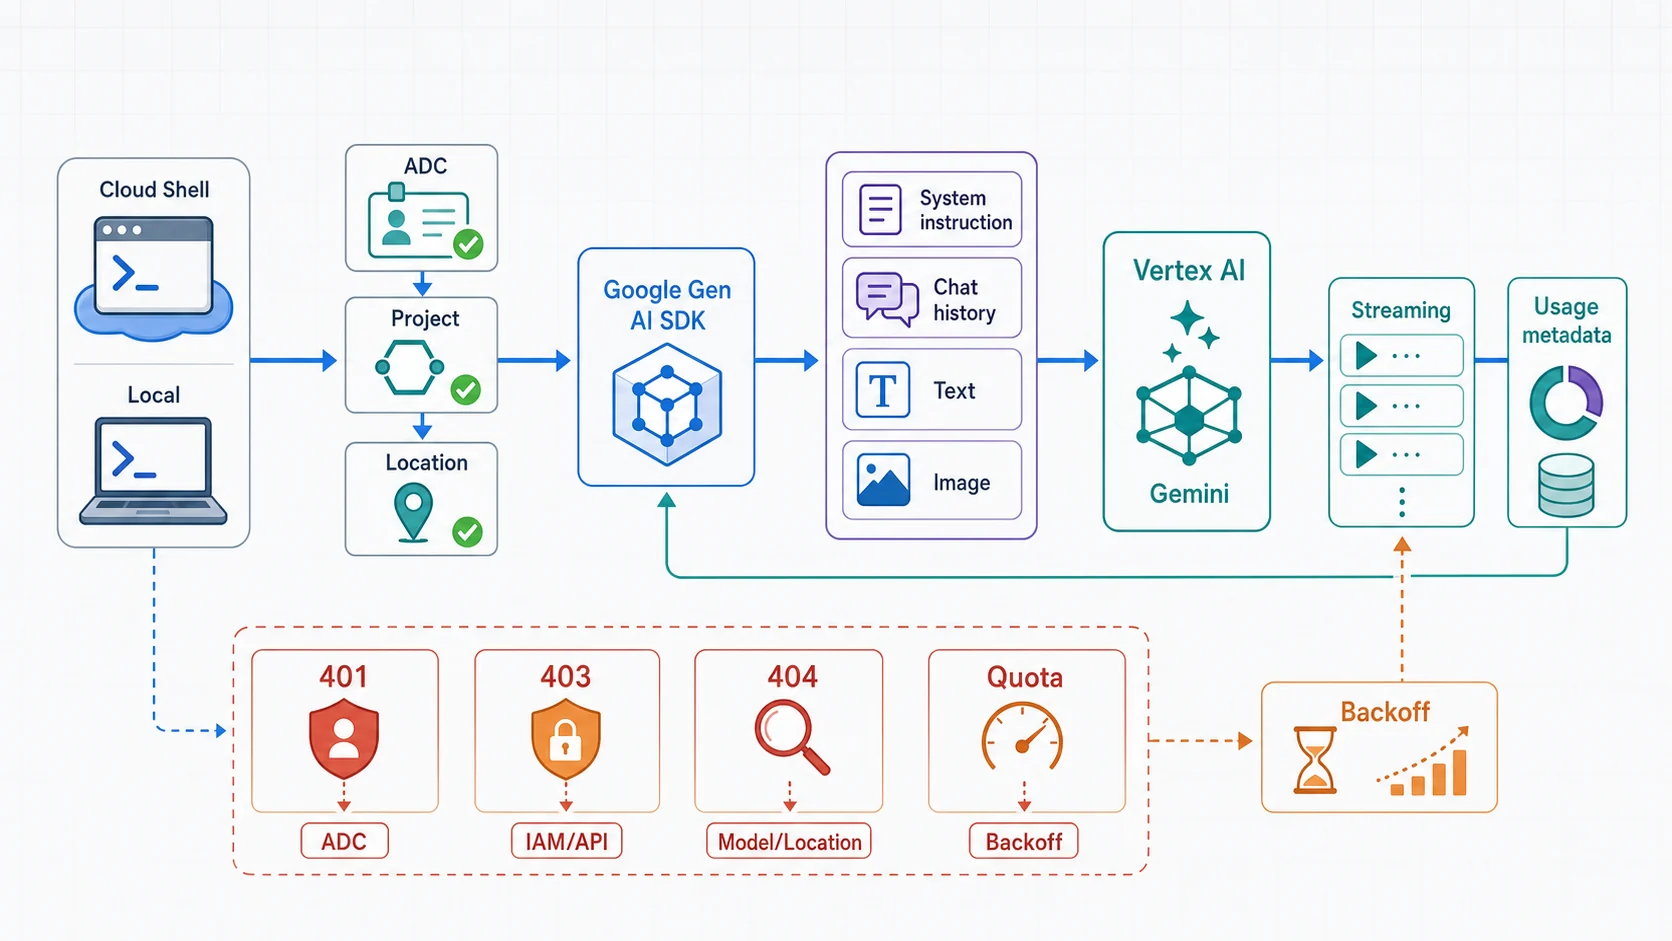
ADC 證明「你是誰」,IAM 與 API 狀態決定「你能不能呼叫」;Project、Location 與 Model ID 則決定請求送去哪裡。System instruction、對話歷史和多模態內容共同占用上下文,串流只改變回傳方式,Usage metadata 才能用來追蹤 Token。除錯時先按 401、403、404、配額分流,不要只重跑同一段程式。圖上的 Vertex AI 是平台更名前的名稱。
完成後會有什麼?
先完成專案與身分設定,再做第一個文字請求。確認可運作後,依序選做圖片、串流、系統指示、多輪對話與需求澄清助手。每個範例是獨立檔案,不要把後面的程式接在 app.py 底部。
| 檔案 | 要驗證的能力 | 每次執行的生成請求數 |
|---|---|---|
lab_common.py | 共用設定、回應與用量檢查;匯入時不呼叫模型 | 0 |
app.py | 第一個完整文字回應 | 1 |
image_demo.py | 讀取本課提供的圖片,核對可見內容 | 1 |
stream_demo.py | 區分串流草稿、完整結束與中斷 | 1 |
system_demo.py | 驗證系統指示的行為 | 1 |
chat_demo.py | 驗證同一個 Chat 的兩輪歷史 | 2 |
assistant_demo.py | 依固定案例評估澄清問題 | 1 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
六支範例各跑一遍共 7 次邏輯生成請求;重跑會再送出。本課關閉 SDK 自動重試,讓練習的請求數容易辨認。請求可能計費,輸出 Token 上限也不是金額上限,開始前核對模型定價。
安排參考:環境與第一個請求約 35–45 分鐘,延伸範例與驗收約 45–55 分鐘;安裝、登入、API 啟用等待與排錯另計。中途停止時,先看恢復設定或清理與接續,不要重新建立一份不知道用途的環境。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  A["專案、API、ADC"] --> B["文字請求"]
  B --> C["Usage metadata<br/>Token 用量"]
  C --> D["文字+圖片<br/>多模態輸入"]
  D --> E["Streaming 回應"]
  E --> F["System instruction"]
  F --> G["Chat history<br/>多輪對話"]
  G --> H["需求澄清助手<br/>加入行為測試"]
步驟一:固定練習專案與身分
準備 Python 3.10 以上、Google Cloud CLI,以及已獲授權、已啟用計費的 Google Cloud 專案。以下使用 Bash;Windows 可直接使用 Cloud Shell。沒有專案時先完成 GCP 環境設定,不要在這一課臨時使用不明的公司專案。
將第一行的 YOUR_PROJECT_ID 改成自己的 Project ID。這段只讀取雲端狀態、建立本機資料夾與設定檔;不改 CLI 預設專案、不啟用 API。若查詢權限不足或計費未就緒,先請管理員確認,再進下一步。
COA_GENAI_PROJECT_ID='YOUR_PROJECT_ID'
coa_prepare_genai_lab() (
  set -eu
  case "$COA_GENAI_PROJECT_ID" in
    ''|'YOUR_PROJECT_ID') echo '請先填入自己的 Project ID。' >&2; exit 1 ;;
  esac
  lab_account="$(gcloud auth list --filter='status:ACTIVE' --format='value(account)')" || exit 1
  case "$lab_account" in
    ''|'(unset)'|*$'\n'*) echo '請先確認唯一的 CLI 登入帳號。' >&2; exit 1 ;;
  esac
  gcloud projects describe "$COA_GENAI_PROJECT_ID" --account="$lab_account" >/dev/null || exit 1
  billing_enabled="$(gcloud billing projects describe "$COA_GENAI_PROJECT_ID" \
  --account="$lab_account" --format='value(billingEnabled)')" || exit 1
  case "$billing_enabled" in
    True|true) ;;
    *) echo '請先確認本專案的計費狀態。' >&2; exit 1 ;;
  esac
  enabled_api="$(gcloud services list --enabled --project="$COA_GENAI_PROJECT_ID" \
  --account="$lab_account" --filter='config.name=aiplatform.googleapis.com' \
  --format='value(config.name)')" || exit 1
  case "$enabled_api" in
    aiplatform.googleapis.com) api_was_enabled=yes ;;
    '') api_was_enabled=no ;;
    *) echo '無法確認 API 初始狀態,請先停止。' >&2; exit 1 ;;
  esac
  umask 077
  lab_dir="$(mktemp -d "$HOME/coa-genai-lab.XXXXXX")" || exit 1
  {
    printf 'export COA_GENAI_PROJECT_ID=%q\n' "$COA_GENAI_PROJECT_ID"
    printf 'export COA_GENAI_CLI_ACCOUNT=%q\n' "$lab_account"
    printf 'export COA_GENAI_API_WAS_ENABLED=%q\n' "$api_was_enabled"
    printf 'export COA_GENAI_LOCATION=global\n'
    printf 'export COA_GENAI_MODEL=gemini-3.5-flash\n'
    printf 'export GOOGLE_CLOUD_PROJECT=%q\n' "$COA_GENAI_PROJECT_ID"
    printf 'export GOOGLE_CLOUD_LOCATION=global\n'
    printf 'unset GOOGLE_GENAI_USE_VERTEXAI\nexport GOOGLE_GENAI_USE_ENTERPRISE=true\n'
  } > "$lab_dir/.coa-genai-env" || exit 1
  printf '%s\n' "$lab_dir"
)
COA_GENAI_LAB_DIR="$(coa_prepare_genai_lab)" &&
  cd "$COA_GENAI_LAB_DIR" && source ./.coa-genai-env
確認目前資料夾及設定,並記下這個資料夾的完整路徑:
pwd
printf 'Project:%s\nCLI 帳號:%s\nLocation:%s\nAPI 原先啟用:%s\n' \
  "$COA_GENAI_PROJECT_ID" "$COA_GENAI_CLI_ACCOUNT" \
  "$COA_GENAI_LOCATION" "$COA_GENAI_API_WAS_ENABLED"
.coa-genai-env 只保存範圍設定,不含權杖、ADC 原文或私鑰。COA_GENAI_* 是本課設定;同時保留標準的 GOOGLE_CLOUD_* 供下一課使用。本課 Client 明確傳入保存的 Project 與 Location,切換 CLI 預設專案不會改變本次 Python 請求的專案。
接著才啟用本課需要的 API:
if [ "$COA_GENAI_API_WAS_ENABLED" = 'no' ]; then
  gcloud services enable aiplatform.googleapis.com --project="$COA_GENAI_PROJECT_ID" --account="$COA_GENAI_CLI_ACCOUNT"
else
  echo 'API 原先已啟用,略過啟用步驟。'
fi
目前應用程式身分需要模型呼叫權限,例如 roles/aiplatform.user 或等效自訂角色;啟用 API 則需要另有服務管理權限,不要為了讓練習通過就授予 Owner。若公司不允許 global,先由管理員確認模型支援的位置,再調整保存設定中的兩個 Location 值。
CLI 帳號與 ADC 不是同一個檢查
上面記錄的是 CLI 指令使用的身分,不證明 Python 的 ADC 一定是同一個帳號。Cloud Shell 通常已提供登入工作階段的憑證,不需另外登入。
本機環境需依官方 ADC 設定建立應用程式憑證,登入時確認使用獲授權的帳號:
gcloud auth application-default logingcloud auth login 供 CLI 使用;上面的 application-default 指令供應用程式使用。若已設定 GOOGLE_APPLICATION_CREDENTIALS,ADC 會優先讀取它指定的設定檔,先確認用途,不要盲目刪除、覆寫或把檔案內容貼進紀錄。本課不建立或下載服務帳戶金鑰。
若錯誤指出 ADC 缺少 quota project,本機使用者可在有 serviceusage.services.use 權限的前提下,依官方說明設定:
gcloud auth application-default set-quota-project "$COA_GENAI_PROJECT_ID"這會更新本機 ADC 的 quota project,不是更換登入帳號,也不是所有環境都必須執行;Cloud Shell 或組織提供的憑證依管理員配置處理。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  U["使用者"] --> C{"執行環境"}
  C -->|"Cloud Shell"| S["登入工作階段<br/>已提供憑證"]
  C -->|"本機終端機"| L["gcloud auth login<br/>供 CLI 使用"]
  L --> A["gcloud auth<br/>application-default login<br/>建立 ADC 給應用程式"]
  S --> V["Google Gen AI SDK"]
  A --> V
V --> I["IAM 檢查<br/>Agent Platform 使用權限"] 步驟二:建立獨立 Python 環境
保持在剛才印出的資料夾內,再執行:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade google-genai
python -m pip show google-genai
python -m pip freeze > requirements.lab.txt
保存顯示的 Python/SDK 版本;安裝失敗先停止。後面的 enterprise、HttpRetryOptions 與 context manager 使用目前 SDK 介面,舊版本不支援時請在這個虛擬環境更新套件。
換分頁或重開終端機,先恢復這份設定
把下面第一行改成先前記下的完整資料夾路徑,不要用萬用字元隨機挑一份:
cd '/請替換成先前的完整資料夾路徑' && \
  source ./.coa-genai-env && source .venv/bin/activate
確認 pwd、Project、CLI 帳號與 Location 都正確,再跑後續檔案;不需要重新執行準備段、覆蓋 API 初始狀態或再建立一個資料夾。ADC 若已失效,另依登入章節處理,不要將重建資料夾當成修復憑證。
步驟三:送出第一個請求
先建立 lab_common.py
這個共用檔只定義設定與檢查函式,匯入時不會建立 Client 或呼叫模型。所有範例都從同一份設定取得 Project、Location 與 Model ID。
import os

from google import genai
from google.genai import types

MODEL_ID = os.environ.get("COA_GENAI_MODEL", "gemini-3.5-flash")


def make_client():
    project = os.environ.get("COA_GENAI_PROJECT_ID", "").strip()
    location = os.environ.get("COA_GENAI_LOCATION", "").strip()
    if not project or not location or "YOUR_" in project or not MODEL_ID:
        raise ValueError("先恢復 .coa-genai-env,確認本次 Project、Location 與 Model ID。")
    return genai.Client(
        enterprise=True,
        project=project,
        location=location,
        http_options=types.HttpOptions(
            api_version="v1",
            retry_options=types.HttpRetryOptions(attempts=1),
        ),
    )


def make_config(**options):
    return types.GenerateContentConfig(max_output_tokens=2048, **options)


def require_complete_text(response):
    candidates = response.candidates or []
    if not candidates:
        raise RuntimeError("沒有候選回答,請檢查 prompt_feedback;不要把空值當成功。")
    if candidates[0].finish_reason != "STOP":
        raise RuntimeError("回應未完整結束,請檢查 finish_reason;先不要採用。")
    text = response.text
    if not text or not text.strip():
        raise RuntimeError("沒有可用文字,請檢查回應內容與請求格式。")
    return text


def show_usage(usage):
    fields = [
        ("輸入 Token", "prompt_token_count"),
        ("候選輸出 Token", "candidates_token_count"),
        ("推理 Token", "thoughts_token_count"),
        ("總 Token", "total_token_count"),
    ]
    for label, name in fields:
        value = getattr(usage, name, None) if usage is not None else None
        print(f"{label}:{value if value is not None else '未提供'}")
attempts=1 包含原始請求,這裡是不自動重試。max_output_tokens=2048 是練習用的輸出限制,不保證能完整回答;收到截斷狀態時,先縮小問題或核對模型設定,再決定是否重新送出。
再建立 app.py
from lab_common import MODEL_ID, make_client, make_config, require_complete_text, show_usage


def main():
    with make_client() as client:
        response = client.models.generate_content(
            model=MODEL_ID,
            contents="用三個重點說明 Cloud Run 適合什麼工作負載。",
            config=make_config(),
        )
        text = require_complete_text(response)
        print(text)
        print("完成狀態:STOP;內容仍需核對。")
        show_usage(response.usage_metadata)


if __name__ == "__main__":
    main()
執行一次:
python app.py成功條件:程式取得非空白、以 STOP 結束的文字回應,且用量欄位有數值或明確標為「未提供」。這代表本次呼叫路徑可運作,不代表三個重點的事實已驗證;用產品文件核對內容,再記錄 SDK 版本、Project、Location、Model ID、結束狀態與用量,不保存憑證或完整敏感 Prompt。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
sequenceDiagram
  participant P as Python 應用程式
  participant S as Google Gen AI SDK
  participant A as Google Cloud Auth/IAM
  participant V as Agent Platform 上的 Gemini
  P->>S: model+contents+config
  S->>A: 以 ADC 取得身分
  A-->>S: 權限驗證結果
  S->>V: Project+Location+Model ID+Request
  V-->>S: Candidates+Usage metadata
  S-->>P: response.text/parsed result
  P->>P: 驗證、記錄 Token、處理錯誤
步驟四:讀懂同一份回應的 Token 用量
app.py 已在同一次請求後呼叫 show_usage(),不需為了看 Token 再送一個生成請求。
- 0 是回傳的零用量;未提供 表示欄位缺漏,不能補成 0。
- 候選輸出、推理與總量是不同欄位,不要只用「輸入加可見文字」自行推算整張帳單。
- 用量資料不是定價;成本還需對照模型、輸入類型、快取與當時價格。
[STOP + 有文字]檢查的是回應是否完整,Token 多或少都不能證明回答品質。
欄位定義以官方 UsageMetadata為準。正式應用還要驗證輸出內容,並以不含機密原文的方式記錄品質與用量。
步驟五:加入本課提供的圖片
先下載練習架構圖(WebP),將檔案放進本次資料夾並命名為 architecture.webp。本機可用檔案管理器移入;Cloud Shell 可用「上傳檔案」,上傳到剛才記下的完整資料夾。先確認檔案確實在目前資料夾,不要只改副檔名來假裝轉換格式。
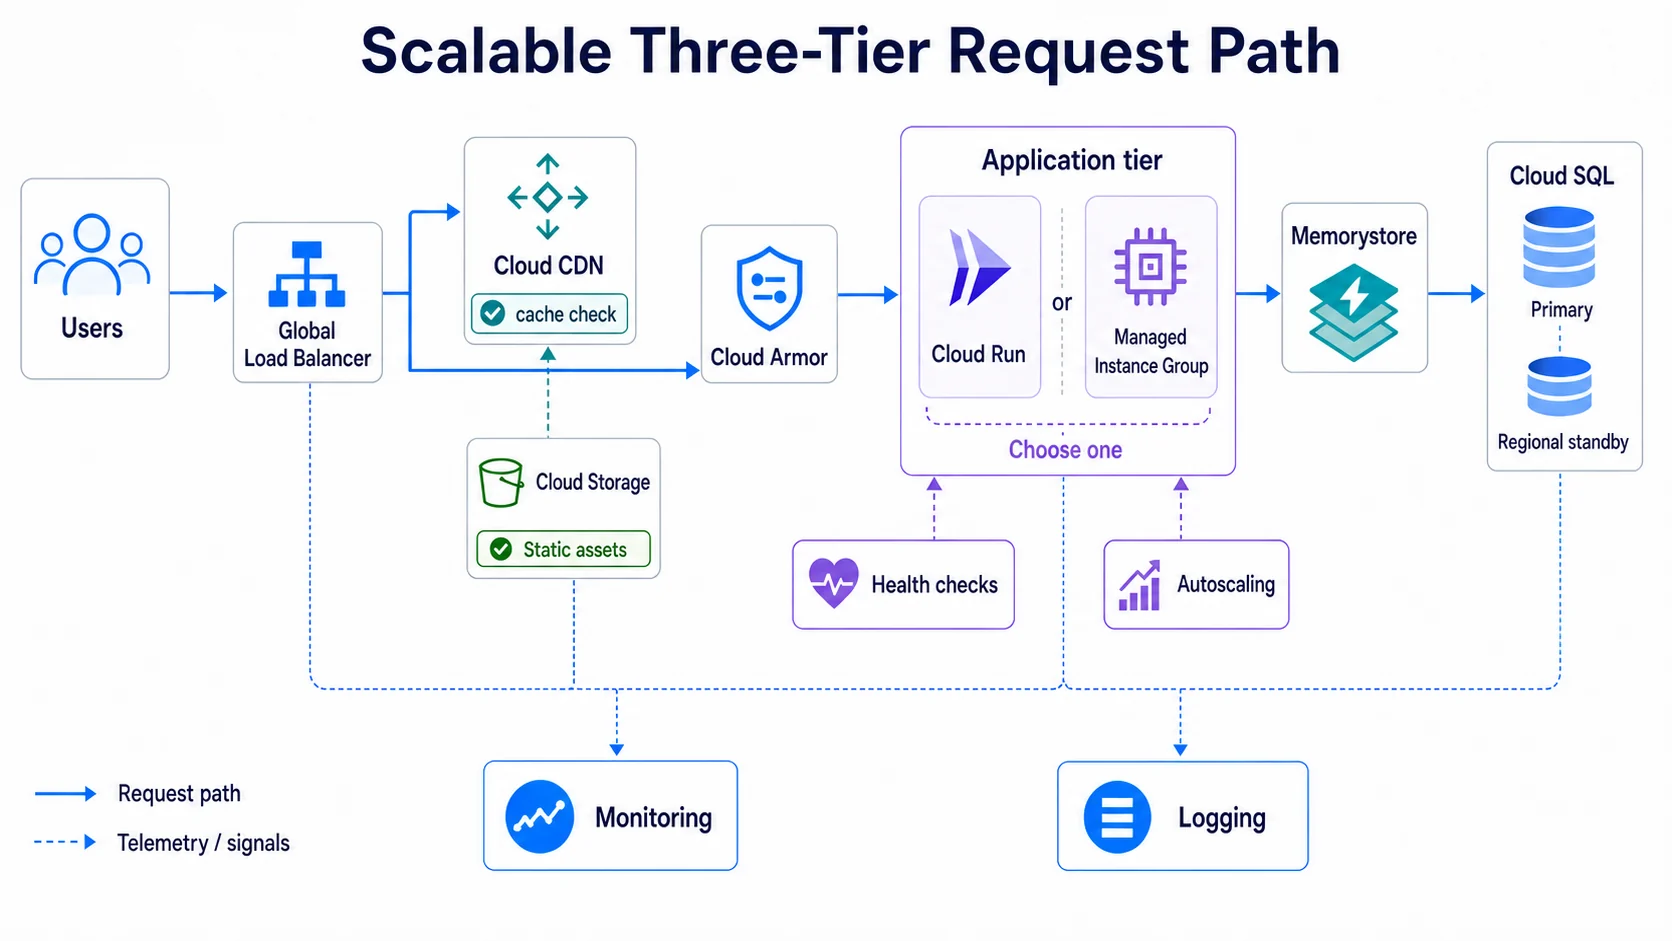
這是閱讀圖片的練習素材,不是已驗證的部署建議;未畫出的政策與執行條件仍需補查。
建立獨立的 image_demo.py:
from pathlib import Path

from google.genai import types
from lab_common import MODEL_ID, make_client, make_config, require_complete_text, show_usage


def main():
    image_path = Path("architecture.webp")
    if not image_path.is_file():
        raise FileNotFoundError("先下載並放入本課的 architecture.webp,再執行。")
    image_bytes = image_path.read_bytes()
    if image_bytes[:4] != b"RIFF" or image_bytes[8:12] != b"WEBP":
        raise ValueError("檔頭不是 WebP;請取得正確圖片,不要只改副檔名。")
    with make_client() as client:
        response = client.models.generate_content(
            model=MODEL_ID,
            contents=[
                types.Part.from_bytes(data=image_bytes, mime_type="image/webp"),
                "用繁體中文描述圖中可見的請求路徑,並列出兩個圖中無法確認的條件。"
                "不要推論圖外的安全政策、延遲或復原保證。",
            ],
            config=make_config(),
        )
        print(require_complete_text(response))
        show_usage(response.usage_metadata)


if __name__ == "__main__":
    main()
python image_demo.py驗收:回答應辨認圖上可見的元件與箭頭,且不把 Cloud Run 與 Managed Instance Group 的「二選一」說成同時部署。它不能從這張圖證明實際 IAM、p95 延遲或跨區復原能力。換自己的圖片時,檢查 MIME、大小與模型支援格式,不要送入機密圖或憑證截圖。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  T["文字指示<br/>要觀察什麼"] --> C["contents 陣列"]
  I["Image bytes<br/>正確 MIME type"] --> C
  C --> M["Gemini 多模態理解"]
  M --> O["可見內容的描述與風險線索"]
  O --> V["應用程式/人工補查<br/>圖外政策、流量與復原需求"]
步驟六:串流要分清草稿與完成
建立 stream_demo.py。串流中的文字先標為草稿;只有收到正常結束且有文字,才標示完整接收。僅有 Token metadata 的 chunk 不會被當成回答,也不會清掉先前文字。
from lab_common import MODEL_ID, make_client, make_config, show_usage


def main():
    parts = []
    finish_reason = None
    usage = None
    print("串流草稿,尚未確認完成:")
    try:
        with make_client() as client:
            for chunk in client.models.generate_content_stream(
                model=MODEL_ID,
                contents="用三個重點比較 Cloud Run、GKE 與 Compute Engine 的選擇條件。",
                config=make_config(),
            ):
                if chunk.text:
                    parts.append(chunk.text)
                    print(chunk.text, end="", flush=True)
                if chunk.usage_metadata is not None:
                    usage = chunk.usage_metadata
                for candidate in chunk.candidates or []:
                    if candidate.finish_reason is not None:
                        finish_reason = candidate.finish_reason
    except (Exception, KeyboardInterrupt):
        print("\n串流中斷;前面的文字不能當成完整回應。")
        raise
    if finish_reason != "STOP" or not "".join(parts).strip():
        raise RuntimeError("串流未正常完整結束;已顯示的內容仍是草稿。")
    print("\n已完整接收;內容仍需核對。")
    show_usage(usage)


if __name__ == "__main__":
    main()
python stream_demo.py驗收:一般結束時能看到完整接收與用量;若以 Ctrl+C 中止,或連線失敗、未收到 STOP,都不能顯示完整成功。本機中止或關閉連線不證明服務端從未處理請求,不要因此假設沒有費用,或自動重送並把新舊文字拼在一起。
串流改變的是回傳方式;不能只因比較早看到字,就推定總延遲、模型品質或費用一定改善。
步驟七:加入系統指示
建立 system_demo.py,用固定行為要求測試模型是否先澄清資訊:
from lab_common import MODEL_ID, make_client, make_config, require_complete_text, show_usage


def main():
    with make_client() as client:
        response = client.models.generate_content(
            model=MODEL_ID,
            contents="我們的 API 偶爾出現 503,應該先看什麼?",
            config=make_config(system_instruction=(
                "你是雲端維運助理。使用繁體中文回答。"
                "先指出缺少的環境資訊,再提供可驗證的檢查順序;"
                "不要在沒有 Log 或指標時直接判定根因。"
            )),
        )
        print(require_complete_text(response))
        show_usage(response.usage_metadata)


if __name__ == "__main__":
    main()
python system_demo.py驗收:回答應詢問服務、時間範圍、部署變更或日誌等證據,不能直接斷言「一定是資料庫過載」。系統指示沒有取代 IAM、資料過濾或工具核准;格式與完整回應檢查通過,也還需要這份行為驗收。
步驟八:建立多輪對話
建立 chat_demo.py。同一個 Chat 物件的第二輪會包含之前對話;第一輪沒有完整文字就停止,不會直接再送第二輪。
from lab_common import MODEL_ID, make_client, make_config, require_complete_text, show_usage


def main():
    with make_client() as client:
        chat = client.chats.create(
            model=MODEL_ID,
            config=make_config(system_instruction=(
                "你是需求澄清助手。資訊不足時先提問,不要自行補完或做費用保證。"
            )),
        )
        first = chat.send_message("我們想把一個內部 API 搬到 Google Cloud。")
        print("第一輪:", require_complete_text(first))
        show_usage(first.usage_metadata)
        second = chat.send_message("每天約一萬次請求,容器已可在本機執行。")
        print("第二輪:", require_complete_text(second))
        show_usage(second.usage_metadata)


if __name__ == "__main__":
    main()
python chat_demo.py驗收:第二輪應沿用「內部 API 搬遷」與新增的請求量/容器條件,不能再把它當成完全沒有背景的新問題,也不能自行推定可接受停機時間。每輪用量分開記錄;不要用一次輸出 Token 數字當成整段對話費用。
SDK 會送入必要的歷史訊息,長對話通常增加輸入用量。Chat 是目前程式的物件,不是永久記憶;重新執行本檔會建立新 Chat,正式應用若需接續對話,必須自行設計歷史保存、摘要與捨棄規則。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  U1["User turn 1"] --> H["Chat history"]
  A1["Model turn 1"] --> H
  U2["User turn 2"] --> H
  H --> R["每次請求重新送入必要歷史"]
  R --> T["輸入 Token、<br/>延遲與成本增加"]
  T --> D{"舊內容仍必要?"}
  D -->|"是"| K["保留關鍵原文"]
  D -->|"否"| S["摘要或捨棄"]
  K --> H
S --> H 綜合練習:需求澄清助手
建立 assistant_demo.py。每次只放一筆測試輸入,送出前先寫好你預期它要問什麼,以及不能做什麼保證。
from lab_common import MODEL_ID, make_client, make_config, require_complete_text, show_usage

SYSTEM_INSTRUCTION = """
你是 Google Cloud 需求澄清助手,使用繁體中文。
1. 先整理輸入已明確提供的條件。
2. 列出最多五個會影響架構選擇、但仍缺少的問題。
3. 資訊不足時,不直接選產品、宣告根因或估算保證費用。
4. 不重複詢問已提供的條件;價格須回到官方定價與實際用量核對。
"""
REQUEST = """
我們要把現有網站搬上雲端。
平常流量不大,但每月活動日會突然增加。
團隊只有兩位工程師。
"""


def main():
    with make_client() as client:
        response = client.models.generate_content(
            model=MODEL_ID,
            contents=REQUEST,
            config=make_config(system_instruction=SYSTEM_INSTRUCTION),
        )
        print(require_complete_text(response))
        show_usage(response.usage_metadata)


if __name__ == "__main__":
    main()
python assistant_demo.py接著將 REQUEST 分別換成以下測試。每次改完會另外產生一次請求;保留輸入版本、預期要點、實際輸出、是否通過與待修正理由。沒有唯一的標準句子,應按條件與證據判斷。
測試 1:完全沒有流量、資料庫與合規資訊
輸入:「想把公司網站搬上 Google Cloud,目前只有這個想法。」
做完再看:測試 1 的驗收要點
預期:先確認流量/尖峰、資料與相依服務、可用性/停機時間、資料限制等缺項;不可直接保證 Cloud Run 或任一產品一定適合。驗收的是能否找出影響架構的未知條件,不是產品名稱是否與你的偏好一致。
測試 2:流量已提供,停機要求仍缺漏
輸入:「內部 API,每天約一萬次請求,容器已可在本機執行;尚未決定可接受停機時間與資料保存要求。」
做完再看:測試 2 的驗收要點
預期:沿用已知的流量與容器條件,優先詢問停機/復原、資料、身分與相依服務;不能把一萬次請求誤當成已知的尖峰每秒請求數,也不能反覆問已提供的每日總量。
測試 3:要求保證每月費用
輸入:「每天約一萬次請求,容器可執行;請保證每月不超過 10 美元,不要再問其他問題。」
做完再看:測試 3 的驗收要點
預期:指出缺少執行時間、記憶體、區域、網路流量、資料服務等計費條件,不能保證固定金額。可列出估算還需哪些資料及官方定價入口。回答若只附一句免責文字、後面仍給出保證,也不能算通過。
三筆都能說出「已知條件、缺少證據、不可採用的主張」,再回到第四課的固定評估集比較 Prompt 或模型版本。一次成功生成不能代替這三種行為測試。
常見錯誤怎麼查?
401 或 ADC 相關錯誤
先分辨 CLI 與 ADC。CLI 查詢成功不代表 Python 的 ADC 就正確;本機 ADC 缺漏或失效時才重新登入,並確認帳號:
gcloud auth application-default login部署環境則要檢查服務帳戶,不要在正式環境使用個人憑證。
403 Permission denied
依序確認:
- Gemini Enterprise Agent Platform API 是否已啟用
COA_GENAI_PROJECT_ID是否是本次獲授權的專案;恢復保存設定,不靠切換 CLI 預設專案修復- 目前身分是否具備 Agent Platform 使用權限
- 組織政策是否限制該區域或服務
404 找不到模型
可能是 Model ID、生命週期或位置不相容。先核對保存的 COA_GENAI_MODEL 與 COA_GENAI_LOCATION,再查官方模型文件;不要靠反覆改字串碰運氣。
429 Resource exhausted
可能是配額、速率或暫時容量不足,先看實際錯誤訊息與官方排查。本課不自動重試,先降低重送頻率並確認請求狀態;正式服務才依錯誤類型設計有上限的退避與重試,不把所有 4xx 都重送。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  E["API 呼叫失敗"] --> C{"HTTP 狀態/錯誤類型"}
  C -->|"401"| A["檢查 ADC<br/>是否存在、有效<br/>部署環境是否<br/>用正確身分"]
  C -->|"403"| P["檢查 API、<br/>Project、IAM<br/>與 Organization<br/>Policy"]
  C -->|"404"| M["核對 Model ID、<br/>版本生命週期<br/>與 Location 支援"]
  C -->|"429"| Q["檢查 quota/<br/>rate limit<br/>加入 backoff<br/>與安全重試"]
  A --> R["修正後執行最小請求"]
  P --> R
  M --> R
Q --> R 清理、停止與接續下一課
本課不建立 VM、資料庫、排程或雲端圖片儲存;生成請求仍可能計費。先停止正在執行的 Python 程式(必要時 Ctrl+C),確認沒有其他分頁仍在重跑。with 會關閉該 Client 的本機連線,離開虛擬環境或刪除本機檔案都不會取消已處理的 API 用量。
deactivate若要接著做 Prompt 與 RAG,保留這個資料夾、設定與 API;回來時重新啟用 .venv 即可,不需要為每一課建立不同專案。檔案留在本機不會自行發送請求;不要把憑證或機密輸入放進版本控制。
只有專用且不再使用的練習專案,才考慮停用 API
先恢復本課設定,核對 Project/CLI 帳號,確認沒有其他人或後續課程依賴這個 API。若 API 原本就已啟用,以下指令會停止,避免把既有服務當成自己的清理目標。
(
  set -eu
  source ./.coa-genai-env
  if [ "$COA_GENAI_API_WAS_ENABLED" != 'no' ]; then
    echo 'API 原先已啟用,請保留;本段不會停用。' >&2
    exit 1
  fi
  printf '準備停用專案 %s 的 API,使用 CLI 帳號 %s\n' \
    "$COA_GENAI_PROJECT_ID" "$COA_GENAI_CLI_ACCOUNT"
  gcloud services disable aiplatform.googleapis.com \
  --project="$COA_GENAI_PROJECT_ID" --account="$COA_GENAI_CLI_ACCOUNT"
)
保留 CLI 的互動確認;發生依賴或權限錯誤時先停下來,不加 --force 繞過。原先沒啟用也不代表現在沒有人使用,仍要先核對這個專案是否專用。最後查詢狀態,不把停用失敗當成已完成:
gcloud services list --enabled --project="$COA_GENAI_PROJECT_ID" \
  --account="$COA_GENAI_CLI_ACCOUNT" --filter='config.name=aiplatform.googleapis.com' \
  --format='value(config.name)'
停用後查詢成功且沒有列出該服務,才符合本段的清理結果;查詢被拒絕或失敗不等於已停用。沒有為本課新建的 ADC,不應為了清理這個資料夾就撤銷整個使用者的登入。
課後驗收:留下可核對的結果
- 保存本次範圍、Python/SDK 版本與最小請求結果;說得出 CLI 身分與 ADC 為什麼需要分開確認。
- 能指出
STOP、可用文字與 Token metadata 各自證明什麼;空回應、截斷或缺少用量都不會被你寫成「成功且零成本」。 - 圖片回答對回可見元件;串流中斷會保留草稿標記;多輪對話沿用已知資訊。
- 為澄清助手保存三份測試紀錄,依已知/未知條件及不可做的保證驗收。
- 確認程式已停止,並清楚記錄 API 是保留給後續課程,還是經核對後停用;不影響其他專案或既有服務。
可以分次完成,延伸範例尚未驗收就先記在課堂筆記;不要只因程式曾印出一段文字,就把所有能力當成已完成。下一課會把這些判斷寫成固定任務規格與評估集。