
這課怎麼做?
這是本站原創的 CloudMart 合成演練,不是 Google 官方案例或唯一標準答案。先下載工作紙,寫下第一輪初稿,再用六張證據卡修訂決策,最後交付四份成果。若還不熟悉需求、遷移與 ADR,可先讀八步示範。
| 回合 | 要留下的結果 | 參考時間 |
|---|---|---|
| 第一輪 | 事實、未知、候選與初稿假設 | 20 分鐘 |
| 證據回合 | 六張卡的計算、拒絕或修訂理由 | 40 分鐘 |
| 修訂交付 | 矩陣、方案比較、ADR、遷移/驗證計畫 | 35 分鐘 |
| 交叉評審 | 找出仍無證據或未核准的條件 | 25 分鐘 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
可分兩次完成;前置補讀與真正部署演練另計。這一課只做文件與資料判讀,不需雲端帳號,不會代你建立資源、切換資料庫或核准上線。若需求分析、SLO 或 DR 還不熟,先回需求分析、可觀測性與 SRE或高可用與災難復原補強。
先準備一份可以修訂的工作紙
下載 CloudMart 工作紙(Markdown)
,用自己的編輯器填寫。工作紙帶有本輪事實、目標、全部證據與四份空白交付區,不含下方的參考判讀;先保留初稿,再新增修訂理由。
也可在架構師設計工作坊自行建立一份草稿,或寫在自己的文件裡。下載與閱讀不會替你新增、匯入或覆寫既有工作坊答案;本站課程筆記適合記錄待查事項,四份交付物請自行保存。
工作坊要交付的不是一張漂亮架構圖
這次練習要產出四樣東西:
- 可驗證的 requirement/constraint matrix。
- 至少兩個候選方案與 trade-off。
- 一份寫清楚理由、假設和後果的 ADR。
- Migration 與 production validation plan。
考試不會要求你真的提交這些文件,但這套思路能幫你看出選項少說了什麼。Architecture diagram 只能顯示元件,無法代替一致性、failure、security 和 operation semantics。
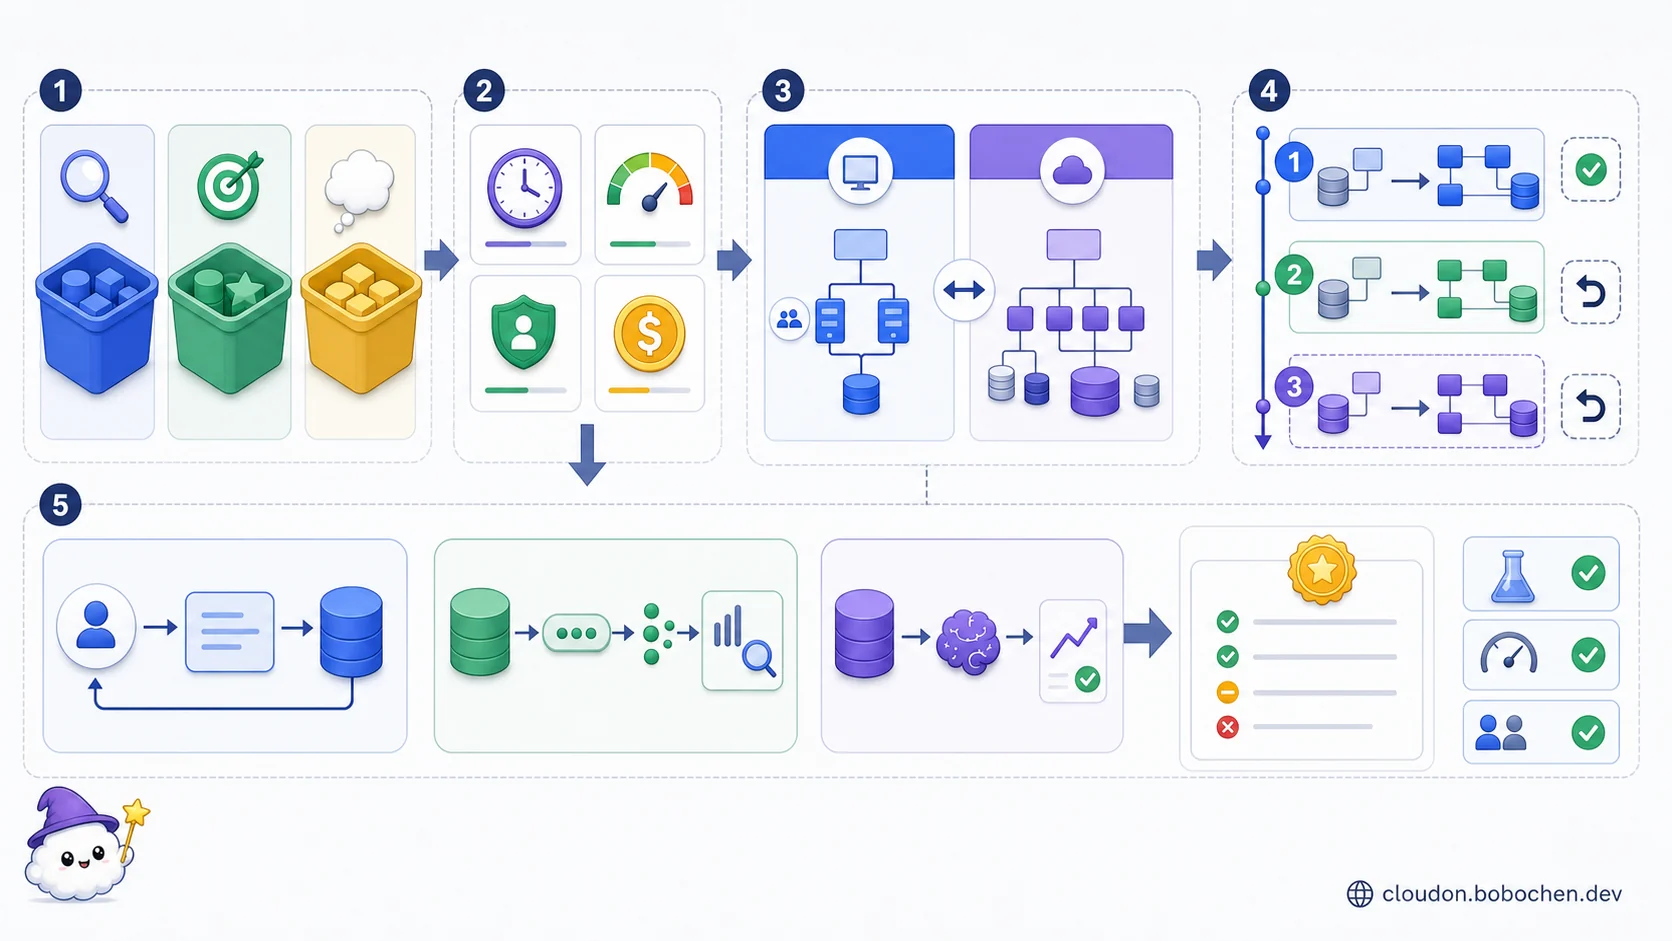
圖解:先分開事實、目標與假設,建立可測試條件,再比較現在能落地與未來可擴展的方案;遷移分階段且可回退,資料與 AI 路徑則各自用驗證結果支撐 ADR。
模擬案例:CloudMart
CloudMart 是總部位於台灣的 online retailer,目前服務台灣與部分東南亞客戶,計畫在 18 個月內進入更多亞太市場,之後評估歐洲。
現況
- Java monolith 跑在地端 VMware,部分 HTTP service 已能 containerize。
- 單一 MySQL 8.0,約 2 TB,order、inventory 和 catalog 共用 schema。
- Product image 放在 NAS,分析資料每天夜間 ETL。
- 每月人工發布一次,回滾需由 DBA 與 application team 協調。
- 團隊熟悉 Java、SQL 和 Docker,只有少數人維護過 Kubernetes。
- 促銷尖峰約為平日 10 倍,最近一次因 database connection 耗盡而停止結帳。
管理層提出的目標
- 台灣與東南亞使用者「都要很快」。
- 促銷期間不能再停止結帳。
- Inventory 不可超賣。
- 半年後開始提供個人化推薦。
- 未來進入歐洲時要符合 privacy 與 data-residency 要求。
- 不希望一次重寫整套系統,也不能中斷現有營運。
注意,這些句子還不能直接選服務。「很快」沒有 percentile;「不可超賣」沒說 reservation workflow;歐洲的實際資料落地義務也尚未由 legal 確認。
第一輪:先寫初稿,保留未知
先不採用後面的範例 ADR。用上面的案例寫至少六列需求/限制,將每列標為「事實、目標、假設、未知」,並列出負責人與取得證據的方法。管理層說「很快」時,不能自行填入已核准的數值。
接著提出至少兩個 Phase 1 候選,列出相容性、容量、資料一致性、失敗處理、團隊與成本的待驗證條件。先將 ADR 狀態設為 Proposed/待驗證,寫下目前傾向與何時會改變決策。
保存這份初稿,再看八步示範或直接進證據回合。先寫出的答案可以不完整;要保留的是未知與推翻條件,不是堅持第一次選的產品。
第一步:把事實、目標、假設分開
| 類型 | 本案例內容 | 下一個動作 |
|---|---|---|
| Fact | MySQL 2 TB、monolith、10 倍尖峰、團隊 K8s 經驗少 | 可量測與盤點 |
| Outcome | 不停止結帳、不超賣、改善 recommendation | 定義 KPI/SLI |
| Constraint | 不能一次重寫、不能中斷營運 | 規劃 migration wave |
| Unknown | 「很快」、歐洲 residency、可接受 RPO/RTO | 找 owner 確認 |
| Assumption | 新 service 可先以 API 包住 monolith | 用 spike/PoC 驗證 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
考試題通常會把 unknown 補成明確條件。在真實工作中,架構師不能擅自把它們變成需求。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TD
  A["案例中的一句陳述"] --> B{"它是哪一類?"}
  B -->|"Fact"| F["量測、盤點<br/>建立 current baseline"]
  B -->|"Outcome"| O["定義 KPI/SLI<br/>與 business owner"]
  B -->|"Constraint"| C["成為方案篩選條件<br/>不能被最佳化掉"]
  B -->|"Unknown"| U["找 owner 確認<br/>不擅自補答案"]
  B -->|"Assumption"| P["設 spike/PoC<br/>定義失敗條件"]
  F --> R["Requirement/constraint matrix"]
  O --> R
  C --> R
  U --> R
  P --> R
R --> V["每一列都有範圍、數值<br/>owner 與驗證方式"] 先問這些問題
- 哪個 user journey 最重要:browse、add to cart、checkout 還是 order tracking?
- Latency 是 client-observed 還是 server-side,在哪個 region、哪個 percentile?
- Inventory 是看到的數量不能過時,還是確認訂單時不能超賣?Reservation 可保留多久?
- Payment 已成功但 order commit timeout 時,如何 reconciliation?
- 可接受多少 downtime 和 data loss?各流程是否不同?
- 哪些資料屬於個資?Legal 要求是儲存地、處理地,還是跨境 transfer control?
- Peak traffic 的 request mix、duration、payload 與 database write ratio 是多少?
- VMware lease、license、network bandwidth 和 migration deadline 有沒有硬限制?
第二步:把需求寫成可測試條件
假設 stakeholder 確認後,得到以下 initial target:
| Journey/能力 | Initial target | 驗證方式 |
|---|---|---|
| Checkout availability | 30 天成功率 SLO 99.95%,排除明確 user input error;5xx/未確認逾時仍計入失敗 | Synthetic checkout + production SLI |
| Checkout latency | 台灣/新加坡使用者在 peak load 下 p95 < 800 ms | Region-based load test + RUM |
| Inventory integrity | Confirmed order 不得讓 on-hand quantity 低於 0 | Concurrent reservation test + invariant query |
| Region outage | Checkout 與本輪付款/庫存對帳於 60 分鐘內恢復,資料點落後 ≤ 5 分鐘 | DR game day |
| Release | Canary 失敗不影響超過 5% production traffic | Progressive delivery test |
| Recommendation | 比現行熱門商品 baseline 提升指定 offline/online KPI | Holdout experiment |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
這些數字只是本工作坊假設,不是通用建議。真正價值是每個目標都有 measurement。
第三步:不要把 target architecture 當第一個 migration step
CloudMart 需要兩條時間線:先移除 data-center/capacity risk,再逐步調整 application boundary。
Phase 0:盤點與建立 baseline
- 用 dependency discovery、traffic capture、query analysis 和 cost model 了解現況。
- 先補 application/database telemetry,量 peak、connection、slow query、failure 和 batch window。
- 建立 landing zone、identity、network、logging、budget 和 policy guardrail。
- 驗證 migration throughput、database compatibility、rollback 與 cutover window。
Phase 1:先搬可搬的,不承諾全面微服務化
若 monolith 能以 container 執行,候選 compute 包括:
- Cloud Run:適合 HTTP-driven、stateless、能配合 request/instance lifecycle 的 workload,團隊 operation 負擔較低。
- GKE Autopilot/Standard:明確需要 Kubernetes API、特定排程/叢集網路或 workload control 時再評估,並分別核對兩種模式的限制。
- Compute Engine MIG:若 application 對 VM、OS、filesystem 或 legacy agent 有相依,可能是期限內風險較低的 rehost step。
不能只因「核心交易很重要」就選 GKE,也不能只因「Cloud Run 是 serverless」就忽略 long-running process、local state、connection 和 scaling behavior。先用 application assessment 排除不相容項。
Phase 2:逐步建立 service boundary
從變更頻率高、domain boundary 清楚且能獨立驗證的能力開始,例如 product catalog read 或 notification。用 facade/routing 將新 request 導向新 service,其餘仍回 monolith。
Order 與 inventory 共用 transaction,通常不是第一個隨意拆開的地方。拆分前要先定義 reservation、idempotency、event ordering、outbox 和 reconciliation,否則只是把 database transaction 變成 distributed inconsistency。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  P0["Phase 0<br/>dependency、traffic、query、cost baseline"] --> G["Landing zone<br/>identity、network、logging、policy"]
  G --> C["Compatibility、throughput<br/>cutover/rollback PoC"]
  C --> D{"候選 workload<br/>可安全遷移?"}
  D -->|"否"| R["保留現況或 rehost<br/>修正 blocker"]
  R --> C
  D -->|"是"| P1["Phase 1<br/>搬移 monolith/可搬 workload"]
  P1 --> V["Production-like load<br/>journey 與 failure validation"]
  V --> P2["Phase 2<br/>facade/routing 漸進抽離"]
  P2 --> B{"Domain boundary 與<br/>transaction semantics<br/>清楚?"}
  B -->|"否"| P1
B -->|"是"| S["獨立 service<br/>canary、reconciliation、rollback"] 第四步:資料庫要比較「現在能搬」與「未來要擴」
候選 A:Cloud SQL for MySQL
優點是 engine compatibility 較高,能縮短 migration;可先建立 regional HA、PITR/backup、connection management 和 cross-region DR plan。限制是單一 primary 的 write scale 與 cross-region asynchronous replication,無法直接滿足任何想像中的全球 multi-writer requirement。
候選 B:Spanner
Spanner 適合需要水平擴展 relational transaction、strong consistency 與符合其 configuration 的跨區可用需求。不過它不是 MySQL 的 drop-in replacement:schema、key、query、transaction 和 application access pattern 都需要評估,migration 成本可能高。
本階段的決策
根據「不能一次重寫」與 2 TB MySQL 現況,Phase 1 先以 Cloud SQL 作為低變更 migration candidate,完成 compatibility/performance/cutover PoC。這不是宣告永遠使用 Cloud SQL。
同時把 order/inventory access pattern 收集起來。若未來確認多區 write、scale 與 consistency 真的超出 Cloud SQL 能力,再為該 bounded context 評估 Spanner,並把 application rewrite、dual-run validation 和 data reconciliation 列入成本。
Inventory 不超賣可以先靠單一 authoritative transaction、reservation table、idempotency key 和正確 locking/optimistic concurrency 解決,不需要因一句「全球庫存」立即更換所有 database。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  A["現況:2 TB MySQL<br/>monolith 共用 schema"] --> B{"現在能承擔 schema<br/>與 application rewrite?"}
  B -->|"否"| C["Phase 1:Cloud SQL candidate<br/>compatibility/load/cutover PoC"]
  B -->|"是"| D{"已核准 horizontal scale、<br/>跨區 write 與 consistency requirement?"}
  D -->|"否"| C
  D -->|"是"| S["Spanner assessment<br/>key、query、transaction、topology"]
  C --> V["HA、PITR、connection<br/>cross-region DR 驗證"]
  V --> T{"Review trigger 出現?<br/>scale 或 observed RTO/RPO 不達標"}
  T -->|"否"| K["維持並持續量測"]
  T -->|"是"| S
  S --> X["Migration/dual-run<br/>reconciliation 與成本驗證"]
  X --> Y{"收益足以承擔改造?"}
  Y -->|"否"| K
Y -->|"是"| Z["只遷移需要該能力的<br/>bounded context"] 第五步:讀取路徑與寫入路徑分開設計
- Product image 遷到 Cloud Storage,依 cacheability 搭配 external Application Load Balancer/Cloud CDN;personalized response 不進 shared cache。
- Catalog read 可用 cache 降低 database load,但 inventory confirmation 仍回 authoritative service。
- Public API 經 load balancer、Cloud Armor 與適合的 identity control;backend 不開 bypass path。
- Cloud Interconnect 或 HA VPN 的選擇以 migration traffic、availability、lead time 和 cost 為依據,並建立 redundant path/route test。
- Global frontend 能降低 edge latency,不代表 regional database write 也會變成 local latency;用 latency budget 找真正 critical path。
第六步:分析管線不能靠 application dual write
Order transaction 同時寫 operational database 和 BigQuery,任一步失敗就會不一致。較安全的方向是:
- Order 先在 authoritative transaction commit。
- 以 outbox、CDC 或支援的 integration 產生可重放 event。
- Pub/Sub 解耦 consumers,consumer 做 idempotency/deduplication。
- Dataflow 或其他 processing 將資料整理後寫入 BigQuery。
- 設 data quality、late event、schema evolution 和 reconciliation 指標。
BigQuery 是 analytics system,不拿來做即時扣庫存。Recommendation feature 也不直接讀 raw production tables,先建立有 consent、lineage、feature freshness 和 access control 的 training/serving data flow。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
sequenceDiagram
  autonumber
  participant A as Order service
  participant D as Operational DB
  participant O as Outbox/CDC
  participant P as Pub/Sub
  participant F as Processing
  participant B as BigQuery
  A->>D: 同一 transaction 寫 order 與 outbox record
  D-->>A: Commit authoritative state
  O->>D: 讀取 committed change
  D-->>O: 可重放 event
  O->>P: Publish event
  P->>F: At-least-once delivery
  F->>F: Idempotency、schema、late-event handling
  F->>B: 寫入 analytics table
  B-->>F: Load result
  F->>D: Reconciliation 只回報差異,不雙寫 order
第七步:AI 專案先做 baseline 與 evaluation
「個人化推薦」可以是 rule-based、prebuilt search/recommendation capability、BigQuery ML,或 Gemini Enterprise Agent Platform(簡稱 Agent Platform,原 Vertex AI)上的 custom model。選擇前確認:
- 目前有沒有足夠的 view、click、cart、purchase 和 product metadata?
- 要最佳化 click-through、conversion、revenue,還是 customer satisfaction?
- Cold-start、新商品、季節性和 bias 怎麼處理?
- Online inference latency/availability 是否在 checkout critical path?
- Personalization 是否取得適當 consent,使用者能否 opt out?
先以熱門商品或簡單 ranking 做 baseline,再進 offline evaluation、shadow/A/B test。Agent Platform Pipelines(原 Vertex AI Pipelines)可編排 training workflow,Model Registry 管理 model version,endpoint/batch prediction 則依 serving need 選擇。Model Garden 是尋找 model 的入口,不是所有 custom TensorFlow workflow 的 version registry。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  K["定義 business KPI<br/>conversion/revenue/satisfaction"] --> B["熱門商品或簡單 ranking<br/>建立 baseline"]
  B --> D["準備有 consent、lineage<br/>freshness 的資料"]
  D --> M["訓練/選擇 candidate"]
  M --> O{"Offline quality、<br/>bias<br/>與 safety 達標?"}
  O -->|"否"| D
  O -->|"是"| S["Shadow/小流量 canary<br/>驗證 latency 與 availability"]
  S --> A["A/B 或 holdout experiment"]
  A --> G{"Online KPI 顯著改善<br/>且 guardrail 正常?"}
  G -->|"否"| R["Rollback/保留 baseline<br/>記錄失敗原因"]
  R --> D
G -->|"是"| P["逐步 rollout<br/>監控 drift、品質與成本"] 第八步:可靠性、安全與成本放進同一份決策
Reliability
- Checkout、database、payment 與 queue 分別定義 SLO/failure behavior。
- Autoscaling 設 maximum 與 downstream connection budget,促銷前跑 peak/soak test。
- Cloud SQL HA 處理 zone failure;region DR 用 replica/backup、runbook 和 game day 驗證 observed RTO/RPO。
- Release 用 immutable artifact、canary、synthetic checkout 和 database-compatible rollback。
Security/privacy
- Human 與 workload identity 分開,使用 least privilege 和短效 credential。
- 個資先分類;log、analytics 和 AI dataset 各有 purpose、retention 與 access policy。
- CMEK 只有在 control/regulation 需要時使用,並設 key availability、rotation 和 recovery。
- VPC Service Controls 適用於支援服務的 data exfiltration defense,不會取代 IAM、application authorization 或 internet egress control。
- 歐洲資料設計等 legal 釐清後再定案,不自行把 GDPR 解讀為所有資料必須留在歐洲。
Cost
- 用 billing export 把成本分到 environment/service/journey,並計算每筆成功訂單成本。
- 比較 migration、parallel run、egress、support、license 和 training,不只看 compute list price。
- CUD 只套在已觀察到的穩定 baseline;promo burst 保留彈性 capacity。
範例 ADR:Phase 1 database
**評審前草案:**這是第一輪候選,不是已通過證據回合的決策。
Status: Proposed — 待相容性、容量、DR 與切換/回復證據核對。
Decision: Phase 1 將 MySQL workload 遷到 Cloud SQL for MySQL,暫不直接改為 Spanner。

Context:
- 2 TB MySQL 與 monolith 共用 schema。
- 18 個月內要擴張,但目前沒有已核准的全球 multi-writer requirement。
- 團隊不能承擔一次 application/database rewrite。

Alternatives:
- Cloud SQL: compatibility 較高,write-scale 與跨區 DR 有限制。
- Spanner: 長期 scale/consistency 能力較強,需 schema 與 application 改造。
- Self-managed MySQL on Compute Engine: control 高,operation burden 也高。

Consequences:
- 先完成 compatibility、load、DMS/cutover 和 rollback PoC。
- 設 regional HA、backup/PITR、cross-region DR 與 restore test。
- 收集 order/inventory access pattern,於 expansion gate 重新評估 Spanner。

Review trigger:
- Sustained write/storage growth超過已驗證容量。
- 核准跨區 write 與 consistency requirement。
- Observed RTO/RPO 無法滿足業務目標。
好的 ADR 不假裝選擇沒有缺點,也會寫明何時重新評估。這份是收到後面 E1–E6 之前的候選草案;讀完新證據,必須修訂狀態、未通過條件與後續驗證,不能原封不動當成已核准答案。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  C["Context<br/>事實、目標、constraints"] --> A["Alternatives<br/>至少兩個可行候選"]
  A --> T["Trade-off<br/>能力、風險、成本、operation"]
  T --> D["Decision<br/>理由與 assumptions"]
  D --> Q["Consequences<br/>接受的限制與後續工作"]
  Q --> V["Validation plan<br/>PoC、load、cutover、rollback"]
  V --> E{"Evidence 支持決策?"}
  E -->|"否"| A
  E -->|"是"| M["Monitor review triggers<br/>scale、requirement、<br/>RTO/RPO"]
  M -->|"trigger 出現"| C
M -->|"未出現"| K["維持決策並持續記錄"] 第二輪:用證據修訂決策
CloudMart、所有量測值、事件與目標都是本站編寫的合成演練,不是 Google 官方案例、產品效能、SLA 或真實部署紀錄。本練習不需要雲端帳號,也不執行切換或建立資源。本輪資料與目標
以下是評審回合提供的補充條件;已核准目標與未知要分開記錄。E1、E2、E4 的時間窗各自獨立;不能把不同批次混成一份 production 成績。
案例事實
- 台灣電商,服務台灣與部分東南亞客戶,18 個月內規劃擴張亞太市場。
- 地端 VMware 上的 Java 單體、2 TB MySQL 8.0;訂單、庫存與商品共用 schema。
- 團隊熟悉 Java、SQL、Docker,Kubernetes 經驗有限;不能一次重寫整套應用。
- 促銷尖峰約為平日十倍;曾因資料庫連線耗盡停止結帳。
- 下列證據是不同測試或決策回合,E1 與 E2 不是同一批流量,不能合併分母。
本輪已核准的演練目標
- 成功率:30 天有效邏輯結帳的 99.95%。以 checkout_id 去重,明確使用者輸入錯誤才排除;5xx 與尚未確認結果的逾時仍納入失敗。
- 延遲:尖峰時台灣與新加坡各自的端到端結帳 p95 都小於 800 ms。E2 使用 nearest-rank:將 n 筆排序,取第 ceil(0.95 × n) 筆。
- 資料完整性:確認訂單不得讓權威庫存低於零;付款、訂單與庫存結果需可對帳。
- 區域災害:故障後 60 分鐘內恢復新單,且完成本輪定義的未決付款/庫存對帳;可復原資料點落後故障時刻不超過 5 分鐘。
- 上述是本次假設業務負責人已核准的演練條件。資料落地、法規適用、變更窗口與新市場細部延遲仍須另行確認,不能推定已核准。
E1:成功率的分母與驗證視窗
一小時合成負載測試;每列互斥且已依 checkout_id 去重,所有結果均在本輪觀察期限結束後分類。
| 結果 | 邏輯結帳數 | 是否納入有效事件 |
|---|---|---|
| 成功完成 | 97,880 | 納入成功 |
| 服務 5xx | 70 | 納入失敗 |
| 逾時且結果尚未確認 | 50 | 納入失敗,另需付款/訂單對帳 |
| 明確使用者輸入錯誤 | 2,000 | 依已核准規則排除 |
先留下判斷:算出有效事件、成功率與同樣本量下的錯誤預算。能否由這一小時宣告達成 30 天 SLO?ADR 的上線條件要改什麼?
記錄「計算或證據 → 哪個主張不能成立 → 修訂哪份交付物 → 下一個驗證與負責人」,再展開參考。保留原初稿與修訂理由。
做完再看:E1 的參考判讀
- 有效事件為 98,000;成功率為 99.878%。同樣本量、99.95% 門檻的錯誤預算是 49 筆,實際失敗 120 筆,超出 71 筆。
- 不能刪掉 5xx 或逾時來美化分母,也不能把 HTTP 重試當成新的邏輯結帳重複計數。這批測試未達相同門檻,且不能代替 30 天 production SLI。
- 應在 ADR 留下未通過的證據、排查及重測條件;沒有獲准的例外就先保留發布閘門,而非以架構圖宣告可靠性已達標。
E2:總體 p95 掩蓋小區域
另一輪尖峰負載的 10,000 筆完整結帳觀測;每筆有效事件各觀測一次且本輪全部完成。表格以相同延遲分組,不能把兩地的 p95 直接平均。
| 使用者位置 | 筆數 | 每筆端到端延遲 |
|---|---|---|
| 台灣 | 8,900 | 650 ms |
| 台灣 | 100 | 900 ms |
| 新加坡 | 900 | 500 ms |
| 新加坡 | 100 | 1,200 ms |
先留下判斷:依 nearest-rank 算出台灣、新加坡與合併 p95。若只展示合併值,能否證明兩地都滿足 < 800 ms?接下來應量哪一段?
記錄「計算或證據 → 哪個主張不能成立 → 修訂哪份交付物 → 下一個驗證與負責人」,再展開參考。保留原初稿與修訂理由。
做完再看:E2 的參考判讀
- 台灣 p95 = 650 ms;新加坡 p95 = 1200 ms;合併 p95 = 650 ms。新加坡未達標,即使合併值小於 800 ms。
- 分母分別為 9,000、1,000 與 10,000,排序後取第 8,550、950 與 9,500 筆。不是平均兩個 percentile,也不是讓較大的台灣樣本抵銷新加坡。
- 先拆使用者網路、入口、應用、資料庫與付款的 latency budget,再驗證瓶頸。加 global frontend 或換資料庫都不能取代同地點、同負載下的重測。
E3:擴容前先算下游連線預算
以下上限是這次容量評估的合成配置,不是任何 Cloud SQL 規格的通用值;每個應用 instance 的所有 worker 合計最多 25 個連線。
| 配置/預算 | 數值 |
|---|---|
| 資料庫本輪核准連線預算 | 300 |
| 保留給管理、遷移及其他工作 | 80 |
| 每 instance 的應用 pool 上界 | 25 |
| 原方案規劃的 instance 上限 | 40 |
| 待評估的較小 instance 上限 | 8 |
先留下判斷:原配置在 pool 都用滿時會發生什麼?改成 8 個 instance 是否就能宣告促銷容量足夠?列出必要的防護與重測。
記錄「計算或證據 → 哪個主張不能成立 → 修訂哪份交付物 → 下一個驗證與負責人」,再展開參考。保留原初稿與修訂理由。
做完再看:E3 的參考判讀
- 應用可用預算為 220;原配置最多需求 1,000。8 個 instance 的算術上界為 200,雖低於預算,仍不證明吞吐、等待時間或尖峰結帳延遲合格。
- 需要 pool/timeout、流量限制或排隊、容量餘裕及尖峰/持續負載重測。也要盤點其他 revision、工作程序與重連突波,不能只計一個設定。
- Cloud Run 的 maximum instances 在特定情況可短暫超出,不能將 8 × 25 當成絕對防線。應用與資料庫端仍需連線管理和保護。
E4:服務可連線不等於業務已復原
合成的區域故障演練,時間均為同日 UTC;依本輪事前定義,RTO 結束點包含新單恢復與未決付款/庫存對帳完成。
| 事件 | UTC 時刻 |
|---|---|
| 復原資料中最後確認一致的資料點 | 09:52 |
| 主要區域故障 | 10:00 |
| 次要區域資料庫可寫 | 10:22 |
| 應用路由切換完成 | 10:29 |
| 新結帳檢查通過 | 10:47 |
| 未決付款/庫存對帳完成 | 11:05 |
先留下判斷:分開計算新單恢復、業務 RTO 與資料點落後時間。是否通過 60 分鐘/5 分鐘目標?還缺什麼證據才能推算遺失訂單?
記錄「計算或證據 → 哪個主張不能成立 → 修訂哪份交付物 → 下一個驗證與負責人」,再展開參考。保留原初稿與修訂理由。
做完再看:E4 的參考判讀
- 新單於故障後 47 分鐘恢復;依本輪定義,業務 RTO 為 65 分鐘,超過 60 分鐘。可復原資料點落後 8 分鐘,亦超過 5 分鐘目標。
- 不能在 DB 可寫的 22 分鐘或新單恢復的 47 分鐘就宣告本輪 RTO 達標。8 分鐘也不是確定遺失的訂單筆數,仍需交易 ID、付款及庫存對帳。
- 區內 HA 與跨區 DR 是不同故障範圍;非同步副本要核對接收與套用進度、應用切換、資料完整性與回切,不能由「已設 HA」推定區域故障演練通過。
E5:開始寫新資料之後怎麼回復
這是評審提供的切換情境,不是可執行操作指令;任何正式變更仍需核准窗口與測試過的程序。
| 時點/條件 | 合成紀錄 |
|---|---|
| 切換前 | 來源停止寫入,目標已追平至核對點;來源保留唯讀 |
| 切換後 | 新目標已接受 15 筆新訂單及相關庫存異動 |
| 可用備份 | 只有切換前備份;沒有已驗證的反向同步/重播程序 |
| 候選回復步驟 | 只將 DNS 指回舊應用與舊資料庫 |
先留下判斷:可否把候選步驟寫成「一鍵回滾」?區分新目標寫入前後的回復界線,列出停止條件、對帳與核准人。
記錄「計算或證據 → 哪個主張不能成立 → 修訂哪份交付物 → 下一個驗證與負責人」,再展開參考。保留原初稿與修訂理由。
做完再看:E5 的參考判讀
- 不能只切回 DNS;舊資料庫沒有那 15 筆新訂單及庫存狀態,可能造成狀態回退、重複處理或付款不一致。切換前備份也不包含這些新寫入。
- 先保護資料與控制寫入邊界,再由已測試的反向同步/重播與對帳流程回復,或採修復前進;是否可用必須由演練證明。付款處理還需冪等與外部結果核對。
- 在遷移計畫分開寫「新目標尚未接收寫入」及「已接收寫入」兩套條件;未證實可安全回復時,ADR 應標為未就緒,交由業務與變更負責人處理風險。
E6:新需求觸發重評,不抹掉舊證據
另一個決策回合:業務核准未來兩地同時接單、同一份庫存仍不得超賣。尚未核准跨區交易延遲、故障時接受的行為或改造預算。
| 狀態 | 新增資訊 |
|---|---|
| 已核准 | 未來兩地同時寫入訂單,庫存仍需一致且不得超賣 |
| 仍未知 | 可接受跨區寫入延遲、區域失聯時是否暫停接單、改造預算 |
| 現有 ADR | 低變更 Phase 1 以 Cloud SQL 為候選,未承諾全球 multi-writer |
先留下判斷:哪些舊決策仍有依據,哪些必須重開 ADR?是否能只憑這張卡立即核准全面改用 Spanner?
記錄「計算或證據 → 哪個主張不能成立 → 修訂哪份交付物 → 下一個驗證與負責人」,再展開參考。保留原初稿與修訂理由。
做完再看:E6 的參考判讀
- 新增跨區寫入需求已觸發既有 ADR 的 review trigger,需重新比較訂單/庫存這個邊界的方案;不能把原本未要求的能力宣稱為 Phase 1 已具備。
- 不代表必須立刻搬完所有 schema,也不等於某個產品名稱已解決跨區延遲、故障行為或遷移。先補齊未知,再用交易、相容性、切換/回復與成本驗證比較候選。
- 保留舊 ADR、這次變更來源、被取代的部分與新驗證閘門。原先盤點、身分與觀測工作可能仍成立,不能因換方案就刪掉不利的 E1–E5 證據。
產品行為核對
本輪的數字是合成資料;產品能力另依第一方文件確認:
- Google SRE:實作 SLO:先固定有效事件與成功事件,再看對應視窗。
- Cloud SQL for MySQL HA與跨區副本與 DR:區內故障與區域災害的範圍不同,非同步複寫仍需核對資料與復原結果。
- 資料庫連線管理與Cloud Run maximum instances:限制設定、pool 與容量保護需要一起驗證。
- 架構決策紀錄:保留情境、候選、後果與狀態變更,讓取捨可追溯。
最後交付:四份成果都要對回證據
1:需求與證據矩陣
- 至少六列需求;標出事實、已核准目標、假設與未知
- 每列有範圍、負責人、驗證方法與 E1–E6 證據/缺口
2:兩個候選與取捨
- 分開 Phase 1 與長期目標,不以產品名稱代替限制比較
- 至少兩個候選對照容量、資料一致性、故障、團隊與成本假設
3:有狀態的 ADR
- 狀態、情境、候選、決策、後果、證據與未通過條件
- 寫出何時重評;E6 後標出保留、修訂及取代的部分
4:遷移與驗證計畫
- 切換前後各有 go/no-go、核准人、觀測點與停止條件
- 區分新寫入前後的回復;包含付款/庫存對帳及復原後回切
交付前展開:怎麼做交叉評審?
請同伴或隔天的自己只看交付物,不先看產品名稱,檢查:
- 能否從每個結論找到需求、證據 ID 或明確標記的待驗證假設?
- 是否保留 E1 的不利成功率、E2 的新加坡問題,以及 E4 未達標的兩個時間目標?
- 是否把 E3 的連線算術當成已完成容量驗證,或把 E5 的 DNS 切回當成完整資料回復?
- E6 後能否說清楚哪些決策保留、哪些重評,而非刪掉舊資料或直接宣告換產品就完成?
- 每個未達標條件是否有負責人、下一個驗證、停止/暫緩條件與核准邊界?
若上述仍說不清楚,將狀態保留為待驗證,回對應證據卡補寫。本輪驗收看的是推理與證據鏈;選到同一個產品名稱、讀完解答或下載工作紙,都不能代替這四份成果。
考試中怎麼縮短這套流程
不必在腦中畫完整 CloudMart。只做四件事:
- 找動詞:題目要你 assess、migrate、design、secure 還是 troubleshoot?
- 找硬約束:existing skill、deadline、protocol、RTO/RPO、consistency、compliance。
- 每個選項問一句:它滿足哪個約束,又新增什麼沒有被要求的負擔?
- 最後檢查:是否把未提供的假設當成事實?
若題目要求「先做什麼」,正確答案可能是 assessment,也可能是立即隔離 compromised credential。順序取決於風險與題目狀態,沒有「FIRST 永遠先規劃」這種規則。
課後檢查
先確認四份成果與 E1–E6 的修訂都已保存,再回答這幾題;答不出來,括號裡是該回去重讀的那一節。只有讀解答或尚未完成的部署驗證,請另外記在待補證據中。
- 一條 requirement 要補上哪些東西,才算可以測試?(回〈第二步:把需求寫成可測試條件〉)
- 為什麼不讓 application 同時寫 operational database 和 BigQuery?(回〈第六步:分析管線不能靠 application dual write〉)
- Phase 1 為什麼先用 Cloud SQL、暫不改 Spanner?什麼訊號出現要重新評估?(回〈範例 ADR:Phase 1 database〉)
本課重點
- Fact、outcome、constraint、unknown 和 assumption 要分開。
- Requirement 要有 owner、範圍、數值與驗證方法。
- Migration landing architecture 與長期 target architecture 可以不同。
- GKE、Cloud Run 和 Compute Engine 按 workload/team/control 選,不按重要性排序。
- Cloud SQL compatibility 較高;Spanner 能力不同但需要 migration/application 成本。
- Inventory integrity 先定義 transaction、reservation、idempotency 和 reconciliation。
- Analytics 用可重放 pipeline,不讓 application 對 operational/warehouse 雙寫。
- AI 先做 baseline、evaluation、privacy 和 fallback,再談 model platform。
- ADR 要記 alternative、consequence、validation 和 review trigger。
下一步
想拿自己的案例從頭走一遍,站內的 架構師設計工作坊 有 13 個步驟可以逐步填寫。
下一課會把這套決策方法帶進考場:先核對官方考試規格,再用原創題練習如何排除「技術上能做、但不符合題目」的選項。