
本課要完成的決策
讀完後,請能選定一個 business journey,寫下故障範圍、RTO/RPO 與最低服務水準,並用演練證據判斷「能切換」、「能恢復服務」與「資料已完整」各自成立了沒有。
先備知識是基本 compute、database 與 replication 概念。已有架構經驗的讀者,可先做後面的〈桌上演練:資料庫可寫,還能直接開站嗎?〉,再回頭補讀不確定的部分。演練約需 20 分鐘,使用本文的虛構紀錄即可,不需要雲端帳號、付費資源或真實付款。
先說清楚要防哪一種故障
「系統要高可用」還不是可以實作的需求。Instance crash、zone outage、region outage、資料誤刪、credential 洩漏、錯誤部署和上游中斷,需要的防線並不相同。
高可用(HA)通常讓服務在預期的 component 或 zone failure 下繼續運作;災難復原(DR)則處理超出主要 failure boundary 的事件,讓服務和資料回到可接受狀態。兩者會重疊,但不必硬分成「HA 一定自動、DR 一定手動」。實際切換方式要看產品能力、風險與授權流程。
先做 dependency map,列出每個 user journey 依賴的:
- Compute、database、object storage、queue 和 cache。
- DNS、load balancer、certificate、secret、KMS key 和 identity provider。
- Quota、artifact registry、CI/CD 與 control plane。
- Third-party payment、email、物流等外部服務。
只把 application 複製到第二個 region,database、secret 或 quota 還在單一 region,並不算完成 DR。
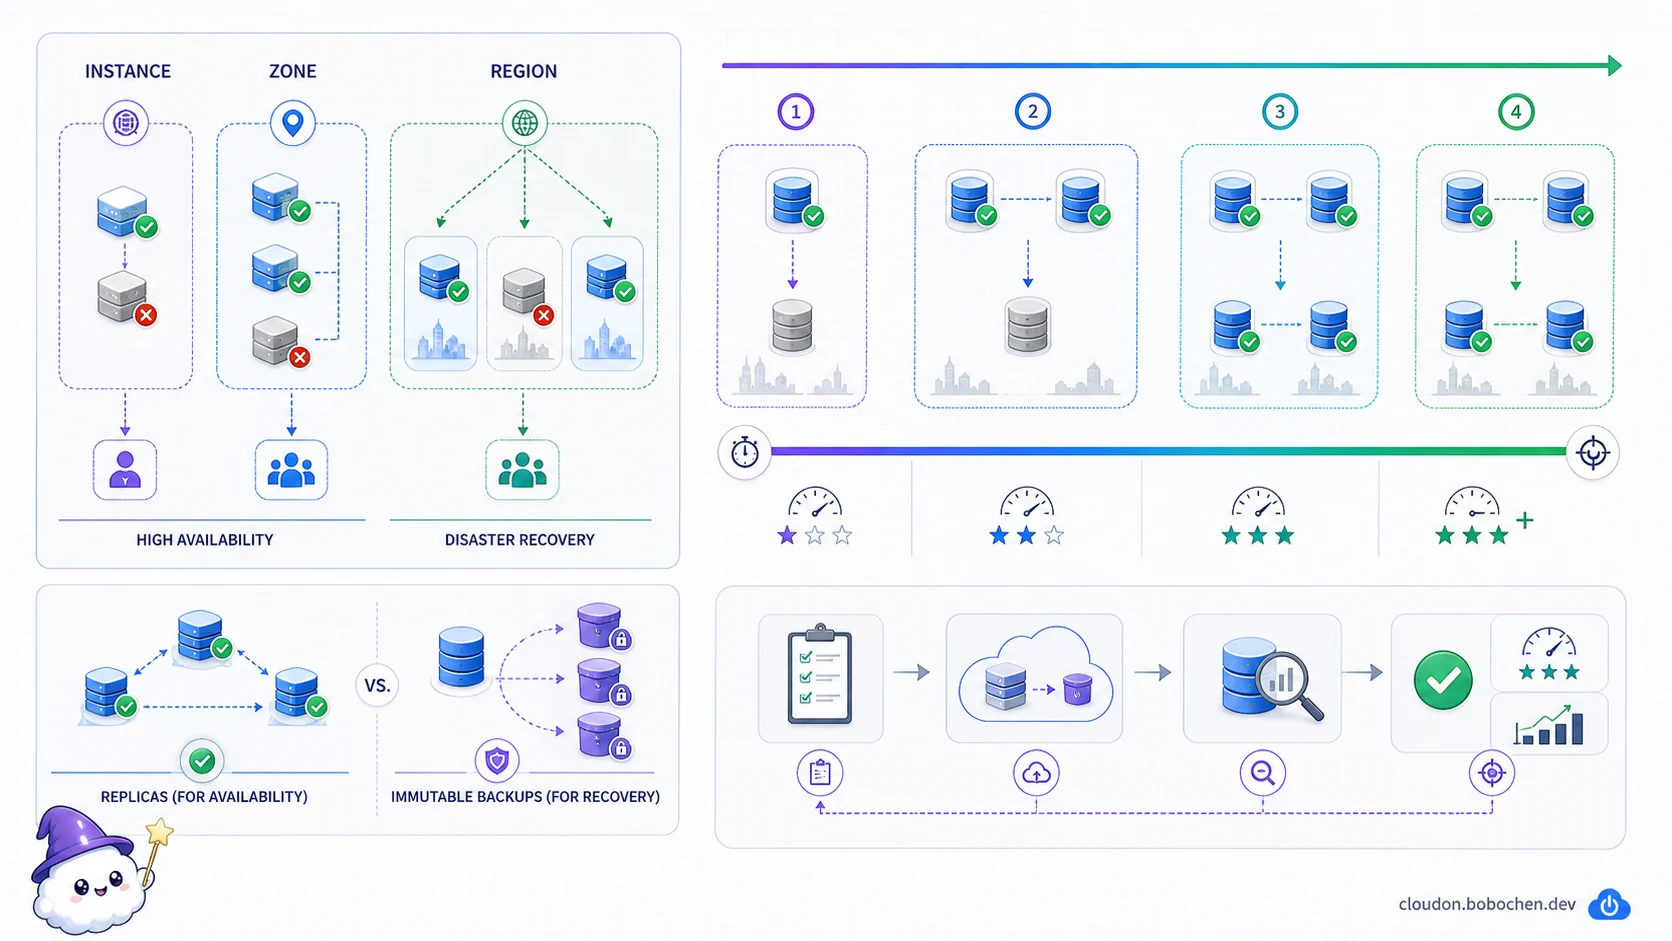
圖解:Zone 內的 HA 與跨 Region 的 DR 防的是不同故障邊界;就緒程度越高,復原通常越快但成本與複雜度也越高。Replica 支援可用性,immutable backup 才能處理誤刪或破壞後的復原。
RTO/RPO 要對一個業務流程定義
- RTO(Recovery Time Objective):中斷後,多久內必須把流程恢復到約定服務水準。
- RPO(Recovery Point Objective):恢復後,允許回到多早以前的資料狀態,也就是可容忍的資料遺失範圍。
例如「付款授權 RTO 15 分鐘、RPO 0;商品推薦 RTO 8 小時、RPO 24 小時」比「整套系統 RTO 15 分鐘」更有用。還要補上:
- Minimum service level:復原初期要能處理全部流量,還是只保留核心功能?
- Consistency requirement:可否暫時只讀、延遲寫入或事後 reconciliation?
- Maximum tolerable downtime:超過多久會造成不可接受的法規、財務或營運影響?
- Dependency objective:第三方服務的承諾是否比你的目標更寬鬆?
RPO 0 不等於題目一出現就選某個產品。要問「哪一種資料」不能遺失,以及 commit acknowledgement 的邊界在哪裡。Database transaction 可以跨區同步,尚未送出的 client request、cache、message consumer 的外部 side effect 和人工流程仍要另外處理。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart LR
  A["最後一筆可還原資料"] -->|"RPO:可容忍的資料缺口"| B(("災難發生"))
  B -->|"RTO:允許的復原時間"| C["核心流程恢復至<br/>最低服務水準"]
C --> D["完整服務恢復<br/>對帳與 failback"] Availability 數字要看產品、版本與配置
不要用「zonal 一律 99.9%、regional 一律 99.99%」推導架構。SLA 是產品與配置的承諾,不是 geography 自動附帶的數字。同樣叫 regional,Cloud SQL HA、regional GKE、Cloud Storage 和 Spanner 的 failure semantics 也不同。
正確流程是:
- 找到當期產品 SLA 與 architecture 文件。
- 確認 edition、region、replica、capacity 和 maintenance 等適用條件。
- 把所有關鍵 dependency 串起來估算 end-to-end availability。
- 用實際 failover 和 load test 驗證,而不是只看單項 SLA。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  A["讀當期產品 SLA"] --> B["核對 edition、region<br/>replica 與 maintenance"]
  B --> C["串起所有關鍵<br/>dependency"]
  C --> D["執行 failover<br/>與 load test"]
  D --> E{"觀測結果達標?"}
  E -->|"否"| F["補足 capacity、quota<br/>或架構缺口"]
  F --> B
E -->|"是"| G["寫入 SLO、runbook<br/>與監控門檻"] 多一份 replica 也不保證有 capacity 接手。平常若兩個 zone 都已接近滿載,少一個 zone 時 autoscaler 可能拿不到 quota 或剩餘節點無法承擔流量。
四種 DR 策略是規劃語彙,不是固定時程表
| 策略 | 平時狀態 | 主要取捨 |
|---|---|---|
| Backup and restore | 只保留可還原的資料與 IaC | 成本低,但 provisioning、restore 與驗證會拉長 RTO |
| Pilot light | 核心資料或少量必要元件持續運作 | 比純備份快,仍要啟動其他 dependency |
| Warm standby | 第二站保留完整但較小 capacity | 切換較快,要持續 patch、同步與測試 |
| Multi-site | 多站同時服務或隨時能承接流量 | RTO 較短,但資料一致性、routing 與成本較複雜 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
名稱本身不能保證 RTO/RPO。Warm standby 能否在 15 分鐘內恢復,要看 database promotion、capacity scale-up、traffic switch、cache warm-up 和人工核准的實測結果。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  A["journey RTO/RPO<br/>法規、風險與預算"] --> B{"需要多少平時就緒程度?"}
  B --> C["Backup and restore<br/>重建+還原"]
  B --> D["Pilot light<br/>核心元件常駐"]
  B --> E["Warm standby<br/>完整環境小容量"]
  B --> F["Multi-site<br/>多站可承載流量"]
  C --> G["Game day:量測 observed RTO/RPO"]
  D --> G
  E --> G
F --> G Compute 與流量層的 failure boundary
Compute Engine 與 GKE
Regional managed instance group 可跨 zones 分布 VM,配合 health check、autohealing 和 load balancing 處理 instance/zone failure。Autoscaling 要保留 failover headroom 和 quota,並避免 state 留在 local disk。
Regional GKE cluster 讓 control plane 跨多個 zones,node pool 也要按需要分布。Topology spread、anti-affinity 和 PodDisruptionBudget 能改善 placement 與 planned disruption,但 PDB 不會增加 capacity,也不保護 region、cluster 或 dependency failure。跨 region 需要額外 cluster、artifact/configuration distribution 和 traffic/data plan;fleet 提供跨 cluster 管理能力,不等於自動完成 failover。
Cloud Run
Cloud Run service 是 regional resource,區域內由平台處理 zone redundancy。若要防 region outage,必須在多個 regions 部署,並使用 global external Application Load Balancer 或 cross-region internal Application Load Balancer 連接 regional serverless NEGs。
僅把多個 NEG 掛到 load balancer,不一定會在 application error 時自動切換。可依當期功能使用 Cloud Run service health 建立 automated failover/failback,或設計 outlier detection/manual failover;無論哪種都要測試健康訊號、false positive、state 和 capacity。
使用 global anycast IP 時,正常切換通常不必修改 DNS。把 Cloud DNS 當成自動 application health failover 工具,常會忽略 record TTL、resolver cache 和 health-check 支援範圍。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  U["使用者"] --> IP["Global anycast IP"]
  IP --> LB["Global external<br/>Application Load Balancer"]
  S["健康訊號<br/>與切換授權"] --> LB
  LB -->|"正常流量"| TW["台灣 Region<br/>Cloud Run"]
  LB -. "failover" .-> JP["日本 Region<br/>Cloud Run"]
  TW --> DB1["主要資料路徑"]
  JP --> DB2["DR 資料路徑"]
  DB1 -. "async replication" .-> DB2
  Q["預留 capacity、quota<br/>secret 與 artifact"] --> JP
資料層:replica、backup 與 archive 用途不同
Replica 能縮短故障後的資料恢復時間,但錯誤 delete、corruption 或 compromised credential 也可能被快速複寫。Backup 保留 point-in-time recovery copy,卻不一定能立即承接流量。Archive 著重長期保存,也未必能直接 restore 成 production service。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TD
  P["Production data"] -->|"同步或非同步複寫"| R["Replica"]
  P -->|"排程備份/PITR"| B["Backup"]
  P -->|"匯出/生命週期政策"| A["Archive"]
  R --> R1["快速接手基礎設施故障"]
  B --> B1["回到誤刪或 corruption<br/>之前的時間點"]
  A --> A1["長期保存與法遵"]
  X["誤刪、corruption<br/>credential 濫用"] -. "也可能被複寫" .-> R
  B --> V["隔離 restore<br/>integrity 與 application validation"]
  V --> O["可證明的 RTO/RPO"]
資料保護至少決定:
- Backup frequency、PITR window、retention 和 storage location。
- Application-consistent 或 crash-consistent 的需求。
- Encryption key 與 restore identity 是否在災難時可用。
- 誰能建立、刪除和 restore backup,是否要 separation of duties。
- Restore 到哪個 project/region,以及 network、DNS、secret 如何重建。
- 如何驗證 row count、business invariant 和 downstream reconciliation。
Cloud SQL
Cloud SQL regional HA 在同一 region 的兩個 zones 提供 primary/standby。符合條件的故障由服務自動切換,維持相同 IP,並保護 zone failure;不要對所有 database version/edition 承諾固定切換秒數。
Region failure 需要另一層設計。Cross-region read replica 使用 asynchronous replication,因此 lag 會隨 workload 與網路狀況改變。傳統 promotion 是有意識的手動/API 操作;Cloud SQL Enterprise Plus 的 advanced DR 可指定 DR replica 並提供額外 failover/switchover 流程,但仍要確認 engine、edition 與當期限制。
切換前後要處理:
- 量測 replica lag,判斷可能遺失哪些已 commit transaction。
- 防止舊 primary 恢復後繼續接受 write,避免 split-brain。
- 確認 promoted instance 的 machine size、HA、flag、user 和 network 足以承載 production。
- 更新 client routing/connection,並排空 stale connection pool。
- 重建 replication topology,規劃 failback 與資料 reconciliation。
Spanner
Spanner regional、dual-region 與 multi-region configuration 的 replica topology、edition、latency 和 SLA 不同。Dual-region 和 multi-region 能提供跨區的 strong/external consistency 與高可用能力;目前 dual-region 文件明確說明在支援的 region outage/network partition 情境下提供 zero RPO,但仍有 quorum mode、manual failover/failback 和 application placement 等操作考量。
選 Spanner 前要確認 relational model、transaction semantics、write latency、edition、region availability 與成本合適。即使 database RPO 是 0,application 也要部署在至少兩個 failure domains,message、object 和 external side effect 仍要各自設計。
Backup and DR 與不可變備份
Backup and DR Service 可集中管理 policy、monitoring 和 recovery。透過 Google Cloud Console 建立的 backup plan 目前支援 Compute Engine VM/disk、Cloud SQL、AlloyDB 等資源;其他 database 或 VMware workload 可能走 appliance management console。GKE 不在目前 Console backup plan 的支援清單中,cluster resource 和 persistent workload 要使用適合的 Kubernetes/application backup 策略,不能因為產品名稱有 DR 就假設全部支援。
Backup vault 是 Google-managed regional resource,提供 identity isolation、immutability 和 enforced retention。依 workload 與位置,可使用 regional、cross-regional 或 multi-regional vault;支援組合不同,例如 Cloud SQL backup plan 與 vault location 有特定相容限制。
設定 enforced retention 前要同時考慮:
- 期間內即使管理者也不能提早刪除,錯誤備份和大量資料仍會產生成本。
- Lock 生效後不能縮短 minimum retention,只能增加。
- Cloud SQL transaction log 等資料未必都存放在 vault 內,要讀各 workload 限制。
- CMEK、project isolation 和 restore permission 要在演練中驗證。
Immutable 不等於已驗證可還原。定期 restore 到隔離環境、執行 integrity/malware scan 和 application validation,才知道備份能否滿足 RTO/RPO。
Failover runbook 要處理的不只「切過去」
一份可執行的 runbook 至少包含:
- Declare:誰判定 region 已不可用?需要哪些 evidence 和 approval?
- Fence:如何停止或隔離舊 primary,避免兩邊同時寫入?
- Recover data:promotion、restore 或 replay 的順序為何?接受多少 lag?
- Scale:standby 的 compute、database connection、quota 和 license 是否足夠?
- Switch traffic:使用 load balancer、service health、DNS 或 client configuration 的哪一層?
- Validate:synthetic transaction、business invariant、security 和 observability 是否正常?
- Communicate:何時對客戶、管理層與監管單位更新?
- Fail back:原區恢復後如何重新同步、切回或決定不切回?
Automation 能縮短人工作業,但錯誤的自動 failover 也可能擴大事故。先確保 signal 足夠可靠、動作 idempotent、權限最小化,而且每一步能停下來檢查。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  A(["偵測異常"]) --> B{"Declare:<br/>達到 DR 啟動門檻?"}
  B -->|"否"| C["留在 HA/<br/>incident response"]
  B -->|"是"| D
  subgraph CUTOVER["切換階段"]
    direction TB
    D["Fence<br/>舊 primary"] --> E["Recover<br/>data"]
    E --> F["Scale standby<br/>確認 quota"]
    F --> G["Switch<br/>traffic"]
    G --> H{"交易與 invariant<br/>正常?"}
    H -->|"否"| E
  end
  H -->|"是"| I
  subgraph RECOVERY["穩定與復原階段"]
    direction TB
    I["Communicate<br/>持續觀測"] --> J["重建 replication<br/>與保護拓樸"]
    J --> K{"現在要<br/>fail back?"}
    K -->|"稍後"| L(["維持新 primary"])
    K -->|"是"| M["重新同步、fence<br/>切回並再驗證"]
end 用演練取得真正的 RTO/RPO
DR 文件中的「預估 15 分鐘」不算驗證。演練要記錄:
- Detection、decision、data recovery、traffic switch 和 validation 各花多久。
- 最後一筆可驗證的 transaction 與實際資料缺口。
- Standby 在 production-like load 下的 latency、error 和 saturation。
- 哪些 IAM、quota、secret、certificate、artifact 或聯絡流程阻塞復原。
- Failback 是否安全,以及 replication topology 是否回到受保護狀態。
先在 non-production、單一 component 或少量 traffic 開始,控制 blast radius,再依風險逐步接近 production failure。演練頻率由 change rate、監管要求、criticality 和過往結果決定,不需要套用每月或每季的固定答案。重大架構、權限或 runbook 變更後,應重新測試相關路徑。
桌上演練:資料庫可寫,還能直接開站嗎?
以下是本站自訂的合成演練,時間、訂單與測試結果都不是產品效能、SLA 或真實事故紀錄。你是事故負責人,請先保留自己的判斷,再展開答案。
先固定驗收邊界
演練前,團隊已約定:
- 故障範圍與起點:10:00 台灣 region 的訂單服務中斷,該時刻開始計時,所有時鐘已同步。
- RTO 30 分鐘:公開下單在約定負載下恢復;新單可完成,未決舊單有可追蹤的隔離/對帳流程,且重送不會觸發未確認的再次扣款。單一 HTTP 200 或 database 可寫都不是結束點。
- 訂單資料 RPO 2 分鐘:10:00 時已確認 commit 的訂單,09:58 以前的資料不得缺漏。付款結果另外與 provider 對帳,不從訂單狀態直接推定已付款或未付款。
- 風險例外:未滿足資料目標時,on-call 只能提出證據與降級方案;必須由事故負責人與業務 owner 明確核准,才可在指定限制下開放。例外不會把原本的演練目標改成「已達標」。
這次採 Cloud SQL 跨區副本作為復原來源,並保留可獨立驗證的基準資料集。事故前最後一筆 replication lag 為 0 的量測時間是 09:55,之後沒有新樣本。升級副本後,團隊另外嘗試依應用日誌補登訂單;補登不是 database 的原生 replication replay,必須另驗證完整性與重送行為。
證據 A:復原時間線
| 時間 | 已取得的證據 | 此時仍缺少什麼 |
|---|---|---|
| 10:00 | 下單中斷 | 尚未啟動 DR |
| 10:04 | 宣告事故,決定切換 | 尚未完成舊寫入路徑隔離 |
| 10:09 | 舊 application/worker 寫入路徑已隔離並驗證 | 新資料路徑尚未可用 |
| 10:14 | 新 database 可寫;基準資料集已證明訂單、庫存與付款映射在 09:57 及以前一致 | 09:57 之後資料未證明完整,公開下單仍關閉 |
| 10:20 | DR 應用連上新 database,可接內部測試流量 | 尚未完成業務流程驗證 |
| 10:23 | 一筆全新的 synthetic order 成功 | 未決舊單與重送風險尚未驗證 |
| 10:27 | 補登後取得證據 B,發現資料缺口及付款未知狀態 | 無法核准自動重送付款 |
| 10:31 | 未決舊單已隔離、可查狀態;停用其自動再次扣款 | 尚未完成約定負載與重送驗證、風險核准 |
| 10:34 | 事故負責人及業務 owner 記錄資料目標未達,核准受限恢復與持續對帳 | 仍須完成恢復前驗證 |
| 10:36 | 約定負載、新單、未知付款隔離及重送測試通過;公開下單恢復 | 舊單完整對帳仍在進行 |
| 10:49 | 本輪未決付款對帳完成 | 仍須重建保護拓樸及安排 failback |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
證據 B:比較交易,不只看最新時間
這是本輪調查窗口內三筆已確認 database commit 的訂單。Commit 時間來自獨立保留的交易證據;金額單位為 TWD。09:57 及以前的基準資料已另完成全範圍核對,本表不代表只抽查這三筆就能證明整庫完整。
| 訂單 | 原 commit 時間 | 金額 | 10:27 候選資料庫 | 獨立付款證據 |
|---|---|---|---|---|
| O-701 | 09:57:40 | 800 | 缺少此訂單 | Provider 已確認扣款,reference P-701 |
| O-702 | 09:58:30 | 600 | 訂單、庫存與付款映射一致 | Provider 已確認扣款,reference P-702 |
| O-703 | 09:59:10 | 1,000 | 訂單存在,付款狀態 pending | 只有請求送出紀錄,結果未知 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
先寫一份四行判斷:
- 本輪實測恢復時間是多少?為什麼不是 14、23 或 49 分鐘?
- 已驗證基準資料的復原點落後多久?能用 O-703 宣告 RPO 只有 50 秒嗎?
- 10:23 或 10:27 能直接開站嗎?O-701 與 O-703 各應該先做什麼?
- 提出一項能改善實測結果的變更,寫出 owner、保留的防線與下次如何驗證。
完成判斷後展開:計算、證據邊界與安全決策
1. 最低服務的實測恢復時間是 36 分鐘,超過 RTO 6 分鐘。
故障起點              10:00
符合事前最低服務並開放  10:36
實測恢復時間           36 分鐘 > 30 分鐘目標
14 分鐘只有 database 可寫,23 分鐘只證明一筆新單成功,兩者都缺少事前約定的安全與服務條件。49 分鐘是本輪付款對帳完成,應另列在報告;這次最低服務允許舊單隔離處理,因此不能事後把 RTO 結束點換成 10:49。若業務事前要求「所有未決付款對帳完成才算恢復」,結束點就會是 10:49,但那是另一份驗收契約。
2. 已驗證基準資料的復原點落後 3 分鐘,無法符合 RPO 2 分鐘。
中斷時間 − 已驗證完整的資料點 = 10:00 − 09:57 = 3 分鐘
中斷時間 − O-701 commit 時間 = 10:00 − 09:57:40 = 2 分 20 秒
中斷時間 − 最新一筆存在時間   = 10:00 − 09:59:10 = 50 秒
09:57 是目前能證明完整的基準界線。後續補登雖讓較新的 O-703 出現,卻漏了更早的 O-701;這份候選資料不是連續、已證明一致的復原點,不能把 50 秒當成實測 RPO。O-701 已落在允許遺失的最後 2 分鐘之外,仍然缺漏,更直接反駁「資料目標達標」。應報告「已驗證基準落後 3 分鐘;補登後完整性未證明」,並保留逐筆缺口。尚未恢復不等於永久遺失,但預期稍後能補回,也不能冒充當下已完成復原。
09:55 的 lag 0 已過時,不能證明 10:00 資料完整。若使用 Cloud SQL for PostgreSQL 的跨區副本,官方要求檢查收到與已 replay 的 WAL 位置;即使收到的交易都已 replay,也不代表原 primary 的每筆 commit 都已送達。這也不能用來合理化應用補登造成的中間缺口;應另查補登範圍、刪除、查詢條件與版本。跨區副本的 failover criteria
3. 10:23 與 10:27 都應維持受控測試,不能僅因新單成功就開放。
- O-701 要以原訂單 ID 與 P-701 核對金額、庫存及付款映射,確認如何補回;不能當作全新交易再次扣款。
- O-703 的付款結果未知,不能直接標成失敗或換一個新 request ID 重送。先隔離並查詢/對帳;若 provider 有冪等功能,也要核對原 key、有效期間與重送契約,不能假設所有 provider 都相同。
- 先保留舊 writer 的隔離,對補登使用可追溯的逐筆清單,驗證相同請求的重送不產生額外業務效果。直到 10:36 的最低服務驗證與事前授權路徑都成立,才按核准限制恢復。
- 10:34 的風險例外只授權受限恢復;報告仍記錄 RTO 未達、基準復原點超過 RPO,不把例外寫成演練成功。
4. 改善要能被下一次演練推翻。
例如由資料負責人建立補登 manifest,逐筆記錄原 ID、來源證據、金額、結果與去重狀態;下次故意移除 O-701、重送 O-702、保留 O-703 未知,確認流程會阻止不安全放行,且不再次扣款。由營運負責人量測各階段耗時,優化偵測、預備存取與可重複的切換步驟;不要用刪除對帳或驗證來縮短 RTO。
演練報告至少留下故障範圍、事前目標、時間線、可證明的資料界線、未解缺口、風險核准、owner 與下次驗證條件。這些紀錄讓「復原成功」成為可審查的判斷。Google Cloud DR planning guide
情境練習:台灣電商訂單服務
業務要求 region outage 後 30 分鐘內恢復下單;已確認可以接受少量 pending order 由客服與對帳流程補正,但 completed payment 不可重複扣款。
先草擬你的方案:compute 和 database 各放在哪、事故當下的動作順序、拿什麼證明 30 分鐘做得到。寫完再展開對照。
寫完再展開:參考方案與切換順序
- 將 journey 拆成 browse、create order、authorize payment 和 notification,分別定義 RTO/RPO 與 degraded mode。
- Cloud Run 部署在台灣與日本,以 global external Application Load Balancer 連接 regional serverless NEGs;兩區都先測可承載的 failover capacity。
- Cloud SQL primary 使用 regional HA 防 zone failure,日本建立 cross-region DR replica。團隊不承諾固定 lag,而是以監控與演練取得 observed RPO。
- Payment request 使用 idempotency key;outbox/reconciliation 記錄用來處理 database 與 payment provider 間無法形成單一 transaction 的狀況。
- Region incident 時先 fence 舊 write path,再檢查 lag、執行 replica failover/promotion、更新 connection target,最後放入 synthetic order。
- Cloud SQL 另以 Backup and DR plan 寫入相容位置的 immutable vault,定期還原到隔離 project;backup 用來防 corruption/誤刪,不冒充即時 replica。
- Game day 報告記錄實際 data gap、切換時間與 capacity,若超過目標,再決定增加 automation、capacity,或改用更符合一致性需求的 database architecture。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
sequenceDiagram
  autonumber
  participant IC as Incident Commander
  participant TW as 台灣寫入路徑
  participant DB as 日本 DR replica
  participant APP as 日本 Cloud Run
  participant PAY as Payment provider
  participant LB as Global load balancer
  IC->>TW: Fence writes
  IC->>DB: 檢查 lag,執行 failover/promotion
  DB-->>IC: 回報 observed data gap
  IC->>APP: 更新 connection target 並擴容
  APP->>PAY: 以 idempotency key 送 synthetic order
  PAY-->>APP: 回傳穩定結果
  APP-->>IC: Business invariant 驗證通過
  IC->>LB: 啟用/確認日本流量
  LB-->>IC: 回報 health 與 production telemetry
這個方案沒有用「replication 通常只差幾秒」保證 RPO,也沒有用 DNS 更新假裝完成自動 failover。每個承諾都有 telemetry、runbook 和測試結果支撐。
課後檢查
往下看重點之前,先試著回答這幾題;答不出來,括號裡是該回去重讀的那一節。
- Replica、backup、archive 各防什麼?為什麼有 replica 還是需要 backup?(回〈資料層:replica、backup 與 archive 用途不同〉)
- Cloud SQL regional HA 保護到哪一種故障?region 掛掉時還需要什麼?(回〈Cloud SQL〉)
- Failover runbook 除了把流量切過去,還要處理哪些步驟?(回〈Failover runbook 要處理的不只「切過去」〉)
- 最新一筆訂單存在,為什麼仍不能證明 RPO?風險例外為什麼不能改寫原本的演練結果?(回〈桌上演練:資料庫可寫,還能直接開站嗎?〉)
本課重點
- 先列 instance、zone、region、corruption、operator 和 security 等 failure modes。
- RTO/RPO 要針對 business journey 與 data class 定義,並包含 degraded service 與 consistency 要求。
- SLA 取決於服務與配置,不能用通用 zonal/regional 百分比代替。
- Replica 不是 backup;backup 也不代表已經測過 restore。
- Cloud SQL HA 保護同區 zone failure;cross-region async replica 的 RPO 取決於實際 lag。
- Cloud Run 多區需要 load balancing 與 health/failover 設計,單純多部署不會完成切換。
- Backup vault 提供 enforced retention,但 workload/location 支援與 log 保護範圍要逐項確認。
- Failover 要包含 fencing、validation、reconciliation 和 failback。
- 只有演練量到的 RTO/RPO,才能拿來檢查架構是否符合業務目標。
延伸閱讀
- Architecting disaster recovery for cloud infrastructure outages
- Disaster recovery planning guide
- Cloud SQL availability
- Promote cross-region Cloud SQL replicas
- Serve Cloud Run traffic from multiple regions
- Backup vault concepts
下一步
想把這一課練熟,站內的 架構師設計工作坊 · 步驟 12 可以直接填自己案例的故障情境、RPO/RTO、備份策略和 runbook。
下一課開始做 PCA case study。你會把 business requirement、technical constraint 和 operation risk 拆開,再用本課的 failure-mode 思考檢查候選架構。