
「18 個月後機房租約到期,所以把 500 台 VM 搬上雲。」
這是一個截止日期,不是遷移計畫。
真正的計畫要回答:哪些系統互相依賴、先搬誰、資料怎麼同步、切換失敗怎麼回去,以及搬完後誰負責營運。
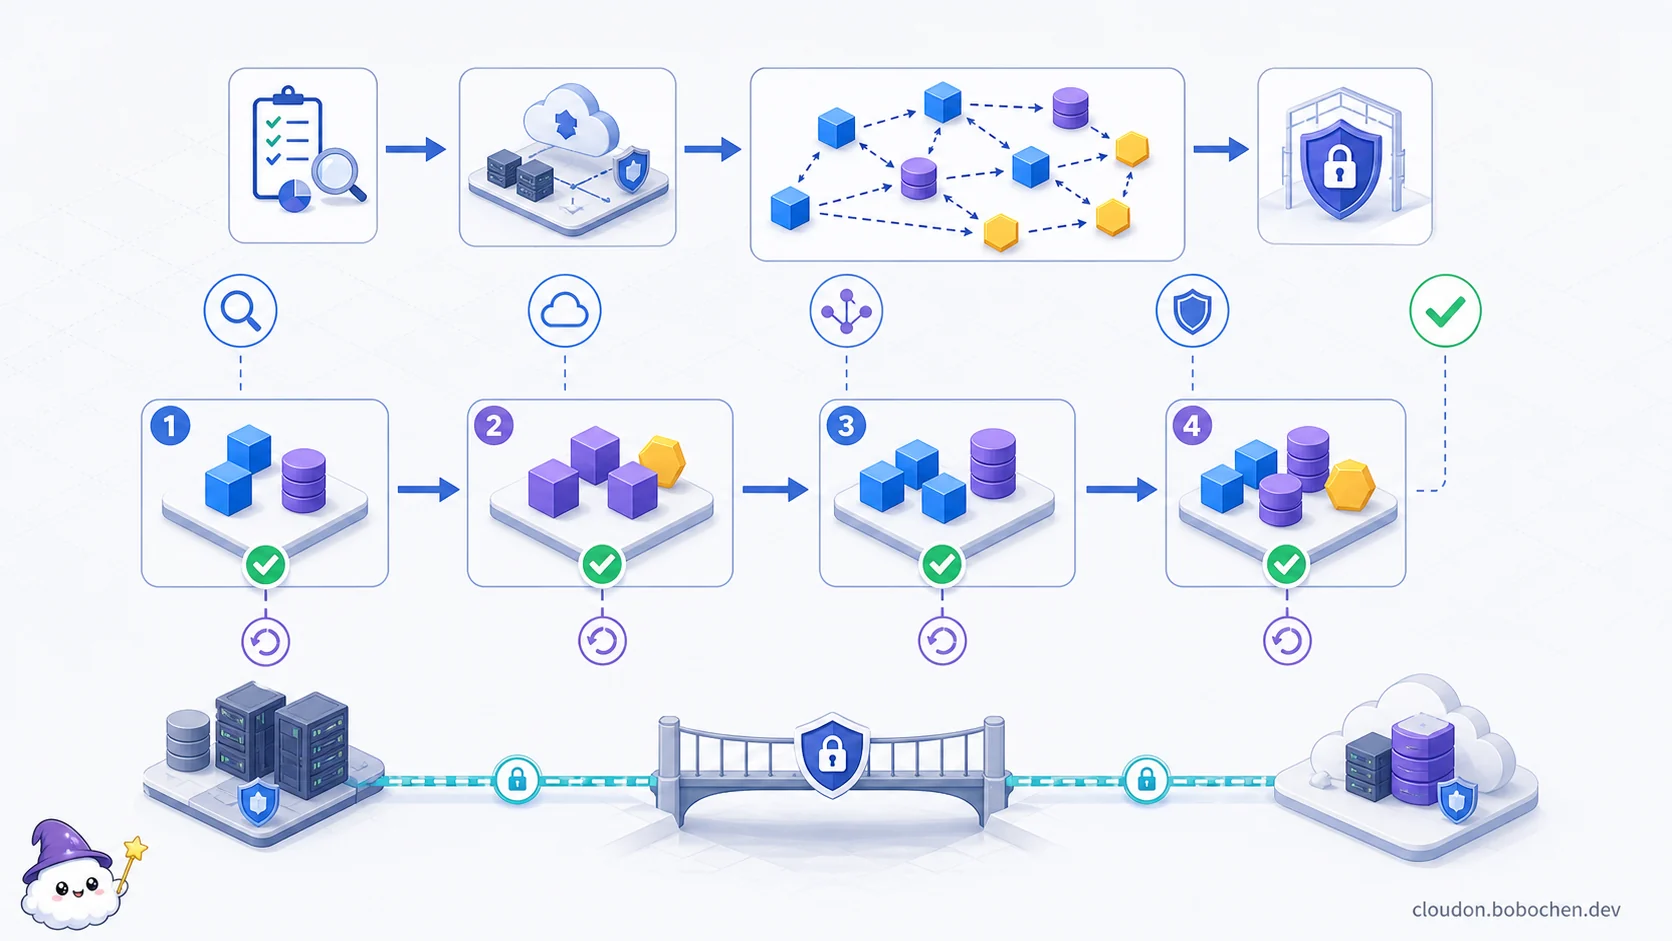
圖解:先盤點相依關係並建立安全的 Landing Zone,再按波次遷移;每一波都要有驗證門檻與回退路徑,混合連線則保留到切換結果真正被證明。
Google Cloud 的四階段遷移路徑
官方遷移指南把旅程分成四個階段:
- Assess:盤點環境、依賴、效能、風險與 TCO。
- Plan:建立雲端基礎、排列優先順序、設計批次和責任。
- Deploy:實際遷移、測試、同步、切換與退役。
- Optimize:根據雲端用量改善可靠性、效能、成本與操作方式。
四個階段會重疊。第一個遷移波次的結果,通常會回頭修正評估資料與後續計畫。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  A["Assess<br/>Inventory、Dependencies、Baseline、Risk、TCO"] --> P["Plan<br/>Landing zone、<br/>Disposition、<br/>Waves、Owners"]
  P --> D["Deploy<br/>Replicate、<br/>Test、Cutover、<br/>Rollback/Retire"]
  D --> O["Optimize<br/>Reliability、<br/>Performance、<br/>Cost、Operations"]
  D --> E["Wave evidence<br/>Actual duration、<br/>Issues、<br/>Dependencies、Cost"]
  O --> E
  E --> G{"Evidence 改變後續<br/>Assumptions<br/>或 priorities?"}
  G -->|"是"| A
G -->|"否"| P Assess:先弄清楚現在有什麼
至少要盤點:
- 伺服器、資料庫、儲存與網路設備
- 應用程式擁有者和業務關鍵性
- 連線、批次、檔案交換與身分依賴
- CPU、記憶體、磁碟、流量和尖峰基準
- 作業系統、資料庫和商業軟體授權
- 備份、RTO/RPO 與維護窗口
- 合規、資料位置和稽核要求
- 現有成本與合約結束日期
資產清單不等於相依關係圖。一台 CPU 很低的舊 VM,可能是所有訂單都要經過的授權伺服器;若只依資源利用率排優先順序,很容易搬錯。
Migration Center 的角色
Migration Center 能匯入或探索基礎設施資料,協助:
- 建立資產清單
- 收集效能資料
- 產生合適規格與費用估算
- 比較偏好的遷移目標
- 支援 TCO 與商業案例分析
實際能取得哪些依賴與屬性,取決於資料來源、Discovery Client、匯入方式和權限。不能假設接上工具後,所有應用依賴和業務關係都會自動正確。
工具輸出也要由應用擁有者確認。掃描不到的排程、人工檔案交換和外部合作夥伴,常比伺服器本身更容易在切換時出問題。
Plan:替每個工作負載決定處置方式
常見的 6R 可以當成討論詞彙:
| 處置 | 代表意思 | 何時可能合理 | 主要風險 |
|---|---|---|---|
| Rehost | 先搬到相似 VM 環境 | 截止日期緊、應用穩定 | 技術債和高成本一起搬過去 |
| Replatform | 小幅改用代管平台 | 能換資料庫或執行平台,但不大改功能 | 相容性與效能要重測 |
| Refactor / Rearchitect | 改變應用與資料架構 | 現況無法達到長期目標 | 時程、範圍和雙跑複雜 |
| Repurchase | 用 SaaS 或其他產品取代 | 非差異化能力、現有產品維護成本高 | 流程改變、資料移轉與退出條款 |
| Retire | 關閉 | 無擁有者、重複或不再產生價值 | 隱藏依賴尚未被發現 |
| Retain | 暫時保留 | 法規、硬體、合約或風險尚未解決 | 混合環境成本和過渡期拉長 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
這不是一題一個 R 的分類遊戲。同一套系統可能先 Rehost 達成機房退出,再把高價值模組逐步 Replatform 或 Refactor。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart LR
  W["Workload+Dependencies+Owner+Baseline"] --> V{"仍有明確 Business value<br/>與 active owner?"}
  V -->|"否"| RT["Retire 候選<br/>先驗證 hidden dependencies"]
  V -->|"是"| H{"法規、Hardware、License、Contract<br/>目前阻止遷移?"}
  H -->|"是"| RN["Retain<br/>寫原因、Owner、Review date"]
  H -->|"否"| S{"成熟 SaaS/Product<br/>可取代非差異化能力?"}
  S -->|"是"| RP["Repurchase 候選"]
  S -->|"否"| L{"Deadline 緊且現況<br/>短期可接受?"}
  L -->|"是"| RH["Rehost<br/>先達成退出,再設 Modernization trigger"]
  L -->|"否"| M{"小幅換 Runtime/Database<br/>即可達標?"}
  M -->|"是"| RPL["Replatform 候選"]
  M -->|"否"| RF["Refactor/Rearchitect 候選"]
  RT --> T["驗證 Cost、Risk、Timeline、Compatibility 與 Exit"]
  RN --> T
  RP --> T
  RH --> T
  RPL --> T
RF --> T 建立 Landing Zone
搬第一個正式工作負載前,要先準備:
- Organization、Folder、Project 和 Billing 結構
- Cloud Identity、IAM、群組與緊急存取
- Organization Policy 和安全基準
- Shared VPC、DNS、IP 規劃與混合連線
- Logging、Monitoring、Audit 與安全事件匯集
- KMS、Secret、資料分類與備份政策
- IaC、CI/CD 和變更流程
- 成本標籤、預算與責任歸屬
如果每個遷移團隊都自行建立一套網路和 IAM,速度可能在第一週看起來很快,後面卻會花更多時間整併。
用 Wave 管理相依關係
一個 Wave 應包含可以一起測試與切換的工作負載,而不是隨機湊出固定數量的 VM。
可以這樣分:
- Pilot:低風險但具代表性,用來驗證基礎與流程。
- 早期 Wave:相依關係清楚、擁有者投入、回退容易。
- 主要 Wave:使用前面量到的速度與問題調整節奏。
- 高風險 Wave:核心系統、複雜資料或短停機窗口。
- Retire / Retain:持續追蹤未搬項目,不讓它們消失在報表外。
每個 Wave 都要有進入條件、測試計畫、切換 Runbook、回退門檻和完成定義。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  S["Select dependency-complete wave"] --> E{"Entry criteria<br/>Owner、Landing zone、<br/>Network、<br/>Backup ready?"}
  E -->|"否"| P["補齊前置條件"]
  P --> E
  E -->|"是"| R["Replicate/<br/>Migrate/<br/>Configure"]
  R --> T["Technical+Business+<br/>Security+Restore tests"]
  T --> G{"Go/No-Go criteria<br/>全部符合?"}
  G -->|"否"| F["Fix,重新演練<br/>Runbook"]
  F --> T
  G -->|"是"| C["Cutover"]
  C --> O["Observe<br/>defined window<br/>SLO、Data、<br/>Support、Cost"]
  O --> D{"Completion<br/>definition<br/>已達成?"}
  D -->|"否"| B["Rollback+<br/>處理切換後新資料"]
  B --> L["Post-wave learning"]
  D -->|"是"| A["Accept+<br/>Decommission<br/>when safe"]
  A --> L
L --> S 遷移工具要按對象選
VM
Migrate to Virtual Machines 可把支援來源的 VM 複寫到 Compute Engine,先測試 Clone,再安排 Cutover。是否能達到停機目標,仍取決於資料變更量、網路、應用和切換步驟。
VMware
Google Cloud VMware Engine 保留 VMware SDDC 操作模型,適合需要快速退出資料中心、又暫時不想改變大量 VM 的情況。
應用程式不用立刻重寫,但授權、容量、網路、備份和長期費用都要重新確認。不要把「VMware 相容」寫成「不需要處理授權」。
資料庫
Database Migration Service 支援多種同質與異質遷移到 Cloud SQL 或 AlloyDB。Continuous Migration 會先做初始載入,再持續同步變更,能把最終切換的停機壓低。
「Minimal downtime」不等於零停機。正式切換仍要:
- 停止或控制來源寫入
- 等待 Replication Lag 歸零
- 驗證資料和序列
- 切換連線
- 觀察錯誤
- 決定回退時資料如何處理
支援的來源、目的地、版本、物件和轉換能力會更新,必須查目前的遷移情境清單。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
sequenceDiagram
  participant S as Source Database
  participant M as Migration/Replication
  participant T as Target Database
  participant A as Application/Traffic
  participant O as Operator/Observer
  M->>S: Initial load,開始擷取 changes
  M->>T: 套用 baseline 與持續 changes
  loop Cutover 前
    O->>M: 監控 lag、errors、unsupported objects
    O->>T: 驗證 schema、counts、queries、performance
  end
  O->>A: 進入 maintenance/read-only/write freeze
  A-->>S: 停止新的 authoritative writes
  O->>M: 等待 replication lag 歸零
  M-->>O: Final sync complete
  O->>T: 執行 data/sequence/permission validation
  O->>A: 切換 connection 到 Target
  A->>T: Smoke test+controlled writes
  alt 驗證成功
    O->>A: 逐步恢復流量並持續觀察
  else 驗證失敗
    O->>A: 停止 Target writes,執行 rollback/reconciliation plan
end 物件與檔案
- Storage Transfer Service:線上來源、其他雲端和支援的地端檔案系統。
- Transfer Appliance:網路窗口不足、適合離線搬運的大型資料集。
- BigQuery Data Transfer Service:把特定 SaaS 或支援來源資料排程匯入 BigQuery,不是一般檔案遷移的萬用工具。
選線上或離線傳輸前,先估:
理想傳輸時間 = 資料量 ÷ 可用吞吐量再加上協定開銷、業務流量、重傳、校驗和增量同步。只看線路標稱頻寬通常太樂觀。
混合環境不是失敗,有時是長期設計
保留地端或其他雲端可能有合理理由:
- 工廠控制需要本地低延遲
- 硬體或授權無法移動
- 資料或系統有明確位置要求
- 併購後暫時需要整合多個環境
- 正在進行分波遷移
- 某個 SaaS 或雲端服務具有必要能力
但每多一個環境,就多一份網路、身分、觀測、事件處理和技能成本。架構文件應寫出保留原因與重新檢視日期,避免「暫時」變成沒有擁有者的永久狀態。
選 HA VPN 還是 Cloud Interconnect?
HA VPN
- 使用 IPsec 加密
- 經過公用網際網路
- 建置通常較快
- 每個 Tunnel 有封包速率上限;實際 Gbps 取決於封包大小
- 適合較低或中等流量、快速建立與備援
要取得 HA VPN SLA,必須使用符合要求的冗餘拓撲,不是建立一條 Tunnel 就自動得到。
Cloud Interconnect
- 流量不走公用網際網路
- 提供 Dedicated、Partner 等連線方式
- 容量、交付時間與責任邊界依類型而異
- 適合穩定高流量、延遲較可預期的連線需求
- 預設不提供端到端 IPsec 加密
若要求 IP 層加密,可以部署 HA VPN over Cloud Interconnect;支援的 MACsec 也有特定範圍。連線設計要分開確認容量、加密和 SLA,不能用單一產品名稱一次代表三件事。
正式環境常會組合多條連線、不同 Edge Availability Domain 和備援設備。Interconnect 當主要路徑、HA VPN 當備援是否足夠,要看兩者是否真的沒有共用故障點。
GKE 的 fleet 多叢集管理適合什麼情況?
GKE 的 fleet 管理功能包含團隊管理、Config Sync、Policy Controller、Connect Gateway 等能力,協助一致管理多個 Kubernetes 叢集與環境;Cloud Service Mesh、Multi Cluster Ingress 這類功能另外計費。這些功能原本屬於 GKE Enterprise(更早叫 Anthos),官方在 2025-09-02 宣布併入標準 GKE,之後不再使用 GKE Enterprise 這個名稱。
它比較適合:
- 組織已有多個 GKE 或 Kubernetes 叢集
- 需要跨叢集身分、政策與設定標準
- 有平台團隊負責治理
- 一致性管理帶來的價值高於額外成本與複雜度
只有一兩個簡單應用,不代表一定要導入整套多叢集平台。也不要反過來假設「只在 Google Cloud 就永遠不需要 fleet 管理」;要看治理規模和功能需求。
Strangler Fig:逐步替換,不是無限期雙軌
漸進式現代化可以這樣做:
- 選出邊界清楚、風險可控的功能。
- 在舊系統前建立可觀察的路由或介面。
- 實作新服務並做資料一致性設計。
- 先導入一小部分流量。
- 比較功能、延遲、錯誤和成本。
- 完全切換後,真正移除舊功能。
最大的陷阱是新舊兩套長期並存。每個被替換功能都要有退役條件、擁有者和日期。
一份可執行的 Cutover Runbook
至少包含:
- 變更前備份與還原驗證
- DNS、TTL、憑證和連線準備
- 凍結或雙寫策略
- 最終同步與資料校驗
- Smoke Test 與業務驗收
- 指標、Log 和觀察窗口
- Go / No-Go 決策者
- 明確回退條件
- 回退後新增資料的處理
- 對使用者、客服和利害關係人的通知
「切回舊系統」若沒有處理切換後的新資料,就不是真正的回退方案。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  F["Freeze/<br/>Dual-write policy 啟動"] --> S["Final sync+Validation"]
  S --> C["Switch traffic/DNS/Connection"]
  C --> W["觀察 Business transactions、Errors、<br/>Latency、Data consistency"]
  W --> G{"達到 Success criteria?"}
  G -->|"是"| A["宣布 Target<br/>authoritative<br/>延後退役 Source"]
  G -->|"否"| N["停止/隔離<br/>Target 新 writes"]
  N --> D{"Cutover 後是否已產生<br/>不可遺失的新資料?"}
  D -->|"否"| R["Route back to Source"]
  D -->|"是"| X["Export/<br/>Reverse sync/<br/>Reconcile/<br/>Compensate,<br/>先定義衝突規則"]
  X --> R
  R --> V["驗證 Source data 與 User journey"]
V --> L["記錄 Root cause,重設下一次 Go/No-Go gate"] 情境練習:18 個月退出資料中心
先不要替 500 台 VM 全選 Rehost。
可以分成:
- 無擁有者且沒有流量證據:先確認能否 Retire。
- 標準商業軟體:比較 Compute Engine、VMware Engine 或 SaaS。
- 自建 PostgreSQL:評估 Cloud SQL、AlloyDB 與 DMS 支援情況。
- 高耦合核心系統:先畫依賴與 Cutover,再決定 Rehost 或 Replatform。
- 大量歷史檔案:用真實可用吞吐量比較線上傳輸與 Transfer Appliance。
- 地端控制系統:若必須保留,明確設計長期混合連線與營運責任。
Pilot 的目的不是挑最簡單的一台 VM 證明「搬得動」,而是驗證身分、網路、觀測、備份、切換和支援流程能否一起運作。
15 分鐘演練:這次切換真的能回退嗎?
以下是教學用情境,時間是團隊演練所得的假設值,不代表任何遷移產品的效能保證。
訂單系統準備從來源資料庫切換到目標資料庫。業務要求:
- 變更窗口最多 30 分鐘,從停止來源寫入開始計時,到恢復正常服務為止。
- 已確認成功的訂單不得遺失。
- 來源在切換後保留為唯讀;團隊沒有演練過自動反向複寫。
- 所有步驟依序執行,以下時間已包含各步驟的驗證。
| 動作 | 演練時間 |
|---|---|
| 最終同步與來源/目標資料校驗 | 5 分鐘 |
| 切換應用連線與基本測試 | 3 分鐘 |
| 目標尚未接受新訂單時,切回來源並驗證服務 | 6 分鐘 |
| 目標已接受新訂單時,停止寫入、匯出並對帳新訂單 | 14 分鐘 |
| 完成對帳後,將新訂單套用至來源、切回連線並驗證服務 | 6 分鐘 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
草案寫著:「第 8 分鐘開放目標寫入,持續觀察到第 20 分鐘;若出現錯誤,就把連線切回來源。」
演練時,第 18 分鐘 發現付款結果無法正確顯示,目標已經接受 24 筆成功訂單。負責人說:「來源還在,直接切回去就好。」
你的交付物
先用 10 分鐘填寫以下四項,再用 5 分鐘對照參考答案。每項都要寫出證據或動作,不能只填產品名稱。
- Go/No-Go:你會批准原草案嗎?用時間計算和資料完整性各提出一個理由。
- 兩種回退路徑:分別寫出「尚未接受新寫入」與「已有新寫入」的操作順序;指出何時可以安全切回來源。
- 決策截止點:若回退工作必須在第 30 分鐘前完成,兩種路徑最晚各要在第幾分鐘開始?原草案的觀察安排有什麼衝突?
- 責任與證據:列出決策者、停止寫入的負責人、訂單對帳的負責人,以及宣布恢復服務前要檢查的至少三項證據。
完成後再展開:參考答案與驗收標準
1. 原草案應判定 No-Go
目標已有新寫入時,完整回退需要 14 + 6 = 20 分鐘。第 18 分鐘開始,最早第 18 + 20 = 38 分鐘 才能恢復服務,超出 30 分鐘窗口。這個計算成立於題目的依序執行假設;沒有演練證據就不能自行假設兩項工作可平行或省略。
直接切回唯讀來源,會讓 24 筆已成功的新訂單暫時或永久缺席,也可能導致使用者重試付款。保留來源只代表仍有舊資料,不能證明它可以立刻承接業務。
2. 回退要依寫入狀態分支
- 尚未接受新寫入:確認目標未產生需要保留的新資料 → 切回來源連線 → 驗證登入、查單與下單流程 → 恢復服務。題目給定此路徑共 6 分鐘。
- 已有新寫入:停止目標寫入 → 保存新訂單與相關付款紀錄 → 對帳並處理重複、缺漏和衝突 → 將確認資料套用至來源 → 切回連線 → 驗證訂單與付款狀態 → 恢復服務。題目給定此路徑共 20 分鐘。
「回退」也不能再次觸發已成功的付款。應先定義訂單識別碼、付款識別碼與重試處理規則,並在演練中證明對帳方法可行。
3. 最晚開始時間不能只看 DNS 或連線切換
- 無新寫入路徑:
30 − 6 = 第 24 分鐘。 - 有新寫入路徑:
30 − 20 = 第 10 分鐘。
原草案第 8 分鐘開放寫入,卻計畫觀察到第 20 分鐘才決定是否回退。它在需要保留新資料的路徑上,只剩第 8 到第 10 分鐘這段決策時間,無法涵蓋第 18 分鐘才發現的問題。
以上是使用題目時間的理論最晚值,正式計畫還要預留變動餘裕。延後開放寫入可以增加唯讀測試時間,但不能取代正式寫入後的業務驗證。
可重新提案的方向包括:演練更快且完整的對帳回退流程、取得較長窗口的業務核准,或驗證能在剩餘窗口內恢復服務的修復方案。不能單憑「應該可以修好」批准原計畫;若限制與演練結果仍不相容,就維持 No-Go。
4. 責任與驗收不能留白
一份可接受的答案會指定具名角色,例如變更負責人決定 Go/No-Go、應用值班者控制寫入、資料庫與支付負責人共同對帳。恢復服務的證據至少包含:
- 24 筆成功訂單在權威資料來源中均可查到,訂單內容與金額一致。
- 每筆付款狀態與訂單一致,沒有因重試造成重複扣款。
- 查單、下單與付款的完整使用者流程通過驗證,並持續觀察錯誤和延遲。
另須保留操作時間、執行者與對帳結果;不能只靠「頁面打得開」宣布完成。
自評:8 分中至少拿到 6 分
| 評分項目 | 得分條件 | 分數 |
|---|---|---|
| 是否批准 | 明確 No-Go,且同時說明窗口與資料風險 | 2 |
| 回退分支 | 兩種路徑都有完整順序,已有新資料時先停寫、對帳再切回 | 2 |
| 截止時間 | 算出第 24/10 分鐘,並指出觀察到第 20 分鐘的矛盾 | 2 |
| 責任與證據 | 有三種負責角色,且驗收涵蓋訂單、付款與完整業務流程 | 2 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
即使總分達標,若答案包含「不處理新訂單就切回來源」,仍需重做第 2 項。這是資料完整性的必要條件,不是可以用其他分數補回的缺漏。
課後檢查
你應該能回答:
- Assess 階段為什麼不能只有資產清單?(回〈Assess〉)
- 6R 是工作負載處置語言,為什麼不是一次性的終局?(回〈Plan〉)
- Minimal downtime 和 zero downtime 差在哪裡?(回〈遷移工具要按對象選〉的資料庫小節)
- Interconnect 的容量、加密與 SLA 為什麼要分開設計?(回〈選 HA VPN 還是 Cloud Interconnect?〉)
- 一份可回退的 Cutover Runbook 必須處理哪些資料問題?(回〈一份可執行的 Cutover Runbook〉)
答不出來的話,括號裡是該回去重讀的那一節。
下一課會深入 VPC、Shared VPC、負載平衡和私有服務存取,補齊遷移計畫裡最容易成為關鍵路徑的網路基礎。