
在 BigQuery 中使用 Gemini 模型
課程概述
假設客服留言都存在 BigQuery,你想替每一筆留言加上分類或摘要,還要先匯出到另一套程式嗎?AI.GENERATE_TEXT 讓 SQL 查詢呼叫 Gemini 處理文字(舊教材與 Lab 畫面上的 ML.GENERATE_TEXT 是它的前一版,功能相同)。這篇會從連線與遠端模型設定開始,最後看批次結果該怎麼檢查。
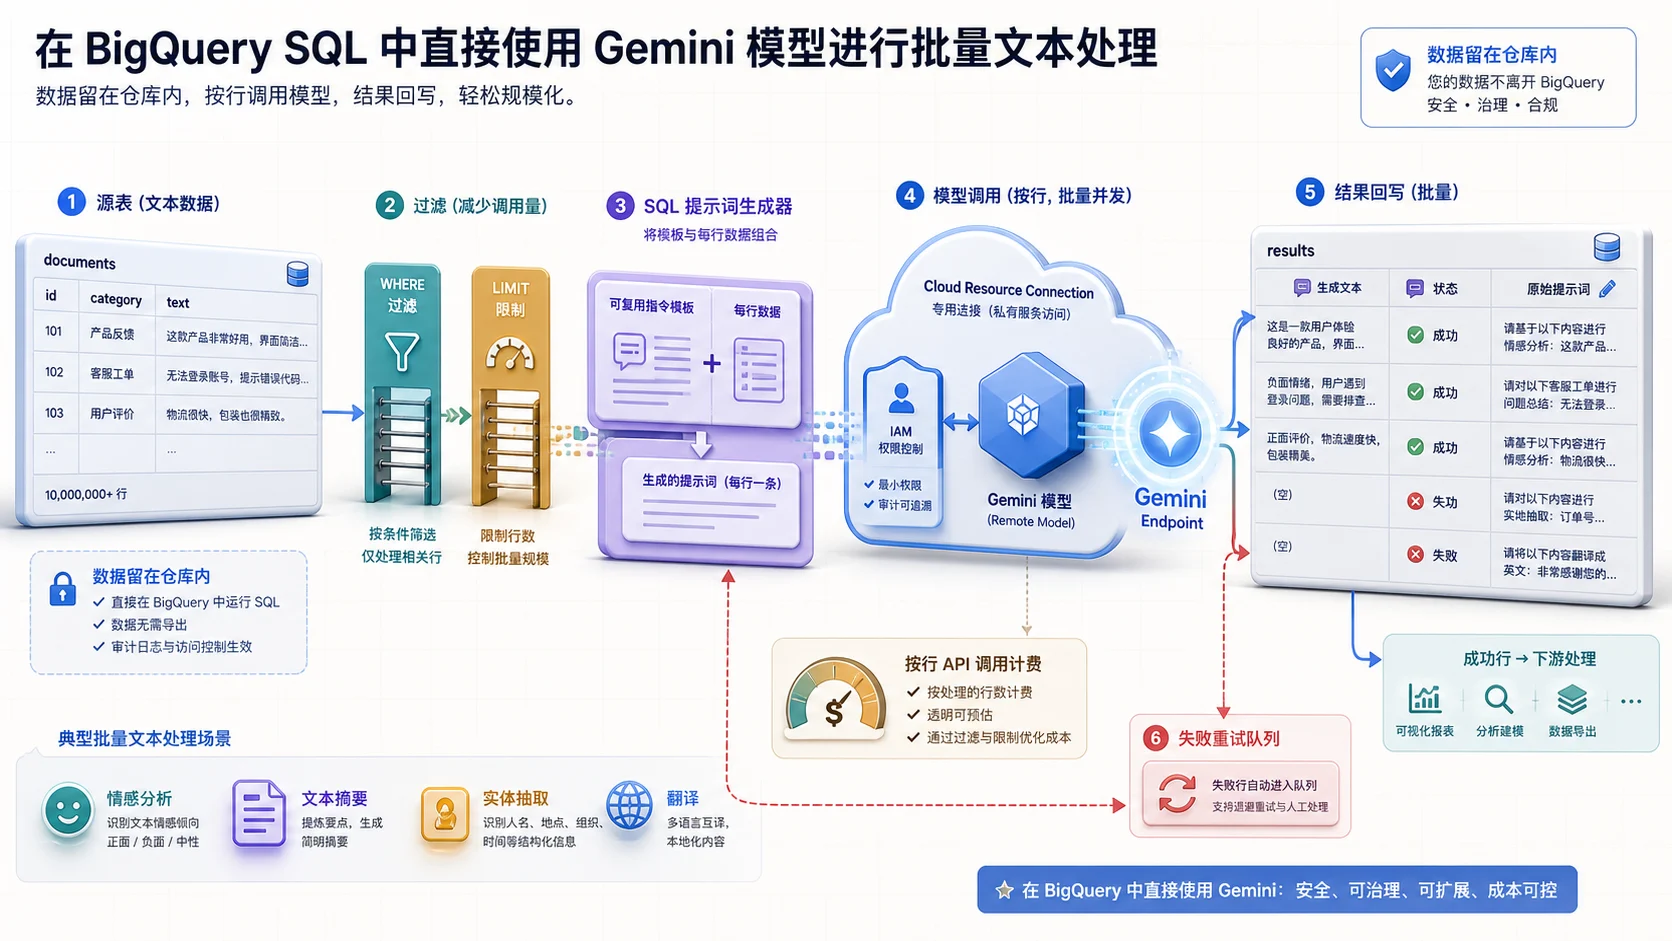
AI.GENERATE_TEXT 把同一個 Prompt 模板套到每列資料,經安全連線批次呼叫
Gemini,再把生成文字與狀態寫回表格。先把少量資料列另存成表來小量驗證可控成本(圖上的 LIMIT
步驟,官方不建議直接寫在 prompt 查詢裡);成功列往下游走,失敗列依狀態集中重試。
你將學到
- 在 BigQuery 中建立連接 Gemini 的遠端模型
- 使用
AI.GENERATE_TEXT對表格資料進行文字生成 - 設計 SQL 內嵌 Prompt 進行批次分類與摘要
- 處理
AI.GENERATE_TEXT的回應結構與錯誤處理 - 控制 Gemini 呼叫的成本與流量
核心概念
BigQuery + Gemini 的架構
在 BigQuery 裡用 Gemini,架構是這樣:
- 建立 Cloud Resource Connection(連接 Gemini Enterprise Agent Platform,簡稱 Agent Platform,原 Vertex AI)
- 建立 Remote Model 指向 Gemini Endpoint
- 使用
AI.GENERATE_TEXT函式在 SQL 中呼叫模型
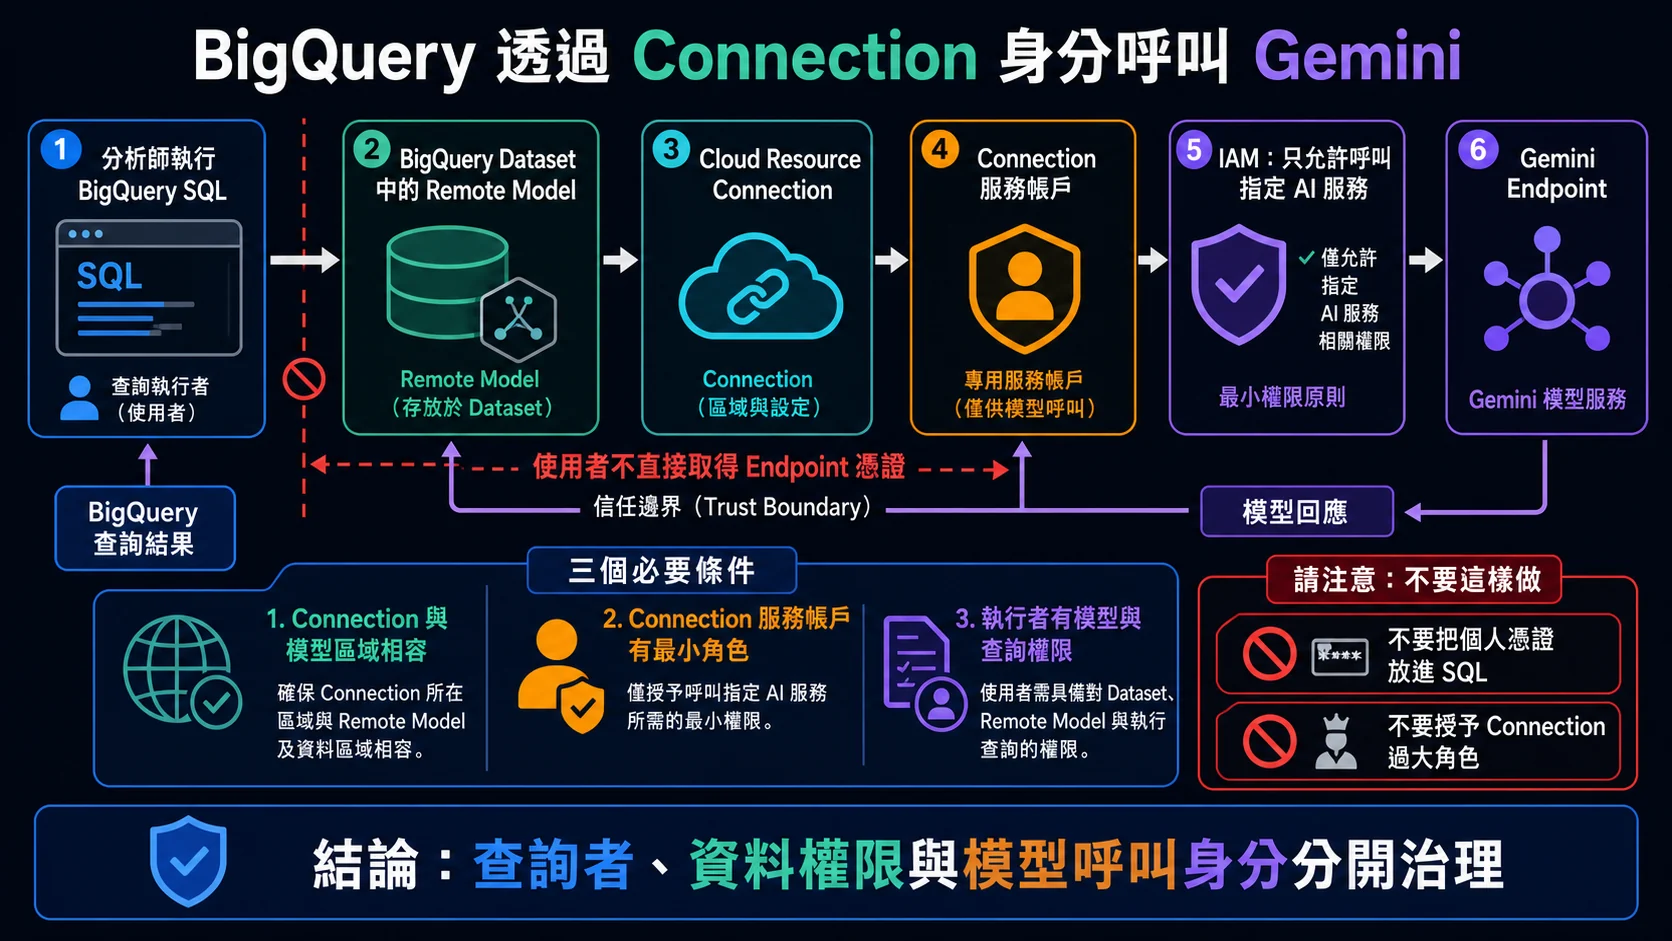
這裡有兩個不同身分邊界:使用者需要執行查詢、使用模型與讀取資料的權限;真正呼叫 Agent Platform 的則是 Connection 服務帳戶,必須另外授予最小必要角色。
建立 Gemini 遠端模型
-- Step 1: 建立 BigQuery 與 Agent Platform 的連線
-- (需先建立 Cloud resource connection:BigQuery 的 Explorer 窗格 → Connections → Create connection,
--  或用 bq mk --connection;需要 BigQuery Connection Admin 角色 roles/bigquery.connectionAdmin)

-- Step 2: 建立指向 Gemini 的遠端模型
CREATE OR REPLACE MODEL `dataset.gemini_model`
  REMOTE WITH CONNECTION `project.region.connection`
  OPTIONS(ENDPOINT = 'gemini-3.5-flash-lite');  -- 模型代號會退役,建立前先對官方的模型生命週期表
模型代號有退役日:舊教材與 Lab 若還寫著
gemini-2.5-flash,要留意官方模型生命週期表列的退役日是 2026 年 10 月 20 日,之後要改用表上列的替代模型。
AI.GENERATE_TEXT 函式
在 BigQuery 裡透過遠端模型呼叫 Gemini,用的是 AI.GENERATE_TEXT。它是 ML.GENERATE_TEXT 的新版:官方 2025 年 11 月 18 日的 release note 說兩者功能相同、新版的輸出欄位名稱較簡短,舊函式的參考頁也註明新寫的查詢建議改用新版。舊教材與 Lab 若還是 ML.GENERATE_TEXT,欄位對照見下方「回應結構」。寫法如下:
-- 先把要測試的少量資料列存成一張表,再交給函式:
-- 官方不建議在 prompt 查詢裡直接寫 LIMIT/OFFSET(會先處理全部輸入資料才套用)
CREATE OR REPLACE TABLE `dataset.customer_reviews_sample` AS
SELECT review_text
FROM `dataset.customer_reviews`
LIMIT 100;

SELECT
  result,
  status,
  prompt
FROM AI.GENERATE_TEXT(
  MODEL `dataset.gemini_model`,
  (SELECT
    CONCAT('請將以下客戶評論分類為正面、中性或負面:', review_text) AS prompt
   FROM `dataset.customer_reviews_sample`),
  -- 沒有設 temperature/top_p:Gemini 3.5 Flash-Lite 不支援自訂取樣參數,設了會被忽略
  STRUCT(
    1024 AS max_output_tokens
  )
);
常見應用場景
| 場景 | Prompt 範例 | 輸入資料 |
|---|---|---|
| 情感分類 | 「將此評論分類為正面/中性/負面」 | 客戶評論表 |
| 內容摘要 | 「用 50 字摘要以下文章」 | 新聞/文件表 |
| 實體抽取 | 「從此文本中抽取人名、地名和組織名」 | 非結構化文字 |
| 資料補全 | 「根據產品名稱推測其分類」 | 商品目錄表 |
| 翻譯 | 「將以下內容翻譯為繁體中文」 | 多語言資料表 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
回應結構
AI.GENERATE_TEXT 會回傳輸入資料表的欄位,再加上這些欄位(Gemini 模型):
result— Gemini 生成的文字(STRING)status— 這一列的 API 呼叫狀態,空字串表示成功full_response— 完整的 JSON 回應rai_result— 負責任 AI 的結果(JSON,含安全屬性)statistics— 這次生成的統計資料(JSON,例如 token 數)grounding_result— 有做 grounding 時的結果(JSON)
舊版 ML.GENERATE_TEXT 對應的欄位是 ml_generate_text_llm_result(生成文字)與 ml_generate_text_status(狀態),而且要把 flatten_json_output 設成 TRUE 才會拆成獨立欄位;沒設時回傳的是 JSON 欄位 ml_generate_text_result,Gemini 模型的生成文字在裡面的 text 元素。
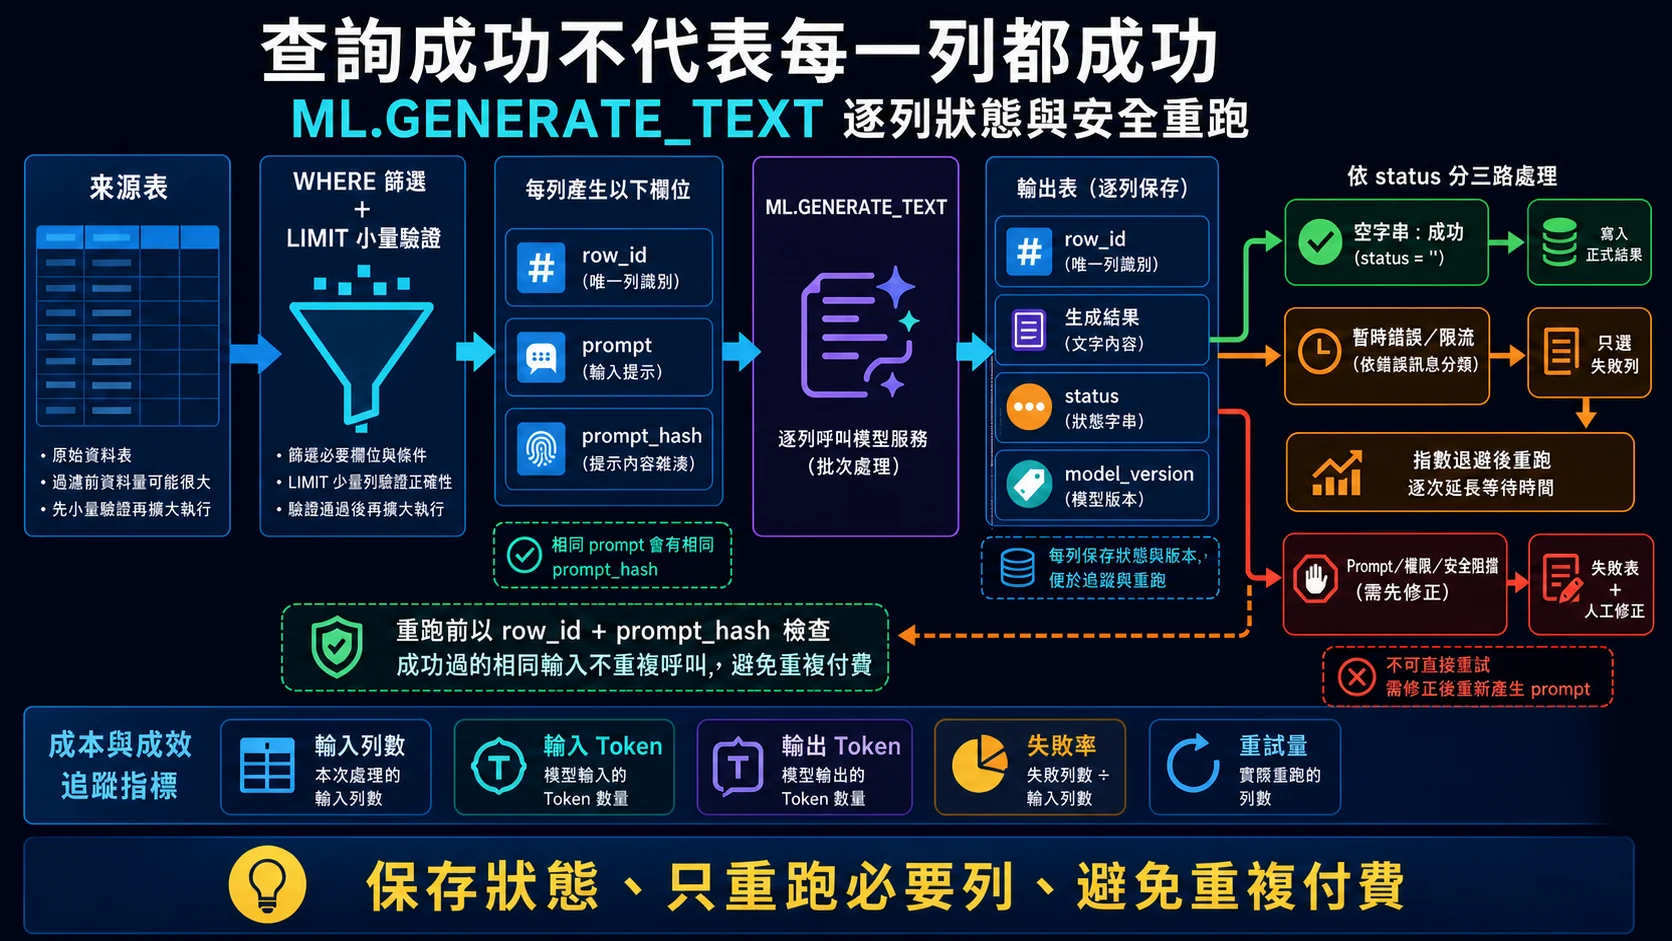
查詢成功不代表每列成功;輸出應保留列識別、Prompt
雜湊、狀態與模型版本。先依錯誤訊息分成暫時性問題與需修正問題,只退避重試必要列,並跳過已成功的相同輸入。圖上印的
ML.GENERATE_TEXT 是舊版函式名;「LIMIT 小量驗證」一步,實作時改成先把少量資料列另存成表。
result 本來就是純文字欄位,後面可以直接用 SQL 接著處理;要看 token 用量或安全屬性時,再去讀 statistics、rai_result 這兩個 JSON 欄位。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32}}}%%
flowchart TD
  PROMPT["固定 Prompt 模板、<br/>模型版本與<br/>結構化輸出要求"] --> SAMPLE["先把代表性資料存成小表<br/>測試品質、安全<br/>與 Token 成本"]
  SAMPLE --> QUALITY{"輸出能穩定解析<br/>且符合業務門檻?"}
  QUALITY -->|"否"| REVISE["調整 Prompt/資料清理<br/>並重跑相同樣本"]
  QUALITY -->|"是"| KEY["保存 row_id、<br/>prompt_hash<br/>與模型設定以支援冪等"]
  KEY --> BATCH["依分區分批呼叫<br/>並寫入結果表"]
  BATCH --> STATUS{"逐列 status 為何?"}
  STATUS -->|"成功"| DONE["保留結果與稽核欄位"]
  STATUS -->|"暫時錯誤"| RETRY["退避後只重試失敗列"]
STATUS -->|"輸入或安全問題"| HOLD["隔離並人工查核,<br/>不盲目重試"] 實作重點
- 建立 Connection 後,須授予連線的服務帳戶
roles/aiplatform.user角色 - 批次處理大量資料時,先把少量資料列存成一張表、用它測試 Prompt 效果,再擴大規模;官方不建議在 prompt 查詢裡用
LIMIT/OFFSET(查詢會先處理全部輸入資料才套用) - 單列呼叫失敗不會讓整個查詢掛掉,錯誤會記在
status欄位,事後用WHERE status != ''把失敗的列撈出來重跑即可(注意 BigQuery 沒有SAFE.AI.GENERATE_TEXT,SAFE.前綴是給 scalar 函式用的,不適用AI.GENERATE_TEXT這種 table-valued function) - 端點位置:BigQuery 支援的這批 Gemini 3 系列模型只有多區域端點。
ENDPOINT只寫模型名稱時,查詢在美國或歐盟(europe-west2、europe-west6 除外)會用 us/eu 端點,其他位置(例如 asia-east1)會用 global 端點;global 端點只能搭配AI.GENERATE_TEXT,而且官方提醒,對資料處理位置有要求時不要用 global 端點 - 成本控制:每次
AI.GENERATE_TEXT呼叫都會算 Gemini Enterprise Agent Platform API(原 Vertex AI API,服務名仍是aiplatform.googleapis.com)的錢,所以先用WHERE把要處理的資料列篩出來、寫成一張表,再把那張表交給函式,別一口氣對整張大表打下去
Lab 指引
Lab 連結:Work with Gemini Models in BigQuery — Google Skills
延伸學習
- Gemini 提升 BigQuery 生產力 — 更多 Gemini 在 BigQuery 中的實用技巧
- BigQuery ML 推論實戰 — BQML 遠端模型推論的完整流程
- Gemini 輔助數據分析 — Gemini 在 BigQuery Console 中的互動輔助功能
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
Gemini 提升 BigQuery 生產力
寫 SQL、看執行計畫、補欄位說明,哪些工作能請 Gemini 幫忙?整理 BigQuery 裡實用的用法和檢查點。
BigQuery ML 推論實戰
模型訓練好之後,怎麼對新資料做預測?比較 BigQuery ML 原生模型、匯入模型與遠端模型的用法。
Gemini 輔助數據分析
讓 Gemini 幫忙起草 SQL 和圖表後,分析師還要檢查什麼?以 BigQuery 和 Looker 的工作流程為例。