
BigQuery ML 推論實戰
課程概述
模型訓練完成,不代表預測流程就能直接上線。新資料的欄位要和訓練時對得上,資料量變大後也要考慮執行時間與費用。這篇從 BigQuery ML 的預測開始,再看匯入模型和 Gemini Enterprise Agent Platform(簡稱 Agent Platform,原 Vertex AI)的遠端模型各適合什麼情況。
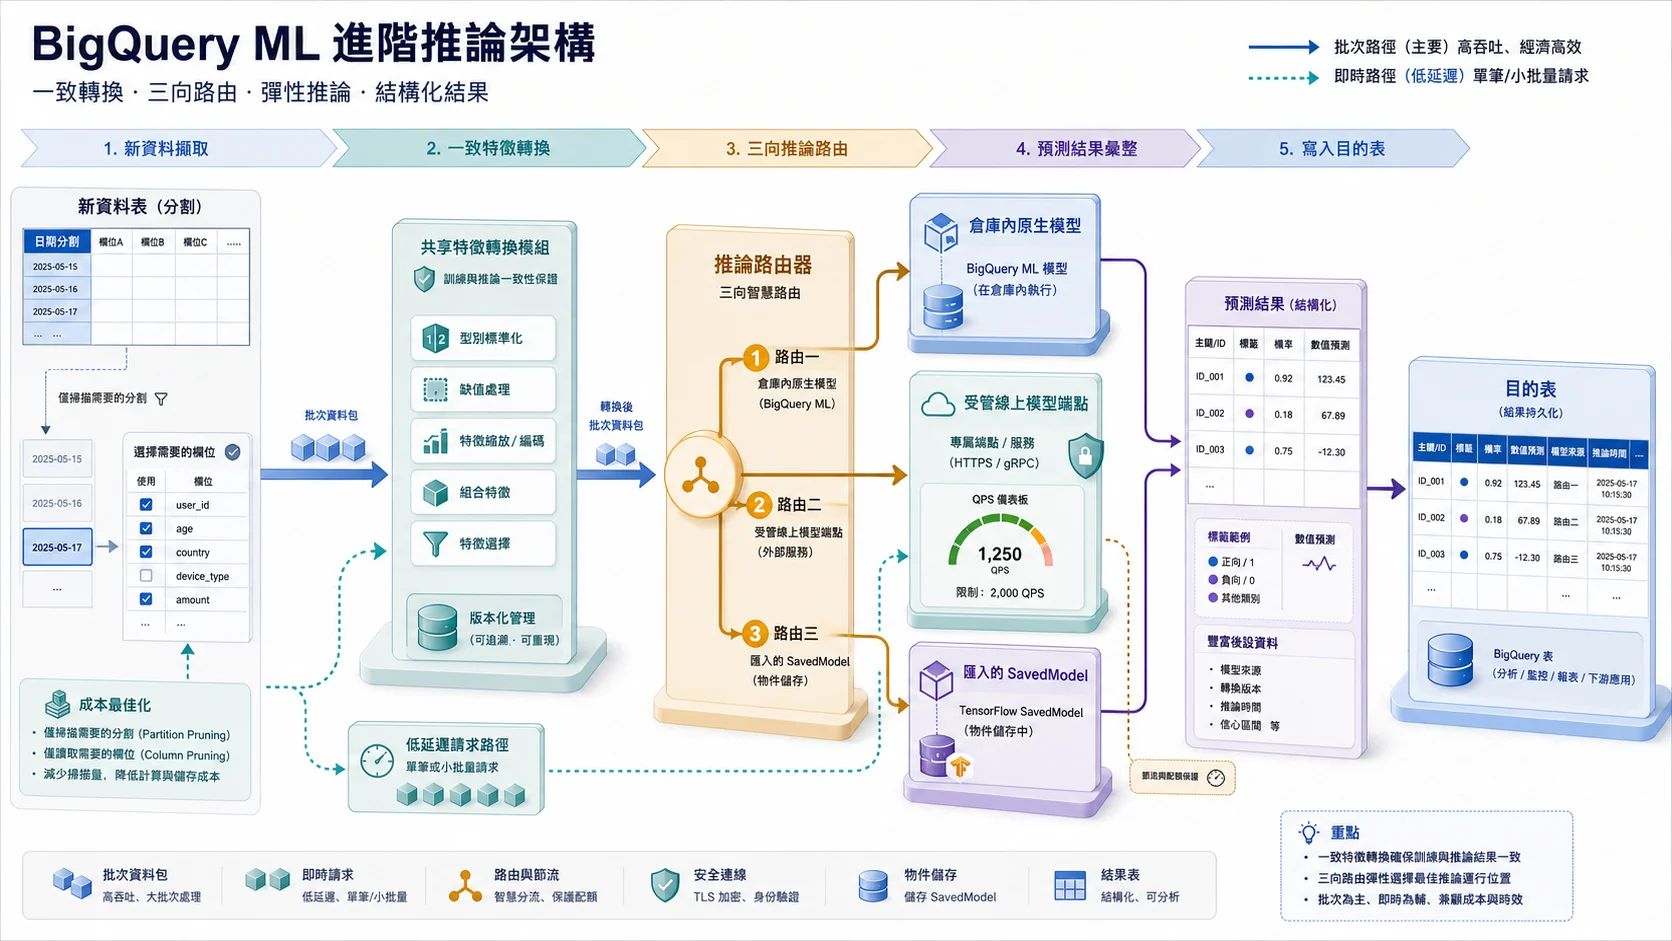
三條路徑共用同一個前提:推論特徵必須與訓練一致。原生模型就地執行、遠端模型提供彈性但受端點 QPS 影響、匯入模型重用外部資產;分區裁剪與欄位裁剪則控制批次成本。
你將學到
- 使用
ML.PREDICT進行批次推論(要低延遲的線上預測,官方做法是把模型登錄到 Model Registry、部署到 Agent Platform 的 endpoint) - 透過
CREATE MODEL ... REMOTE呼叫 Agent Platform 上的外部模型 - 匯入 TensorFlow SavedModel 到 BigQuery ML
- 使用
ML.TRANSFORM確保推論時的特徵一致性 - 優化大規模推論的效能與成本
核心概念
BQML 推論的三種方式
| 方式 | 語法 | 使用場景 |
|---|---|---|
| 本地模型推論 | ML.PREDICT(MODEL model) | BQML 原生訓練的模型 |
| 遠端模型推論 | ML.PREDICT(MODEL remote_model) | 呼叫 Agent Platform 的 endpoint |
| 匯入模型推論 | ML.PREDICT(MODEL imported_model) | TensorFlow / ONNX 模型 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
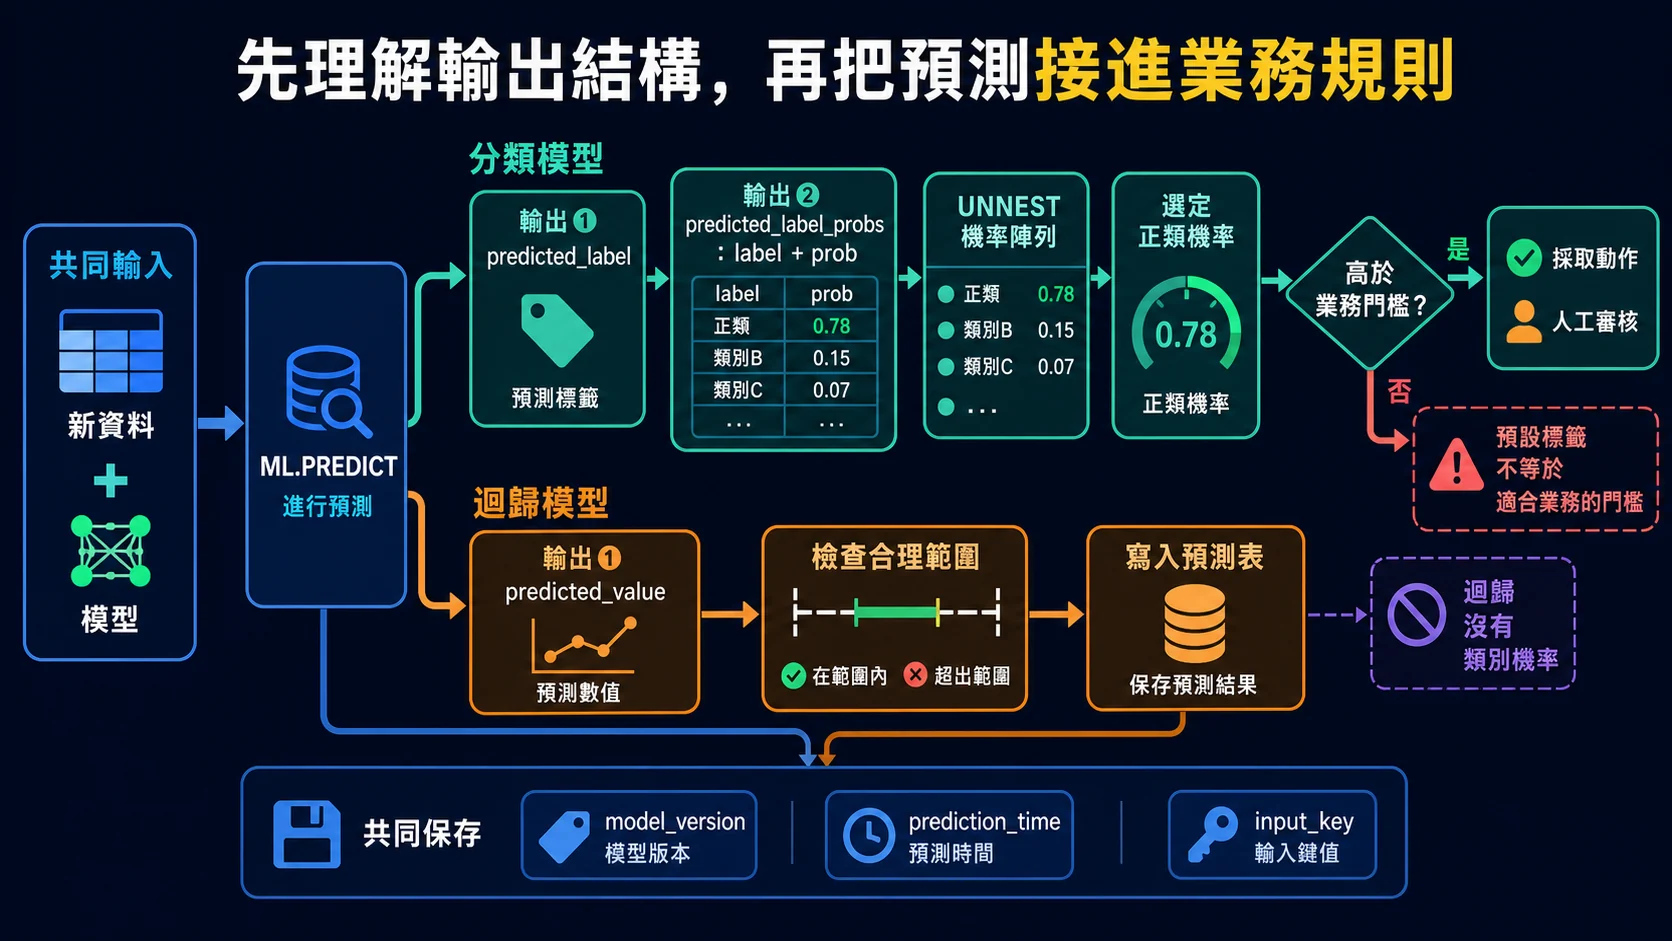
ML.PREDICT
的下游處理要依模型類型設計:分類結果除了標籤還要展開機率並設定決策門檻;迴歸結果則檢查預測值範圍、誤差與異常值,不能套用類別機率邏輯。
遠端模型(Remote Model)
遠端模型讓你直接在 BigQuery SQL 裡呼叫部署在 Agent Platform 上的模型,資料不用搬出 BigQuery:
-- 建立遠端模型連線
CREATE OR REPLACE MODEL `dataset.remote_model`
  INPUT(feature1 FLOAT64, feature2 STRING)
  OUTPUT(prediction FLOAT64)
  REMOTE WITH CONNECTION `project.region.connection`
  OPTIONS(ENDPOINT = 'https://REGION-aiplatform.googleapis.com/...');

-- 使用遠端模型預測
SELECT * FROM ML.PREDICT(MODEL `dataset.remote_model`,
  (SELECT feature1, feature2 FROM `dataset.new_data`));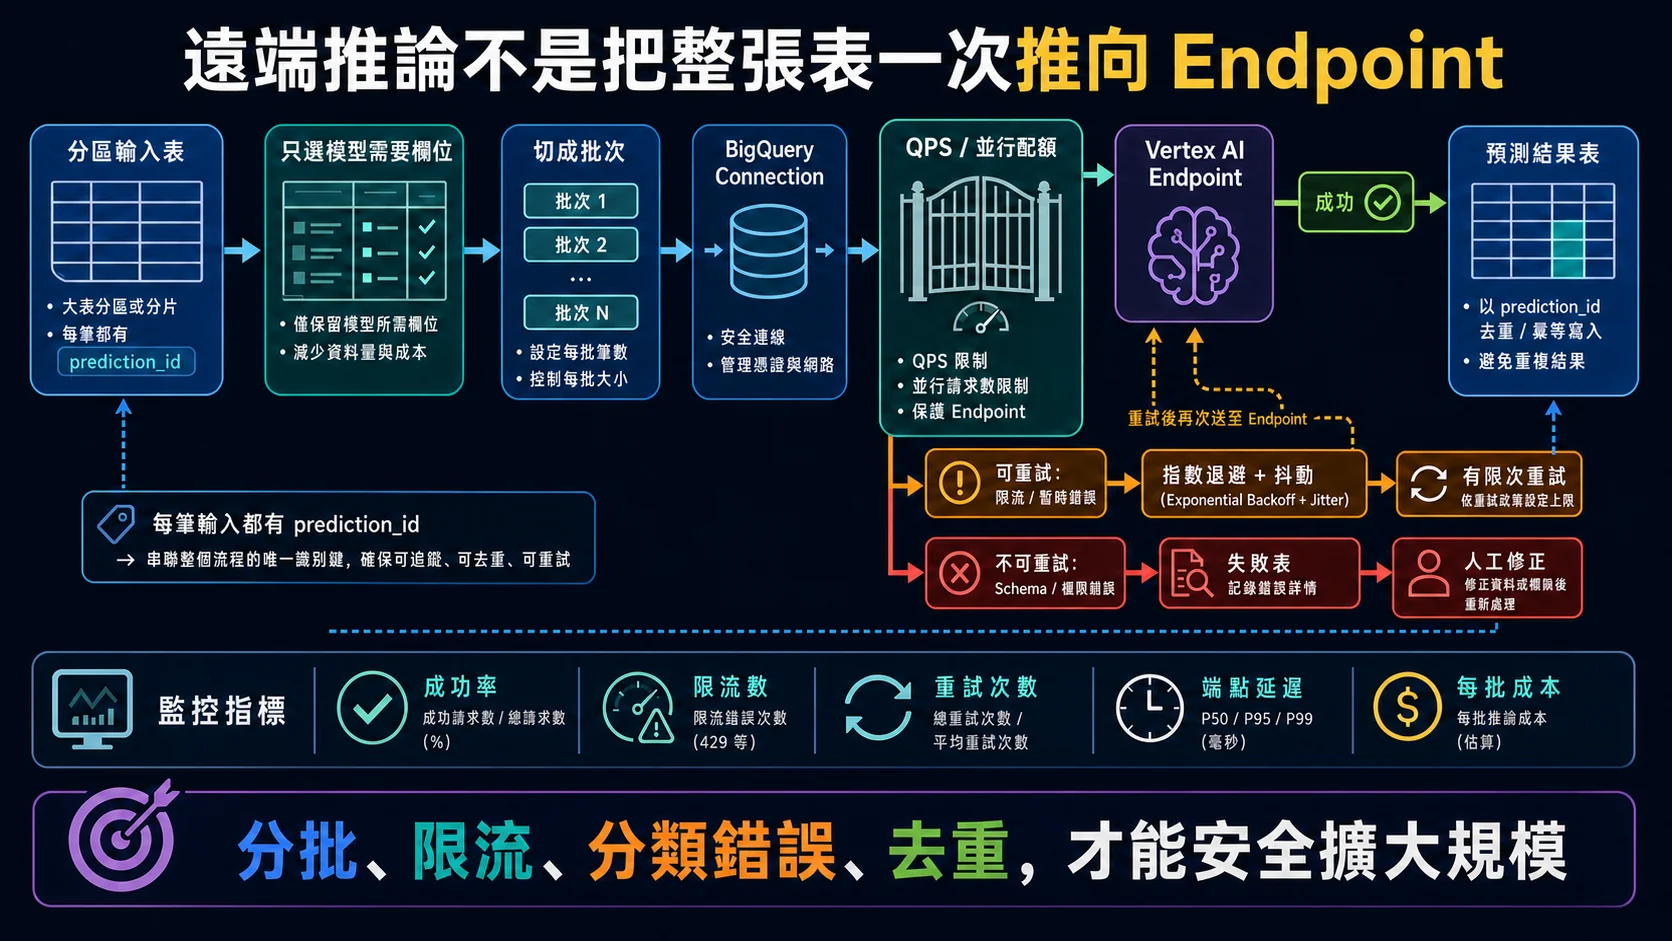
遠端推論同時受 BigQuery 工作量與端點配額約束;以可控批次送出、記錄每列狀態,只對暫時錯誤退避重試,並用唯一鍵或雜湊確保重跑不會重複產生結果。
匯入 TensorFlow 模型
如果你在外部已經訓練好 TensorFlow 模型,把 SavedModel 上傳到 Cloud Storage,再匯入 BigQuery ML 就行:
CREATE OR REPLACE MODEL `dataset.tf_model`
  OPTIONS(model_type='TENSORFLOW',
          model_path='gs://bucket/saved_model/*');
匯入後就能像使用 BQML 原生模型一樣進行推論。
特徵一致性(Feature Consistency)
推論時最容易踩的雷,就是訓練跟推論的特徵處理對不上。BQML 的 TRANSFORM 子句正是用來解決這件事:
CREATE MODEL `dataset.model`
  TRANSFORM(
    ML.BUCKETIZE(age, [18, 30, 50, 65]) AS age_bucket,
    ML.STANDARD_SCALER(income) OVER() AS scaled_income,
    label
  )
  OPTIONS(model_type='LOGISTIC_REG')
  AS SELECT age, income, label FROM `dataset.train`;
寫在 TRANSFORM 裡的轉換,到 ML.PREDICT 時會自動套用,兩邊就不會兜不起來。
批次推論效能優化
大規模推論時的效能考量:
- 對輸入資料使用分區表,只掃描需要預測的分區
- 物化中介結果並只 SELECT 模型需要的輸入欄位,減少重複計算與掃描量
- 遠端模型推論受 Agent Platform endpoint 的 QPS 限制,需注意流量控管
- 批次推論結果可直接寫入目標表:
CREATE TABLE ... AS SELECT * FROM ML.PREDICT(...)
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32}}}%%
flowchart TD
  FAILED["保留 row_id、模型版本、輸入雜湊<br/>與每列錯誤狀態"] --> TYPE{"失敗類型?"}
  TYPE -->|"欄位/型別/Signature"| SCHEMA["對齊名稱與型別<br/>並重用訓練時的 TRANSFORM"]
  TYPE -->|"Connection/IAM/Region"| ACCESS["檢查連線服務帳戶、端點權限<br/>與資源位置"]
  TYPE -->|"配額或暫時性錯誤"| QUOTA["縮小批次並指數退避<br/>避免同時壓滿 Endpoint"]
  TYPE -->|"無效輸入或模型拒絕"| DATA["隔離問題列並修正資料<br/>不要無限重試"]
  SCHEMA --> RETRY["只重跑失敗列,跳過相同雜湊的成功結果"]
  ACCESS --> RETRY
  QUOTA --> RETRY
DATA --> QUARANTINE["保留到隔離表供人工查核"] 實作重點
- 分類模型的
ML.PREDICT會輸出預測標籤與各類別機率(predicted_<label>_probs),可用UNNEST展開後依機率篩選;迴歸模型則只輸出預測值,沒有機率欄位 - 遠端模型需先建立 BigQuery Connection(
bq mk --connection),並授予連線的服務帳戶呼叫 Agent Platform 的權限 - 匯入 TensorFlow 模型時,須確認模型的 signature 與 BigQuery 的資料類型相容
- 常見錯誤:推論資料的欄位名稱或類型與訓練時不一致,導致
ML.PREDICT報錯 - 成本控制:推論查詢也按掃描量計費,建議只 SELECT 需要的欄位作為模型輸入
Lab 指引
Lab 連結:Using BigQuery Machine Learning for Inference — Google Skills
延伸學習
- BigQuery ML 建模實戰 — 回顧 BQML 基礎建模流程
- 在 BigQuery 中使用 Gemini 模型 — 用 BQML 遠端模型呼叫 Gemini
- Agent Platform(原 Vertex AI)機器學習解決方案 — 深入 Agent Platform 的完整 ML 流程
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
BigQuery ML 建模實戰
資料已經在 BigQuery,能不能直接用 SQL 做預測?從建模、評估到預測,試一次 BigQuery ML。
在 BigQuery 中使用 Gemini 模型
一整欄文字要分類或摘要,能直接在 BigQuery 裡做嗎?用 AI.GENERATE_TEXT 批次呼叫 Gemini。
Gemini 提升 BigQuery 生產力
寫 SQL、看執行計畫、補欄位說明,哪些工作能請 Gemini 幫忙?整理 BigQuery 裡實用的用法和檢查點。