
Agent Platform(原 Vertex AI)機器學習解決方案
課程概述
如果現成 API 不符合需求,BigQuery ML 也不夠彈性,就得自己處理訓練與部署。Gemini Enterprise Agent Platform(簡稱 Agent Platform,原 Vertex AI)提供 AutoML、自訂訓練、模型註冊和部署工具。這篇先看各步驟怎麼接,再比較何時用哪條路。
名稱提醒:Vertex AI 已在 2026 年 4 月改名為 Gemini Enterprise Agent Platform(簡稱 Agent Platform)。本文用現行名稱;課程影片與 Lab 畫面若仍顯示舊名,指的是同一個產品。
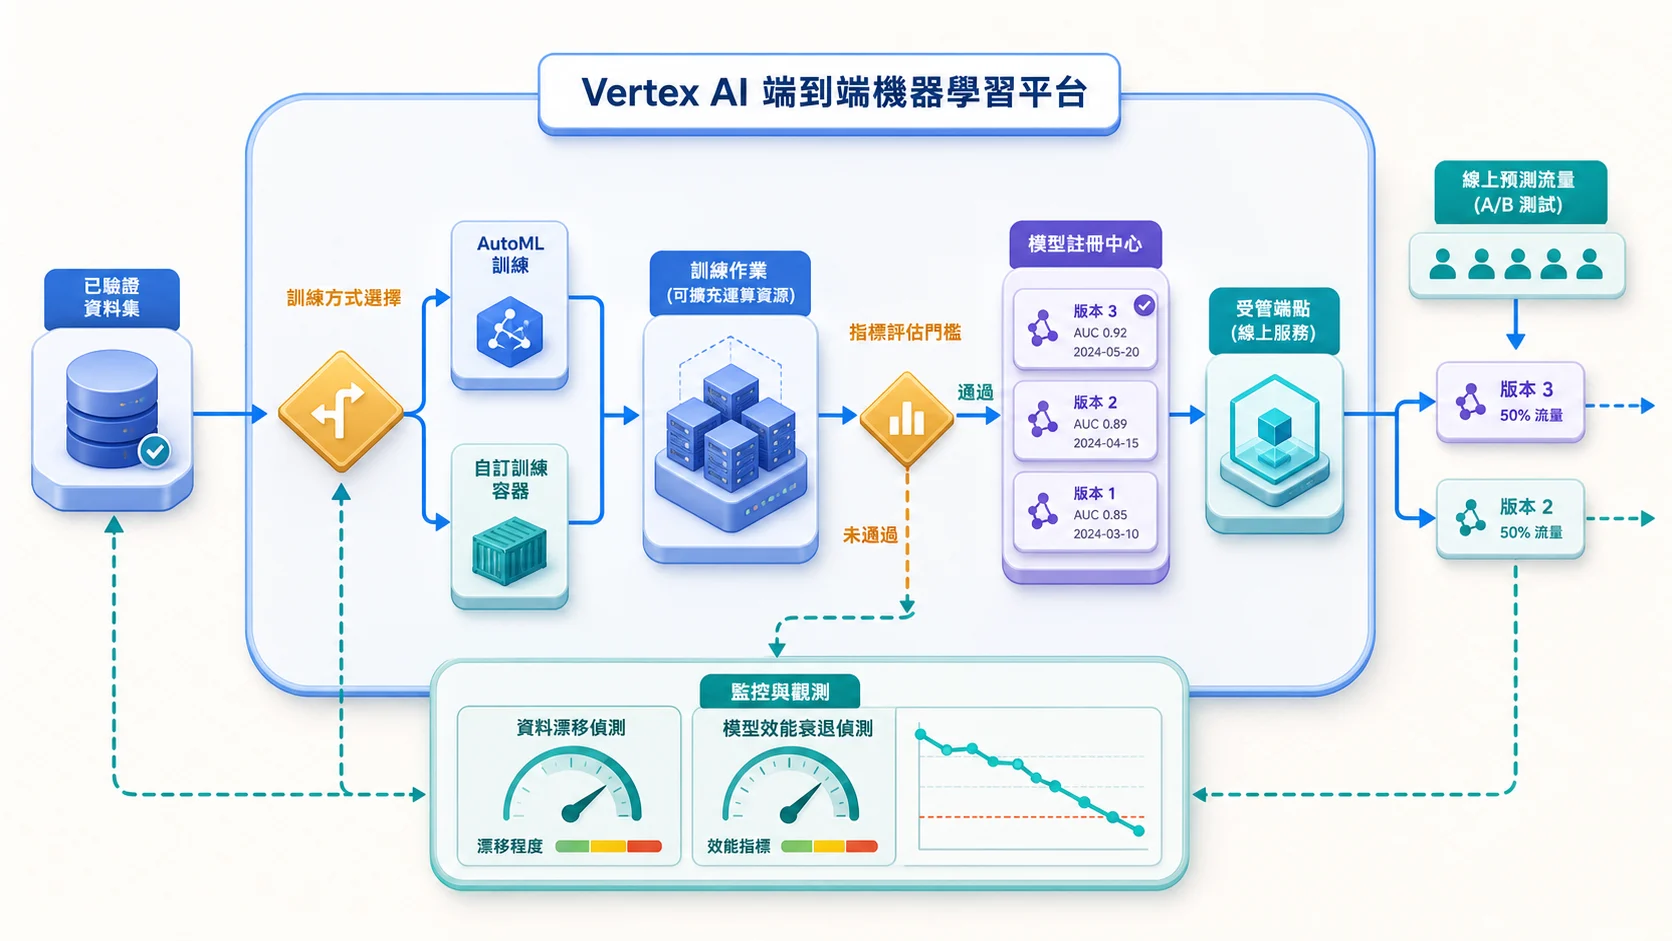
Agent Platform(圖上印的是舊名 Vertex AI)將選擇訓練方式、可擴縮訓練、品質閘門、版本註冊、端點部署與監控串成一條可重複管線;線上流量可在模型版本間分配,漂移或效能退化則把流程送回資料與重訓階段。
你將學到
- 使用 AutoML 建立影像分類與表格預測模型
- 設定 Agent Platform 的自訂訓練 Job 執行 TensorFlow / PyTorch 程式碼
- 將訓練好的模型部署到 Endpoint 提供線上預測
- 使用 Agent Platform Pipelines(原 Vertex AI Pipelines)自動化 ML 工作流
- 透過 Model Registry(原 Vertex AI Model Registry)管理模型版本
核心概念
Agent Platform 在 ML 光譜中的定位
Google Cloud 的 ML 工具大致是一條從簡單到複雜的光譜:
預訓練 API → BigQuery ML → AutoML → 自訂訓練(Agent Platform)
   最簡單      用 SQL       無程式碼     最大彈性
Agent Platform 把 AutoML 和自訂訓練兩端都涵蓋進來,而且共用同一套管理介面。
AutoML vs 自訂訓練
| 面向 | AutoML | 自訂訓練 |
|---|---|---|
| 適合對象 | ML 初學者、快速驗證 | ML 工程師、研究人員 |
| 所需技能 | 不需寫程式碼 | Python + ML 框架 |
| 模型彈性 | Google 自動選擇最佳架構 | 完全自訂架構與超參數 |
| 訓練時間 | 可能要好幾個小時,依資料量、複雜度與訓練預算而定 | 依模型複雜度而定 |
| 支援類型 | 影像、表格(AutoML Text、AutoML Video 已停止提供) | 任何框架與模型類型 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
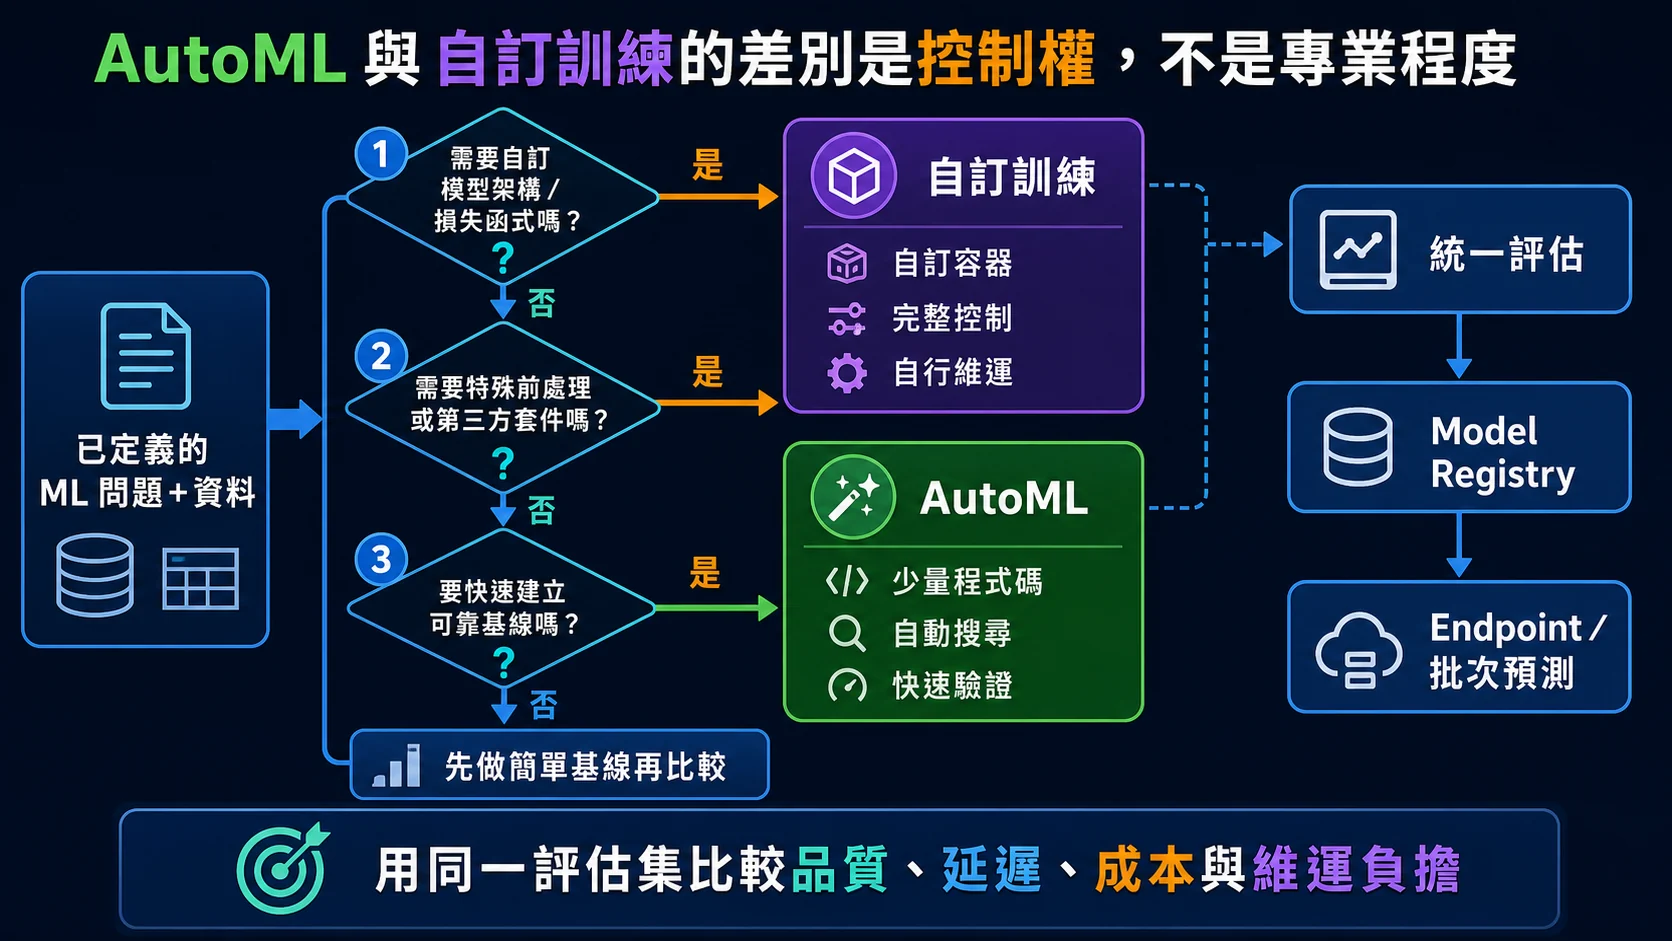
AutoML 適合快速建立可靠基線;只有在需要特殊架構、自訂訓練迴圈或現成框架無法滿足時,才承擔自訂容器、調參與維運成本,並以同一評估門檻比較兩條路徑。
Agent Platform Pipelines
Pipelines 讓你把 ML 工作流寫成一個可以重複跑的 DAG(有向無環圖)。一個典型的 Pipeline 大概長這樣:
- 資料驗證 — 檢查資料品質與分佈
- 資料預處理 — 特徵工程與資料轉換
- 模型訓練 — 執行訓練 Job
- 模型評估 — 計算效能指標並與基線比較
- 模型部署 — 通過品質門檻後自動部署到 Endpoint
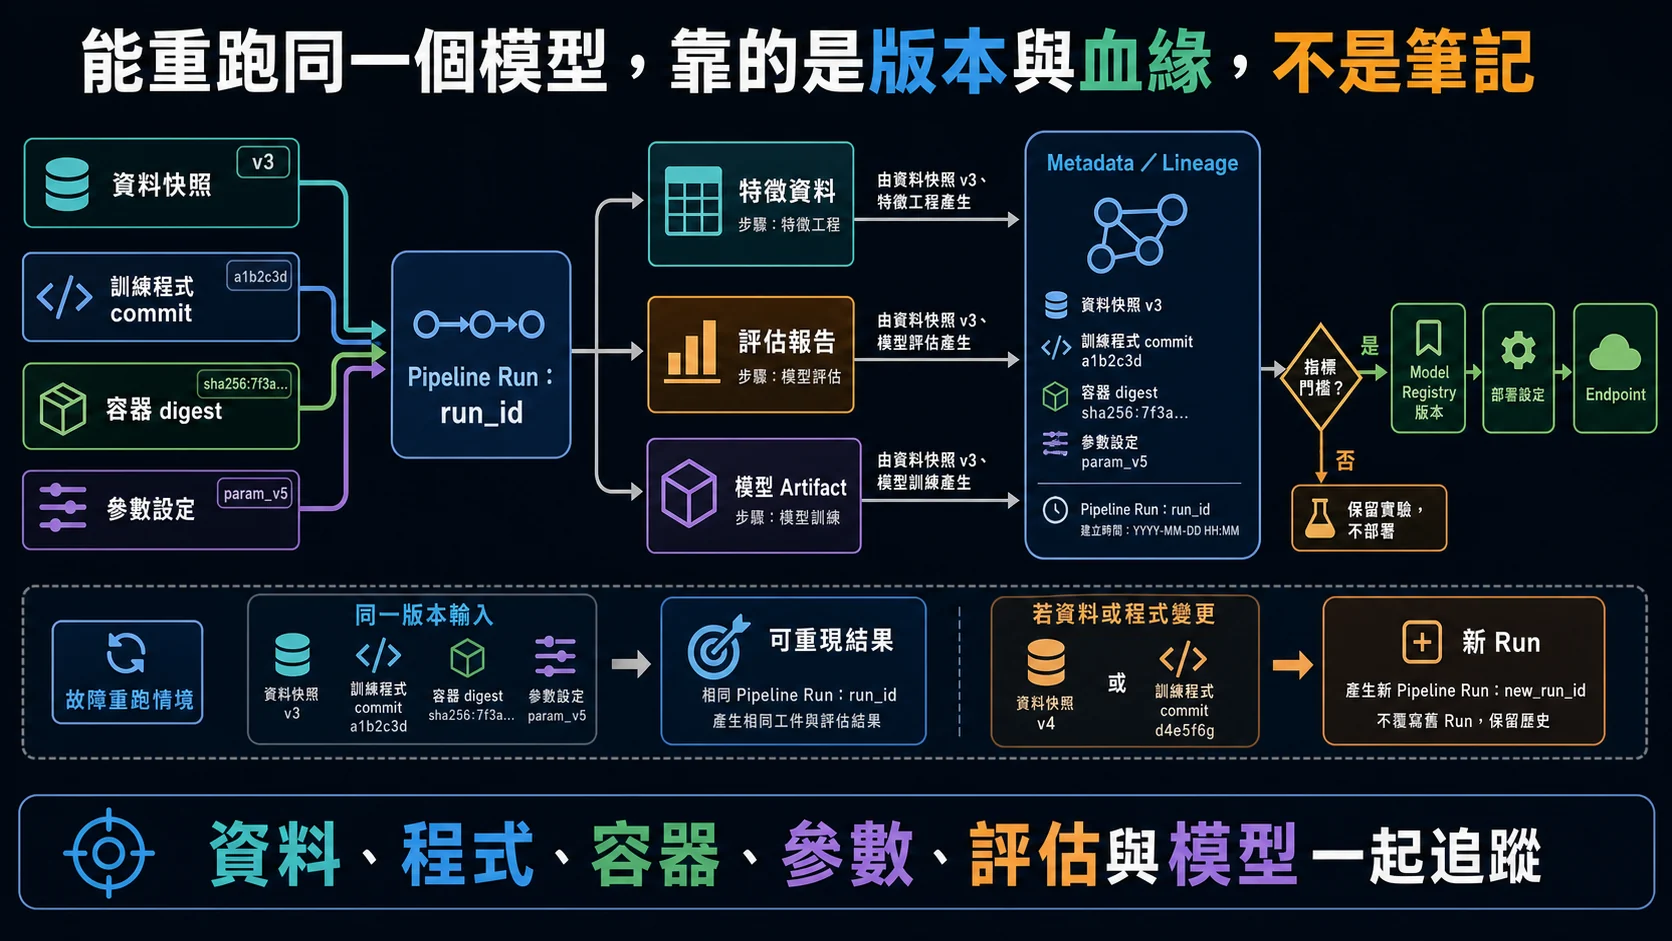
可重跑的 Pipeline 不只記錄步驟,還要固定資料、程式、容器、參數與環境;評估指標和模型版本連回同一次執行,才能回答「哪個輸入產生了目前部署的模型」。
Endpoint 與線上預測
把模型部署到 Agent Platform 的 endpoint 之後,就能透過 REST API 發即時預測請求了。Endpoint 支援:
- 流量分割 — 在多個模型版本之間分配流量(A/B 測試)
- 自動擴縮 — 根據請求量自動增減節點
- 模型監控 — 偵測資料漂移(Data Drift)與模型效能下降
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32}}}%%
flowchart TD
  RUN["Pipeline 固定資料快照、程式、<br/>容器、參數與評估結果"] --> QUALITY{"候選模型通過基線、<br/>安全與公平性門檻?"}
  QUALITY -->|"否"| STOP["停止發布並保留失敗 Run 的血緣"]
  QUALITY -->|"是"| REGISTER["登錄不可變模型版本"]
  REGISTER --> CANARY["先以 Shadow/Canary 流量<br/>比較延遲、錯誤與預測品質"]
  CANARY --> HEALTH{"線上指標正常?"}
  HEALTH -->|"否"| ROLLBACK["將流量切回前一穩定版本<br/>再分析輸入與模型差異"]
  HEALTH -->|"是"| PROMOTE["逐步提高流量並持續監控 Drift"]
PROMOTE --> RETRAIN["漂移或品質退化時觸發重訓評估"] 實作重點
- AutoML 影像分類每個標籤至少需要 10 張圖片,Google 建議每個標籤約 1,000 張訓練圖片
- 自訂訓練 Job 需指定容器映像檔,可使用 Google 預建容器或自訂 Docker 映像
- Endpoint 部署模型時,機器類型預設是
n1-standard-2(也能選e2-standard-2等其他機型);最少副本數必須是 1 以上,所以模型部署著就會計費、沒有請求也一樣,要停止計費得取消部署(預先發布版的 Scale To Zero 可在沒有流量時縮到 0 個副本) - 常見錯誤:Pipeline 中的元件未正確設定輸入 / 輸出的資料類型,導致 DAG 執行失敗
- 成本控制:開發階段使用較小的機器類型,驗證流程正確後再擴大規模
Lab 指引
Lab 連結:到 Google Skills 搜尋「Build and Deploy Machine Learning Solutions on Vertex AI」。截至 2026 年 10 月,目錄中找不到同名課程,可能已改版或下架。
延伸學習
- Gemini API 搭配 Agent Platform(原 Vertex AI)探索 GenAI — 在 Agent Platform 上使用最新的生成式 AI 模型
- BigQuery ML 建模實戰 — 用 SQL 快速建模的替代方案
- GCP GenAI 課程 — 動手呼叫 Gemini API 的完整教學
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
BigQuery ML 推論實戰
模型訓練好之後,怎麼對新資料做預測?比較 BigQuery ML 原生模型、匯入模型與遠端模型的用法。
Gemini API 搭配 Agent Platform(原 Vertex AI)探索 GenAI
想把 Gemini 接進自己的程式?先用圖形介面試提示,再看 API 怎麼處理文字與圖片。
BigQuery ML 建模實戰
資料已經在 BigQuery,能不能直接用 SQL 做預測?從建模、評估到預測,試一次 BigQuery ML。