
Cloud SQL for PostgreSQL 管理實作
課程概述
資料庫搬上雲端後,誰負責備份?應用要怎麼連線?主實例出問題時又怎麼辦?Cloud SQL 會接手一部分維運工作,但這些設定仍需要你決定。這篇以 PostgreSQL 為例,從建立實例開始,走過連線、備份和高可用設定。
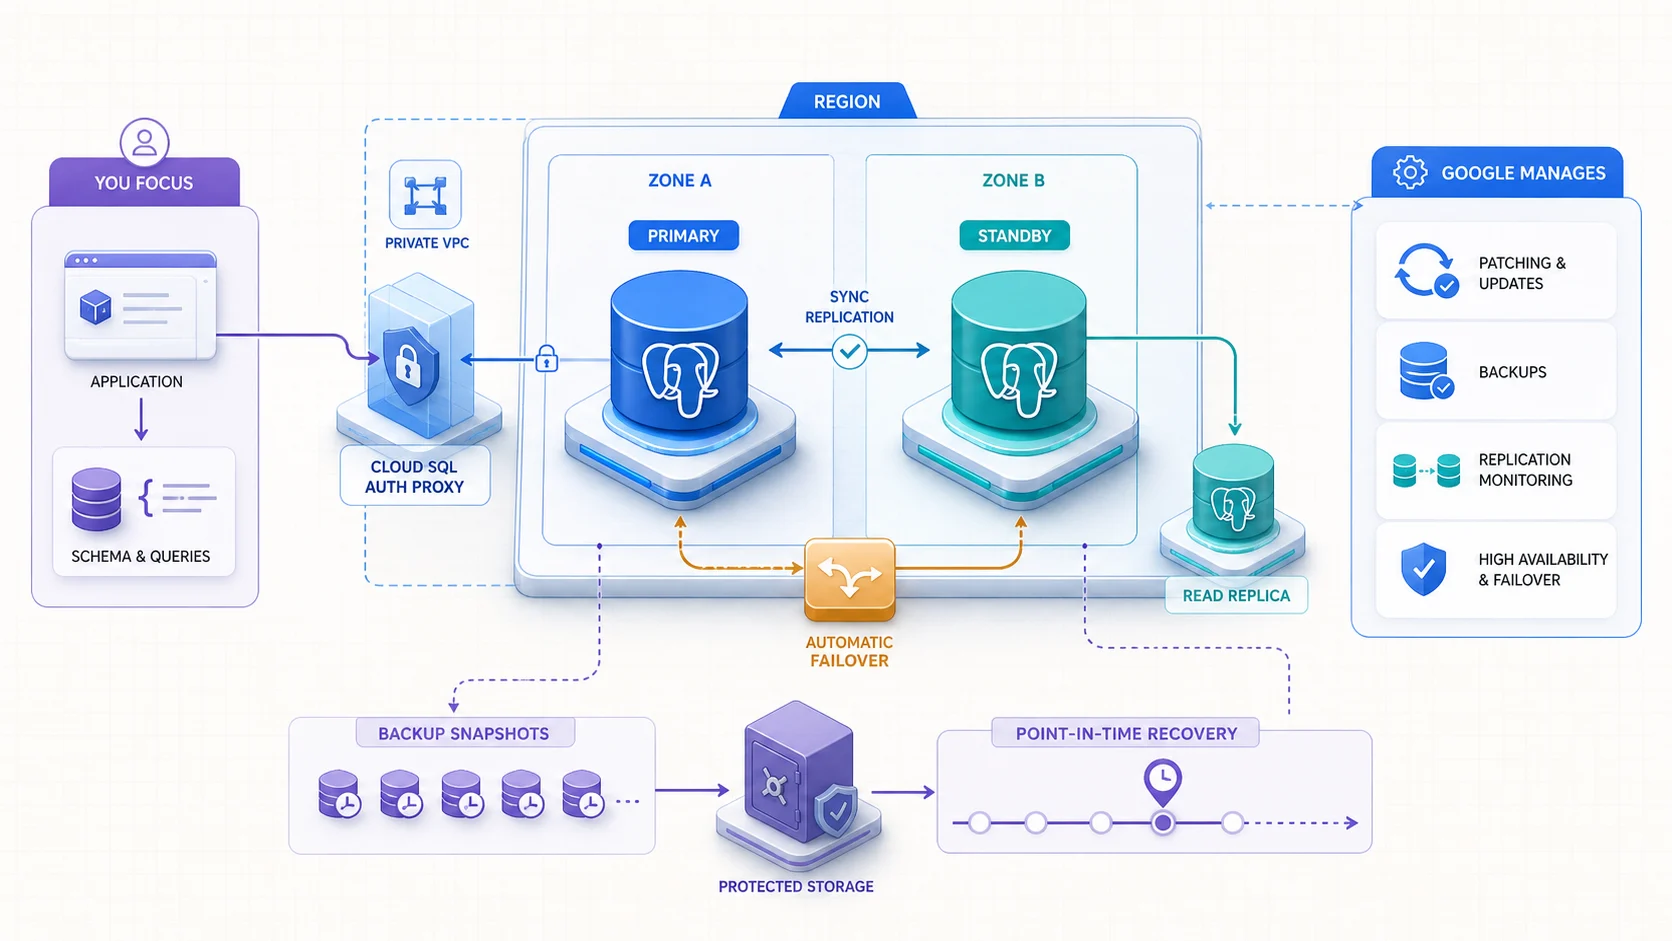
生產環境的四道保護:安全連線隔離存取、跨 Zone 同步複寫、自動容錯移轉,以及備份搭配時間點還原;讀取副本則另外承接唯讀流量。Google 管理修補、備份與切換,應用端專注在結構與查詢。
你將學到
- 透過 Cloud Console 與 gcloud CLI 建立 Cloud SQL for PostgreSQL 實例
- 使用 Cloud Shell 連線到資料庫並執行 SQL 查詢
- 設定自動備份與時間點還原(Point-in-time Recovery)
- 認識高可用性(HA)配置與容錯移轉機制(本文補充;官方課程的 Lab 練的是 Database Migration Service 遷移、連接應用程式、CMEK/pgAudit/IAM 資料庫驗證,以及時間點還原)
- 管理資料庫使用者與連線安全性
核心概念
Cloud SQL 的定位
Cloud SQL 是 Google Cloud 的受管關聯式資料庫服務。和在 Compute Engine 上自行架設 PostgreSQL 相比,平台會處理部分底層維護,也提供備份、高可用性等功能;但團隊仍要設定備份與復原目標、管理存取權限,並處理資料模型和查詢效能。
實例層級與效能
Cloud SQL 的機器類型很多,從開發用的 db-f1-micro,到生產用的高記憶體機型都有。挑的時候要看連線數上限、儲存空間 IOPS,還有 CPU / 記憶體需求。生產環境不要用共用核心機型:官方說明 db-f1-micro 與 db-g1-small 不在 Cloud SQL SLA 涵蓋範圍內,只適合低成本的測試與開發;專用核心要多少 vCPU 與記憶體,依負載測試決定(例如 db-custom-2-8192 是 2 vCPU/8 GB)。
高可用性架構
啟用 HA 後,Cloud SQL 會在同一區域的不同可用區(Zone)建一個備用實例。主要實例掛掉時,系統會自動切到備用實例;切換時既有連線會中斷,實例大約有 60 秒無法使用(實際時間依環境而異)。HA 大概會讓成本多一倍,但生產環境很需要它。
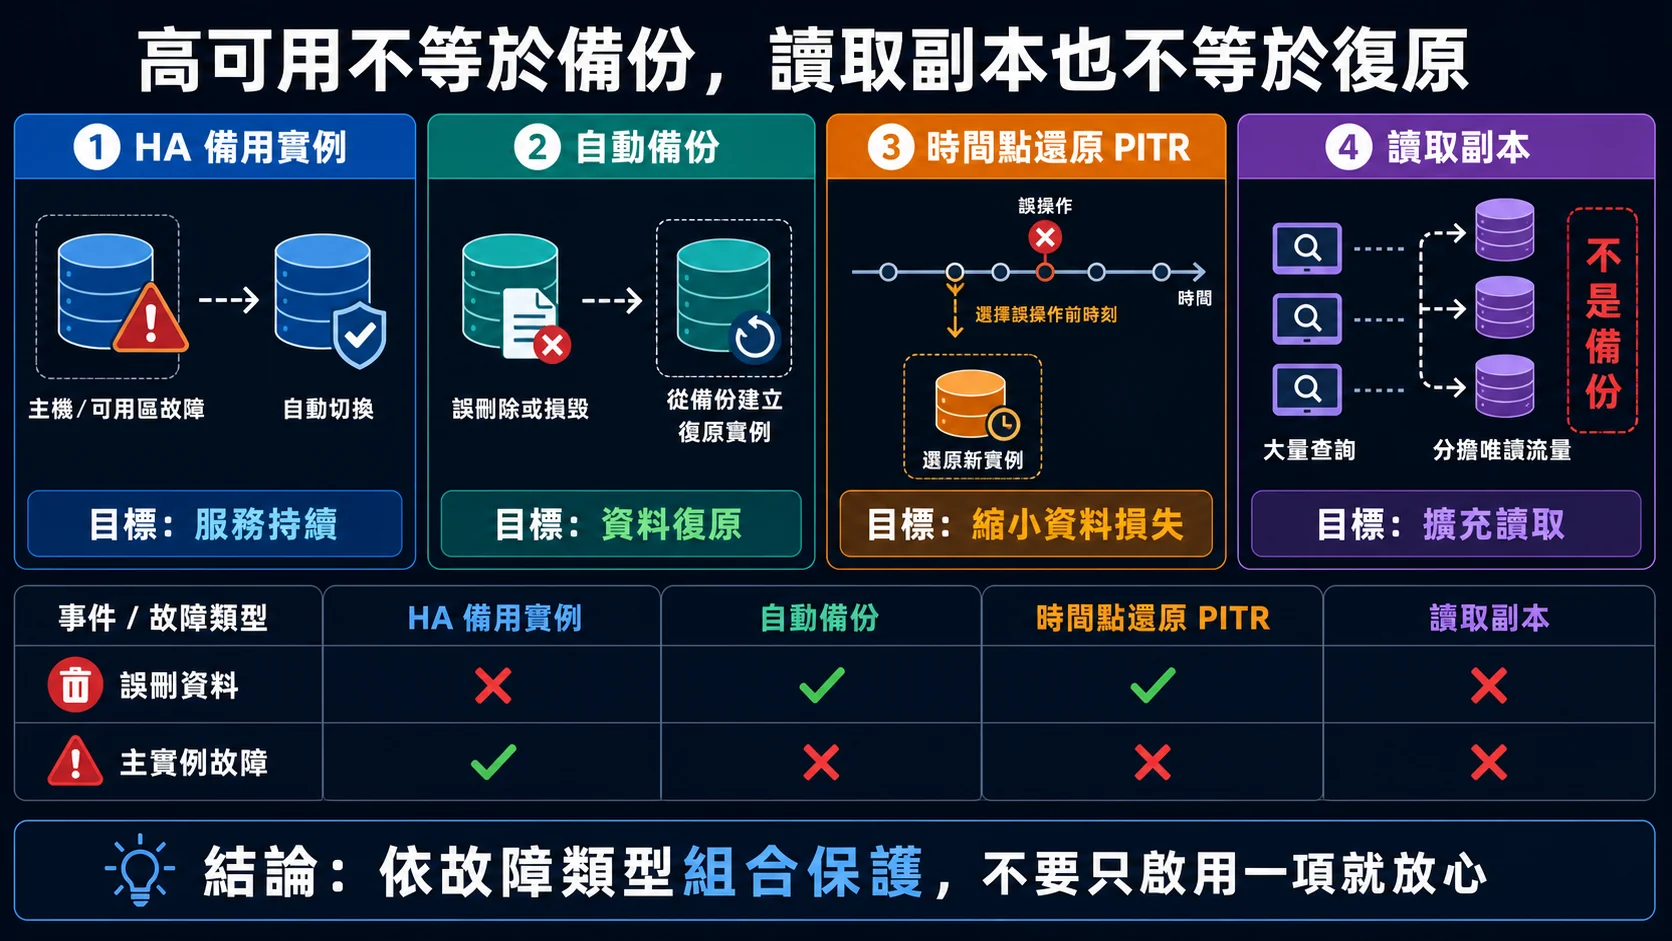
四種能力解決不同風險:HA 縮短基礎設施故障的停機時間,備份與 PITR 回復誤刪或錯誤寫入,讀取副本則擴充讀取能力;讀取副本不能取代備份或 HA。
連線方式
Cloud SQL 支援三種主要連線方式:
- Cloud SQL Auth Proxy — 走公有 IP 時,官方建議用 Cloud SQL connector(Auth Proxy 或語言連接器):自動加密並驗證身分,不必自己管 SSL 憑證
- 私有 IP — 經 private services access(VPC 對等互連)或 Private Service Connect 連線;官方基於安全建議優先採用,並搭配直接連線與強制 SSL
- 公有 IP + 授權網路 — 直接連公有 IP 時必須設定授權網路;官方把改用 Cloud SQL connector 列為更安全的替代做法
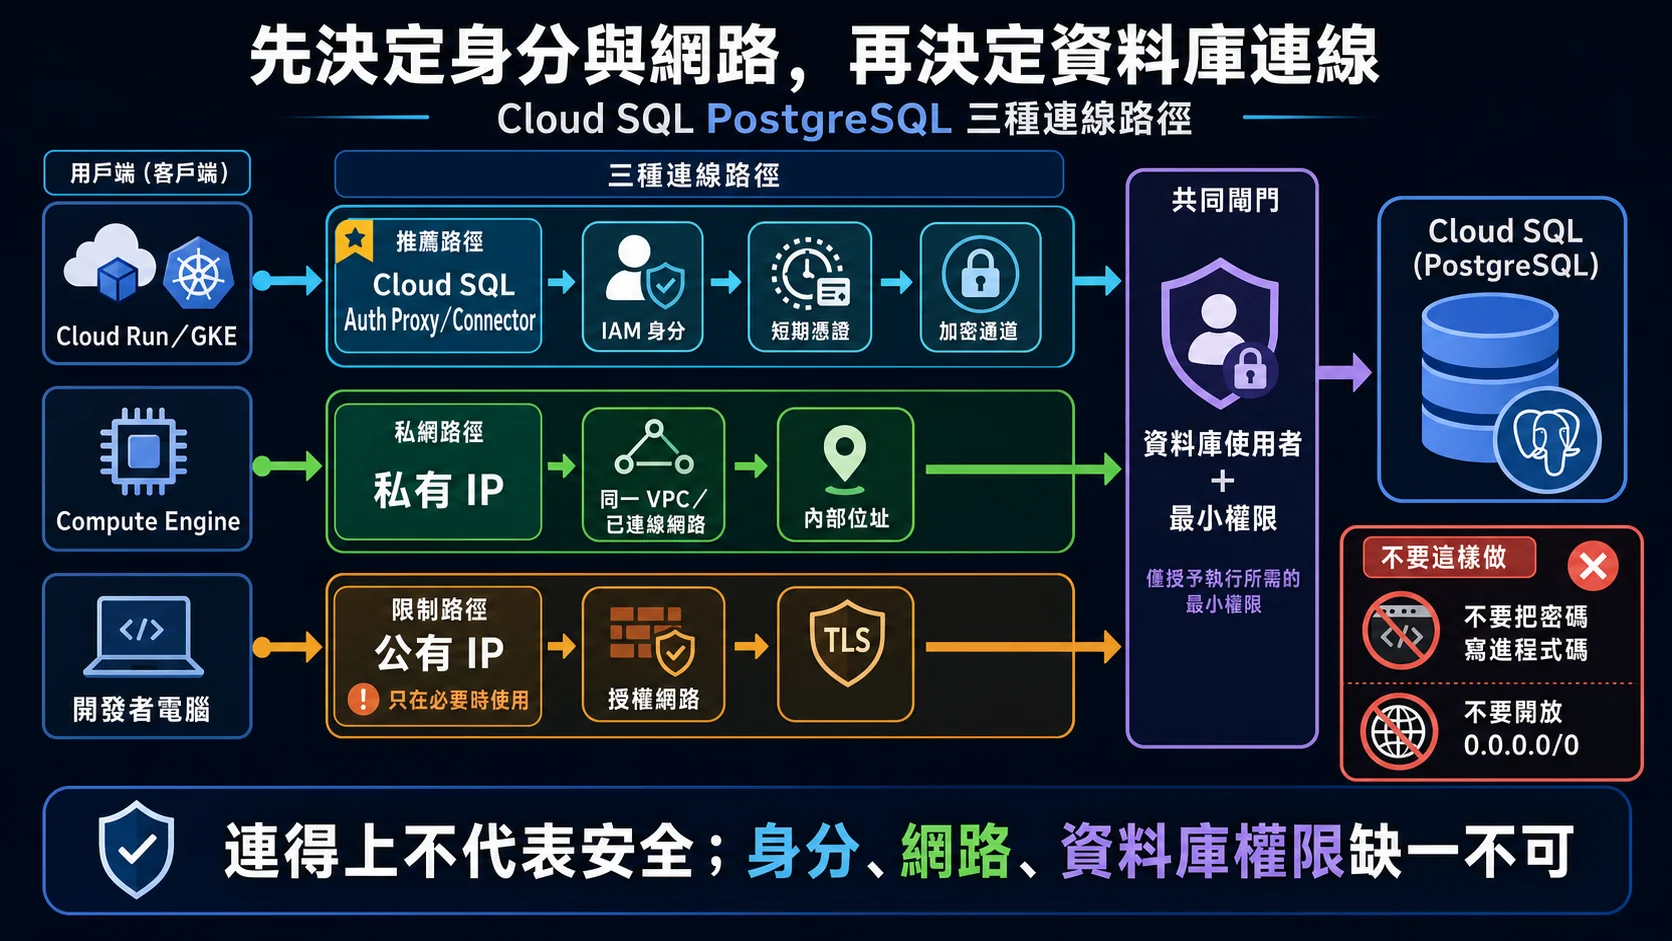
連線設計先分清楚身分與網路:Auth Proxy/Connector 負責 IAM 驗證與加密通道,私有 IP 把流量留在 VPC;若必須使用公有 IP,仍要限制授權網路並縮小資料庫權限。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32}}}%%
flowchart TD
  ALERT["先確認錯誤時間、影響範圍<br/>與最近的結構或設定變更"] --> EVENT{"主要事件類型?"}
  EVENT -->|"主要實例不可用"| HA["檢查 HA Failover 與應用重連<br/>不要把 Read Replica 當備援"]
  EVENT -->|"誤刪或錯誤寫入"| PITR["以 PITR 還原到新實例<br/>驗證資料後再切換連線"]
  EVENT -->|"唯讀查詢壓力"| REPLICA["建立或調整 Read Replica<br/>只分流可接受延遲的讀取"]
  EVENT -->|"只有應用連不上"| CONNECT["依序查 Auth Proxy/Connector、<br/>VPC、IAM、DB User 與連線數"]
  HA --> VERIFY["以應用健康檢查與資料一致性驗證恢復"]
  PITR --> VERIFY
  REPLICA --> VERIFY
CONNECT --> VERIFY 實作重點
- 建立實例時務必選擇與應用程式相同的區域,以降低網路延遲
- 使用
gcloud sql instances create指令可加入--database-version=POSTGRES_15指定版本 - 自動備份每天一次,預設保留最近 7 份(Enterprise edition,約 7 天;Enterprise Plus edition 是 15 份),可用
--retained-backups-count調整(1–365);--backup-start-time以 UTC 的 HH:MM 指定每日備份的開始時間,用來避開尖峰 - 常見錯誤:忘記在 Cloud SQL 實例上啟用所需的 flag(例如
cloudsql.enable_pgaudit) - 連線字串格式:
postgresql://USER:PASSWORD@HOST:5432/DATABASE
Skill Badge 指引
Lab 連結:Create and Manage Cloud SQL for PostgreSQL Instances — 完成此 lab 可獲得 Skill Badge
延伸學習
- BigQuery 搭配 Connected Sheets 分析 — 掌握另一種雲端資料分析方式
- 基礎 Data、ML 與 AI 任務 — 結合 Cloud SQL 的資料與 ML 工作流
- GCP ACE 課程:Compute Engine 基礎 — 了解 Cloud SQL 常搭配的運算服務
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
AppSheet 低程式碼應用開發
手上有一張試算表,想做成同事能填寫的 App?從 AppSheet 的資料、表單到權限一步步設定。
Gemini 提升 BigQuery 生產力
寫 SQL、看執行計畫、補欄位說明,哪些工作能請 Gemini 幫忙?整理 BigQuery 裡實用的用法和檢查點。
在 BigQuery 中使用 Gemini 模型
一整欄文字要分類或摘要,能直接在 BigQuery 裡做嗎?用 AI.GENERATE_TEXT 批次呼叫 Gemini。