
BigQuery ML 建模實戰
課程概述
已經會用 SQL 查 BigQuery 的資料,想做個簡單的預測模型,還得先把資料搬出去嗎?BigQuery ML 可以直接用 SQL 建模、評估和預測。這篇會走完第一個模型的流程,重點不只在指令能跑,還要看評估結果是否足以支持你的判斷。
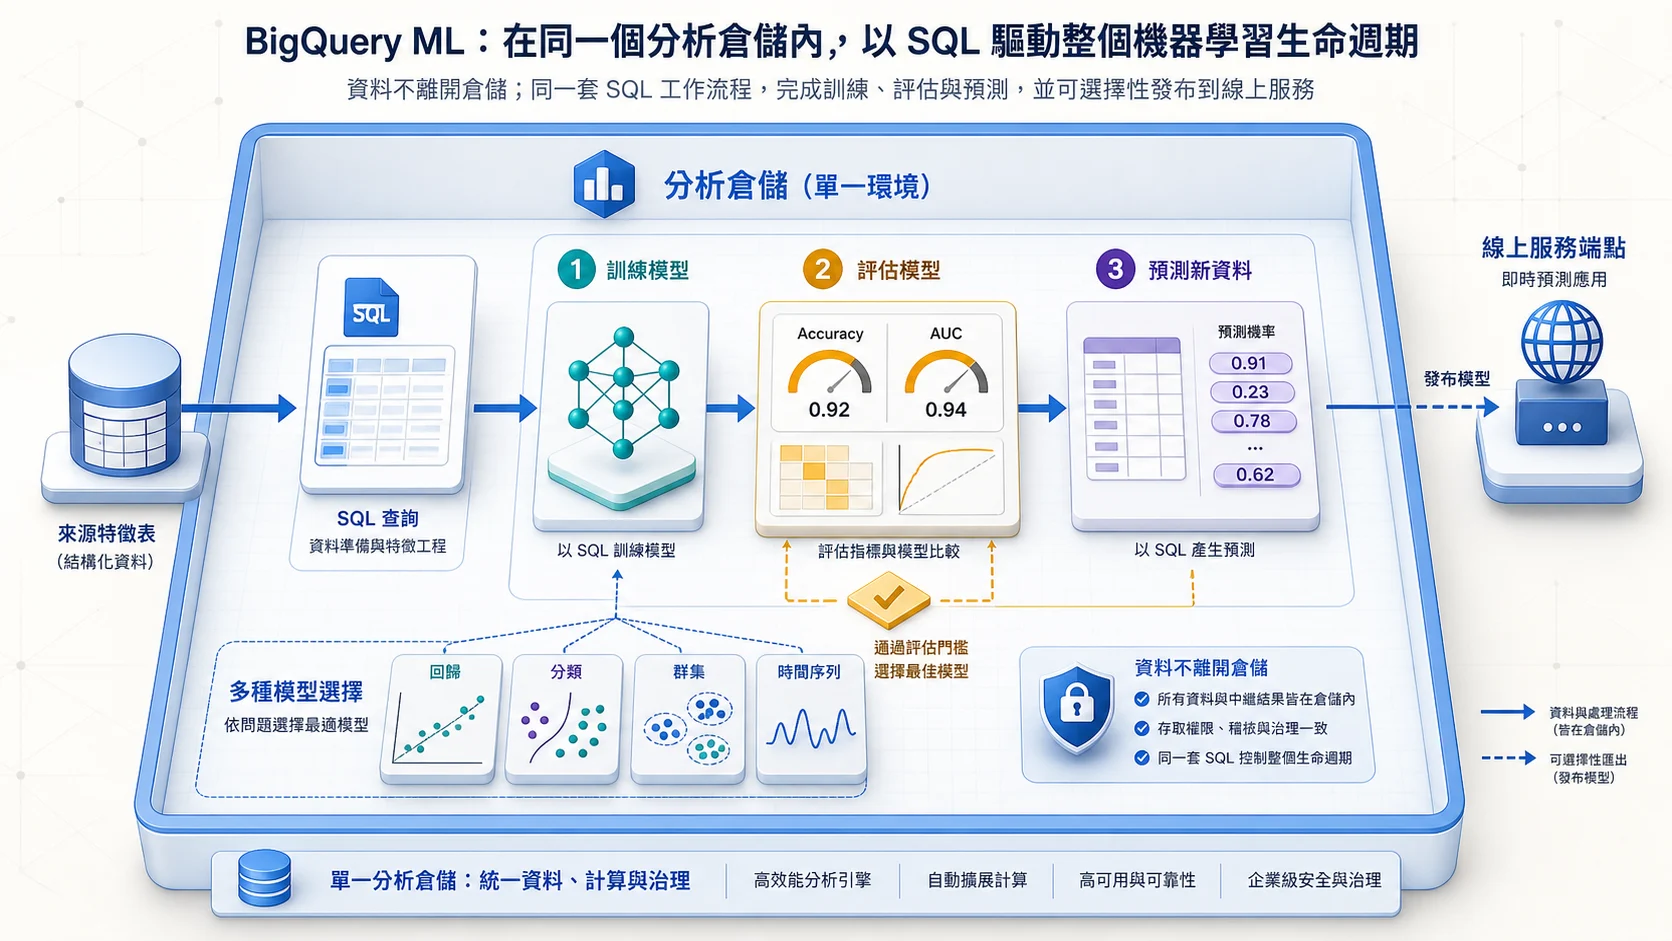
BQML 把訓練、評估與預測收進資料倉儲,讓同一套 SQL 工作流不必匯出資料。先依問題選模型,再以指標門檻判斷是否可用;只有需要線上低延遲服務時才把模型部署到端點。
你將學到
- 使用
CREATE MODEL語法建立線性迴歸與邏輯迴歸模型 - 使用
ML.EVALUATE評估模型效能指標 - 使用
ML.PREDICT對新資料進行預測 - 理解 BQML 支援的模型類型與適用場景
- 將 BQML 模型匯出至 Gemini Enterprise Agent Platform(簡稱 Agent Platform,原 Vertex AI)進行線上服務
核心概念
BigQuery ML 的定位
傳統 ML 工作流要走這幾步:匯出資料 → 預處理 → 選框架 → 訓練 → 評估 → 部署。BQML 把這一整串都收進 BigQuery,全用 SQL 搞定。哪些人特別適合用它?
- 熟悉 SQL 但不熟悉 Python 的資料分析師
- 需要快速驗證 ML 想法的資料科學家
- 想在不搬移資料的情況下建立模型的團隊
支援的模型類型
| 模型類型 | SQL 關鍵字 | 典型場景 |
|---|---|---|
| 線性迴歸 | LINEAR_REG | 預測銷售額、溫度 |
| 邏輯迴歸 | LOGISTIC_REG | 客戶流失預測、垃圾郵件分類 |
| K-Means 聚類 | KMEANS | 客戶分群、異常偵測 |
| XGBoost | BOOSTED_TREE_CLASSIFIER/REGRESSOR | 高精確度分類與迴歸 |
| DNN | DNN_CLASSIFIER/REGRESSOR | 複雜非線性關係 |
| ARIMA Plus | ARIMA_PLUS | 時間序列預測 |
| 匯入模型 | TENSORFLOW | 使用自訓練 TF 模型 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
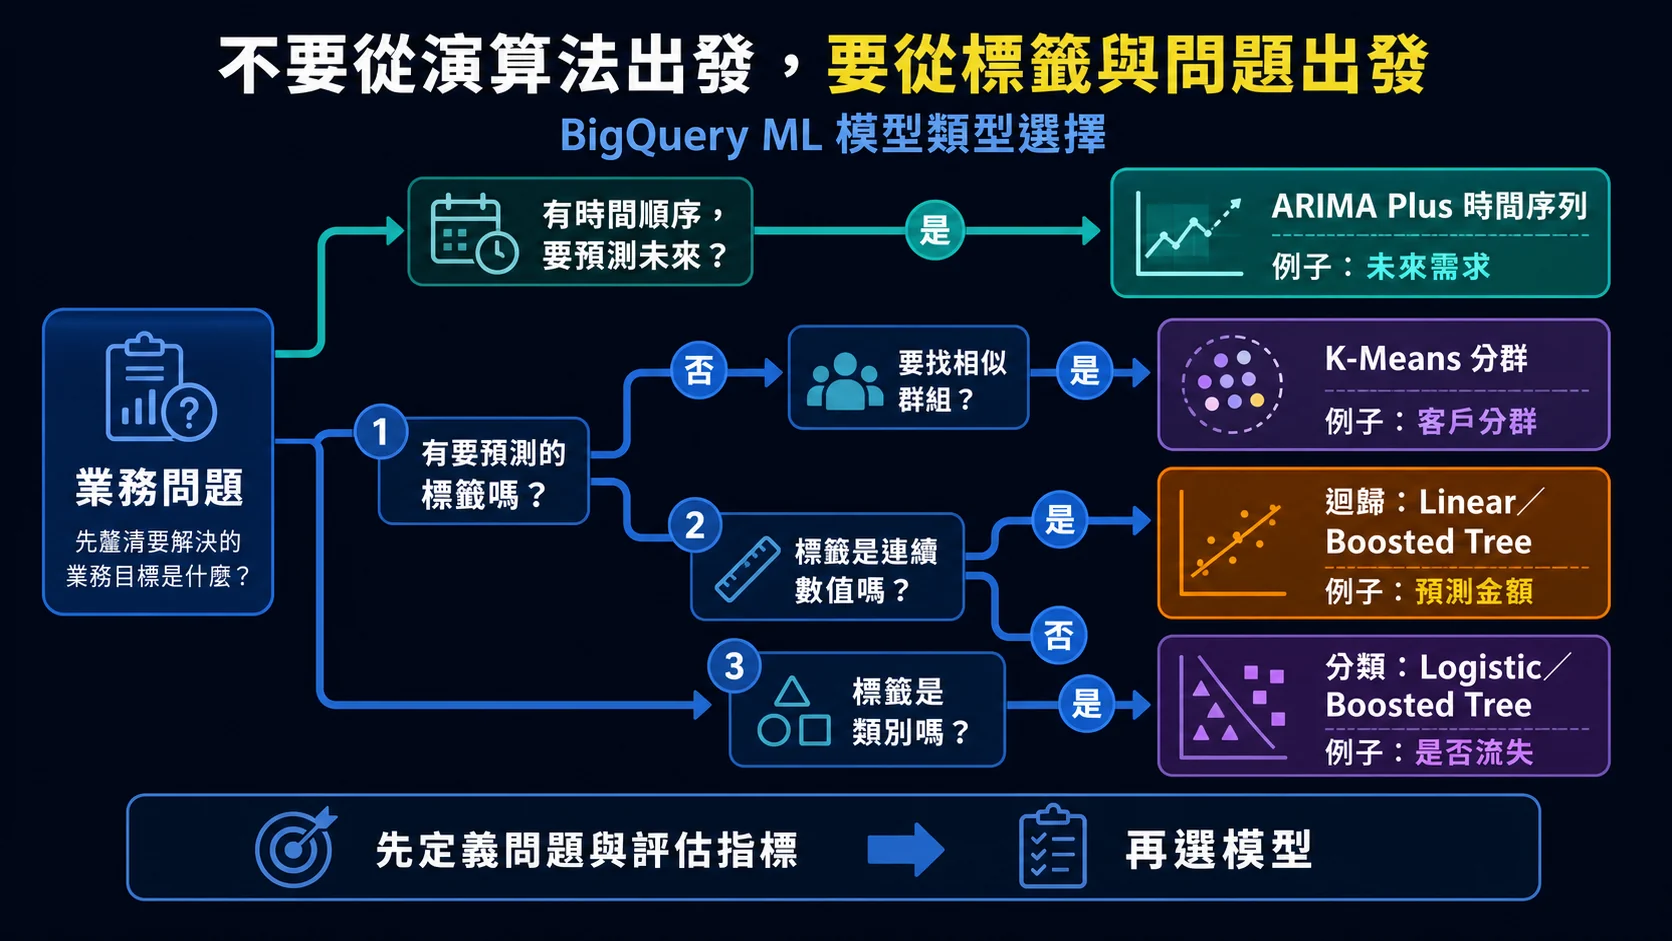
模型選擇從問題定義開始:沒有標籤可考慮分群;有標籤時再看預測目標是類別、連續數值或時間序列,最後才比較各演算法的精度、成本與可解釋性。
建模流程
-- Step 1: 建立模型
CREATE OR REPLACE MODEL `dataset.my_model`
OPTIONS(model_type='LOGISTIC_REG', input_label_cols=['label'])
AS SELECT * FROM `dataset.training_data`;

-- Step 2: 評估模型
SELECT * FROM ML.EVALUATE(MODEL `dataset.my_model`);

-- Step 3: 預測
SELECT * FROM ML.PREDICT(MODEL `dataset.my_model`,
  (SELECT * FROM `dataset.new_data`));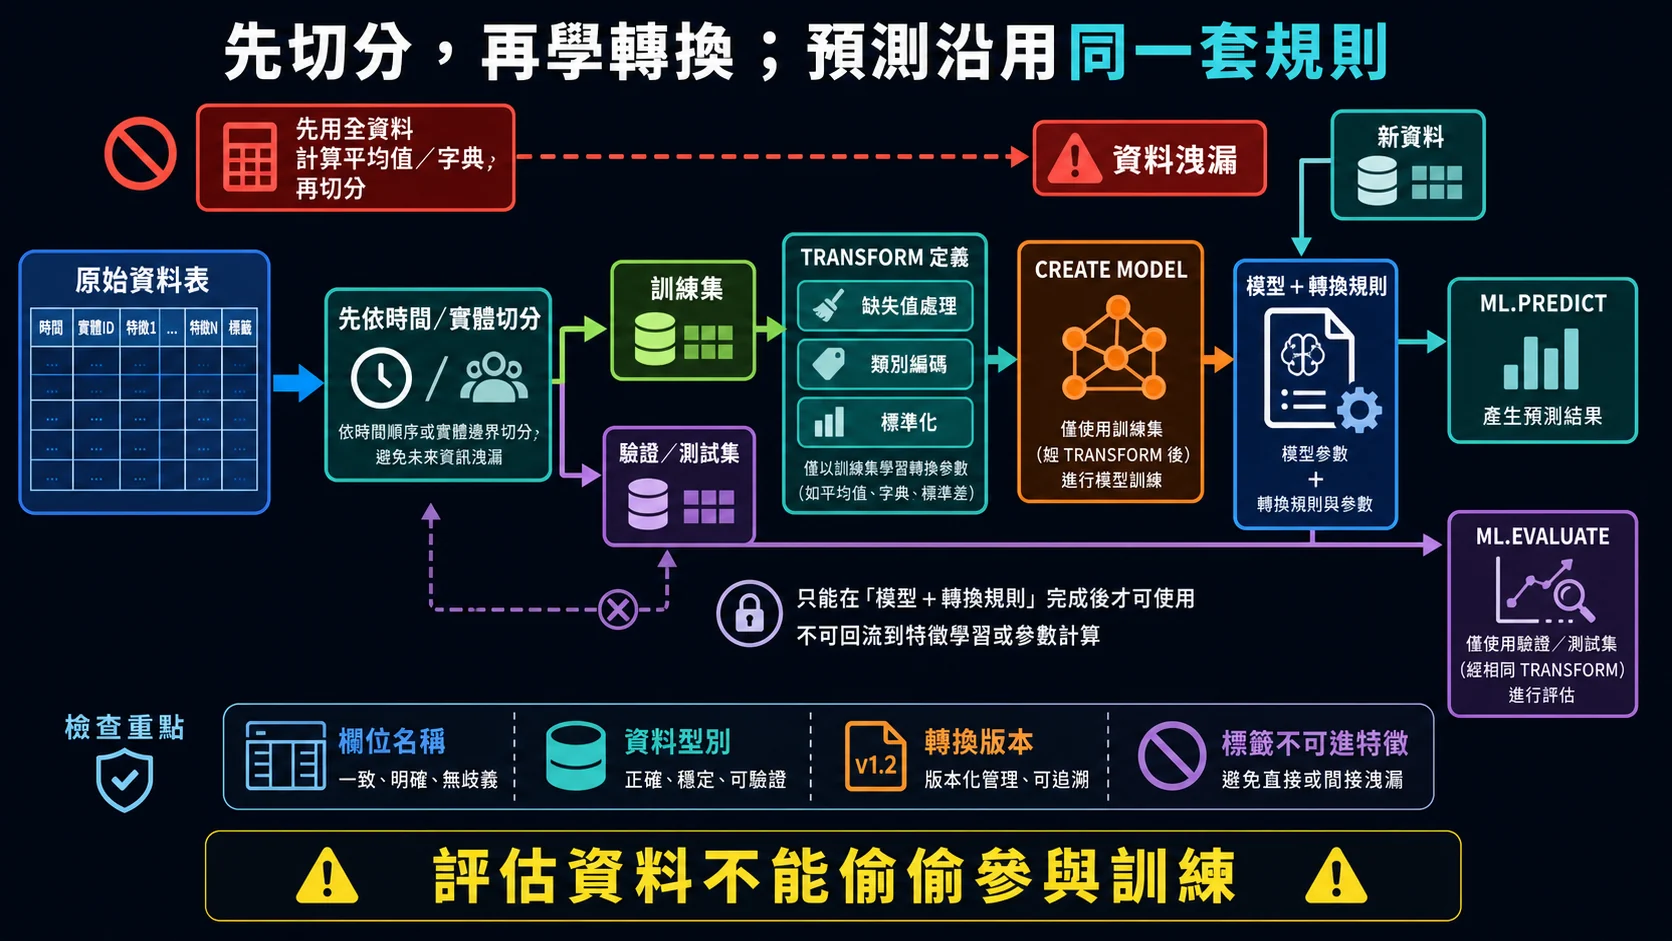
正確順序是先切分資料,再讓特徵轉換只從訓練集學習;把轉換寫進模型可在評估與預測時一致套用,避免測試資訊洩漏,也避免線上特徵與訓練特徵不一致。
模型評估指標
- 迴歸模型:關注
mean_squared_error(越低越好)和r2_score(越接近 1 越好) - 分類模型:關注
accuracy、precision、recall和f1_score - AUC-ROC:邏輯迴歸的核心指標,0.5 表示隨機猜測,1.0 表示完美分類
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32}}}%%
flowchart TD
  GOAL["定義預測目標、業務基線<br/>與可接受指標"] --> TRAIN["按時間/實體切分資料,<br/>以 TRANSFORM 固定特徵後訓練"]
  TRAIN --> GATE{"ML.EVALUATE 是否優於基線,<br/>且沒有資料洩漏?"}
  GATE -->|"否"| REVISE["回查標籤、特徵、切分方式<br/>與模型類型後重新訓練"]
  GATE -->|"是"| DELIVERY{"預測結果如何被使用?"}
  DELIVERY -->|"排程或大批資料"| BATCH["以 ML.PREDICT 寫入結果表"]
  DELIVERY -->|"線上低延遲請求"| ONLINE["登錄或匯出模型<br/>並部署到 Agent Platform<br/>的 endpoint"]
  BATCH --> MONITOR["監控資料分佈、預測品質與成本"]
ONLINE --> MONITOR 實作重點
CREATE MODEL語句會啟動訓練 Job,大型資料集可能需要數分鐘到數十分鐘- 用
TRANSFORM子句可以在建模時一併把特徵工程定義好,這樣預測時就會自動套同一套轉換,不會兩邊兜不起來 - 想知道模型用了哪些特徵、各特徵的統計值(最小、最大、平均、類別數、NULL 數),用
ML.FEATURE_INFO看;它不會告訴你哪個特徵比較重要,boosted tree 與 random forest 模型的特徵重要性要用ML.FEATURE_IMPORTANCE - 常見的雷:類別資訊如果是用數字編碼的(例如 0/1/2 代表三種分類),BQML 會把它誤當成連續數值特徵,要先
CAST成 STRING,它才會當類別特徵去做 one-hot 編碼 - 成本提醒:on-demand 計價下,BQML 訓練按處理的資料量計費,但建立模型的單價和一般查詢不同——線性迴歸、邏輯迴歸、K-means、時間序列等模型在 us-central1 是每 TiB $312.50(一般查詢是 $6.25),評估與預測才比照一般查詢;建議先用小資料集測試查詢邏輯
Skill Badge 指引
Lab 連結:Create ML Models with BigQuery ML — 完成此 lab 可獲得 Skill Badge
延伸學習
- Agent Platform(原 Vertex AI)機器學習解決方案 — 當你需要更多彈性,可以看看 Agent Platform 這個功能更完整的平台
- BigQuery ML 推論實戰 — 想再進一步玩 BQML 的進階推論技巧,看這篇
- 在 BigQuery 中使用 Gemini 模型 — 結合 BQML 與 Gemini 大語言模型
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
BigQuery ML 推論實戰
模型訓練好之後,怎麼對新資料做預測?比較 BigQuery ML 原生模型、匯入模型與遠端模型的用法。
在 BigQuery 中使用 Gemini 模型
一整欄文字要分類或摘要,能直接在 BigQuery 裡做嗎?用 AI.GENERATE_TEXT 批次呼叫 Gemini。
Gemini 提升 BigQuery 生產力
寫 SQL、看執行計畫、補欄位說明,哪些工作能請 Gemini 幫忙?整理 BigQuery 裡實用的用法和檢查點。