
基礎 Data、ML 與 AI 任務
課程概述
資料從哪裡進來、要怎麼整理,最後又由誰查詢?這篇用三個小任務回答:在 BigQuery 查資料、用 Dataflow 處理資料流,再用 Speech-to-Text 把語音轉成文字。三個工具各做各的事,先認清它們的位置,後面學更大的資料流程會比較好接。
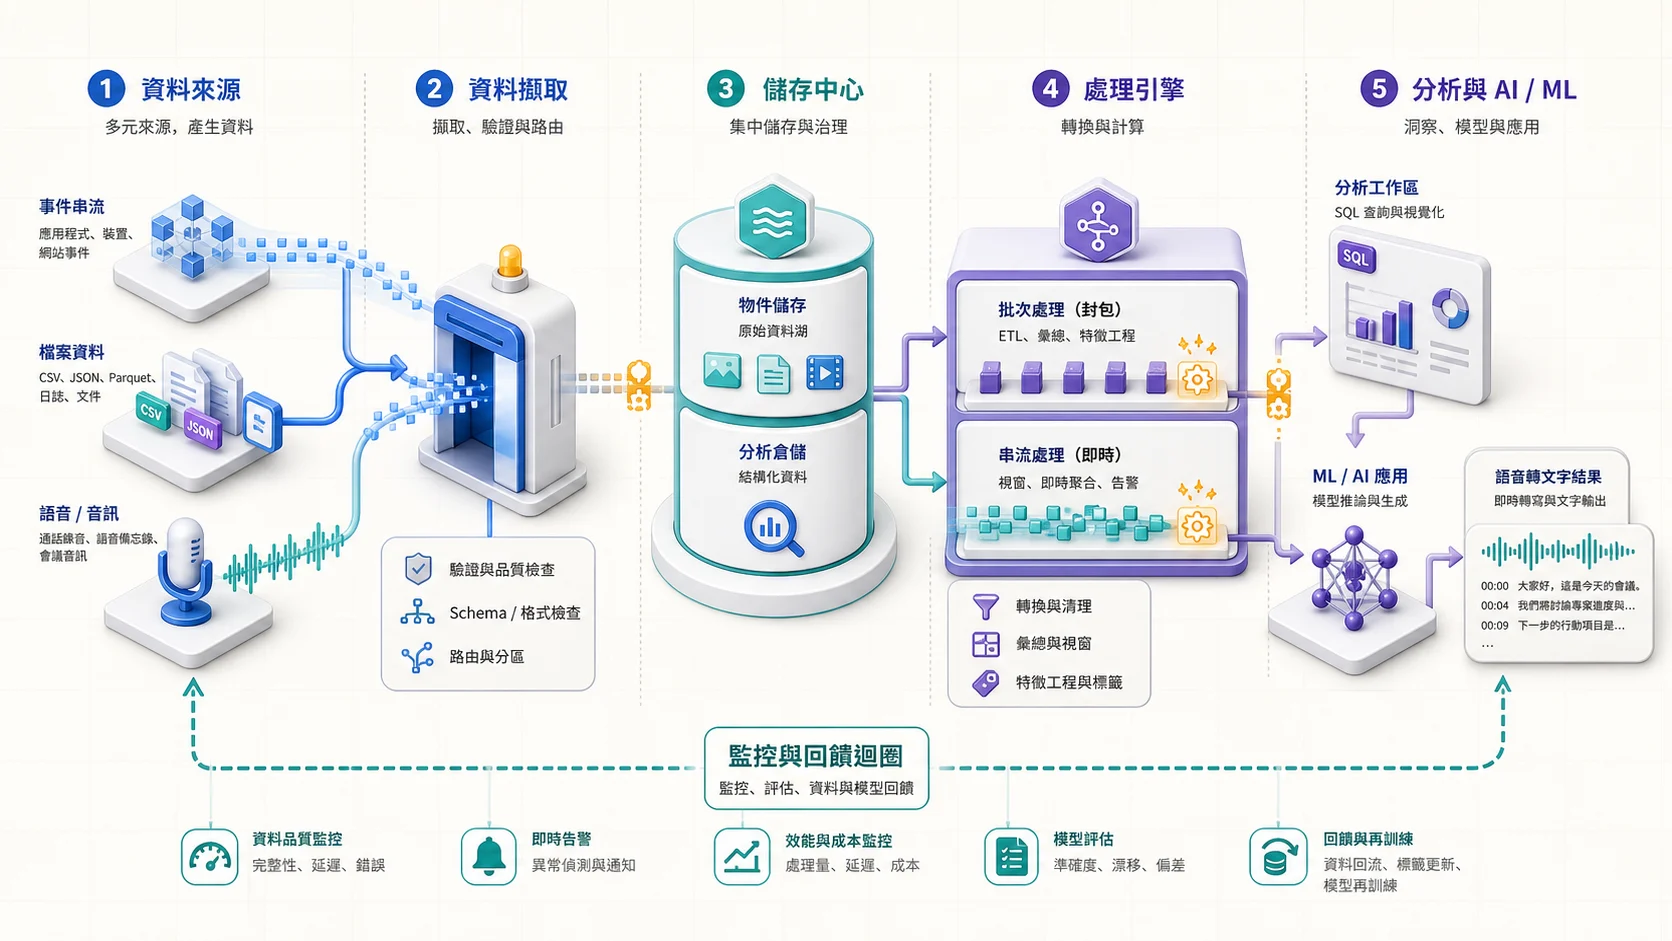
從來源、擷取、儲存、處理到分析與 AI,每一階段解一個不同問題;Dataflow 同時承接有界批次與無界串流,BigQuery 負責分析,預訓練 API 與模型把整理後的資料轉成應用結果。
你將學到
- 在 BigQuery 中執行 SQL 查詢並分析公開資料集
- 使用 Dataflow 建立批次與串流資料處理管線
- 呼叫 Cloud Speech-to-Text API 進行語音辨識
- 理解 Google Cloud 資料生命週期的各階段
- 選擇正確的服務來匹配不同的資料處理需求
核心概念
Google Cloud 資料生命週期
Google Cloud 的資料處理,走的是一條很清楚的生命週期:
- 擷取(Ingest) — Pub/Sub、Cloud Storage、Transfer Service
- 儲存(Store) — Cloud Storage、BigQuery、Cloud SQL、Bigtable
- 處理(Process) — Dataflow、Managed Service for Apache Spark(原 Dataproc)、Cloud Run functions(原 Cloud Functions)
- 分析(Analyze) — BigQuery、Looker、Connected Sheets
- ML/AI — Gemini Enterprise Agent Platform(原 Vertex AI)、AutoML、預訓練 API
BigQuery 基礎
BigQuery 是無伺服器架構,你不用管叢集、也不用自己調容量。它用的是列式儲存(Columnar Storage)格式,跑分析型查詢特別快:
- 公開資料集 — BigQuery 代管多個公開資料集,包含氣象、GitHub 活動、維基百科等;儲存費由 Google 負擔,你只付查詢費用(每月前 1 TiB 免費)
- GoogleSQL(原 Standard SQL) — BigQuery 支援 ANSI SQL:2011 標準,熟悉 SQL 的人可以直接上手
- 巢狀與重複欄位 — BigQuery 支援 STRUCT 和 ARRAY 類型,適合半結構化資料
Dataflow 與 Apache Beam
Dataflow 是 Google Cloud 的全代管資料處理服務,基於 Apache Beam SDK:
- 批次模式 — 處理有界(Bounded)資料集,例如每日 ETL
- 串流模式 — 處理無界(Unbounded)資料流,例如即時事件處理
- 自動擴縮 — Dataflow 會根據資料量自動調整 worker 數量
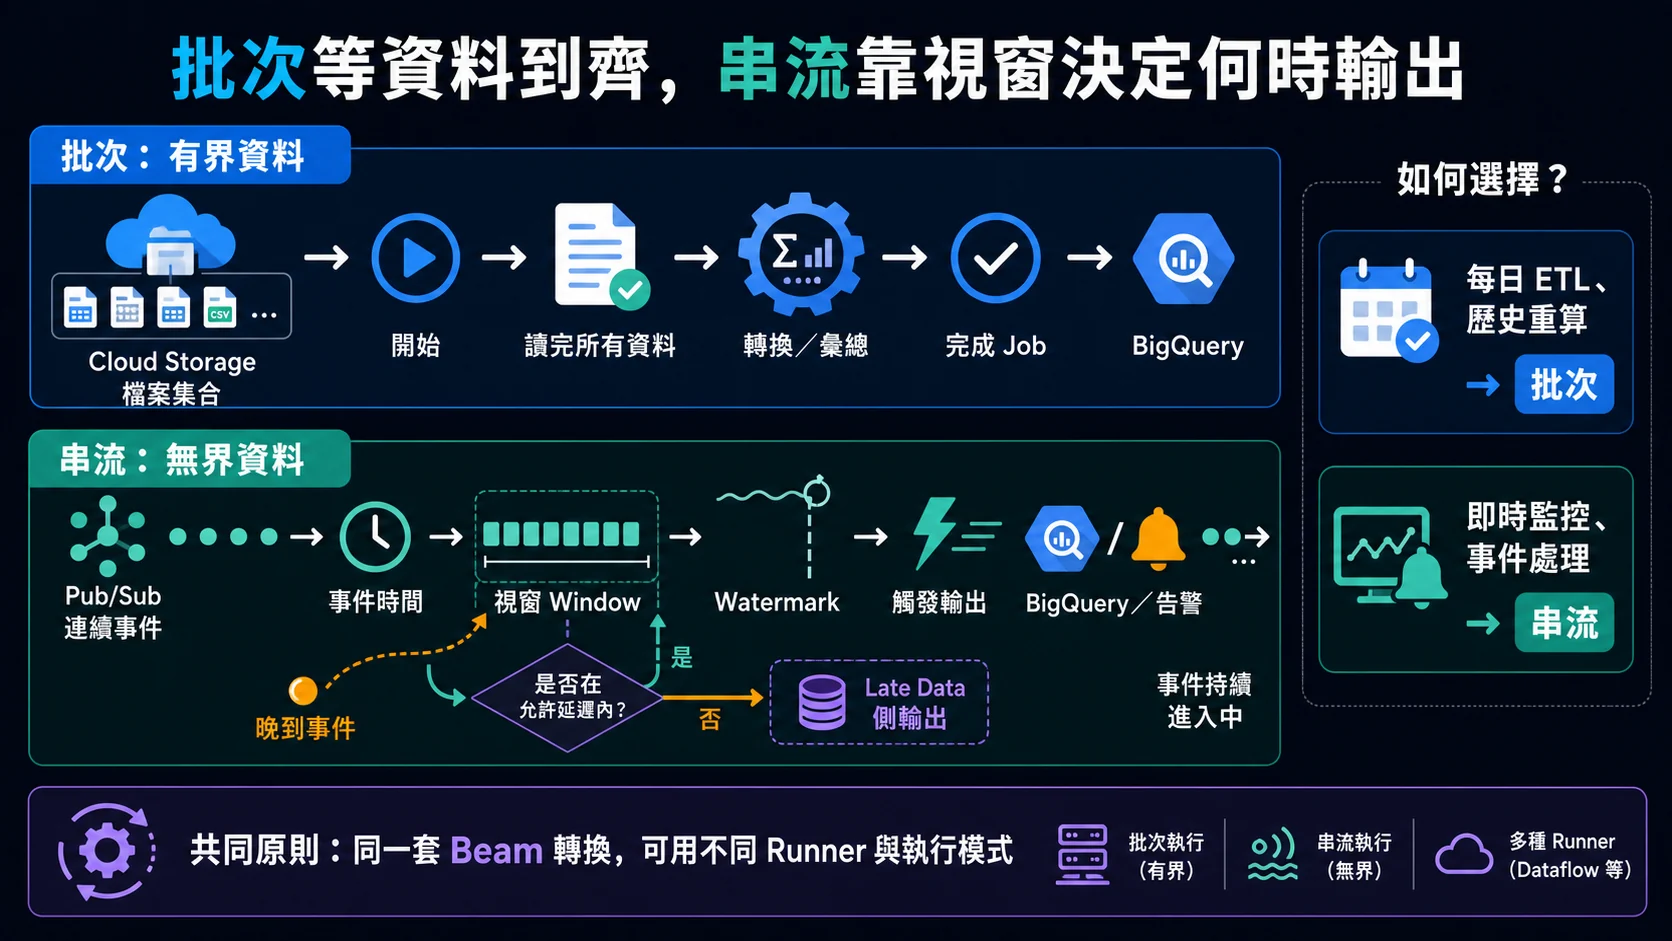
批次管線等資料範圍確定後處理;串流管線面對持續到達、甚至亂序的事件,必須定義視窗、水位線與延遲資料處理方式,才能決定何時輸出及是否更新結果。
Cloud Speech-to-Text API
Speech-to-Text API 將語音轉換為文字,支援超過 125 種語言:
- 同步辨識 — 短音訊(< 1 分鐘)即時回傳結果
- 非同步辨識 — 長音訊(最長 480 分鐘)背景處理
- 串流辨識 — 即時語音辨識,適合即時字幕場景
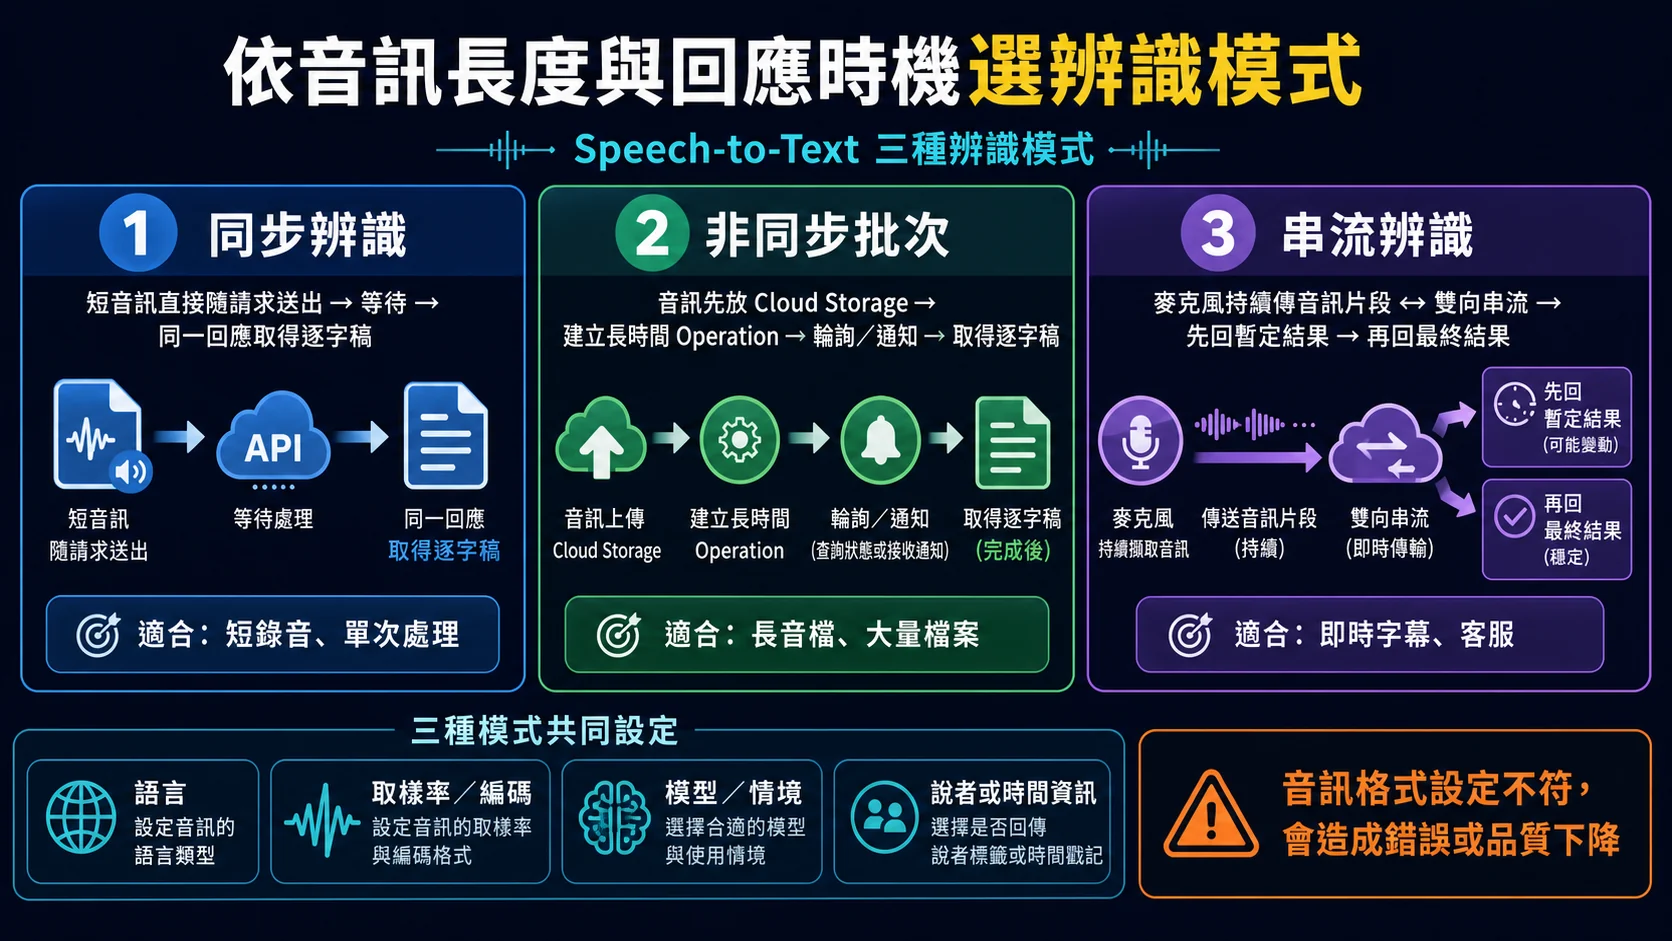
選擇辨識模式時先看輸入是否持續到達、音訊長度及回應延遲:短檔案可同步取得結果,長檔案交給非同步工作,麥克風或即時字幕則使用串流連線。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 24, "rankSpacing": 32}}}%%
flowchart TD
  NEED["先確認資料來源、是否持續到達<br/>以及結果需要多快產生"] --> INPUT{"主要輸入型態?"}
  INPUT -->|"資料倉儲中的結構化資料"| BQ["BigQuery SQL<br/>互動分析與大規模彙總"]
  INPUT -->|"有界檔案或每日 ETL"| BATCH["Dataflow Batch<br/>處理完整資料範圍"]
  INPUT -->|"持續事件流"| STREAM["Pub/Sub + Dataflow Streaming<br/>定義 Window、Watermark 與延遲資料"]
  INPUT -->|"音訊"| AUDIO{"輸入與回應方式?"}
  AUDIO -->|"短檔、同步回應"| SYNC["Speech-to-Text 同步辨識"]
  AUDIO -->|"長檔、背景工作"| ASYNC["非同步辨識"]
AUDIO -->|"麥克風/即時字幕"| LIVE["串流辨識"] 實作重點
- 想先看資料長相,不要跑查詢:用資料表的「預覽」分頁或
bq head --max_rows=10 dataset.table,兩者都不收費;SELECT * … LIMIT 10在非叢集資料表上仍會讀完整張表、照全表計費。真的要用查詢抽樣時,只選需要的欄位,或對大型資料表加上TABLESAMPLE SYSTEM (10 PERCENT)(預先發布版)只讀部分資料區塊 - Dataflow 的 Job 需要指定暫存位置(
--temp_location gs://bucket/temp) - Speech-to-Text 支援多種音訊格式:FLAC、WAV、MP3、OGG
- 常見錯誤:Dataflow Job 因 IAM 權限不足而失敗,需確認服務帳戶有
dataflow.worker角色 - 成本控制技巧:BigQuery 查詢前先使用 dry run 估算掃描量(
--dry_runflag)
Skill Badge 指引
Lab 連結:Prepare Data for ML APIs on Google Cloud(原名 Perform Foundational Data, ML, and AI Tasks in Google Cloud)— 完成此 lab 可獲得 Skill Badge。課程已改版:舊版涵蓋 BigQuery,現行課綱為 Dataprep、Dataflow、Apache Spark 叢集作業,以及 Natural Language、Speech-to-Text、Video Intelligence 三種 ML API,不含本文的 BigQuery 查詢部分
延伸學習
- BigQuery 搭配 Connected Sheets 分析 — 用 Sheets 探索 BigQuery 資料
- BigQuery ML 建模實戰 — 直接在 BigQuery 中建立 ML 模型
- 使用 Google Cloud ML API — 再多認識幾個預訓練 ML API
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
Gemini 提升 BigQuery 生產力
寫 SQL、看執行計畫、補欄位說明,哪些工作能請 Gemini 幫忙?整理 BigQuery 裡實用的用法和檢查點。
在 BigQuery 中使用 Gemini 模型
一整欄文字要分類或摘要,能直接在 BigQuery 裡做嗎?用 AI.GENERATE_TEXT 批次呼叫 Gemini。
BigQuery ML 推論實戰
模型訓練好之後,怎麼對新資料做預測?比較 BigQuery ML 原生模型、匯入模型與遠端模型的用法。