
Cloud Spanner 何時比 Cloud SQL 合適?
前言
Cloud SQL 能處理很多關聯式資料庫需求;但如果資料要跨區域服務使用者,還得維持交易一致性,架構就會複雜得多。Spanner 是這類需求的候選之一,代價是資料模型、主鍵和成本都需要重新評估。
如果還不熟 Cloud SQL,可以先看 GCP-108:Cloud SQL。這篇會從兩者的取捨出發,再談 Spanner 的容量配置、主鍵設計與多區域選項。
這是 ACE 進階系列第 13 課,我們會把 Spanner 的架構設計和實際操作好好談一遍。
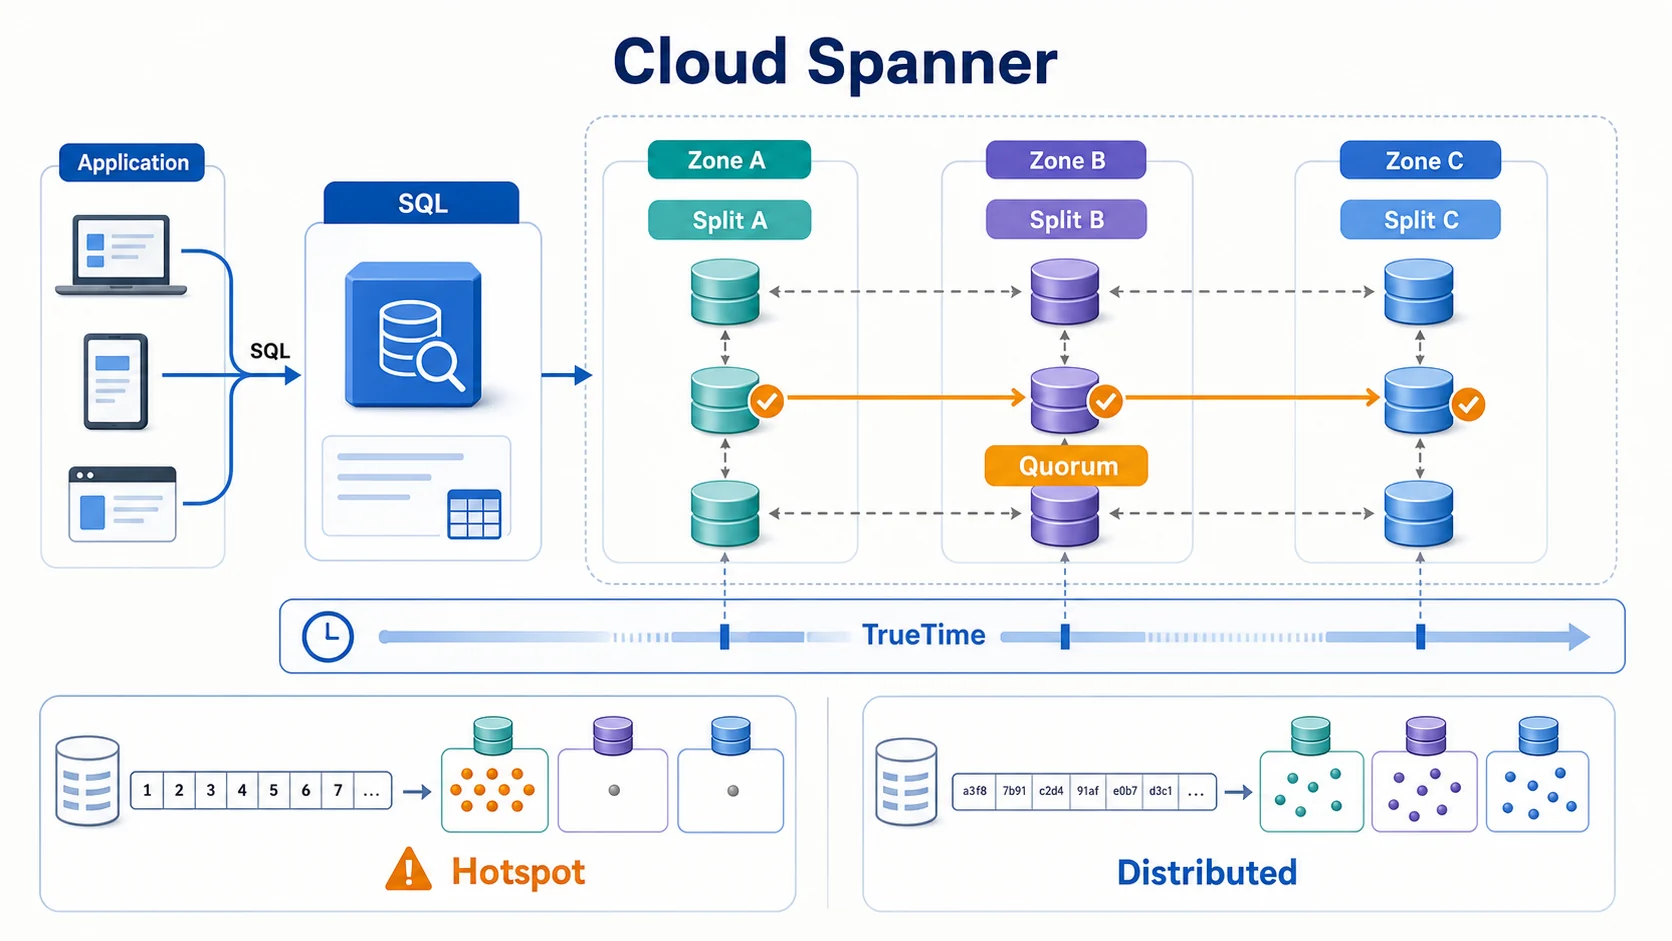
Spanner 把 SQL、交易一致性與水平分片放進同一套系統:資料依主鍵範圍拆成 Split,複本跨故障邊界同步並以 Quorum 提交,TrueTime 則協助建立外部一致的交易順序。主鍵若持續遞增,新增資料會集中到同一個 Split;UUID、雜湊前綴或反轉序列能把寫入打散。
什麼是 Cloud Spanner?
Spanner 是 Google 自研的全球分散式關聯資料庫,同時具備:
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart LR
  SPANNER["Cloud Spanner"] --> REL["關聯式資料庫能力"]
  SPANNER --> DIST["分散式資料庫能力"]
  REL --> SQL["GoogleSQL/PostgreSQL 方言"]
  REL --> ACID["ACID 交易與外部一致性"]
  REL --> SCHEMA["Schema、索引與 Foreign Key"]
  DIST --> SPLIT["依主鍵範圍自動分片"]
  DIST --> SCALE["Processing Units 水平擴展"]
  DIST --> REPLICA["跨故障邊界同步複寫"]
  SPLIT --> BALANCE["自動搬移 Split 與負載平衡"]
Spanner 厲害在它同時做到外部一致性(External Consistency)跟全球水平擴展——這組合在業界非常罕見。Google 自己的 Google Ads、Gmail、Google Photos 這些核心服務,背後跑的就是它。
核心架構
Processing Units(PU)
Spanner 的運算單位是 Processing Unit(PU):
| 規格 | 說明 |
|---|---|
| 最小單位 | 100 PU |
| 1 Node | 1,000 PU |
| 增量 | 未滿 1,000 PU 以 100 PU 為單位;達 1,000 PU 後以 1,000 PU(1 Node)為單位 |
| 每 100 PU 儲存 | 1,024 GiB |
| 每 Node 儲存 | 10 TiB |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
# 建立 Spanner 實例(100 PU,最小規模)
gcloud spanner instances create my-instance \
  --config=regional-asia-east1 \
  --processing-units=100 \
  --description="Development instance"

# 建立 1 Node 實例
gcloud spanner instances create prod-instance \
  --config=regional-asia-east1 \
  --nodes=1 \
  --description="Production instance"
資料分片(Split)
Spanner 會自動依主鍵範圍把資料切到多個分片(Split),每個分片交給不同的伺服器處理:
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  WRITE["新增資料"] --> KEY{"主鍵如何產生?"}
  KEY -->|"UUID/雜湊前綴/bit-reversed"| EVEN["Key 均勻分散"]
  EVEN --> S1["Split A~M<br/>伺服器 1"]
  EVEN --> S2["Split N~Z<br/>伺服器 2"]
  EVEN --> S3["資料成長後<br/>自動再分裂與搬移"]
  KEY -->|"AUTO_INCREMENT/時間戳"| MONO["新 Key 持續落在範圍尾端"]
MONO --> HOT["單一 Hot Split<br/>寫入集中、吞吐受限"] 主鍵設計——最關鍵的決策
避免單調遞增主鍵
這是 Spanner 設計裡最重要的一條原則。拿 AUTO_INCREMENT 或時間戳當主鍵,會讓所有寫入都擠到同一個分片上,也就是所謂的熱點:
-- ❌ 錯誤:單調遞增,造成寫入熱點
CREATE TABLE Orders (
  orderId INT64 NOT NULL,  -- 1, 2, 3, 4...
  ...
) PRIMARY KEY (orderId);

-- ✅ 正確:使用 UUID,寫入均勻分散
CREATE TABLE Orders (
  orderId STRING(36) NOT NULL,  -- UUID
  ...
) PRIMARY KEY (orderId);

-- ✅ 正確:使用 GENERATE_UUID()
CREATE TABLE Orders (
  orderId STRING(36) NOT NULL DEFAULT (GENERATE_UUID()),
  ...
) PRIMARY KEY (orderId);

-- ✅ 正確:反轉位元序列,打散熱點
CREATE SEQUENCE EventIdSeq OPTIONS (sequence_kind='bit_reversed_positive');

CREATE TABLE Events (
  eventId INT64 NOT NULL DEFAULT (GET_NEXT_SEQUENCE_VALUE(SEQUENCE EventIdSeq)),
  ...
) PRIMARY KEY (eventId);
📝 考場提點
題目若出現自增 ID 或時間戳主鍵,同時提到寫入效能不佳,可以檢查是否形成寫入熱點。單調遞增的主鍵可能讓新寫入集中在相近的分片(Split),影響分散寫入的效果。
如果確認瓶頸是單調遞增主鍵造成的寫入熱點,可以比較以下幾種打散方式:
- UUID /
GENERATE_UUID():最常見、最好記,隨機分散;缺點是字串較長、沒有時間順序。- bit-reversed sequence(位元反轉序列):想要整數主鍵、又要打散時用;把連續整數的位元反轉,相鄰值就被甩到不同分片。
- 反過來,需要照時間排序又怕熱點時,可以把高基數欄位放主鍵前綴(例如
userId在前、時間戳在後),用前綴先打散。實際調整前,先用監控與負載測試確認熱點位置;寫入慢不一定只有主鍵這個原因。
Interleaved Tables(交錯表)
這是 Spanner 獨有的功能,把父子表的資料實際存在一起,JOIN 效能會明顯變好:
-- 父表
CREATE TABLE Customers (
  customerId STRING(36) NOT NULL,
  name STRING(100),
  email STRING(200)
) PRIMARY KEY (customerId);

-- 子表(交錯在父表中)
CREATE TABLE Orders (
  customerId STRING(36) NOT NULL,
  orderId STRING(36) NOT NULL,
  amount FLOAT64,
  createdAt TIMESTAMP
) PRIMARY KEY (customerId, orderId),
  INTERLEAVE IN PARENT Customers ON DELETE CASCADE;

-- 孫表(可以多層交錯)
CREATE TABLE OrderItems (
  customerId STRING(36) NOT NULL,
  orderId STRING(36) NOT NULL,
  itemId STRING(36) NOT NULL,
  productName STRING(200)
) PRIMARY KEY (customerId, orderId, itemId),
  INTERLEAVE IN PARENT Orders ON DELETE CASCADE;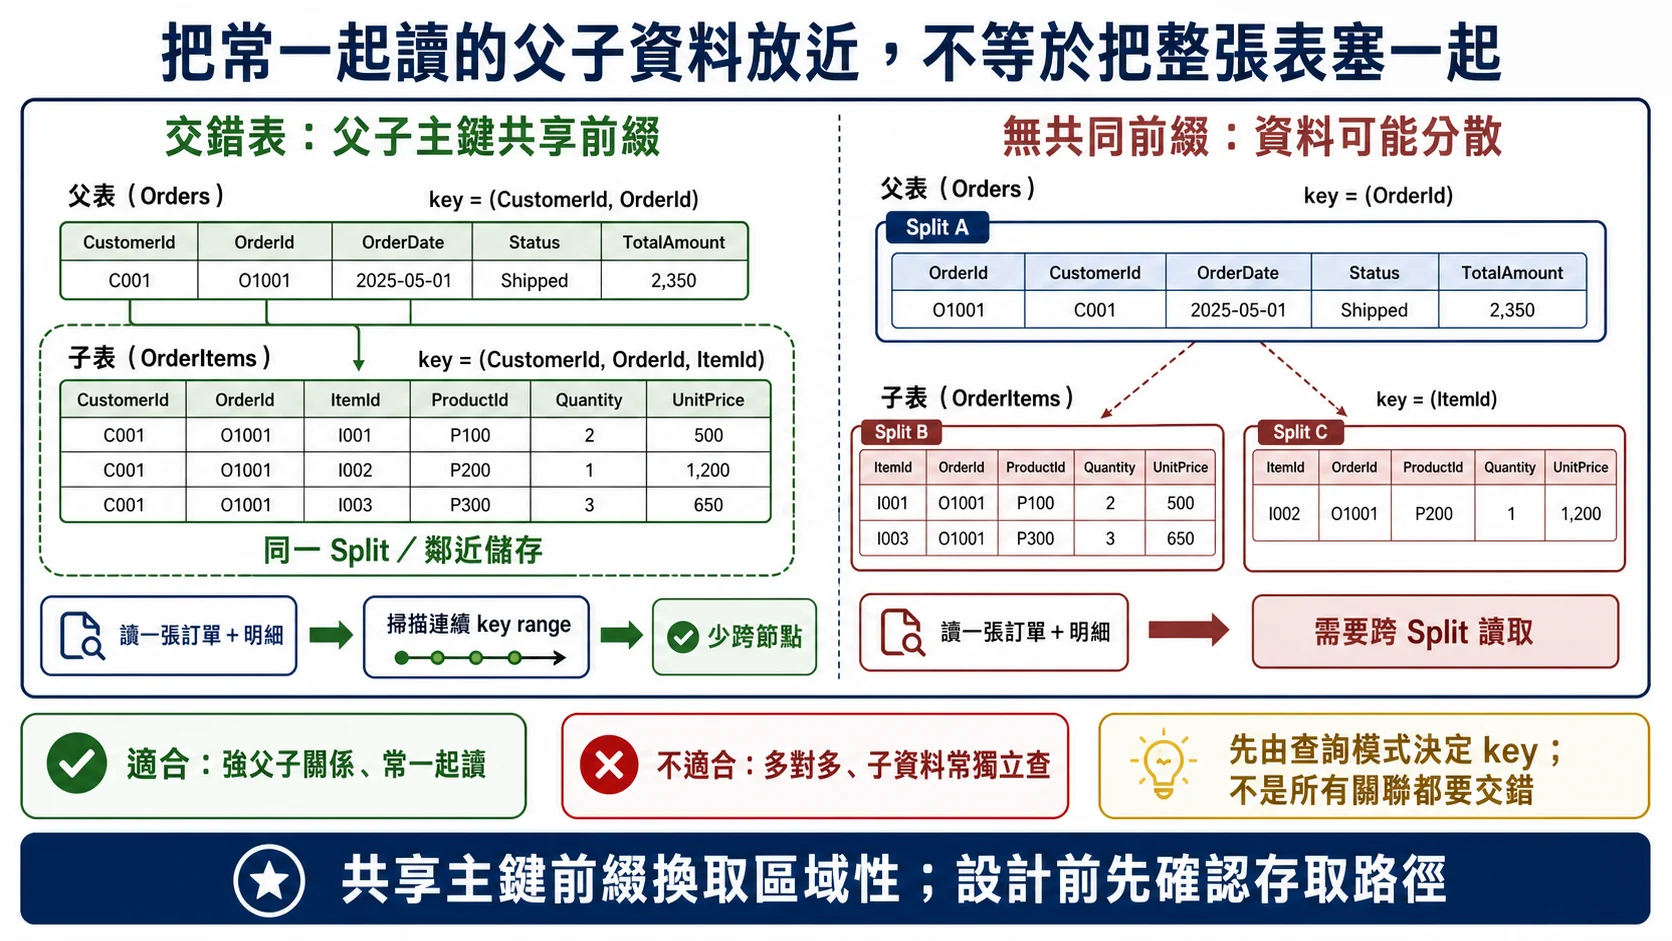
交錯表的核心不是把整張子表塞進父表,而是讓強父子關係共享主鍵前綴,將常一起讀的 key range 放得更近。多對多關係或經常獨立查詢的子資料不一定適合,仍要先由存取路徑決定 key。
效能差異
一般 JOIN(非交錯):可能跨多個分片 → 網路延遲
Interleaved JOIN:資料在同一個分片 → 本地讀取

查詢 "Customer X 的所有訂單和商品"
  非交錯:3 次跨分片請求
  交錯:1 次本地讀取
SQL 方言:GoogleSQL vs PostgreSQL
Spanner 支援兩種 SQL 方言:
| 特性 | GoogleSQL | PostgreSQL |
|---|---|---|
| 狀態 | 原生預設 | GA(2022 年) |
| 語法 | Spanner 專屬 | PostgreSQL 相容 |
| 驅動 | Spanner 客戶端 | 標準 PG 驅動(psycopg2 等) |
| Interleaved Tables | 支援 | 支援 |
| Graph | 支援 | 不支援 |
| 遷移 | 需要學習 | 從 PostgreSQL 遷移更容易 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
# 建立 PostgreSQL 方言資料庫
gcloud spanner databases create my-db \
  --instance=my-instance \
  --database-dialect=POSTGRESQL

# 建立 GoogleSQL 方言資料庫(預設)
gcloud spanner databases create my-db \
  --instance=my-instance \
  --database-dialect=GOOGLE_STANDARD_SQL
標準 PG 驅動(像 psycopg2)沒辦法直連 Spanner,得透過 PGAdapter(PostgreSQL wire-protocol 代理 / sidecar):驅動先連到本機的 PGAdapter,再由它翻譯成 Spanner gRPC。
# 先啟動 PGAdapter 代理(PostgreSQL wire-protocol proxy / sidecar)
# docker run -d -p 5432:5432 gcr.io/cloud-spanner-pg-adapter/pgadapter \
#   -p my-project -i my-instance

# 標準 PG 驅動連到本機 PGAdapter,由 PGAdapter 翻譯成 Spanner gRPC
import psycopg2

conn = psycopg2.connect(
    database="my-db",   # PostgreSQL 方言資料庫名稱
    host="localhost",   # PGAdapter 監聽位址(非 Spanner 資源路徑)
    port=5432
)
多區域配置
區域類型與 SLA
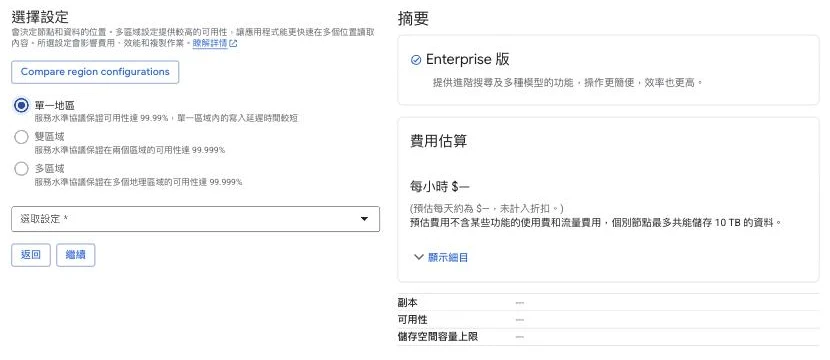
這張「選擇設定」就是 Spanner 選型題的現場:三顆單選按鈕由上而下,可用性從單一地區的 99.99% 一路跳到雙區域、多區域的 99.999%——多那一個 9,靠的就是把副本鋪到更多區域、甚至跨洲。但右邊那塊費用摘要會誠實地同步往上跳,多區域的單價明顯高於單一地區。要 99.999% 就得吃多區域(或雙區域)配置,而且版本得是 Enterprise Plus。選配置時除了可用性需求,也要把成本一起算進去。
| 配置類型 | SLA | 適合場景 |
|---|---|---|
| Regional | 99.99% | 單一區域,低延遲 |
| Dual-Region | 99.999% | 資料駐留需求 |
| Multi-Region | 99.999% | 全球高可用 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
常見多區域配置
| 名稱 | 區域 | 涵蓋範圍 |
|---|---|---|
| nam-eur-asia1 | Iowa + Oklahoma + Belgium + Taiwan | 三洲 |
| nam6 | 讀寫:Iowa + South Carolina;唯讀:Oregon + LA;witness:Oklahoma | 北美 |
| eur3 | Belgium + Netherlands | 歐洲 |
| asia1 | Tokyo + Osaka | 亞洲 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
Dual-Region(Enterprise Plus 專屬)
dual-region-japan1:  Tokyo + Osaka
dual-region-india1:  Mumbai + Delhi
dual-region-germany1: Berlin + Frankfurt
Dual-Region 配置只在 Enterprise Plus 版本提供,每個 dual-region 包含 6 個副本(每區域 3 個)。
交易與一致性
External Consistency
Spanner 提供的是外部一致性,這是比強一致性更嚴格的保證。簡單講,就是只要 T1 先提交,全世界任何地方的 T2 都保證讀得到——不會出現 A 洲已經寫好、B 洲還讀到舊值的情況。把這個白話畫面記住,再看下面的時間點示意就很好懂:
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
sequenceDiagram
  participant T1 as 亞洲的交易 T1
  participant S as Cloud Spanner
  participant T2 as 美洲的交易 T2
  T1->>S: 寫入並要求 Commit
  S->>S: Quorum 複寫並以 TrueTime 排定提交順序
  S-->>T1: t1 Commit 成功
  Note over T1,T2: T2 在真實時間上晚於 t1 才開始
  T2->>S: t2 開始讀取
  S-->>T2: 回傳包含 T1 結果的一致快照
交易類型
from google.cloud import spanner

instance = spanner.Client().instance("my-instance")
database = instance.database("my-db")

# 讀寫交易(鎖定)
def transfer(transaction):
    row_a = transaction.read("Accounts", ["balance"],
                             keyset=spanner.KeySet(keys=[[1]]))
    row_b = transaction.read("Accounts", ["balance"],
                             keyset=spanner.KeySet(keys=[[2]]))
    # ... 更新餘額

database.run_in_transaction(transfer)

# 唯讀交易(不鎖定,用快照)
with database.snapshot() as snapshot:
    results = snapshot.execute_sql(
        "SELECT * FROM Users WHERE age > @min_age",
        params={"min_age": 25},
        param_types={"min_age": spanner.param_types.INT64}
    )
Change Streams
Spanner 的 Change Streams(GA,2022 年)可以讓你追蹤資料變更:
-- 建立 Change Stream,監控所有表
CREATE CHANGE STREAM AllChanges FOR ALL;

-- 只監控特定表和欄位
CREATE CHANGE STREAM OrderChanges
  FOR Orders(orderId, amount, status);
常見用途
- 即時同步到 BigQuery 做分析
- 觸發 Pub/Sub 訊息做事件驅動
- 歸檔變更到 Cloud Storage 做合規
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  APP["應用程式交易"] --> SPANNER["Spanner Tables"]
  SPANNER --> STREAM["Change Stream<br/>保留 1~30 天"]
  STREAM --> PIPE["Dataflow Change Streams Connector"]
  PIPE --> BQ["BigQuery<br/>即時分析"]
  PIPE --> PUB["Pub/Sub<br/>事件驅動"]
  PIPE --> GCS["Cloud Storage<br/>稽核與長期歸檔"]
  SCHEMA["Schema/索引變更"] -. "不會被追蹤" .-> STREAM
重要限制
- 資料保留期:1-30 天(預設 7 天)
- 不追蹤 schema 變更、索引、views
- 會增加儲存和複製成本
Spanner Editions
| 特性 | Standard | Enterprise | Enterprise Plus |
|---|---|---|---|
| 區域配置 | Regional | Regional | Regional + 多區域 + Dual-Region |
| SLA | 99.99% | 99.99% | 最高 99.999% |
| Managed Autoscaler | 不支援 | 支援 | 支援 |
| Spanner Graph | 不支援 | 支援 | 支援 |
| 向量搜尋 | 不支援 | 支援 | 支援 |
| 全文搜尋 | 不支援 | 支援 | 支援 |
| Columnar Engine | 不支援 | 支援 | 支援 |
| Geo-Partitioning | 不支援 | 不支援 | 支援 |
| CUD 折扣 | 1 年 20% / 3 年 40% | 1 年 20% / 3 年 40% | 1 年 20% / 3 年 40% |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
備份與還原
# 建立備份(保留 30 天)
gcloud spanner backups create my-backup \
  --instance=my-instance \
  --database=my-db \
  --retention-period=30d \
  --async

# 從備份還原
gcloud spanner databases restore \
  --destination-instance=my-instance \
  --destination-database=my-db-restored \
  --source-instance=my-instance \
  --source-backup=my-backup

# 匯出到 GCS(透過 Dataflow)
gcloud dataflow jobs run export-spanner \
  --gcs-location=gs://dataflow-templates/latest/Cloud_Spanner_to_GCS_Avro \
  --parameters=instanceId=my-instance,databaseId=my-db,outputDir=gs://my-bucket/export/
免費試用
Spanner 提供 90 天免費試用實例:
| 項目 | 限制 |
|---|---|
| 試用期 | 90 天 |
| 儲存空間 | 10 GB |
| 最多資料庫 | 5 個 |
| 每個帳單帳號 | 最多 5 個試用實例 |
| SLA | 無 |
| 備份 | 不支援 |
| 可用區域 | 僅 Regional |
| 到期後 | 30 天寬限期,之後刪除 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
# 建立免費試用實例(不用指定 --processing-units,--description 則是必填)
gcloud spanner instances create free-instance \
  --config=regional-us-central1 \
  --instance-type=free-instance \
  --description="Free trial instance"
定價概覽
Spanner 依運算 + 儲存 + 網路計費:
| 項目 | 費用(Regional,美國) |
|---|---|
| 運算(Standard) | ~$0.90 / Node-hour |
| 運算(Enterprise) | ~$1.23 / Node-hour |
| 儲存 | $0.30 / GB / 月 |
| 備份儲存 | $0.10 / GB / 月 |
| 多區域運算 | 僅 Enterprise Plus,單價高於 Regional(依組態而定) |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
最小運算費用是 100 PU(= 0.1 Node):以 us-central1 Regional 計,Standard 約 0.1 × $0.90 × 730 小時 ≈ $66/月,Enterprise 約 0.1 × $1.23 × 730 小時 ≈ $90/月(不含儲存)。
Cloud Spanner vs Cloud SQL vs AlloyDB
三者的選型差異整理如下:
| 特性 | Cloud SQL | AlloyDB | Cloud Spanner |
|---|---|---|---|
| 類型 | 托管 MySQL/PostgreSQL | 托管 PostgreSQL | 全球分散式 |
| 擴展 | 垂直 + 讀取複本 | 垂直 + 讀取複本 | 水平擴展 |
| 最大儲存 | 64 TB | 128 TiB | 無限(加 Node) |
| 跨區域 | 跨區域讀取複本 | 跨區域讀取複本 | 跨區域讀寫 |
| SLA | 99.95%(Enterprise)/ 99.99%(Enterprise Plus),皆需 HA 組態 | 99.99%(需 HA 組態) | 99.999%(Enterprise Plus 多區域/雙區域;Regional 為 99.99%) |
| SQL 相容 | 完全相容 | 完全 PG 相容 | 部分相容 |
| 價格(us-central1,不含儲存) | 最低 ~$7.7/月(共用核心 db-f1-micro,$0.0105 × 730 小時) | ~$114/月起(1 vCPU/8 GiB,($0.06608 + 8 × $0.0112) × 730 小時) | ~$66/月起(Standard、100 PU,0.1 × $0.90 × 730 小時) |
| 最適合 | 中小型 OLTP | 高效能 PG | 全球規模 OLTP |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
選型公式
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  START{"需要關聯式 SQL 與 ACID 嗎?"}
  START -->|"否:文件模型與即時同步"| FS["Firestore"]
  START -->|"是"| GLOBAL{"需要全球水平擴展<br/>與跨區域讀寫嗎?"}
  GLOBAL -->|"是,且要外部一致性"| SPANNER["Cloud Spanner"]
  GLOBAL -->|"否:單區域主要寫入"| PG{"需要高效能 PostgreSQL<br/>與進階分析整合嗎?"}
  PG -->|"是"| ALLOY["AlloyDB"]
  PG -->|"否:傳統 MySQL/PostgreSQL/SQL Server"| SQL["Cloud SQL"]
SPANNER --> SLA["Regional 99.99%<br/>Dual/Multi-Region 99.999%"] 📝 考場提點
如果系統同時需要跨區域讀寫、關聯式交易與水平擴展,Spanner 是值得優先評估的選項。還要確認資料模型、寫入位置、可用性目標與費用,而不是只看到「全球」兩個字就下決定。英文規格常會寫 globally distributed、horizontal scale 或 external consistency,閱讀時要分清各自指的是什麼能力。
比較其他資料庫時,重點是它們是否滿足同一組需求:
- Cloud SQL:只能單區域寫入,跨區域那台是唯讀複本——題目一出現「多個區域都要能寫」就出局。
- Firestore:是 NoSQL、強項是 Mobile/Web 的即時同步——題目要「關聯式 / SQL / 強一致交易」就不是它。
- AlloyDB / Cloud SQL 也能跨區域,但只跨在「讀」,不是「寫」。
一句話:要「跨區域同時寫、又要強一致」只有 Spanner;其餘情境先想便宜的 Cloud SQL。
ACE 考試重點整理
必背知識點
- Spanner 結合 SQL、ACID 交易與水平擴展,可用於跨區域部署
- 避免單調遞增主鍵——用 UUID 或 BIT_REVERSE
- Interleaved Tables 將父子資料物理共置,大幅提升 JOIN 效能
- 1 Node = 1,000 PU,最小 100 PU,每 Node 10 TiB 儲存
- Regional 99.99%,Multi-Region 99.999%
- Enterprise Plus 才支援多區域和 dual-region
- Change Streams 可即時追蹤資料變更到 BigQuery 或 Pub/Sub
常見陷阱題
Q:需要全球多區域讀寫、ACID 交易的資料庫,選什麼? A:Cloud Spanner。Cloud SQL 只能單區域寫入,讀取複本是唯讀的。
Q:Spanner 使用 AUTO_INCREMENT 作為主鍵會有什麼問題? A:造成寫入熱點(Hotspot)。所有新寫入都集中在最後一個分片,無法利用 Spanner 的水平擴展優勢。
Q:Spanner 的 99.999% SLA 需要什麼配置? A:Enterprise Plus 版本 + 多區域配置。Regional 只有 99.99%。
Q:想在 Spanner 中儲存父子關聯資料並高效查詢,該用什麼功能? A:Interleaved Tables。它讓父子資料物理上存放在同一個分片,避免跨分片 JOIN。
什麼時候該考慮 Spanner?
如果應用需要跨區域部署、關聯式資料模型和一致的交易語意,Spanner 值得評估。但如果需求只落在單一區域,或資料量與流量還不需要水平擴展,先比較 Cloud SQL 的成本與維運方式。選資料庫時,把寫入位置、查詢型態、可用性和預算放在一起看,比單背產品名稱有用。
下一課 GCP-113:Cloud Bigtable 入門,來看 PB 級寬列 NoSQL 資料庫怎麼設計、怎麼操作。
資料庫選型系列
| 課程 | 服務 | 適合場景 |
|---|---|---|
| GCP-108 | Cloud SQL | 中小型 OLTP、傳統 SQL 應用 |
| GCP-112 | Firestore | Mobile/Web App、即時同步 |
| GCP-113 | Bigtable | PB 級 IoT/時序、低延遲高吞吐 |
| ACE-211 | BigQuery | PB 級分析、BI 報表 |
| 本課 ACE-213 | Spanner | 全球規模 OLTP、強一致性 |
| GCP-115 | Memorystore | 微秒級快取、Session 管理 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
還在比較資料庫?可以接著看 Google Cloud 資料庫怎麼選?。
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
地端連 Google Cloud:VPN 與 Interconnect 怎麼選?
機房和 Google Cloud 要互通,該選 VPN 還是專線?從目的地、頻寬、加密和備援要求,一步步釐清選型。
Terraform、Infrastructure Manager、Config Connector 怎麼選?
同樣是用程式碼管理 GCP 資源,三種工具各接手哪一段?比較設定語法、State 與維運責任。
Dataflow 與 Managed Service for Apache Spark(原 Dataproc)怎麼選?
Dataflow 與 Managed Service for Apache Spark(原 Dataproc)都能處理大量資料,差別在哪?從 Apache Beam、Spark 和批次/串流需求來比較。