
Cloud Memorystore 入門:快取該用哪種引擎?
前言
購物車、登入狀態、排行榜這類資料常被反覆讀取。如果每次都查主資料庫,延遲和負載可能跟著升高;這時可以評估用快取分擔讀取。Cloud Memorystore 提供幾種受管的記憶體資料庫引擎,選之前先看資料用途和失效後怎麼回源。
這篇會比較 Redis、Valkey 和 Memcached,也會談快取設定、費用與常見的選型問題。
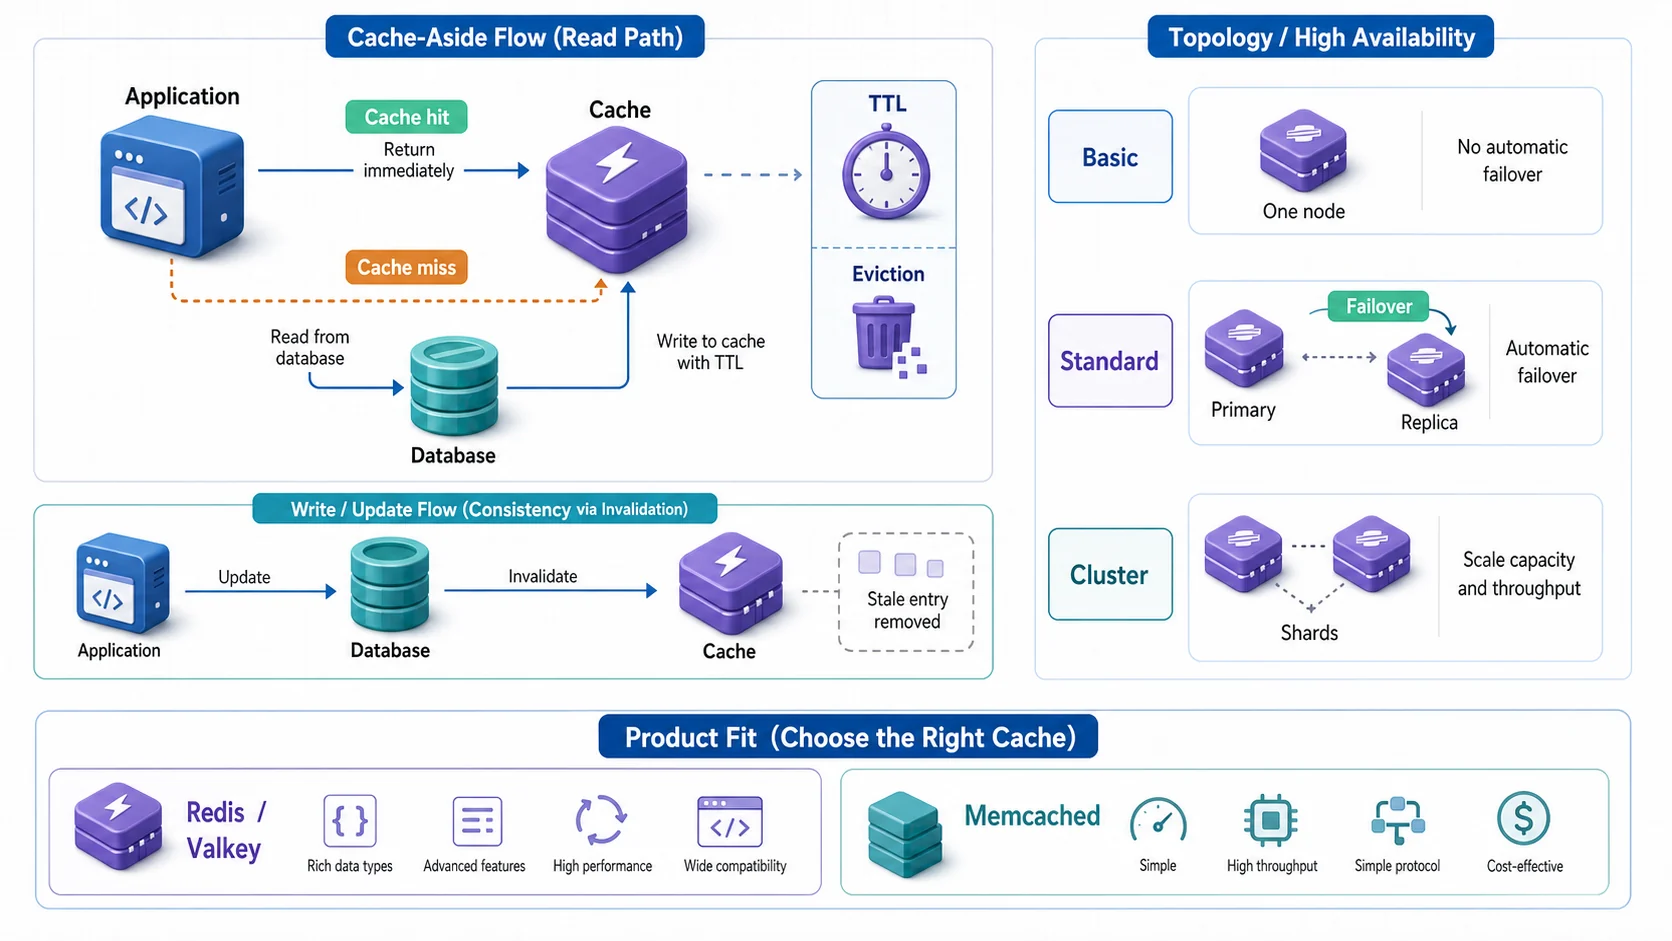
快取不是資料真實來源:cache hit 直接回傳,cache miss 才查持久資料庫並以 TTL 寫回;更新資料時還要刪除或更新舊快取,避免 stale data。Basic、Standard 與 Cluster 分別對應單節點、可自動故障轉移與分片擴充,產品選擇則要看資料結構、相容性、可用性與生命週期需求。
什麼是 Cloud Memorystore?
先補一點背景,免得後面看得霧煞煞。快取(cache) 講白話就是「把常用的資料先放在拿得快的地方」,這樣下次要用就不必每次都跑去翻很慢的硬碟資料庫。讀到快取裡有要的東西叫快取命中(cache hit),沒有、得回頭去查資料庫叫快取未命中(cache miss)。Memorystore 扮演的就是這個「拿得快的地方」。
Memorystore 是 GCP 的全託管記憶體資料庫,資料放在記憶體(RAM)裡而不是硬碟,所以讀寫延遲超低:
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart LR
  subgraph READ["1. 讀取路徑"]
    direction TB
    REQUEST["應用收到讀取請求"] --> CACHE{"Memorystore<br/>有這個 Key?"}
    CACHE -->|"Cache hit"| FAST["直接回傳快取資料"]
    CACHE -->|"Cache miss"| DB["查詢 Cloud SQL/Firestore<br/>等真實資料來源"]
    DB --> FILL["以合適 TTL 寫回快取"]
    FILL --> RESPONSE["回傳資料"]
  end
  subgraph WRITE["2. 更新路徑"]
    direction TB
    UPDATE["應用更新資料"] --> SOURCE["先提交到真實資料來源"]
    SOURCE --> INVALIDATE["刪除或更新對應 Cache Key"]
    INVALIDATE --> NEXT["下一次讀取重新填入新資料"]
  end
READ ~~~ WRITE Memorystore 應視為加速層,不是預設的資料真實來源。讀取時 miss 才查資料庫並回填;寫入時要在資料提交後失效舊 Key,並用 TTL 限制 stale data 長期存在。
四個產品
| 產品 | 說明 | 狀態 |
|---|---|---|
| Memorystore for Redis | 獨立 Redis 實例(Basic/Standard) | GA |
| Memorystore for Redis Cluster | 分片式 Redis 叢集 | GA |
| Memorystore for Valkey | 基於 Valkey(Redis 開源分支) | GA |
| Memorystore for Memcached | 託管 Memcached | 已棄用(2029/1/31 停止服務) |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
Valkey 是 Redis 在 2024 年改授權之後,由 Linux Foundation 主導的開源分支(BSD 3-Clause),協議跟 Redis 完全相容。Google、AWS、Oracle 等都有一起支持。
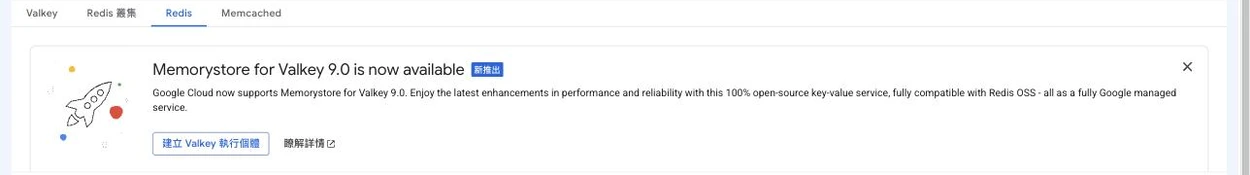
Memorystore 底下這四個分頁——Valkey、Redis 叢集、Redis、Memcached ——就是上面那張四個產品表。注意 Console 上方的橫幅是 Valkey 9.0 上線的公告(100% 開源、跟 Redis OSS 完全相容);Memcached 雖然還在分頁上,但已經在倒數退場了。
Memorystore for Redis(獨立實例)
Basic vs Standard Tier
| 特性 | Basic Tier | Standard Tier |
|---|---|---|
| 高可用 | 無(單節點) | 跨可用區(zone)複製 + 自動故障轉移 |
| SLA | 無 | 99.9% |
| 讀取副本 | 無 | 最多 5 個 |
| 最大容量 | 300 GB | 300 GB |
| RDB 快照 | 支援 | 支援(從副本執行,不影響主節點) |
| 適合場景 | 開發測試、可容忍冷啟動 | 正式環境 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 24, "nodeSpacing": 18}}}%%
  flowchart TB
  START["建立 Memorystore for Redis"] --> PRODUCTION["服務中斷或快取清空<br/>會影響正式使用者?"]
  PRODUCTION -->|"否,可重建"| BASIC["Basic Tier<br/>單節點、無 SLA"]
  PRODUCTION -->|"是"| STANDARD["Standard Tier<br/>跨 Zone 複寫與自動 Failover"]
  STANDARD --> READS["需要提高讀取吞吐?"]
  READS -->|"是"| REPLICA["啟用 Read Replicas<br/>應用使用 Read Endpoint"]
  READS -->|"否"| HA["保留 HA Replica<br/>使用主要 Endpoint"]
  BASIC --> LOCK["Tier 不能原地升級<br/>日後更換須建立新 Instance"]
  REPLICA --> TEST["演練 Failover、重連<br/>與暫時讀取容量下降"]
HA --> TEST Basic 適合資料可隨時重建的開發或非關鍵快取;正式環境通常從 Standard 開始。自動 Failover 仍會造成短暫連線中斷,Client 必須設定重試、退避與連線池重建。
💡 重點提點
Basic 和 Standard 不能原地互換,更換層級需要建立新的執行個體並搬遷連線與資料(見官方層級說明)。正式服務若需要自動容錯移轉,應在建立時就評估 Standard;若先用 Basic,也要把日後切換的停機與資料重建方式規劃進去。
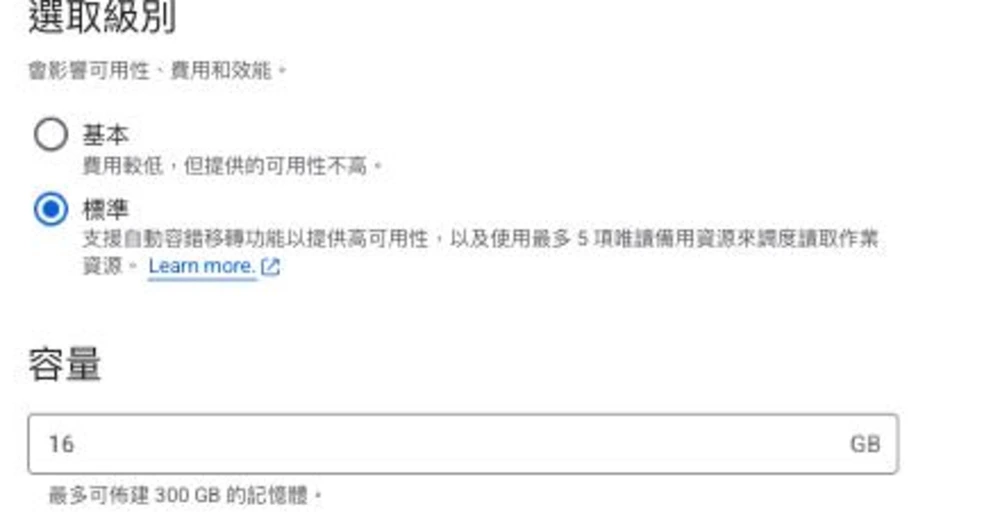
建 Redis 實例第一個要定的就是級別:基本是單節點、無 SLA,只適合開發測試;標準才有跨可用區複製、自動容錯移轉跟 99.9% SLA。這正是上面提點框在講的坑——兩者不能互相升級,正式環境第一步就得選標準,別想著先開基本省錢之後再升,到時只能停機重建。下面容量最多也就到 300 GB,要更大得改用 Valkey 叢集。
容量等級
| 等級 | 容量範圍 | 網路吞吐 |
|---|---|---|
| M1 | 1-4 GB | 10 Gbps |
| M2 | 5-10 GB | 10 Gbps |
| M3 | 11-35 GB | 10 Gbps |
| M4 | 36-100 GB | 16 Gbps |
| M5 | 101-300 GB | 16 Gbps |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
建立與連接
# 建立 Standard Tier Redis 實例
gcloud redis instances create my-cache \
  --size=5 \
  --region=asia-east1 \
  --tier=standard \
  --redis-version=redis_7_2

# 查看實例資訊(含 Host/Port)
gcloud redis instances describe my-cache --region=asia-east1

# 從 VM 連接
redis-cli -h INSTANCE_HOST -p 6379
RDB 快照(備份)
RDB(Redis Database Backup)快照就是把當下記憶體裡的整份資料「拍一張照」存起來,之後可以拿這張照片把資料還原回去——重啟或誤刪時的救命稻草。
# 快照間隔:1h / 6h / 12h / 24h
# 匯出走 BGSAVE(copy-on-write),官方建議必要時先把 maxmemory-gb 降到容量的 50%

# 匯出到 Cloud Storage
gcloud redis instances export gs://my-bucket/backup.rdb \
  my-cache --region=asia-east1

# 從 Cloud Storage 匯入(會中斷服務)
gcloud redis instances import gs://my-bucket/backup.rdb \
my-cache --region=asia-east1流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  LIVE["Redis 記憶體資料"] --> SNAPSHOT["依排程建立 RDB Snapshot<br/>只代表某個時間點"]
  SNAPSHOT --> LOCAL["供服務維護與復原使用"]
  SNAPSHOT --> EXPORT["必要時匯出到 Cloud Storage<br/>另行管理 Bucket 權限與生命週期"]
  EXPORT --> RESTORE["將 RDB 匯入目標 Instance"]
  RESTORE --> DOWNTIME["匯入期間服務中斷<br/>完成後驗證 Key、TTL 與應用連線"]
  LIVE -. "Snapshot 間隔內的新寫入<br/>仍可能不在復原點" .-> RPO["依業務 RPO 判斷<br/>快取能否直接重建"]
RDB 是時間點快照,不是每筆寫入同步落盤。對純快取,通常應先確保能從真實資料來源重建;若 Memorystore 承載重要狀態,必須明確接受 Snapshot 間隔帶來的 RPO 與匯入停機。
Memorystore for Valkey
Valkey 是 Redis 相容的開源引擎,也是官方建議 Memcached 使用者遷移的目標:
核心優勢
- Valkey(2024 年 8 月 Preview 起步,目前官方支援 7.2、8.0、9.0、9.1,預設為 9.1):在微秒級延遲下,每秒查詢數(QPS)最高可達 Memorystore for Redis Cluster 的 3 倍(9.1 版;8.0 時為 2 倍)
- 支援叢集模式和非叢集模式
- 每個分片(shard,把資料切成好幾塊、分散到不同節點存的單位):1 個主節點 + 最多 5 個副本
- 最大 250 個節點(不配副本時就是 250 個分片,每分片 1 個副本時是 125 個),總容量可達數十 TB 級(實際看你挑哪種節點型別與副本數)
- 零停機擴縮:水平增減分片不中斷服務
- 跨區域複製(GA)
- 向量搜尋(vector search,用「語意相似度」找資料,而不是精準比對關鍵字):內建支援,常用在 GenAI / RAG 這類應用
節點類型
以下列的是幾種常用型別(官方實際提供更多種,上面還有更大的,例如 highmem-2xlarge):
| 節點類型 | vCPU | 可寫容量 | SLA |
|---|---|---|---|
| shared-core-nano | 0.5 | 1.12 GB | 無 |
| standard-small | 2 | 5.2 GB | 有 |
| highmem-medium | 2 | 10.4 GB | 有 |
| highmem-xlarge | 8 | 46.4 GB | 有 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
SLA
- 99.99%:多可用區(Multi-Zone)部署 + 副本
- 99.9%:單一可用區 + 副本
- 無 SLA:shared-core-nano 或無副本
相容性
協議跟 Redis 完全相容,手上現有的 Redis 客戶端(Jedis、redis-py、ioredis 等)不用改就能直接接上。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  CLIENT["Cluster-aware Valkey Client"] --> SLOT["依 Key 計算 Hash Slot<br/>直接連到負責的 Shard"]
  SLOT --> S1["Shard A Primary<br/>部分 Keyspace"]
  SLOT --> S2["Shard B Primary<br/>部分 Keyspace"]
  SLOT --> S3["Shard C Primary<br/>部分 Keyspace"]
  S1 -. "非同步複寫" .-> R1["Shard A Replica<br/>另一個 Zone"]
  S2 -. "非同步複寫" .-> R2["Shard B Replica<br/>另一個 Zone"]
  S3 -. "非同步複寫" .-> R3["Shard C Replica<br/>另一個 Zone"]
  R1 -->|"Primary 故障時提升"| F1["新的 Shard A Primary"]
  R2 -->|"Primary 故障時提升"| F2["新的 Shard B Primary"]
  R3 -->|"Primary 故障時提升"| F3["新的 Shard C Primary"]
分片擴充容量與吞吐,Replica 則分散到不同 Zone 並在故障時提升。Valkey 複寫是非同步的,非預期 Failover 仍可能遺失少量已確認寫入;不能把快取 HA 當成強一致的交易資料庫。
Memorystore for Memcached(已棄用)
| 時間點 | 事件 |
|---|---|
| 2026/1/20 | 不再推薦使用 |
| 2027/2/1 | 新專案無法建立實例 |
| 2029/1/31 | 完全停止服務 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
Memcached 跟 Redis/Valkey 差最多的地方:
- 無持久化:純快取,重啟資料全沒,救不回來
- 無複製、無故障轉移(failover,主節點掛了自動換副本頂上的機制):主節點一倒,這段快取就斷了
- 僅支援簡單 Key-Value:沒有 List、Set、Sorted Set(會自動依分數排序的集合)這些資料結構
Google 建議遷移至 Memorystore for Valkey。
網路架構
連到 Memorystore 時,先確認用戶端是否能走私有網路到達執行個體的位址。從筆電、公網或不同 VPC 直接連線,通常不會像連公開資料庫那樣通;要另外規劃 VPN、互連或受支援的 VPC 路徑。
💡 重點提點
Cloud Run 連 Redis 時,要讓服務能送出流量到執行個體所在的授權 VPC。官方建議優先評估 Direct VPC egress,也可使用 Serverless VPC Access Connector。若連線逾時,除了檢查 VPC egress,還要核對網路、位址、連接埠與防火牆設定;不要只憑 timeout 就認定是少了 Connector。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  subgraph DIRECT["VPC 內的運算資源"]
    direction LR
    VM["Compute Engine VM"]
    GKE["VPC-native GKE Pod"]
    FLEX["App Engine Flexible"]
  end
  subgraph SERVERLESS["無伺服器執行環境"]
    direction LR
    RUN["Cloud Run service"]
    FUNCTION["Cloud Run function"]
    STANDARD["App Engine Standard"]
  end
  subgraph NETWORK["私有網路路徑"]
    direction LR
    VPC["授權的 VPC/Shared VPC"]
    EGRESS["Direct VPC egress<br/>或 Serverless VPC Access Connector"]
  end
  CACHE["Memorystore Internal IP<br/>無公開端點"]
  VM --> VPC
  GKE --> VPC
  FLEX --> VPC
  RUN --> EGRESS
  FUNCTION --> EGRESS
  STANDARD -->|"使用 Connector"| EGRESS
  EGRESS --> VPC
VPC --> CACHE 能否連線取決於網路路徑,不是只看 IAM。VM 與 VPC-native GKE 可直接經授權 VPC;Cloud Run service/function 可使用 Direct VPC egress 或 Connector,並應確認路由、IP 範圍、防火牆與區域。
| 服務 | 連接方式 |
|---|---|
| Compute Engine | 直接透過 VPC(同一網路) |
| GKE | VPC-native 叢集直接連接 |
| Cloud Run | Serverless VPC Access Connector 或 Direct VPC Egress |
| Cloud Run functions(原 Cloud Functions) | Serverless VPC Access Connector 或 Direct VPC Egress |
| App Engine Standard | Serverless VPC Access Connector |
| App Engine Flex | 直接透過 VPC |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
常見使用場景
1. Session 快取
import redis

r = redis.Redis(host='MEMORYSTORE_HOST', port=6379)

# 儲存 Session(30 分鐘過期)
r.setex(f"session:{session_id}", 1800, session_data)

# 讀取 Session
session = r.get(f"session:{session_id}")
2. 資料庫查詢快取
def get_user(user_id):
    # 先查快取
    cached = r.get(f"user:{user_id}")
    if cached:
        return json.loads(cached)

    # 快取未命中,查資料庫
    user = db.query("SELECT * FROM users WHERE id = %s", (user_id,))

    # 寫入快取(5 分鐘過期)
    r.setex(f"user:{user_id}", 300, json.dumps(user))
    return user
3. 遊戲排行榜
# 使用 Redis Sorted Set
r.zadd("leaderboard", {"player_a": 1500, "player_b": 2300})

# 取得前 10 名
top_10 = r.zrevrange("leaderboard", 0, 9, withscores=True)
4. API 速率限制
def check_rate_limit(api_key, limit=100, window=60):
    key = f"rate:{api_key}"
    current = r.incr(key)
    if current == 1:
        r.expire(key, window)
return current <= limit流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  START["要加速<br/>或協調哪一種應用狀態?"] --> USE{"資料行為"}
  USE -->|"登入狀態、<br/>一次性 Token"| SESSION["String/<br/>Hash + TTL<br/>到期自動失效"]
  USE -->|"資料庫查詢結果"| QUERY["Cache-aside<br/>+ TTL<br/>更新資料時<br/>Invalidate"]
  USE -->|"排行榜、優先順序"| RANK["Sorted Set<br/>依 Score 排序"]
  USE -->|"計數器、速率限制"| RATE["INCR +<br/>EXPIRE 或 Lua<br/>確保原子邊界"]
  SESSION --> REVIEW["定義 Key 命名、TTL、<br/>最大大小與資料重建方式"]
  QUERY --> REVIEW
  RANK --> REVIEW
RATE --> REVIEW 先由操作語意選資料結構,不要把所有內容都序列化成大型 String。Session 與查詢快取需要
TTL;排行榜利用 Sorted Set;多步驟速率限制則要注意 INCR 與 EXPIRE 之間的原子性與失敗恢復。
Redis vs Valkey vs Memcached 選型
| 特性 | Redis(獨立) | Valkey(叢集) | Memcached |
|---|---|---|---|
| 資料結構 | String、List、Set、Hash、Stream 等 | 同左 | 僅 Key-Value |
| 持久化 | RDB 快照 | RDB 或 AOF(擇一) | 無 |
| 高可用 | Standard Tier 99.9% | 99.99%(多可用區) | 無 |
| 最大容量 | 300 GB | 數十 TB 級 | 依節點數擴展 |
| Pub/Sub | 支援 | 支援 | 不支援 |
| 向量搜尋 | 支援(Redis 7.2) | 支援 | 不支援 |
| 狀態 | GA | GA | 已棄用 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
Pub/Sub(Publish/Subscribe,發布/訂閱)是 Redis 內建的訊息廣播機制:發送方丟一則訊息,所有訂閱該頻道的接收方都會即時收到,常拿來做即時通知、聊天室。(注意這跟 GCP 那個獨立的 Cloud Pub/Sub 服務不是同一個東西,只是名字一樣。)AOF(Append Only File)則是另一種持久化方式,把每一筆寫入指令逐筆記下來,比 RDB 快照更不容易掉資料。
選型公式
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 24, "nodeSpacing": 18}}}%%
  flowchart TB
  START["需要全託管記憶體資料服務"] --> MEMCACHED["目前依賴 Memcached<br/>特有 Client/行為?"]
  MEMCACHED -->|"是"| MIGRATE
  MEMCACHED -->|"否"| EXISTING["既有獨立 Redis Instance<br/>要維持相同拓撲?"]
  EXISTING -->|"是"| REDIS
  EXISTING -->|"否,新專案或需要新能力"| VALKEY
  MIGRATE["規劃遷移到 Valkey<br/>不要建立新的長期 Memcached 相依"]
  REDIS["Memorystore for Redis<br/>Basic/Standard 獨立 Instance"]
VALKEY["Memorystore for Valkey<br/>支援分片、複本與向量搜尋"] Memcached 已進入退場時程,不應成為新架構的預設答案。既有獨立 Redis 若要降低遷移變數可先維持 Redis;新專案與需要分片、複本或新能力的工作負載,優先評估 Valkey。
定價
Redis 獨立實例(us-central1 參考)
| 等級 | Basic Tier(每 GiB/hr) | Standard Tier(每 GiB/hr) |
|---|---|---|
| M1(1-4 GB) | ~$0.049 | ~$0.064 |
| M2(5-10 GB) | ~$0.027 | ~$0.054 |
| M3(11-35 GB) | 低於 M2 | ~$0.046 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
Standard Tier 比 Basic Tier 貴不少(M1 約貴 3 成,M2、M3 約貴一倍),畢竟多了複製和 HA 的開銷。
Valkey / Redis Cluster(us-central1 參考)
| 節點類型 | 每節點每小時 |
|---|---|
| shared-core-nano | ~$0.0318 |
| highmem-medium | ~$0.192 |
| highmem-xlarge | ~$0.858 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
範例:5 分片 × 1 副本 × highmem-medium = 10 節點 × $0.192 = $1.92 / 小時(官方月價每節點 $140.379 × 10 ≈ $1,404 / 月)
成本優化
- 承諾使用折扣(CUD,Committed Use Discounts):先承諾用 1 年或 3 年,換取比隨用隨付更低的價格——承諾越久折扣越多,實際百分比依產品和時間調整,要省錢前先去官方定價頁查當下的數字
- 沒有免費層;不過新帳號有 GCP 註冊後的免費試用額度可以拿來練手(額度與適用範圍以官方為準)
效能調校建議
- System memory usage ratio 低於 80%——官方把 80% 當記憶體壓力的警戒線,維護、匯出前則要壓到 50% 以下
- 匯出、擴縮、升級前必要時把 maxmemory-gb 降到容量的 50%——建立時預設等於容量,匯出用的 BGSAVE(copy-on-write)所需記憶體最多可能是資料量的兩倍
- 使用 I/O Thread——M3 以上搭配 Redis 6.x+ 自動啟用
- 選擇同區域的 VPC——減少網路跳數
- 使用 Pipeline / Batch——Pipeline(管線)就是把一堆指令打包成一次送出、不必每條都來回確認,減少 Round-Trip(往返)次數,延遲會明顯下降
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  subgraph OBSERVE["1. 確認主要症狀"]
    direction TB
    START["p95/p99 延遲、錯誤<br/>或 Eviction 增加"] --> MEMORY{"記憶體使用率接近上限,<br/>且 Evicted Keys 上升?"}
    MEMORY -->|"否"| NETWORK{"Client 與 Instance<br/>同區域,<br/>連線數與 RTT 正常?"}
  end
  subgraph ACTION["2. 對症處理"]
    direction TB
    CAPACITY["調整 TTL、Key 大小<br/>與 eviction policy<br/>必要時擴容<br/>或增加 Shard"]
    CONNECTION["修正 VPC<br/>路徑與連線池<br/>避免每次請求<br/>重新連線"]
    ROUNDTRIP["用 Pipeline/<br/>Batch 減少往返<br/>再檢查慢指令<br/>與大型 Value"]
  end
  subgraph VERIFY["3. 重新驗證"]
    direction TB
    LOAD["用真實 Key 分佈<br/>與並行度壓測"] --> MONITOR["監控 Memory、CPU、<br/>Connections、Latency、<br/>Errors 與 Evictions"]
  end
  MEMORY -->|"是"| CAPACITY
  NETWORK -->|"否"| CONNECTION
  NETWORK -->|"是"| ROUNDTRIP
  CAPACITY --> LOAD
  CONNECTION --> LOAD
ROUNDTRIP --> LOAD 先區分容量、網路與指令往返問題。只擴大 Instance 不會修好跨區網路或每次重建連線;只縮短 TTL 也可能把壓力轉回資料庫,因此調整後要同時觀察 Cache hit ratio 與下游負載。
ACE 考試重點整理
必背知識點
- Memorystore 是全託管記憶體資料庫,支援 Redis、Valkey、Memcached
- Valkey 是 Redis 開源分支(Linux Foundation),官方建議 Memcached 使用者遷移到 Valkey
- Basic Tier 無 SLA,Standard Tier 99.9%,Valkey 多可用區 99.99%
- 使用私有網路連線——Cloud Run 等服務可評估 Direct VPC egress 或 Serverless VPC Access Connector
- Memcached 已棄用(2029/1/31 停止服務)
- Basic 和 Standard 無法互相升級,必須重建
- RDB 快照匯入會中斷服務
常見陷阱題
Q:Web App 需要毫秒以下的 Session 快取,選什麼? A:如果 Session 需要頻繁讀寫,而且多個應用實例要共用狀態,可以評估 Memorystore for Redis 或 Valkey。實際延遲仍要連同網路與應用程式行為一起量測。
Q:Memorystore 實例可以從公開網路存取嗎? A:不能直接從公開網路連線。應用需要透過 VPC 存取;若部署在 Cloud Run,可依網路配置選用 Direct VPC egress 或 Serverless VPC Access Connector。
Q:需要 >300 GB 的記憶體快取並且要 99.99% SLA,選什麼? A:Memorystore for Valkey(叢集模式)。獨立 Redis 卡在 300 GB,要再大、又要多可用區 99.99% SLA,就得走叢集型產品(Redis Cluster 也有 99.99% SLA);每分片配 1 個副本時最多 125 個分片,總容量最高約 13.75 TB。
Q:Redis 和 Memcached 有什麼差別? A:Redis/Valkey 支援豐富資料結構(List、Set、Hash 等)和持久化。Memcached 只支援簡單 Key-Value 且無持久化。Google 已棄用 Memcached,建議用 Valkey。
Q:什麼是 Valkey? A:Redis 在 2024 年更改授權後的開源分支,由 Linux Foundation 主導,與 Redis 完全協議相容。
總結
Memorystore 適合讓多個應用實例共用快取,例如 Session、排行榜或速率限制資料。選 Redis、Valkey 或其他產品時,先看資料結構、容量、可用性與既有相容性;連線方式也要一起規劃。若資料需要長期保存並支援查詢或交易,就不要只靠快取,應另選合適的資料庫。
下一課 ACE-216:地端連 Google Cloud,VPN 與 Interconnect 怎麼選?,來看機房和 Google Cloud 要互通時,VPN 和專線該怎麼選。
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
Cloud DNS 入門:公開、私有網域與解析路徑
網域要給外部使用者查,還是只給 VPC 內部查?從 Public/Private Zone 到 DNSSEC 和路由策略。
Cloud Bigtable 入門:大量資料的 Row Key 怎麼設計?
時序或感測器資料量很大時,Bigtable 適合嗎?從 Row Key、叢集容量與資料保留策略看起。
Firestore 入門:文件資料、即時更新與存取規則
App 的資料適合放 Firestore 嗎?從文件模型、即時監聽和安全規則開始,再看費用與選型。