
Cloud Bigtable 入門:大量資料的 Row Key 怎麼設計?
前言
當感測器或時序資料持續累積,查詢又得保持低延遲,Cloud Bigtable 可能是選項。但「資料很多」還不足以決定要不要用它:應用怎麼查、Row Key 怎麼排,往往更重要。
這篇會先看 Bigtable 的資料模型,再談 Row Key、複製與擴縮。你可以直接從這篇開始,不必先讀完前面的課。
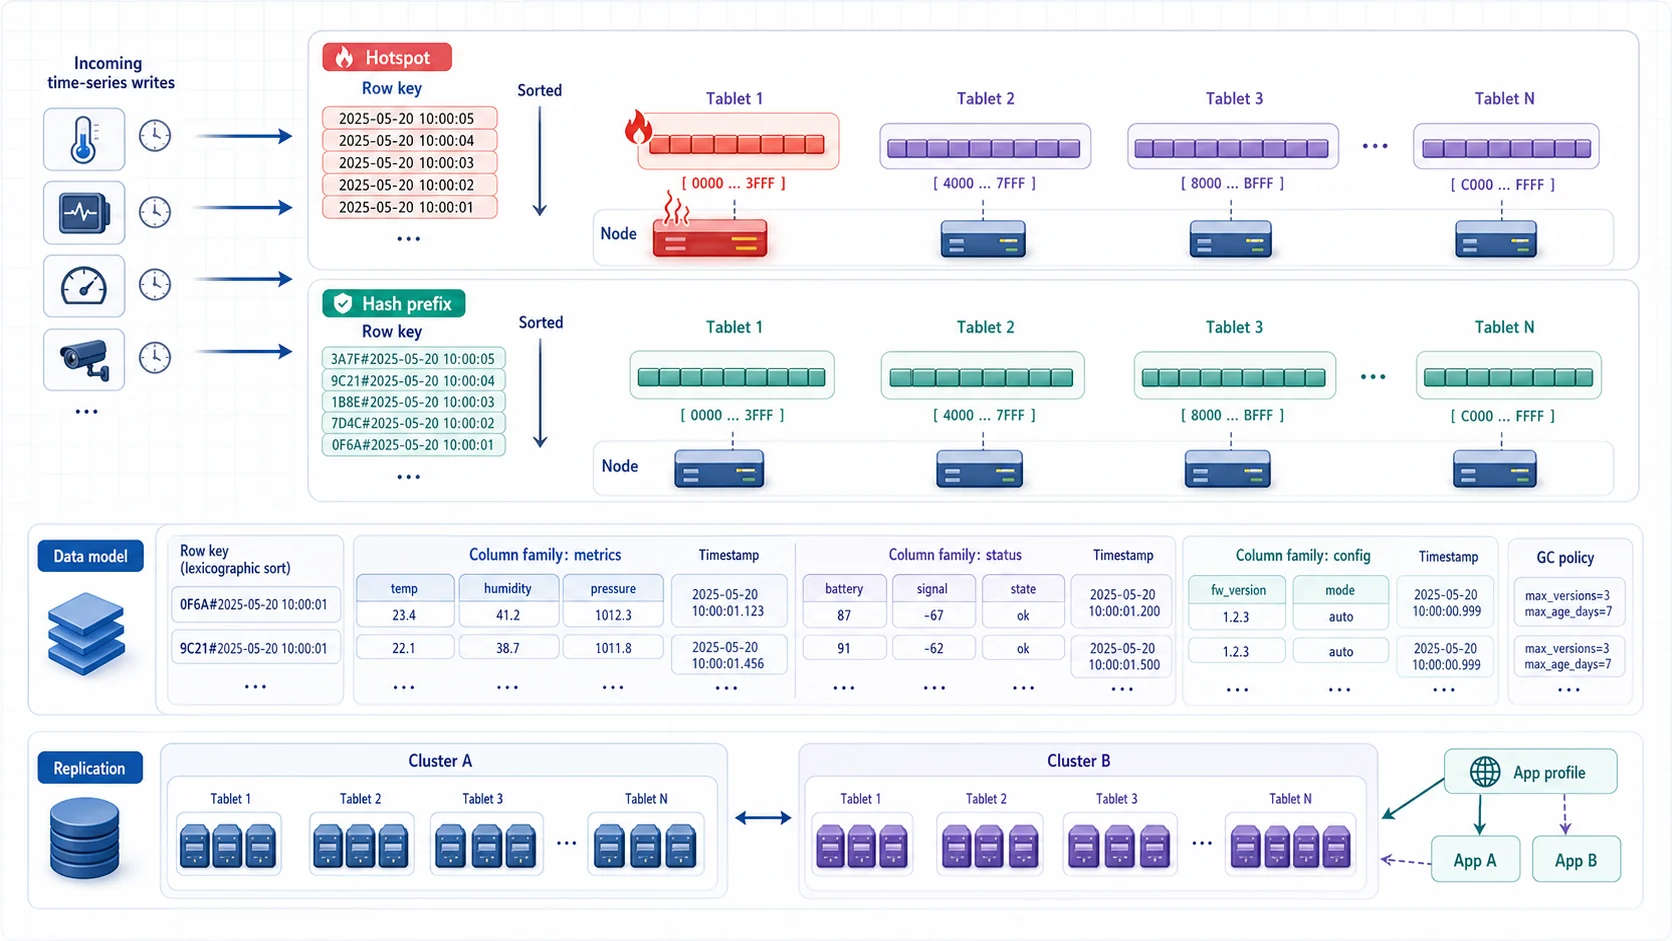
Bigtable 依 Row Key 的字典序排列資料並把連續範圍切成 Tablet;所以 Row Key 同時決定查詢效率與寫入是否均衡。時間戳放最前面會讓最新寫入擠進同一範圍,設備 ID、雜湊或反轉時間等前綴可分散負載。Column Family 與 GC policy 管資料版本,跨 Cluster 複寫與 App profile 則處理可用性和路由。
什麼是 Cloud Bigtable?
Bigtable 是 Google Cloud 的寬列型 NoSQL 資料庫(Wide-Column Store)。它適合資料量大、讀寫模式能圍繞 Row Key 設計的工作負載;實際延遲和吞吐量仍要看資料模型、用量與叢集配置。
Row Key          │ Column Family: profile      │ Column Family: metrics
─────────────────┼─────────────────────────────┼──────────────────────
sensor#2026-03   │ name: "TempSensor-A"        │ temp: 25.3
                 │ location: "Taipei"          │ humidity: 78
─────────────────┼─────────────────────────────┼──────────────────────
sensor#2026-04   │ name: "TempSensor-A"        │ temp: 26.1
                 │ location: "Taipei"          │ humidity: 72
核心特性
- 大量資料:依 Row Key 範圍切分資料,分散到叢集節點
- 低延遲讀寫:SSD 通常適合線上查詢,但應以自己的負載測試結果為準
- 可增加節點處理更多流量:前提是讀寫沒有集中在少數 Row Key
- HBase API 用戶端:可協助既有 Java 應用遷移,仍需檢查 API 差異和資料搬遷工作
SSD vs HDD
| 特性 | SSD | HDD |
|---|---|---|
| 讀取延遲 | 通常較低,適合線上隨機讀取 | 隨機讀取較慢,範圍掃描較合適 |
| 寫入延遲 | 通常較低 | 視負載而定 |
| 每 Node 讀取 | 最高約 17,000 rows/s | 最高約 500 rows/s |
| 每 Node 寫入 | 最高約 14,000 rows/s | 最高約 10,000 rows/s |
| 每 Node 掃描 | 最高約 220 MB/s | 最高約 180 MB/s |
| 每 Node 儲存 | 5 TB | 16 TB |
| 適合場景 | 即時查詢、線上服務 | 不要求低延遲的批次掃描 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
吞吐量是官方效能文件在理想條件、每列約 1 KB 的估計上限,不是服務保證值。延遲、儲存容量和適用場景可對照SSD/HDD 選型說明。
Instance 建立後不能直接把儲存類型從 SSD 切成 HDD,或反過來切換;若要改,需在另一個 Instance 還原資料並安排應用切換。線上隨機讀取通常先評估 SSD;HDD 則適合可容忍較高延遲、以掃描和寫入為主的工作負載。
# 建立 SSD 叢集
gcloud bigtable instances create my-instance \
  --display-name="Production" \
  --cluster-storage-type=SSD \
  --cluster-config=id=my-cluster,zone=asia-east1-a,nodes=3

# 建立 HDD 叢集(大量儲存場景)
gcloud bigtable instances create analytics-instance \
  --display-name="Analytics" \
  --cluster-storage-type=HDD \
--cluster-config=id=analytics-cluster,zone=us-central1-a,nodes=3流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart LR
  subgraph REQUIREMENT["1. 確認主要工作負載"]
    direction TB
    START["建立 Bigtable Instance"] --> ONLINE{"需要低延遲隨機讀取,<br/>支援線上服務?"}
    ONLINE -->|"否"| BATCH{"主要是大型循序掃描,<br/>且更重視容量成本?"}
  end
  subgraph CHOICE["2. 選擇儲存類型"]
    direction TB
    SSD["SSD<br/>低延遲、高隨機讀取吞吐"]
    HDD["HDD<br/>高容量、適合批次掃描"]
    REVIEW["以實際 Row 大小與查詢<br/>做負載測試及成本估算"]
  end
  ONLINE -->|"是"| SSD
  BATCH -->|"是"| HDD
  BATCH -->|"否或混合負載"| SSD
  SSD --> REVIEW
HDD --> REVIEW 儲存類型會套用到 Instance 的所有 Cluster,建立後不能直接切換。線上隨機讀取通常選 SSD;只有延遲要求較低、以大型掃描和容量成本為主時,才考慮 HDD。
Row Key 要同時顧查詢與寫入分布
Bigtable 依 Row Key 的字典序排列資料,再把連續的 Key 範圍切成 Tablet,分散到節點。Row Key 會影響能否有效讀取一段資料,也會影響新寫入是否集中。設計時先列出實際查詢,再檢查寫入分布。
避免熱點(Hotspot)
⚠️ 容易形成熱點的 Row Key:

  timestamp                  → 新寫入集中在相近範圍
  monotonic-id (1, 2, 3...)  → 同樣會持續寫到 Key 空間的一端

✅ 可依查詢方式評估的寫法:

  device + reverse timestamp → sensor-001#...
  hash prefix + entity       → a3f2#sensor-001
  region + device + timestamp → asia-east1#sensor-001#...
如果 Key 以正向或反向時間戳、單調增加的 ID 開頭,新資料容易落在同一段範圍,形成寫入熱點。增加節點不一定能解決這種集中流量。可考慮把高基數的設備 ID 放前面,但也要測試單一熱門裝置的流量。反向時間戳只改變排序,不能保證分散寫入;若評估分桶,也要計入範圍查詢與合併結果的代價。詳細設計原則見官方 Schema 指南。
時序資料的一種 Row Key 寫法
# IoT 感測器資料的 Row Key 設計
# 格式:device_id#reverse_timestamp
import struct
import time

device_id = "sensor-taipei-001"
reverse_ts = struct.pack(">q", (2**63 - 1) - time.time_ns() // 1000)
row_key = f"{device_id}#{reverse_ts.hex()}"

# 這樣同一個 device 的最新資料會排在最前面
# device 前綴是否分散負載,仍取決於 key 範圍與實際流量
Field Promotion(欄位提升)
將常用的查詢維度提升到 Row Key 中:
原始:sensor-001#2026-03-11T10:00:00
提升:asia-east1#sensor-001#2026-03-11T10:00:00

好處:可以高效查詢 "asia-east1 區域的所有感測器資料"流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  subgraph DESIGN["1. 設計可查詢且分散的 Key"]
    direction TB
    START["列出點查、<br/>前綴與範圍掃描<br/>提升常用查詢維度"] --> MONO{"Key 以時間戳或<br/>遞增 ID 開頭?"}
    MONO -->|"是"| SPREAD["改用 entity/hash 前綴<br/>必要時反轉時間戳"]
    MONO -->|"否"| RANGE["保留相關資料的<br/>連續前綴<br/>避免隨機到無法掃描"]
  end
  subgraph VERIFY["2. 用真實流量驗證"]
    direction TB
    TEST["依實際讀寫比例壓測<br/>用 Key Visualizer 看熱點"] --> RESULT{"分佈均勻且<br/>掃描範圍可控?"}
    RESULT -->|"否"| REDESIGN["調整前綴、<br/>salting 或拆表<br/>再重新測試"]
    RESULT -->|"是"| ADOPT["固定 Row Key 規格<br/>納入容量與監控基準"]
  end
  SPREAD --> TEST
RANGE --> TEST Row Key 是每張表的主要索引;若需要另一種查詢路徑,可能要額外設計資料或使用持續實體化檢視。先由實際查詢決定可掃描的前綴,再確認新寫入不會集中到少數 Tablet;Hash 也不能亂加,否則雖然分散寫入,卻可能讓範圍掃描變複雜。
Column Family 設計
什麼是 Column Family?
Column Family 是一組相關欄位的容器,也用來設定資料版本的保留規則。把更新頻率與保留需求接近的欄位放在一起,會比較容易管理;不必為每個欄位都建立一個 Family。
# 建立表格和 Column Family
cbt createtable sensors
cbt createfamily sensors profile
cbt createfamily sensors metrics
cbt createfamily sensors raw

# 寫入資料
cbt set sensors "sensor-001#2026" \
  profile:name="TempSensor" \
  profile:location="Taipei" \
  metrics:temp="25.3" \
  metrics:humidity="78"
設計原則
- 最多約 100 個 Column Family(這就是官方建議的上限,超過可能會拖累效能)
- 將經常一起讀取的欄位放同一個 Family
- 不同存取頻率的資料放不同 Family
- Column Family 名稱盡量簡短(佔用儲存空間)
垃圾回收(Garbage Collection)
Bigtable 的每個 Cell 都可以有多個版本(用時間戳區分)。垃圾回收策略就是決定哪些版本要留、哪些該清掉:
常見策略
# 只保留最新 1 個版本
cbt setgcpolicy sensors metrics maxversions=1

# 只保留 7 天內的版本
cbt setgcpolicy sensors raw maxage=7d

# 組合策略(Union):超過 7 天 OR 超過 3 個版本就刪除
cbt setgcpolicy sensors metrics "maxage=7d or maxversions=3"

# 組合策略(Intersection):超過 7 天 AND 超過 3 個版本才刪除
cbt setgcpolicy sensors metrics "maxage=7d and maxversions=3"垃圾回收是非同步執行的,設定後不會立即刪除舊資料。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  START["這個 Column Family<br/>要保留哪些 Cell 版本?"] --> RULE{"只用一種上限,<br/>還是組合年齡與版本數?"}
  RULE -->|"只看版本數"| VERSION["maxversions<br/>例如只留最新 1 版"]
  RULE -->|"只看資料年齡"| AGE["maxage<br/>例如只留最近 7 天"]
  RULE -->|"組合兩種條件"| COMBINE{"哪種情況<br/>應判定為過期?"}
  COMBINE -->|"任一上限超過"| UNION["Union:age OR versions<br/>較積極清理"]
  COMBINE -->|"兩個上限都超過"| INTERSECTION["Intersection:age AND versions<br/>保留時間較長"]
  VERSION --> ASYNC["套用 Policy;背景 Compaction<br/>會在之後非同步移除資料"]
  AGE --> ASYNC
  UNION --> ASYNC
INTERSECTION --> ASYNC GC Policy 是 Column Family 層級的生命週期規則。Union 適合「任何一項超標就清理」,Intersection 則要同時超過年齡與版本數才清理;兩者語意相反,部署前應用測試資料驗證。
複製(Replication)
Bigtable 可把資料複寫到多個叢集,讓應用在叢集故障時有其他路徑。讀取延遲是否改善,還要看 App Profile 如何路由,以及應用和叢集的位置:
# 新增第二個叢集到既有實例
gcloud bigtable clusters create my-cluster-2 \
  --instance=my-instance \
  --zone=asia-east1-b \
  --num-nodes=3
路由策略
| 策略 | 讀寫路徑與取捨 |
|---|---|
| Single-Cluster | 流量送到指定叢集;可讓同一應用維持 read-your-writes,故障時需自行切換路由 |
| Multi-Cluster | 可就近路由並在叢集不可用時自動轉移;跨叢集複寫是最終一致性,不支援單列交易 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
可用性 SLA 會隨路由方式、叢集所在區域等條件不同,正式設計前請查看官方 SLA。
# 設定 App Profile 為 Multi-Cluster 路由
gcloud bigtable app-profiles create multi-read \
  --instance=my-instance \
  --route-any
複製限制
- 一個 instance 的叢集可分佈在最多 8 個區域;每個 Zone 可放的叢集數仍受服務限制,規劃時請查官方叢集說明。入門階段先理解「多叢集帶來複寫與路由選擇」即可,不必把區域數當成選型依據。
- 複製是最終一致性(Eventually Consistent)
- 單叢集路由可以保證強一致性讀取
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  subgraph NEED["1. 判斷應用需求"]
    direction TB
    START["應用連線到多<br/>Cluster Instance"] --> CONSISTENCY{"需要 read-your-writes、<br/>單列交易<br/>或固定資料所在地?"}
    CONSISTENCY -->|"否"| AVAILABILITY{"更重視就近讀取與<br/>自動 Cluster 故障轉移?"}
  end
  subgraph ROUTING["2. 設定 App Profile"]
    direction TB
    SINGLE["Single-cluster routing<br/>固定指定 Cluster"]
    MULTI["Multi-cluster routing<br/>自動選擇可用 Cluster"]
  end
  subgraph EFFECT["3. 理解行為"]
    direction TB
    STRONG["可使用單列交易<br/>並取得一致的讀寫路徑"]
    EVENTUAL["寫入非同步複寫<br/>跨 Cluster<br/>讀取可能暫時看到舊值"]
  end
  CONSISTENCY -->|"是"| SINGLE
  AVAILABILITY -->|"是"| MULTI
  AVAILABILITY -->|"否"| SINGLE
  SINGLE --> STRONG
MULTI --> EVENTUAL Replication 與 App Profile 是兩層設定:Instance 決定有哪些 Cluster,App Profile 決定每類應用怎麼路由。Multi-cluster 提升可用性與就近存取,但應用必須容忍非同步複寫造成的短暫舊讀。
自動擴縮(Autoscaling)
Bigtable 支援 GA 的 Managed Autoscaling:
gcloud bigtable clusters update my-cluster \
  --instance=my-instance \
  --autoscaling-min-nodes=3 \
  --autoscaling-max-nodes=20 \
  --autoscaling-cpu-target=60
注意事項
- 最大 Node 數不能超過最小的 10 倍
- 適用 SSD 和 HDD 叢集
- 根據 CPU 使用率和儲存使用量自動調整
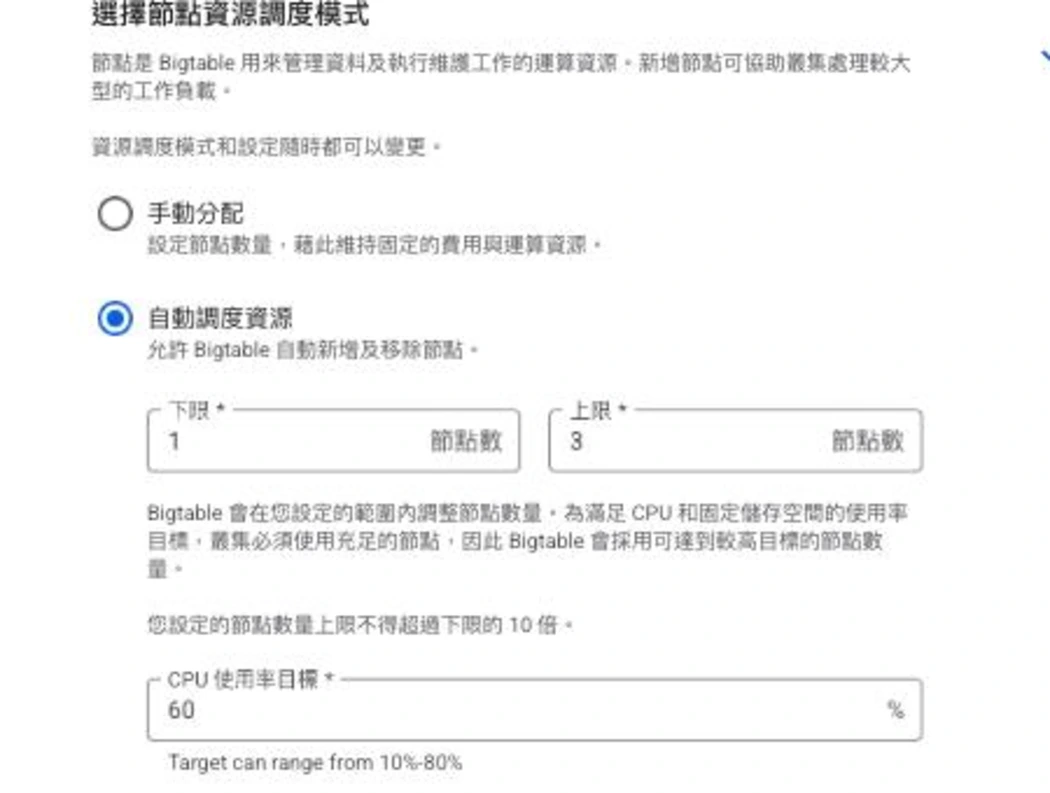
叢集要幾個節點,可以固定(手動分配)也可以交給 自動調度資源。設好下限/上限節點數,Bigtable 就依 CPU 使用率自動增減——注意畫面那句「上限不得超過下限的 10 倍」,正是上面提的限制;CPU 使用率目標預設 60%,延遲敏感的服務建議設更低。
Change Streams
Bigtable Change Streams(GA)讓你即時追蹤資料變更:
# 在前面建好的 sensors 表格啟用 Change Streams(保留 7 天)
gcloud bigtable instances tables update sensors \
  --instance=my-instance \
  --change-stream-retention-period=7d
常見用途
- 即時同步到 BigQuery 做分析(有 Dataflow 範本)
- 觸發 Pub/Sub 做事件驅動處理
- 歸檔到 Cloud Storage 做合規
- 同步到 Elasticsearch 做全文搜尋
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 32}}}%%
  flowchart TB
  APP["應用寫入、更新或刪除"] --> TABLE["啟用 Change Streams 的 Table<br/>產生資料變更紀錄"]
  TABLE --> PROFILE["使用 Single-cluster App Profile<br/>讀取各 Tablet Partition"]
  PROFILE --> PIPELINE["Dataflow Template、Beam Connector<br/>或 Java Client 平行處理"]
  PIPELINE -. "與線上資料共用 Cluster 運算" .-> CAPACITY["預留額外 CPU、讀取容量<br/>與 Change Stream 儲存成本"]
  PIPELINE --> BQ["BigQuery<br/>即時分析"]
  PIPELINE --> PS["Pub/Sub<br/>事件處理"]
PIPELINE --> ARCHIVE["Cloud Storage/其他系統<br/>稽核與歸檔"] Change Streams 是 CDC,不是獨立免費佇列。讀取端要使用 single-cluster App Profile,並為紀錄保存、Pipeline 與共享的 Cluster 運算預留容量;優先使用 Dataflow 範本或 Beam Connector 處理 Tablet 分割。
用 Key Visualizer 找寫入熱點
Key Visualizer 是 Bigtable 內建的視覺化診斷工具。它把存取模式畫成熱力圖,讓你看出某段 Row Key 是否承受了過多流量:
Key Visualizer 熱力圖(顏色 = 存取密度)

Row Key 範圍
  ▲
  │  ████████  ← 熱點!某段 Row Key 被集中存取
  │  ▒▒▒▒▒▒▒▒
  │  ░░░░░░░░
  │  ▒▒▒▒▒▒▒▒
  └──────────────────→ 時間
能診斷的問題
- 寫入熱點:某段 Row Key 範圍顏色特別深 → Row Key 設計不良
- 讀取傾斜:某些分片負載遠高於其他 → 考慮重新設計 Row Key
- 空洞區域:大片無存取 → 資料分佈不均勻
- 週期性尖峰:定時任務造成的流量集中
啟用條件
- 該表在每個叢集至少有 1 GB 資料量,Bigtable 才會產生 Key Visualizer 掃描資料(達到後可能還要等最多 1 小時)
- Console → Bigtable → Instance → Key Visualizer
Key Visualizer 適合看特定 Row Key 範圍是否過熱;若延遲升高,還要一起看 CPU、儲存使用量、網路和用戶端指標,不能只靠一張熱力圖下結論。官方排查流程也把這些項目一起列出。
監控與告警
關鍵監控指標
| 指標 | 怎麼看 |
|---|---|
| CPU utilization | 和自動擴縮目標、尖峰時的延遲一起看,留意最忙的節點 |
| Storage utilization | 對照儲存目標與節點容量,避免背景維護擠壓服務能力 |
| Request latency (p99) | 以服務自己的 SLO 當基準,分辨用戶端和 Bigtable 服務端延遲 |
| Error count | 先看錯誤類型與比例,再判斷是配額、逾時還是連線問題 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
以下 CPU 告警的 70% 只是示範門檻;正式環境要依工作負載的延遲要求與 autoscaling 設定調整。
# 用 Cloud Monitoring 建立 CPU 使用率告警
gcloud alpha monitoring policies create \
  --notification-channels=CHANNEL_ID \
  --display-name="Bigtable High CPU" \
  --condition-display-name="CPU > 70%" \
  --condition-filter='resource.type="bigtable_cluster" AND metric.type="bigtable.googleapis.com/cluster/cpu_load"' \
  --condition-threshold-value=0.7 \
  --condition-threshold-comparison=COMPARISON_GT
效能調校要點
- CPU 持續接近設定的目標:先看是否有整體容量不足,再評估增加節點或調整 autoscaling。
- 只有少數 Key 範圍變慢:用 Key Visualizer 檢查讀寫熱點,回頭看 Row Key 設計。
- 剛擴容後仍然慢:Bigtable 需要時間重平衡資料,先觀察負載與節點分布,不要假設新節點一加入就立即改善。
- 做效能測試:使用代表性的資料量與流量,先預熱,再量測足夠長的時間。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  subgraph OBSERVE["1. 確認症狀"]
    direction TB
    START["p99 延遲或錯誤率升高"] --> WARM{"新 Cluster 或剛改流量,<br/>尚未完成預熱?"}
    WARM -->|"否"| CPU{"CPU 或 Storage utilization<br/>持續接近目標上限?"}
  end
  subgraph ACTION["2. 對症處理"]
    direction TB
    PREWARM["以代表性流量預熱<br/>再重新量測"]
    SCALE["增加 Node 或調整<br/>Autoscaling<br/>上限/目標"]
    VISUALIZE["開啟 Key<br/>Visualizer<br/>檢查熱點、<br/>傾斜與週期尖峰"]
  end
  subgraph ROOT["3. 修正根因"]
    direction TB
    HOT{"熱度集中在少數<br/>Row Key 範圍?"}
    REDESIGN["重設 Row Key/拆表<br/>並重新進行壓測"]
    QUERY["檢查 Row 大小、Filter、<br/>掃描範圍與 Client 設定"]
  end
  WARM -->|"是"| PREWARM
  CPU -->|"是"| SCALE
  CPU -->|"否"| VISUALIZE
  VISUALIZE --> HOT
  HOT -->|"是"| REDESIGN
HOT -->|"否"| QUERY 加 Node 只能解決整體容量不足,不能消除單一 Row Key 範圍的熱點。先區分預熱、容量與資料分佈問題,才能避免「持續擴容但延遲沒有改善」。
Data Boost
Data Boost 使用獨立的無伺服器運算資源處理大量讀取,適合把批次掃描和線上流量分開。它有適用的讀取模式與配額限制,不是所有查詢都能直接搬過去:
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  START["應用要讀取 Bigtable 資料"] --> WORKLOAD{"工作負載類型"}
  WORKLOAD -->|"低延遲點查、線上 API、<br/>持續小範圍讀取"| NODE["一般 Data API 讀取<br/>使用 Cluster Node 容量"]
  WORKLOAD -->|"大型掃描、ETL、分析或<br/>BigQuery 聯邦查詢"| BOOST["Data Boost<br/>使用獨立 Serverless 運算"]
  NODE --> ONLINE["與線上讀寫共用 CPU<br/>納入 Autoscaling 與容量規劃"]
BOOST --> ISOLATED["降低批次掃描對線上 Cluster 的影響<br/>另依 SPU 計費與設定配額"] Data Boost 仍讀取同一份 Bigtable 資料,但把合適的大型分析讀取移到獨立運算資源;它不是所有查詢的加速開關,線上低延遲流量仍應使用一般 Data API 與 Cluster Node。
適合場景:批次分析、ETL 作業、BigQuery 聯邦查詢。
Data Boost 另外按 SPU(Serverless Processing Units)計費。使用前先看官方適用條件:它適合高吞吐掃描,不適合以單列點查為主的線上服務。
備份與還原
Bigtable 有託管備份功能,可以把表格還原成備份當下的內容(還原成新表格):
# 建立備份
gcloud bigtable backups create my-backup \
  --instance=my-instance \
  --cluster=my-cluster \
  --table=my-table \
  --retention-period=30d

# 從備份還原到新表格
gcloud bigtable instances tables restore \
  --source=my-backup \
  --source-instance=my-instance \
  --source-cluster=my-cluster \
  --destination=my-table-restored \
--destination-instance=my-instance備份重點:
- 標準備份的保留期上限依 Bigtable 版本而定(Enterprise 最長 90 天、Enterprise Plus 最長 365 天);30 天這個上限現在只適用於「備份複本(backup copy)」。實際以官方文件為準
- 備份與備份複本可還原到其他區域的 Bigtable 執行個體,但需要規劃複本位置、還原步驟與時間;這和多叢集複寫的自動路由不同,詳見官方備份說明
- 備份不計入 Node 運算費用,僅收取備份儲存費
多叢集複寫有助於服務持續運作,備份則讓你還原到先前的資料狀態。兩者解決的問題不同;規劃災難復原時,還要明確寫下可接受的中斷與資料遺失時間。
定價
Bigtable 的主要費用來自佈建節點、資料儲存與網路流量;Edition、區域、折扣、備份及複寫配置也會影響帳單。多叢集會保留多份資料,儲存費用不能只按一份算。這裡不列一組容易過期的單價,試算時請以官方定價頁和實際配置為準。
試用與最低費用
- 一般付費叢集按佈建的節點、儲存與網路用量計費;節點閒置時仍可能產生費用。
- Google Cloud 另提供限時 Bigtable 免費試用執行個體,適合先做功能與效能練習。
免費試用執行個體與一般付費叢集的條件不同。練習結束後,記得確認測試資源是否仍在運作。
Bigtable vs Firestore vs BigQuery
這三個服務都能存大量資料,但用途和查詢方式不同。先問「應用會怎麼讀」,再比較容量和價格。
| 要比較的事 | Bigtable | Firestore | BigQuery |
|---|---|---|---|
| 資料模型 | 以 Row Key 排列的寬列資料 | 文件與集合 | 用於分析的資料表 |
| 常見讀法 | 依 Key 找單列或掃描相近的 Key | 讀文件、依欄位條件查詢與即時監聽 | 用 SQL 掃描、彙總與分析大量資料 |
| 先確認 | Key 設計與讀寫分布能否符合需求 | 查詢、索引與用戶端同步是否需要 | 查詢量、資料載入與分析成本 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
選型公式
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart LR
  subgraph NEED["1. 判斷核心需求"]
    direction TB
    START["描述資料模型、查詢、<br/>延遲、規模與一致性"] --> SQL{"需要關聯式 SQL、ACID<br/>與全球 OLTP?"}
    SQL -->|"否"| ANALYTICS{"主要是 SQL 分析、BI<br/>或 ad-hoc 大範圍掃描?"}
    ANALYTICS -->|"否"| DOCUMENT{"Mobile/Web<br/>文件資料,<br/>需要即時同步<br/>或離線 SDK?"}
    DOCUMENT -->|"否"| WIDE{"PB 級時序/IoT,<br/>並以 Row Key<br/>做低延遲高吞吐存取?"}
  end
  subgraph SERVICE["2. 選擇服務"]
    SPANNER["Cloud Spanner<br/>全球關聯式 OLTP"]
    BIGQUERY["BigQuery<br/>分析型資料倉儲"]
    FIRESTORE["Firestore<br/>文件型應用資料"]
    BIGTABLE["Bigtable<br/>寬列型低延遲資料"]
    RECHECK["重新檢查 Cloud SQL、<br/>Storage<br/>或其他專用服務"]
  end
  SQL -->|"是"| SPANNER
  ANALYTICS -->|"是"| BIGQUERY
  DOCUMENT -->|"是"| FIRESTORE
  WIDE -->|"是"| BIGTABLE
WIDE -->|"否"| RECHECK 先分清「線上資料服務」與「分析查詢」。Bigtable 擅長已知 Row Key 模式的低延遲讀寫;BigQuery 擅長 SQL 掃描與聚合。資料量很大並不自動代表該選 Bigtable。
讀完後先檢查這幾件事
選 Bigtable 之前,試著回答:
- 主要查詢能否用 Row Key 或相近的 Key 範圍完成?
- 新寫入會不會一直落在同一段 Key?
- 工作負載需要低延遲隨機讀取,還是可以接受較慢的批次掃描?
- 需要多叢集讀取時,應用能否接受複寫期間短暫讀到舊資料?
- 節點、儲存、複寫與備份的費用是否都已估進去?
用幾個情境練習判斷
Q:需要存 PB 級的 IoT 感測器時序資料,選什麼? A:先看讀法。如果應用要按設備與時間範圍持續讀寫,Bigtable 值得測試;如果主要工作是跨設備做 SQL 分析,也要比較 BigQuery。只有「PB 級」還不足以決定。
Q:Bigtable 用時間戳作為 Row Key 會有什麼問題? A:單調增加的時間戳可能讓新寫入集中在相近的 Row Key 範圍,形成熱點。先用 Key Visualizer 確認流量分布,再評估設備 ID 或雜湊前綴;若要讓同一設備的新資料排在前面,可把反轉時間戳放在設備 ID 後面。改 Key 時也要檢查原本的範圍查詢是否仍方便。
Q:從 HBase 遷移到 GCP 最適合用什麼服務? A:Bigtable 提供 HBase API 的 Java 用戶端,可以列入候選;但 API 並非完全相同,資料搬遷、效能測試和切換流程仍要規劃。
Q:Bigtable 讀取延遲突然升高,如何診斷? A:先分辨是用戶端、網路還是 Bigtable 服務端變慢,再看 CPU、儲存、錯誤與 Key Visualizer。若只有某段 Key 過熱,調高節點數可能不是根本解法。
Q:Bigtable 和 BigQuery 有什麼不同? A:Bigtable 著重按 Row Key 讀寫資料;BigQuery 著重用 SQL 做分析。兩者也能放在同一條資料流程裡,分別服務線上應用與報表。
寫在最後
Bigtable 適合大量、以 Row Key 範圍讀寫的資料。Row Key 若讓新寫入集中在同一段範圍,就算增加節點也可能改善有限;因此設計前要把主要查詢與寫入模式一起列出來。若需求是文件同步或 SQL 分析,則應分別比較 Firestore 和 BigQuery,不要只因資料量大就選 Bigtable。
下一步往資料處理管線走 ACE-214:Dataflow 與 Managed Service for Apache Spark(原 Dataproc)怎麼選?,看 GCP 怎麼把資料搬進搬出、做轉換。
本站以 GCP-1xx 標示入門課程、ACE-2xx 標示進階課程。兩個系列會互相連結,可以按自己目前需要的主題閱讀。
資料庫選型系列
| 課程 | 服務 | 適合場景 |
|---|---|---|
| GCP-108 | Cloud SQL | 中小型 OLTP、傳統 SQL 應用 |
| GCP-112 | Firestore | Mobile/Web App、即時同步 |
| 本課 GCP-113 | Bigtable | PB 級 IoT/時序、低延遲高吞吐 |
| ACE-211 | BigQuery | PB 級分析、BI 報表 |
| ACE-213 | Spanner | 全球規模 OLTP、強一致性 |
| GCP-115 | Memorystore | 微秒級快取、Session 管理 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
還在比較資料庫?可以接著看 Google Cloud 資料庫怎麼選?。
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
Firestore 入門:文件資料、即時更新與存取規則
App 的資料適合放 Firestore 嗎?從文件模型、即時監聽和安全規則開始,再看費用與選型。
Cloud SQL 入門:版本、HA、連線與備份怎麼選
從資料庫版本與機型開始,說明 Cloud SQL 的高可用架構、安全連線、備份還原、讀取副本和成本取捨。
Cloud Memorystore 入門:快取該用哪種引擎?
資料庫查詢撐不住時,快取能幫什麼忙?比較 Redis、Valkey、Memcached 與部署設定。