
Dataflow 與 Managed Service for Apache Spark(原 Dataproc)怎麼選?
前言
同樣是資料處理工作,Dataflow 和 Managed Service for Apache Spark(原 Dataproc)常被放在同一題比較。如果團隊已有 Spark 程式,和從頭寫 Apache Beam 管線,要考慮的事情並不一樣;批次或串流需求也會影響選擇。
名稱先對一下:Google 在 2026 年 4 月把 Dataproc 和 Google Cloud Serverless for Apache Spark 併進這個新品牌,所以它現在有叢集部署(原 Dataproc on Compute Engine)和 serverless 部署(原 Google Cloud Serverless for Apache Spark,更早叫 Dataproc Serverless)兩種。舊教材和題庫可能還寫 Dataproc。官方說明改名不影響 API、client library、gcloud CLI 和 IAM 角色與權限名稱,所以 gcloud dataproc 指令、dataproc.googleapis.com API 和 roles/dataproc.* 角色都維持原樣,文中的指令照舊。
這篇會沿著現有程式框架、資料處理模式和維運責任來比較兩者,再用情境題練習怎麼選。
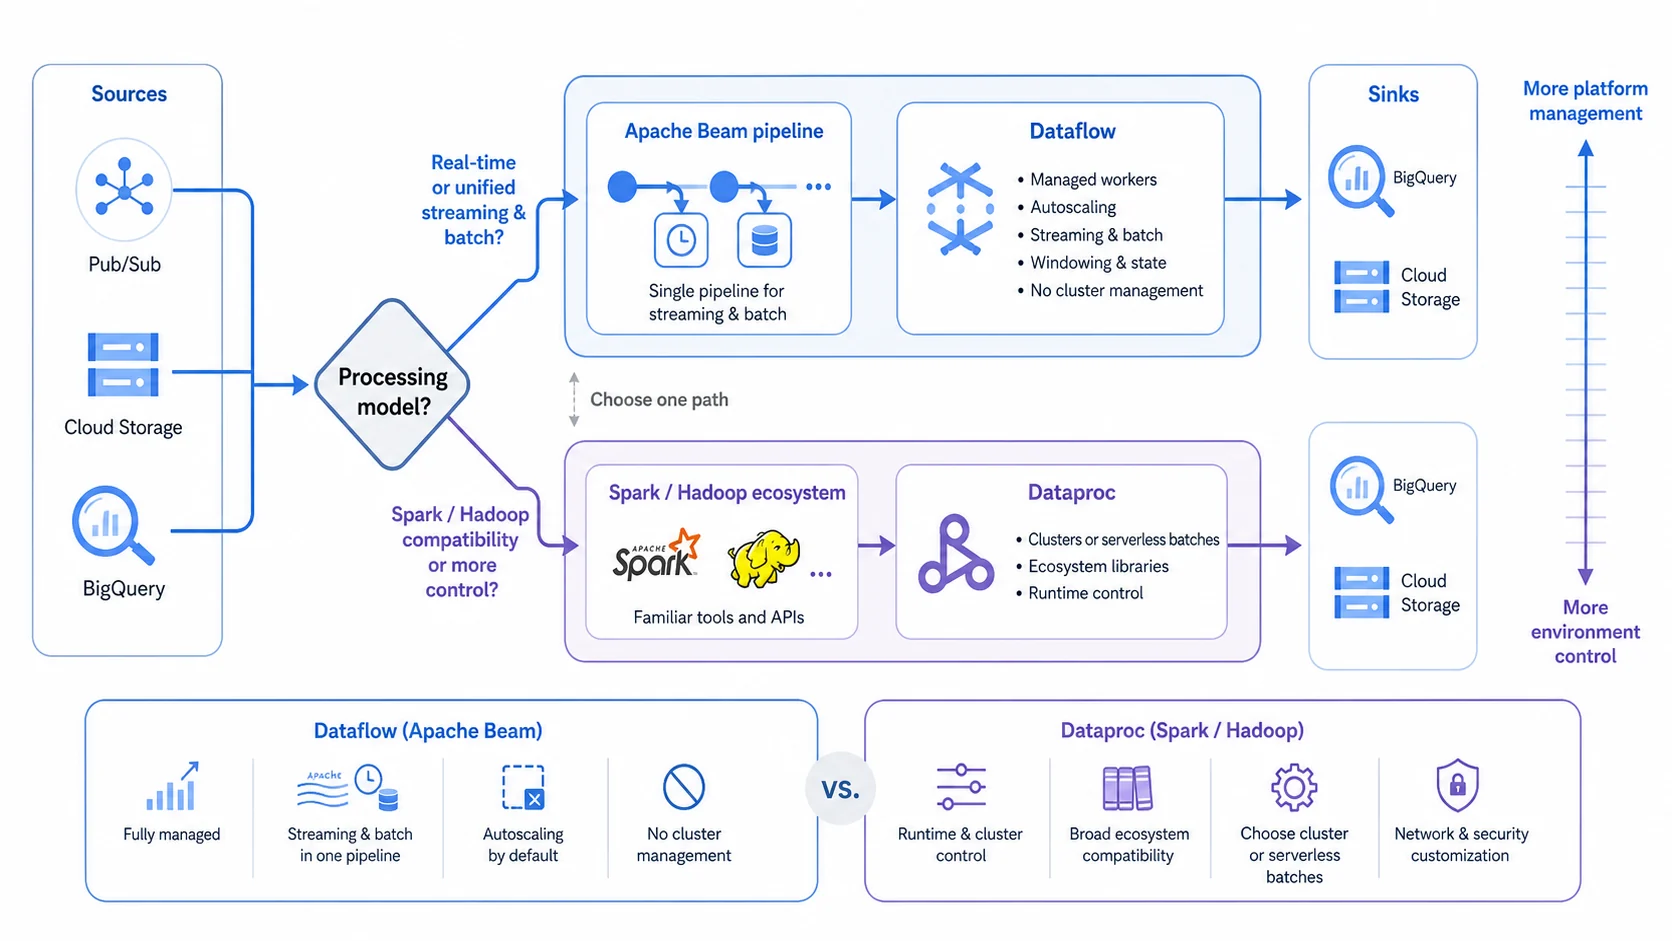
兩個服務先看處理模型與責任邊界:Dataflow 用 Beam 統一 batch/streaming、worker 與擴縮由平台管理;Managed Service for Apache Spark 保留 Spark/Hadoop API、生態工具與 runtime/cluster 控制,也可用 serverless batches。它們是各自從來源到 sink 的替代路徑,不必先跑 Dataflow 再跑 Spark 作業。圖中印的 Dataproc 是這個服務的舊名。
第一部分:Dataflow
什麼是 Dataflow?
Dataflow 是 GCP 的全託管資料處理服務,基於 Apache Beam 開源框架:
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  PS["Pub/Sub/Kafka<br/>無界串流"] --> READ["Beam I/O Read"]
  GCS["Cloud Storage/BigQuery<br/>有界批次"] --> READ
  READ --> PC["PCollection"]
  PC --> TRANSFORM["Map/Filter/GroupByKey"]
  TRANSFORM --> WINDOW["Window + Trigger<br/>切分串流時間"]
  WINDOW --> RUNNER["Dataflow Runner<br/>自動擴縮 Workers"]
  RUNNER --> BQ["BigQuery"]
  RUNNER --> BT["Bigtable"]
  RUNNER --> OUT["Cloud Storage/<br/>Pub/Sub"]
Dataflow 可以用 Apache Beam 定義批次和串流管線,worker 也由平台依負載擴縮。它支援 Exactly-once 處理語意,但資料寫入外部系統時,仍要確認使用的連接器和目的地怎麼處理重試與重複資料。SDK 有 Java、Python 和 Go。
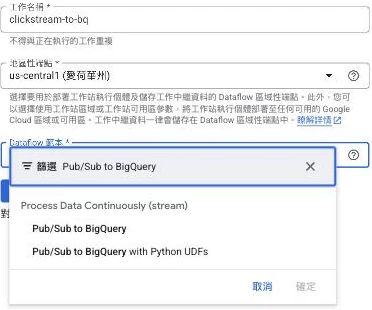
別急著擔心要不要寫 Beam——真正常見的串流 ETL,Google 早就幫你備好範本了。這是 Dataflow「依據範本建立工作」的畫面,範本下拉篩到 Process Data Continuously (stream) 分類,第一個就是招牌的 Pub/Sub to BigQuery:把 Pub/Sub 訊息即時倒進 BigQuery,你連一行 Beam 都不用碰,選範本、填幾個參數就跑。所以後面那題「即時處理 Pub/Sub 訊息流寫入 BigQuery 選什麼」答案是 Dataflow,靠的正是這類現成範本,不是要你真的去手刻 pipeline。
Apache Beam 程式設計模型
下面這段不用看懂語法,重點看它的結構:讀檔 → 轉換 → 過濾 → 寫進 BigQuery,這就是一條 pipeline 的長相。考試不會叫你寫 Beam,但看到這種「一管接一管」的串接,要認得出它是一條資料處理管線。
import apache_beam as beam
from apache_beam.options.pipeline_options import PipelineOptions

options = PipelineOptions([
    "--runner=DataflowRunner",
    "--project=my-project",
    "--region=asia-east1",
    "--temp_location=gs://my-bucket/temp",
])

with beam.Pipeline(options=options) as p:
    (
        p
        | "Read" >> beam.io.ReadFromText("gs://my-bucket/input.csv")
        | "Parse" >> beam.Map(lambda line: line.split(","))
        | "Filter" >> beam.Filter(lambda row: float(row[2]) > 100)
        | "Format" >> beam.Map(lambda row: {"name": row[0], "value": float(row[2])})
        | "Write" >> beam.io.WriteToBigQuery(
            "my-project:dataset.table",
            schema="name:STRING,value:FLOAT"
        )
    )
核心概念
| 概念 | 說明 |
|---|---|
| Pipeline | 整個資料處理流程 |
| PCollection | 資料集合(不可變、可分散) |
| Transform | 資料轉換操作(Map、Filter、GroupByKey) |
| Runner | 執行引擎(DataflowRunner、DirectRunner) |
| Window | 時間視窗,將無限串流切成有限區間 |
| Trigger | 何時輸出視窗結果 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
Windowing(時間視窗)
串流資料是源源不絕的,沒有結尾,那要怎麼做「每 5 分鐘的總和」這種統計?答案就是 Windowing(時間視窗)——把無止盡的資料切成一段段,每一段各自算各自的。
下面四種視窗看一眼結構就好,重點是認得它們各自解決什麼問題(比較表在後面):
import apache_beam as beam
from apache_beam import window

# 固定視窗:每 5 分鐘一個區間
events | beam.WindowInto(window.FixedWindows(300))

# 滑動視窗:30 分鐘大小,每 5 分鐘滑動一次
events | beam.WindowInto(window.SlidingWindows(1800, 300))

# Session 視窗:10 分鐘無活動就結束 session
events | beam.WindowInto(window.Sessions(600))

# Global 視窗:所有資料在同一個視窗(批次模式預設)
events | beam.WindowInto(window.GlobalWindows())
視窗類型比較
| 視窗 | 大小 | 重疊 | 適合場景 |
|---|---|---|---|
| Fixed | 固定 | 不重疊 | 每 N 分鐘聚合 |
| Sliding | 固定 | 重疊 | 移動平均、趨勢 |
| Session | 動態 | 不重疊 | 用戶行為分析 |
| Global | 無限 | — | 批次處理 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  START{"資料是否為持續串流?"}
  START -->|"否:整批資料一次計算"| GLOBAL["Global Window"]
  START -->|"是"| QUESTION{"要回答哪種時間問題?"}
  QUESTION -->|"每個不重疊區間的總和<br/>例如每 5 分鐘"| FIXED["Fixed Window"]
  QUESTION -->|"滾動趨勢或移動平均<br/>區間彼此重疊"| SLIDING["Sliding Window"]
  QUESTION -->|"依使用者活動切段<br/>沉默一段時間才結束"| SESSION["Session Window"]
  FIXED --> TRIGGER["Trigger 決定何時輸出"]
  SLIDING --> TRIGGER
SESSION --> TRIGGER 考試不會要你寫 Beam,但要認得這四種視窗分別解決什麼問題:固定區間統計用 Fixed、移動平均/趨勢用 Sliding、依使用者活動切段用 Session、整批一次處理用 Global。
Exactly-once 處理
Dataflow 預設就是 Exactly-once 語義:
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  SOURCE["Pub/Sub 事件<br/>可能 at-least-once 重送"] --> READ["Dataflow 讀取事件"]
  READ --> SEEN{"事件與處理狀態<br/>是否已完成?"}
  SEEN -->|"是:重複投遞"| SKIP["略過重複計算"]
  SEEN -->|"否"| WORK["Transform/Window/Aggregate"]
  WORK --> CHECKPOINT["持久化狀態與 Checkpoint"]
  CHECKPOINT --> SINK["寫入支援一致性語意的 Sink"]
  SINK --> DONE["確認來源進度"]
  SKIP --> DONE
READ -. "失敗則從 checkpoint 重試" .-> WORK 如果不需要 Exactly-once(例如日誌聚合允許少量誤差),可以切換到 At-least-once 模式以獲得更低延遲和更低成本。
Flex Templates vs Classic Templates
| 特性 | Classic Templates | Flex Templates(推薦) |
|---|---|---|
| 打包方式 | GCS 上的 JSON | Docker Image |
| 依賴管理 | 打包時固定 | 執行時解析 |
| 執行參數 | 部分限制 | 完全靈活 |
| 自訂環境 | 不支援 | Docker 自訂 |
| DAG 形狀 | 打包時固定 | 執行時動態 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
# 建立 Flex Template
gcloud dataflow flex-template build \
  gs://my-bucket/templates/my-pipeline.json \
  --image-gcr-path=asia-east1-docker.pkg.dev/my-project/my-repo/my-pipeline:latest \
  --sdk-language=PYTHON \
  --flex-template-base-image=PYTHON3 \
  --py-path=. \
  --env=FLEX_TEMPLATE_PYTHON_PY_FILE=pipeline.py

# 執行 Flex Template
gcloud dataflow flex-template run my-job \
  --template-file-gcs-location=gs://my-bucket/templates/my-pipeline.json \
  --region=asia-east1 \
  --parameters input=gs://my-bucket/input.csv
FlexRS(彈性資源排程)
這是批次作業省錢的招數,做法是混合用一般 VM 和可回收 VM(官方文件原文用 preemptible VM,概念上等同現在的 Spot VM):
# FlexRS 透過 Flex Template 執行時以 --flexrs-goal 旗標設定
gcloud dataflow flex-template run my-batch-job \
  --template-file-gcs-location=gs://my-bucket/templates/my-pipeline.json \
  --region=asia-east1 \
  --flexrs-goal=COST_OPTIMIZED  # 成本優化(或 SPEED_OPTIMIZED)

# 或在 SDK pipeline options 中設定:Python/Go 用 --flexrs_goal=COST_OPTIMIZED,Java 用 --flexRSGoal=COST_OPTIMIZED- 比一般批次便宜約 40%
- 延遲啟動(最長 6 小時內開始)
- 適合非即時的批次 ETL
Dataflow 定價
| 資源 | Batch | Streaming |
|---|---|---|
| vCPU | $0.056 / hr | $0.069 / hr |
| 記憶體 | $0.003557 / GB-hr | $0.003557 / GB-hr |
| 磁碟(HDD) | $0.000054 / GB-hr | $0.000054 / GB-hr |
| 磁碟(SSD) | $0.000298 / GB-hr | $0.000298 / GB-hr |
| Shuffle | $0.011 / GB | — |
| Streaming Engine | — | $0.018 / GB |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
Dataflow 沒有免費層,但 Google Cloud 新帳號有 $300 免費試用額度。
第二部分:Managed Service for Apache Spark
什麼是 Managed Service for Apache Spark?
Managed Service for Apache Spark(原 Dataproc)是 GCP 的託管 Spark/Hadoop 服務,有叢集和 serverless 兩種部署。如果你團隊本來就在跑 Spark 或 Hadoop,又不想自己維護那一堆 master/worker、裝 YARN、調 HDFS,它的叢集部署就是把這套叢集交給 Google 託管,適合已經有一整套大數據生態系的團隊:
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  JOB["Spark/Hadoop/Hive Job"] --> MASTER["Master Nodes 1~3<br/>排程與叢集控制"]
  MASTER --> YARN["YARN Resource Manager"]
  MASTER --> META["HDFS NameNode/Hive Metastore"]
  YARN --> PRIMARY["Primary Workers<br/>Executor + DataNode + NodeManager"]
  YARN --> SECONDARY["Secondary Workers<br/>純運算,可使用 Spot VM"]
  PRIMARY --> HDFS["HDFS 資料區塊"]
  SECONDARY -. "不保存 HDFS 資料" .-> HDFS
  AUTO["Autoscaling Policy"] -. "調整 worker 數量" .-> PRIMARY
  AUTO -.-> SECONDARY
幾個第一次出現的詞先解釋:YARN(Hadoop 的資源排程器,負責分配 CPU/記憶體給各個運算工作)、HDFS(Hadoop Distributed File System,Hadoop 的分散式檔案系統,把資料切塊分散存在多台機器上)、Hive Metastore(記錄資料表 schema 的目錄服務,Hive 查 SQL 時靠它知道資料長怎樣)。Master Node 同時扛著這三個角色,所以高可用(HA)模式才需要 3 個 master 互為備援。
叢集部署支援的框架
| 框架 | 用途 |
|---|---|
| Apache Spark | 批次/串流處理、ML |
| Apache Hadoop | MapReduce 批次處理 |
| Apache Hive | SQL-on-Hadoop |
| Apache Pig | 資料轉換腳本 |
| Trino | 互動式 SQL 查詢 |
| Apache Flink | 串流處理 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
serverless 部署(原 Dataproc Serverless)
serverless 部署(GA,API / IAM / gcloud 指令沒有跟著改名)不用自行佈建叢集,提交 Spark Job 即可:
# 提交 Serverless Spark 作業
gcloud dataproc batches submit spark \
  --region=asia-east1 \
  --jars=gs://my-bucket/my-app.jar \
  --class=com.example.MySparkJob \
-- arg1 arg2| 特性 | 叢集部署 | serverless 部署 |
|---|---|---|
| 管理 | 自建叢集 | 全託管 |
| 啟動時間 | 120 秒 | 50 秒 |
| 計費 | 叢集存續期間 | 作業執行期間 |
| 自訂 | 完全自訂 | 限 Spark |
| 適合 | 長時間運行叢集 | 短期批次作業 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
啟動時間取自官方部署比較表(Startup time:serverless 50s、cluster 120s);叢集總覽頁另寫啟動、擴縮、關閉每項操作平均 90 秒或更短(on average)。兩處口徑不同,都是概略值。
自動擴縮(Autoscaling)
# 自動擴縮策略寫成 YAML 檔,再用 import 建立(gcloud 沒有 autoscaling-policies create)
cat > my-policy.yaml <<'EOF'
workerConfig:
  minInstances: 2
  maxInstances: 20
basicAlgorithm:
  cooldownPeriod: 2m
  yarnConfig:
    scaleUpFactor: 1.0
    scaleDownFactor: 0.5
    gracefulDecommissionTimeout: 1h
EOF

gcloud dataproc autoscaling-policies import my-policy \
  --source=my-policy.yaml \
  --region=asia-east1

# 套用到叢集
gcloud dataproc clusters create my-cluster \
  --region=asia-east1 \
  --autoscaling-policy=my-policy \
  --num-workers=3
叢集部署的自動擴縮目前只支援 YARN-based 的應用(Spark、Hadoop、Hive)。要特別留意的限制:官方明列 Autoscaling 不支援 Spark Structured Streaming,所以串流作業別指望它自動長機器。
Spot VM 支援
Secondary Workers 可以使用 Spot VM 來降低成本:
gcloud dataproc clusters create my-cluster \
  --region=asia-east1 \
  --num-workers=3 \
  --num-secondary-workers=5 \
--secondary-worker-type=spot- Spot VM 的 Compute Engine 單價對許多機型最高可省 91%(叢集部署的管理費照常計算)
- Secondary Workers 不儲存 HDFS 資料,被回收不影響資料
📝 考場提點
「省錢」題要看是哪一邊的省錢,兩招別搞混:
招數 屬於 省多少 代價 / 關鍵字 FlexRS Dataflow 批次 約 40% 延遲啟動(最長 6 小時內開始),題目強調「非即時批次 + 省錢」 Spot / Secondary Workers 叢集部署 VM 單價最高省 91% VM 可能被回收,但 Secondary Workers 不存 HDFS 所以資料安全;題目強調「叢集還要更便宜」 表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
判斷訊號:「非即時批次、可以等」→ FlexRS;「叢集部署要再壓成本」→ Secondary Workers 用 Spot VM。順帶提醒前面那個限制:叢集部署的 Autoscaling 不支援 Spark Structured Streaming,串流作業別期待它自動擴縮。
Component Gateway
Component Gateway 讓你安全存取 Web UI(無需 SSH Tunnel):
gcloud dataproc clusters create my-cluster \
  --region=asia-east1 \
  --enable-component-gateway \
  --optional-components=JUPYTER
支援的 Web UI:
- Spark UI
- YARN Resource Manager
- Jupyter Notebook
- Zeppelin
Managed Service for Apache Spark 定價
叢集部署除了底層 VM,還要付一筆管理費(官方定價頁稱 management fee):
叢集部署費用 = Compute Engine VM 費用 + 管理費

管理費:$0.01 / vCPU / 小時
以 1 個 master+2 個 worker、每台 4 vCPU 為例(管理費涵蓋 master 在內的所有 vCPU):
管理費:12 vCPU × $0.01 = $0.12/hr
Compute Engine:VM 與磁碟費用另計,依機型與區域查 Compute Engine 定價
serverless 部署的計費方式不同:依實際用到的資源按秒計費,計費單位是 Data Compute Unit(DCU),另外還有 shuffle 儲存和附掛加速器的費用。
選型:什麼時候用哪一個
核心差異
下表右欄指的是叢集部署;serverless 部署的差異看前面「serverless 部署」一節的對照表。
| 特性 | Dataflow | Managed Service for Apache Spark(叢集部署) |
|---|---|---|
| 基礎 | Apache Beam | Spark / Hadoop |
| 管理 | 全託管 | 自建叢集 |
| 擴縮 | 完全自動 | 需設定策略 |
| 語言 | Java, Python, Go | Java, Scala, Python, SQL(R 透過 SparkR) |
| 串流 | 原生支援 | Spark Structured Streaming |
| 精確度 | Exactly-once(預設) | 依 Spark 引擎模式與 sink 而定 |
| 延遲 | 秒級 | 秒~分鐘級 |
| 生態系 | Beam I/O Connectors | 完整 Hadoop/Spark 生態 |
| GPU | 支援 | 支援 |
| 最適合 | 新建 ETL / 串流 | 已有 Spark/Hadoop 程式 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
選型公式
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  START{"已有必須原樣保留的<br/>Spark/Hadoop 程式嗎?"}
  START -->|"是"| LIFE{"作業生命週期?"}
  LIFE -->|"長駐、需要 Hive/<br/>Trino/Jupyter<br/>或完整環境控制"| DATAPROC["Managed Service<br/>for Apache Spark<br/>叢集部署"]
  LIFE -->|"短期 Spark 批次<br/>不想管叢集"| SERVERLESS["Managed Service<br/>for Apache Spark<br/>serverless 部署"]
  START -->|"否:新建資料管線"| MODEL{"需要串流、Windowing<br/>或預設 Exactly-once?"}
  MODEL -->|"否:一般批次"| CONTROL{"要 Beam 全託管<br/>還是 Spark 生態?"}
  MODEL -->|"是"| DATAFLOW["Dataflow<br/>+ Apache Beam"]
  CONTROL -->|"Spark 相容性"| SERVERLESS
CONTROL -->|"Beam、免管 worker"| DATAFLOW 📝 考場提點
選型題就是在比對「關鍵字訊號」。看到題目出現「全託管 / 不想管叢集 / 全新建立 / 串流 / Exactly-once」,往 Dataflow 想;看到「已有 Spark/Hadoop 程式碼 / Hive / Pig / Trino / lift-and-shift(原封不動搬上雲)遷移」,往 Managed Service for Apache Spark 想。
如果題目要求既有 Spark job 上雲,且不打算改寫處理邏輯,優先考慮 Managed Service for Apache Spark。Dataflow 使用 Apache Beam,不能直接把 Spark 程式當成 Beam 管線執行。
與其他服務的關係
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  APPS["應用程式事件"] --> PUB["Pub/Sub<br/>接收、緩衝與重送"]
  PUB --> FLOW["Dataflow<br/>解析、去重、<br/>Window、聚合"]
  FLOW --> BQ["BigQuery<br/>歷史分析"]
  FLOW --> BT["Bigtable<br/>低延遲即時查詢"]
  BQ --> LOOKER["Looker/BI 報表"]
  PUB -. "若只是原樣匯出<br/>可用直接訂閱" .-> DIRECT["BigQuery/Cloud<br/>Storage Subscription"]
ACE 考試重點整理
必背知識點
- Dataflow = 全託管 + Apache Beam + 自動擴縮 + Exactly-once
- Managed Service for Apache Spark = 託管 Spark/Hadoop(叢集或 serverless 部署)+ 開源生態系
- 新建管線選 Dataflow,遷移 Spark 選 Managed Service for Apache Spark
- Windowing:Fixed(定時聚合)、Sliding(移動平均)、Session(用戶行為)
- serverless 部署(原 Dataproc Serverless,2026-04 起併入 Managed Service for Apache Spark):不用管叢集的 Spark
- FlexRS:Dataflow 批次的成本優化,省約 40%
- Dataflow Flex Templates:Docker 打包,取代 Classic Templates
常見陷阱題
Q:需要即時處理 Pub/Sub 訊息流並寫入 BigQuery,選什麼? A:Dataflow。它支援全託管串流處理;實際寫入語意仍要看所用的範本或連接器。
Q:已有 Spark ML Pipeline 要上雲,選什麼? A:Managed Service for Apache Spark。直接跑既有 Spark 程式碼,不需要改寫成 Beam。
Q:Dataflow 和 Pub/Sub 有什麼不同? A:Pub/Sub 是訊息佇列(接收和分發訊息),Dataflow 是處理引擎(轉換、聚合、寫入)。兩者通常搭配使用。
Q:需要跑 Hive SQL 查詢大量歷史資料,選什麼? A:Managed Service for Apache Spark。Hive 是 Hadoop 生態系的工具,在 GCP 上由它的叢集部署託管支援。(補充:BigQuery 也能透過外部資料表查詢 Hive 分區資料。)
Q:Dataflow 的 Exactly-once 和 Pub/Sub 的 At-least-once 有衝突嗎? A:不衝突。Pub/Sub 可能重複投遞;Dataflow 的處理語意和下游系統的寫入語意要分開看,不能只憑前者就認定目的地絕不會出現重複資料。
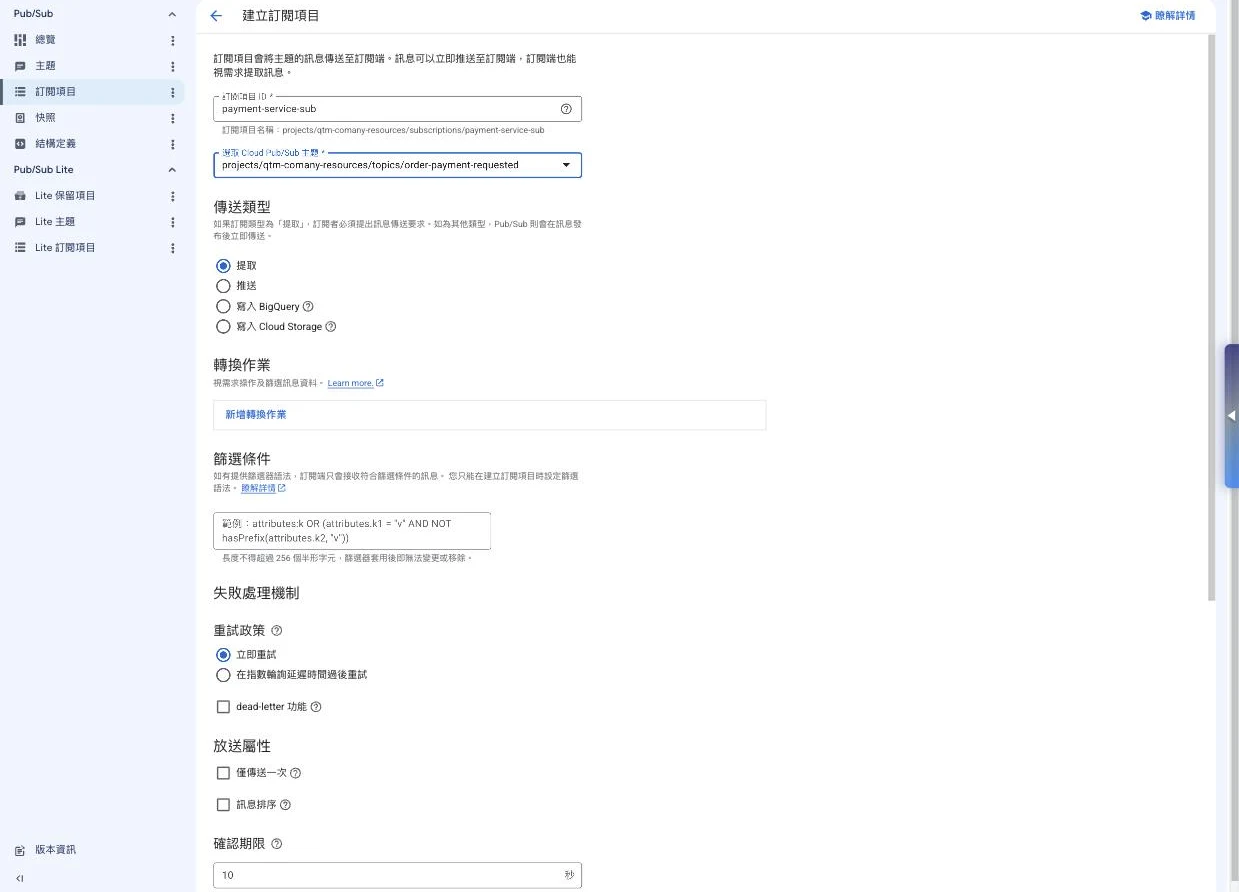
這是 Pub/Sub 建立訂閱的設定頁,正好對上前面那句「Pub/Sub 是管道、Dataflow 是處理引擎」。畫面裡有兩個值得留意的細節:一是「傳送類型」除了提取/推送,還能直接寫入 BigQuery/Cloud Storage——單純搬運根本不必動用 Dataflow;二是僅一次投遞(exactly-once)這個開關,提醒你 Pub/Sub 預設是 at-least-once(可能重複投遞),下游要不重不漏,要嘛在這裡開,要嘛靠 Dataflow 內部去重,這正是上面那題的答案。
總結
選資料處理平台時,先看團隊已有的程式碼和作業型態。新管線若要用 Apache Beam 處理批次與串流,可以評估 Dataflow;已有 Spark 或 Hadoop 作業,則先比較 Managed Service for Apache Spark 的遷移成本。若只需要執行 Spark 工作,也可評估它的 serverless 部署,省去叢集維運。
真正要確認的是資料如何進來、處理後寫到哪裡,以及失敗或重複寫入時怎麼處理。以下是各平台提供的能力,不能單憑一個功能名稱就推定整條管線的寫入語意。
Dataflow: 全託管 Apache Beam、自動擴縮、預設 Exactly-once;批次和串流共用一份程式碼;Windowing 分 Fixed / Sliding / Session / Global;打包用 Flex Templates(Docker),批次省錢用 FlexRS(約 40%)。
Managed Service for Apache Spark: 託管 Spark / Hadoop / Hive / Trino 叢集;不想養叢集就用它的 serverless 部署;Secondary Workers 配 Spot VM,VM 單價最高省 91%;Web UI 靠 Component Gateway 進去。
下一課 GCP-114:Cloud DNS 入門,來看看 GCP 的全託管 DNS 服務怎麼用。
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
地端連 Google Cloud:VPN 與 Interconnect 怎麼選?
機房和 Google Cloud 要互通,該選 VPN 還是專線?從目的地、頻寬、加密和備援要求,一步步釐清選型。
Terraform、Infrastructure Manager、Config Connector 怎麼選?
同樣是用程式碼管理 GCP 資源,三種工具各接手哪一段?比較設定語法、State 與維運責任。
Cloud Spanner 何時比 Cloud SQL 合適?
需要跨區域的關聯式交易時,Spanner 能解什麼問題?從容量、主鍵設計到多區域配置比較。