
企業資料庫 AI Agent:NL2SQL 不等於直接執行
課程概述
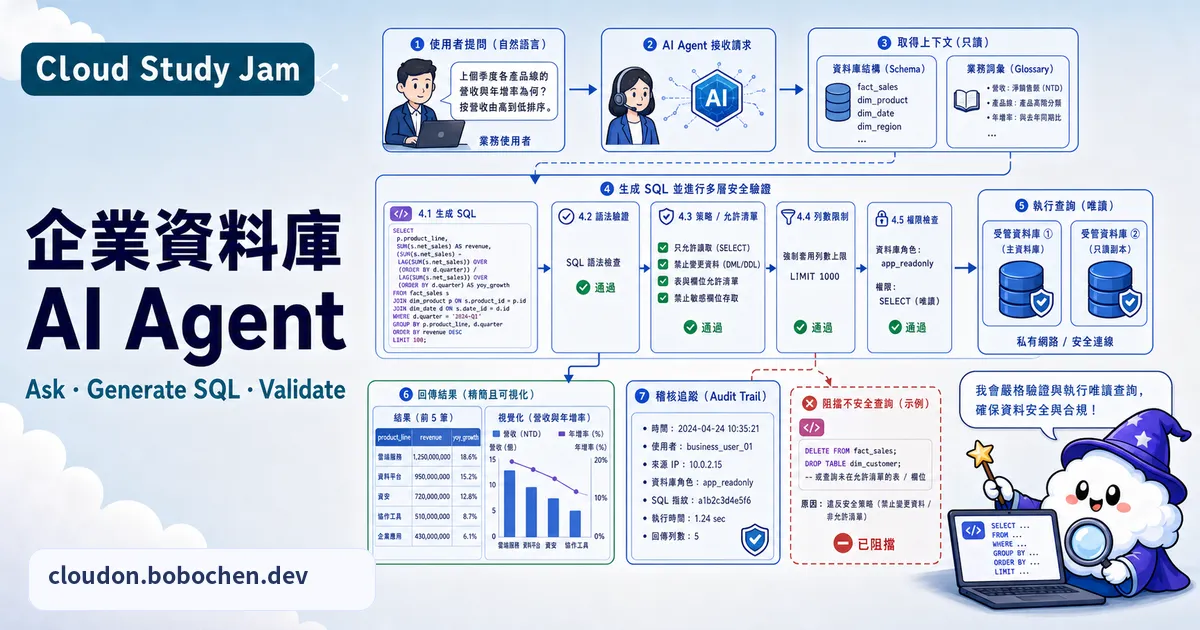
讓使用者用自然語言問銷售、庫存或營運資料,確實能減少來回寫報表的時間;但 NL2SQL 只是在「問題」和「查詢」之間多一層翻譯,不會自動理解公司的指標定義,也不會替資料庫守住權限。這篇會把 Schema 語意、QueryData、SQL 驗證、唯讀執行與寫入核准拆開,讓 Agent 可以協助查資料,卻不能拿一段看似合理的 SQL 直接碰正式資料庫。
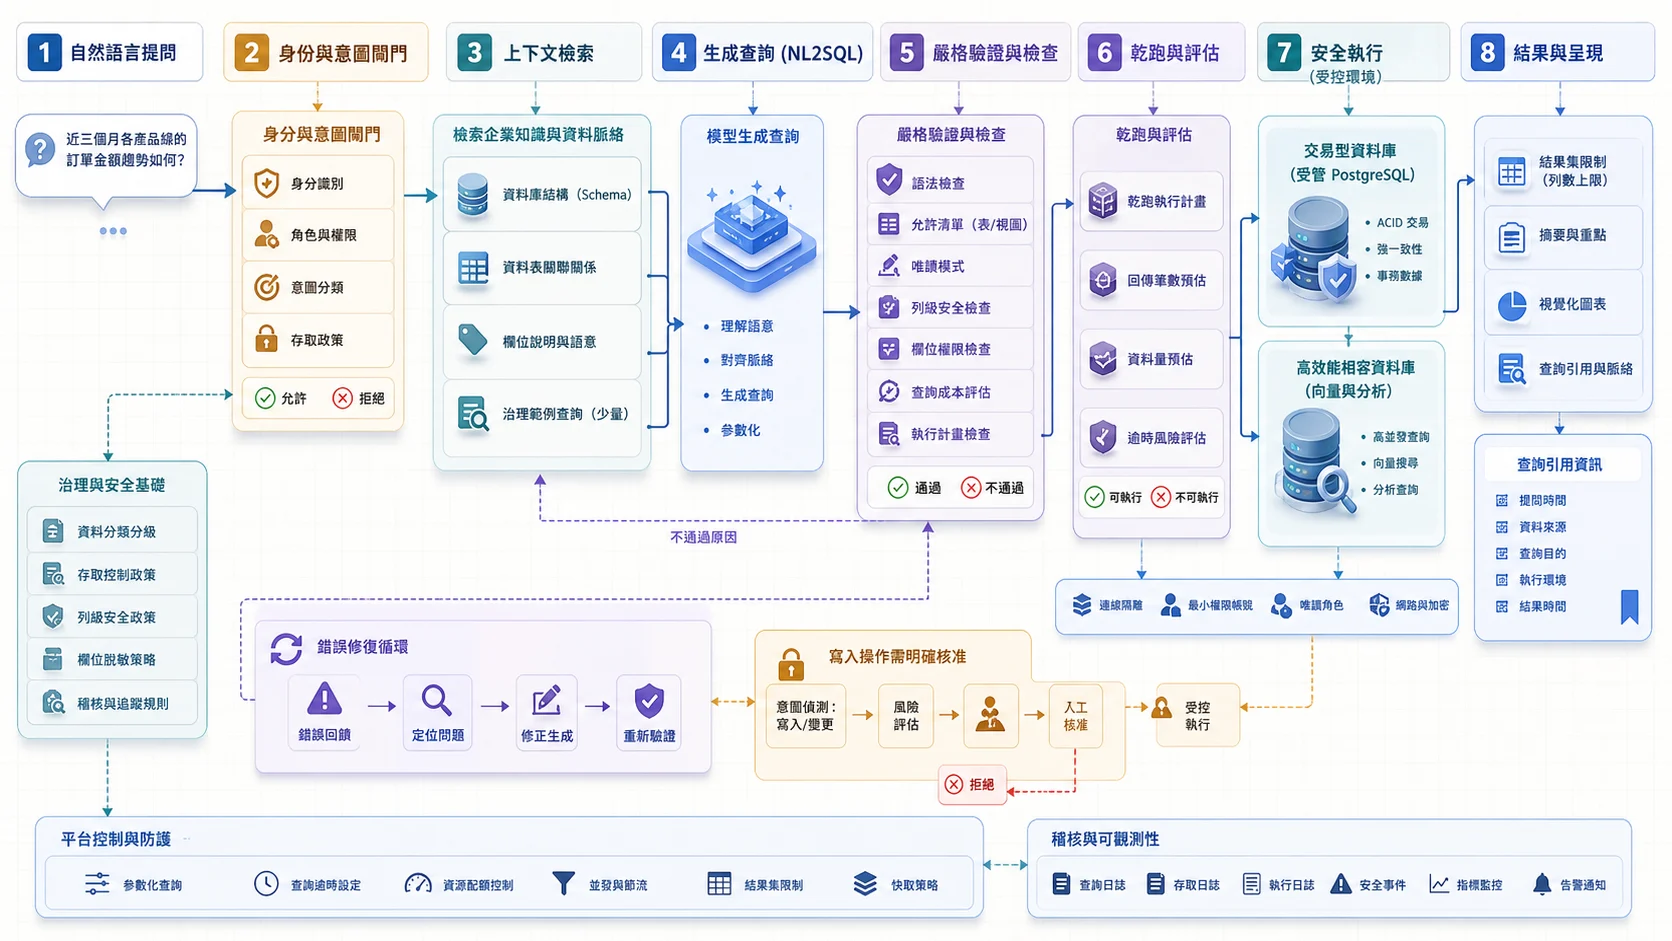
NL2SQL 的品質高度依賴 Schema、指標和範例,安全性則依賴模型外部的資料庫權限。查詢要限時、限量、限制物件並先看執行計畫;資料變更另走交易、影響預覽與人工核准,所有查詢和結果來源都要可稽核。
你將學到
- 理解 NL2SQL、QueryData 與一般工具呼叫的差異
- 建立包含 Schema、指標、關聯、值與範例的 Context Set/語意層
- 用資料庫角色、唯讀 View、Row/Column Policy 和查詢預算阻擋越權
- 分開讀取、資料變更與高風險操作的執行路徑
- 判斷 Cloud SQL、AlloyDB AI、向量搜尋與 AI Functions 的適用需求
核心概念
現在不只一條 NL2SQL 路徑
最簡單的做法是把 Schema 和問題丟給模型,請它生成 SQL;這適合原型,不適合直接上線。Google Cloud 在 2026 年推出 Preview 的 QueryData,可為 Cloud SQL、AlloyDB 與 Spanner 建立資料庫專屬 Context Set,再由 Data Agent 產生查詢。AlloyDB 原有的 alloydb_ai_nl 擴充功能也仍在 Preview,但官方文件已建議新一代 Text-to-SQL 工作優先評估 QueryData。
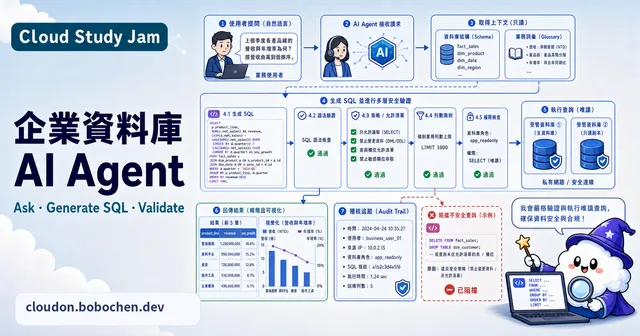
不論使用哪一條路徑,完整流程都包含:
- 身分與範圍:先確認使用者能查哪些資料、地區與期間
- Context 選取:取回相關表、欄位、指標、Join、範例與值對應
- 查詢生成:產生 SQL 或資料庫查詢,必要時請使用者釐清問題
- 靜態與資料庫驗證:限制 Statement、Schema、View、成本、列數與時間
- 受控執行:以原使用者或受限 Agent 身分執行,保留稽核資料
- 結果詮釋:附上指標定義、資料時間與查詢來源,不把空值腦補成結論
為什麼 Schema 描述很關鍵?
光靠 cust_id、gmv 這些欄位名稱,模型不會知道它們在公司裡的真正定義。好的 Context Set 或語意層至少要包含:
- 每張表的業務用途說明
- 每個欄位的中文意義、單位、值域與敏感等級
- 指標公式、時區、會計期間、取消訂單和退貨等納入規則
- 表與表的 Join 路徑、基數與不可使用的欄位
- 經資料擁有者審核的自然語言問題與參數化 SQL 範例
- 常見同義詞與資料庫裡實際值的對應
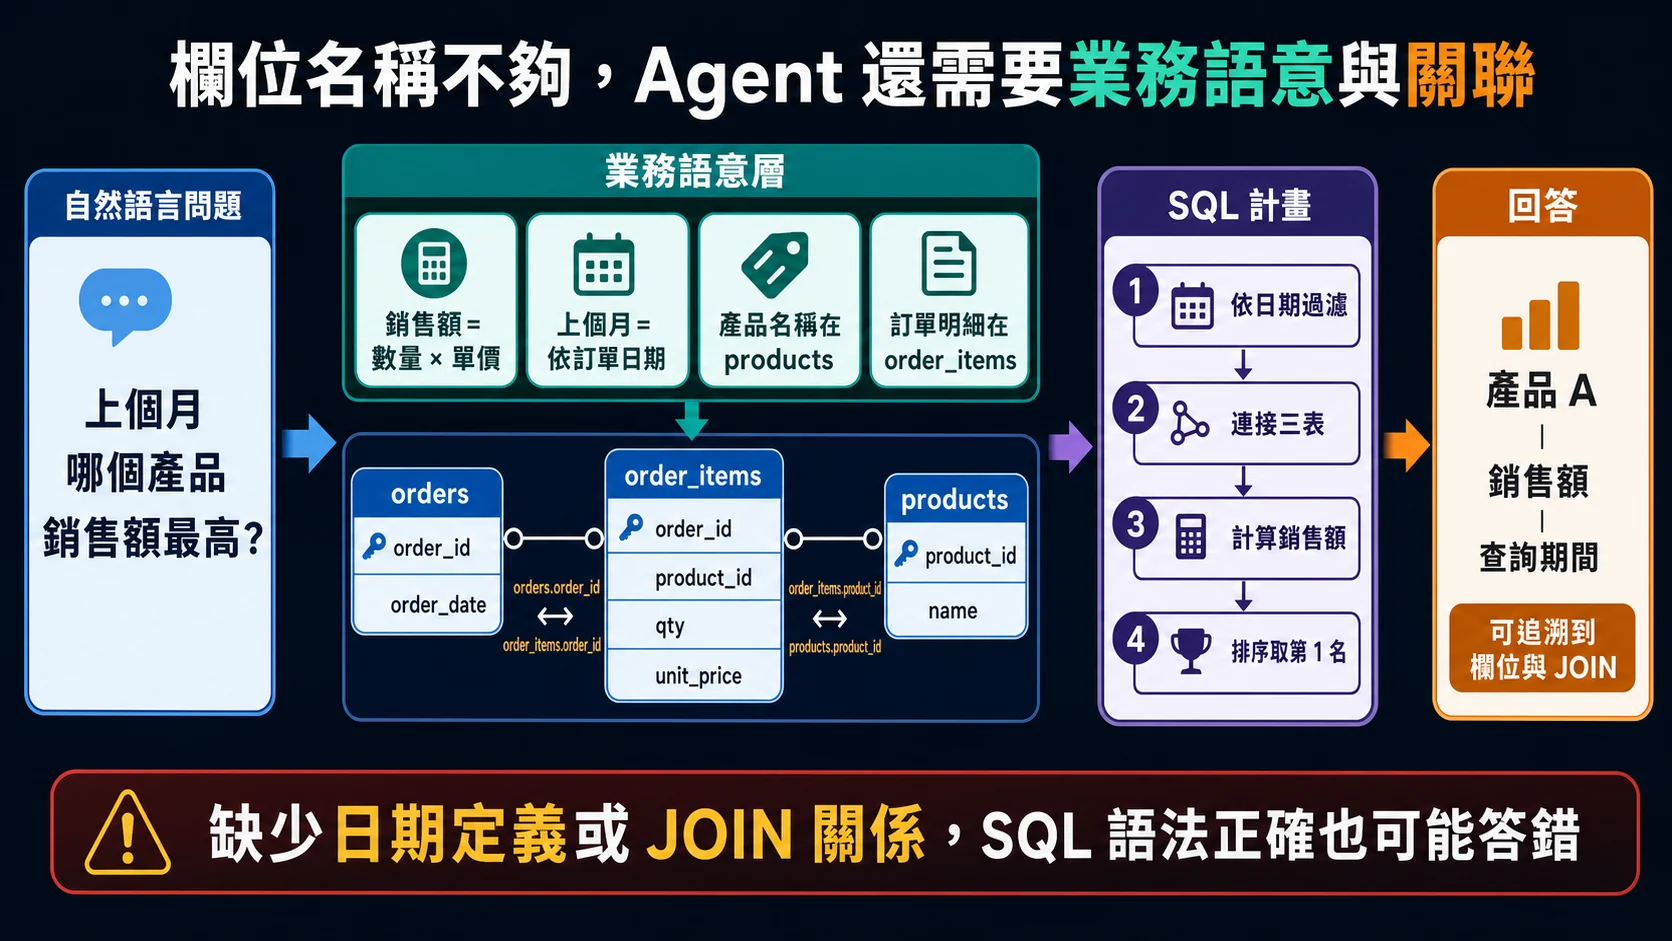
SQL 能執行不代表業務答案正確。Agent 還需要日期定義、指標公式、欄位語意與 Join 關係,並把採用的定義和查詢一起留下,使用者才知道這個數字怎麼來的。
Cloud SQL vs AlloyDB 的選擇
| 面向 | Cloud SQL | AlloyDB |
|---|---|---|
| 主要定位 | 受管 MySQL、PostgreSQL、SQL Server,適合既有應用與一般 OLTP | PostgreSQL 相容,著重高效能、可用性與混合交易/分析工作 |
| Text-to-SQL | QueryData(Preview,依支援引擎) | QueryData;另有 alloydb_ai_nl Preview |
| 向量與 AI | 依引擎使用向量擴充與 Google Cloud AI 整合 | ScaNN、google_ml_integration、AI Functions 與自動 Embedding |
| 選擇依據 | 既有引擎、相容性、成本與維運需求 | PostgreSQL 相容且需要 AlloyDB 的效能與內建 AI 能力 |
AlloyDB AI 的向量能力
AlloyDB AI 可透過 google_ml_integration 呼叫已註冊模型、產生 Embedding,並以 ScaNN 或 Vector Index 做相似度搜尋;也提供 ai.if()、ai.rank()、ai.generate() 等 AI Functions。模型呼叫仍會有成本、延遲與資料傳送範圍,語意相似也不代表兩筆案例在法規或處理方式上相同。把 Structured Filter、權限與時間條件留在 SQL,再用向量處理模糊語意,通常比全部交給向量搜尋安全。
安全架構設計
最重要的原則是:模型提出查詢,資料庫與應用程式決定能不能執行。只檢查字串裡有沒有 DROP 或 DELETE 很容易被繞過,至少要搭配:
- 資料庫硬權限:唯讀角色、核准 View、Row/Column Security 與必要的使用者身分傳遞
- 語法樹與物件檢查:只接受允許的 Statement、Schema、Function 和單一查詢,不靠關鍵字 Denylist
- 資源預算:
statement_timeout、列數/位元組上限、Connection Pool、並行限制與取消機制 - 執行計畫:先用
EXPLAIN或產品提供的驗證能力檢查全表掃描、Join 與預估成本;PostgreSQL 並沒有通用的「Dry Run」開關 - 稽核與最小回傳:記錄使用者、自然語言問題、生成 SQL、政策判斷和查詢 ID,只回傳完成任務需要的欄列
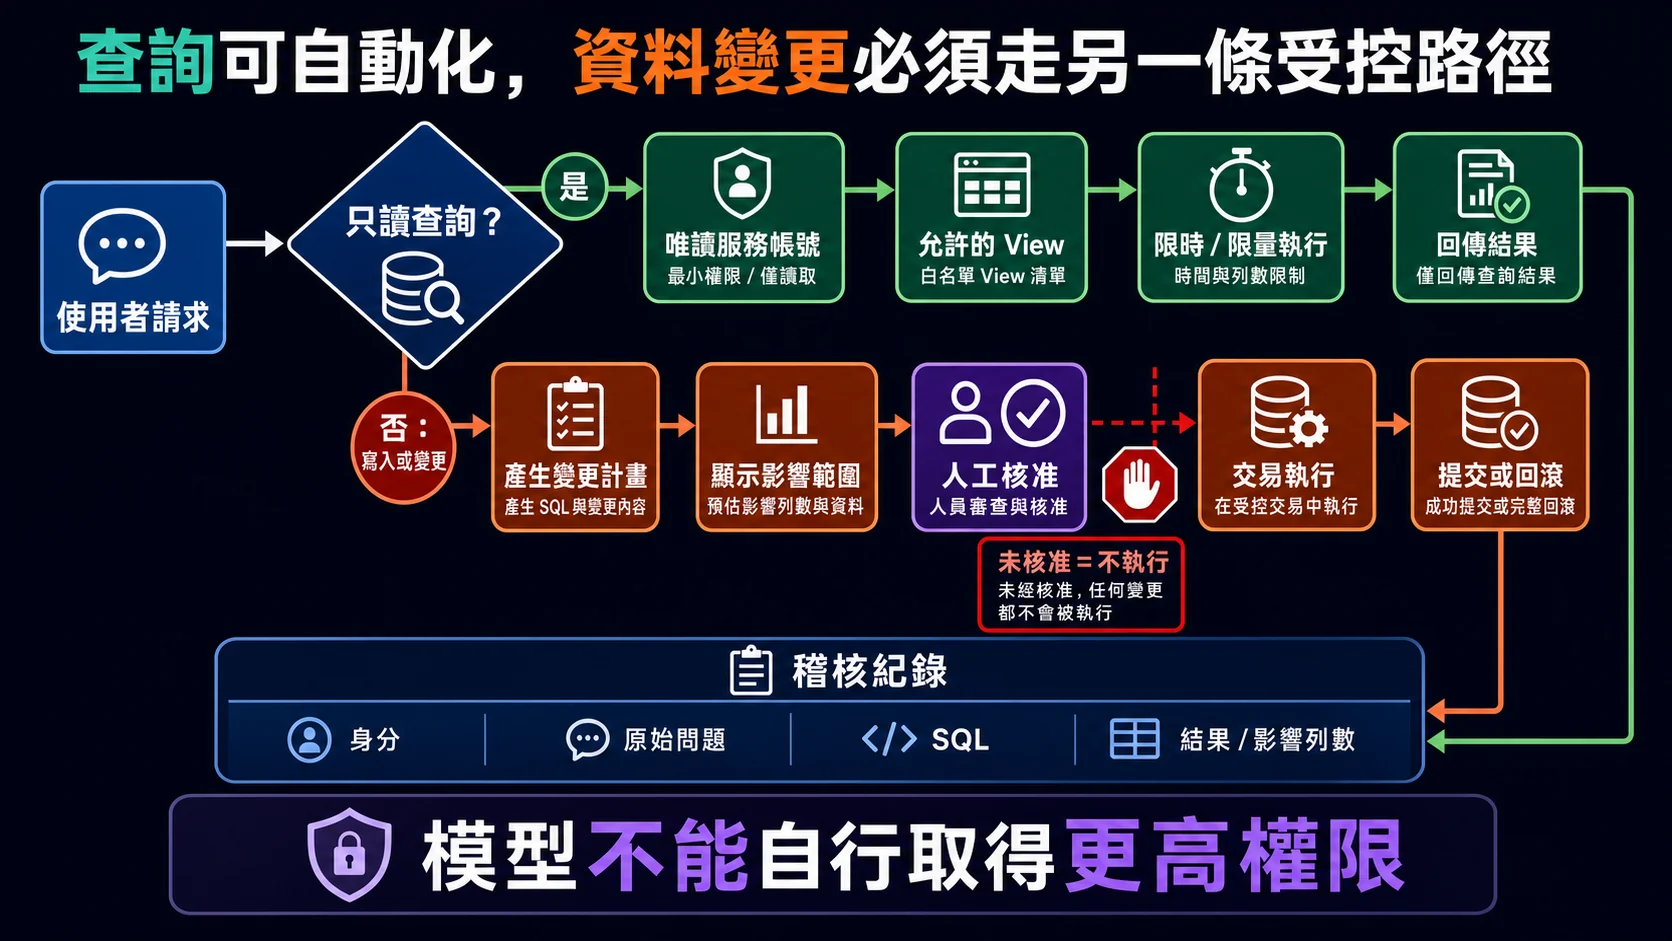
查詢與資料變更要走不同路徑。讀取限制在唯讀 View;寫入先產生結構化變更計畫,重新驗證最新資料與影響範圍,取得人工核准後才以受限交易執行。核准的是這一筆計畫,不是給模型永久寫入權限。
流程圖暫時無法顯示,請重新整理頁面後再試。
實作重點
- 先評估 QueryData 的 Context Set;若 Lab 使用自建 Tool,仍要把 Schema、指標與範例版本化
- 使用 Cloud SQL Connector/Auth Proxy、Workload Identity 或受管 Secret,程式碼不放帳密
- AlloyDB 可用
embedding()或註冊模型後的google_ml.embedding();依官方文件確認模型、維度與地區 - 測試集要包含單表、多表 Join、時區、空值、同義詞、權限拒絕、全表掃描與 SQL 方言差異
- 每題比對生成 SQL 和最終答案;SQL 不完全相同也可能等價,語法正確也可能算錯業務指標
- 將讀取成功率、澄清率、越權阻擋、查詢成本與人工覆核結果一起納入評估
Lab 導讀
Lab 連結:Build AI Agents with Enterprise Databases — Google Cloud Skills Boost
這個 Lab 會做出能查銷售資料庫的 Agent。完成「上個月哪個產品銷售額最高?」後,請再追問:上個月用哪個時區、銷售額是否扣退貨、使用者能不能看全部區域?接著用唯讀帳號、限制 View、逾時和列數上限重跑。若要採用新一代方案,可另外對照 QueryData;舊 Lab 的重點則保留在 Context 與安全執行層。
延伸學習
- Cloud SQL for PostgreSQL 管理實作 — Cloud SQL 的基礎管理操作
- Agent Development Kit 開發實戰 — ADK 基礎,建構 Tool 的核心知識
- Vertex AI MLOps 模型評估 — 評估 NL2SQL 的準確率與品質
相關文章
您可能也會對這些文章感興趣
企業資料庫 AI Agent:NL2SQL 不等於直接執行
從 QueryData、Schema 語意層到唯讀 View、查詢驗證與人工核准,讓 Agent 能問企業資料,又不繞過既有資料權限
AI Agent 安全:別只叫模型「不要洩密」
從 Prompt Injection、工具越權與資料外洩,到 Model Armor、IAM、VPC Service Controls 和人工核准的分層防禦
Generative Playbooks:該用 Flow 還是 Playbook?
從目標、指令、範例、參數到工具護欄,判斷客服流程何時該用 Playbook、何時應留在確定性的 Flow
