
AI Agent 安全:別只叫模型「不要洩密」
課程概述
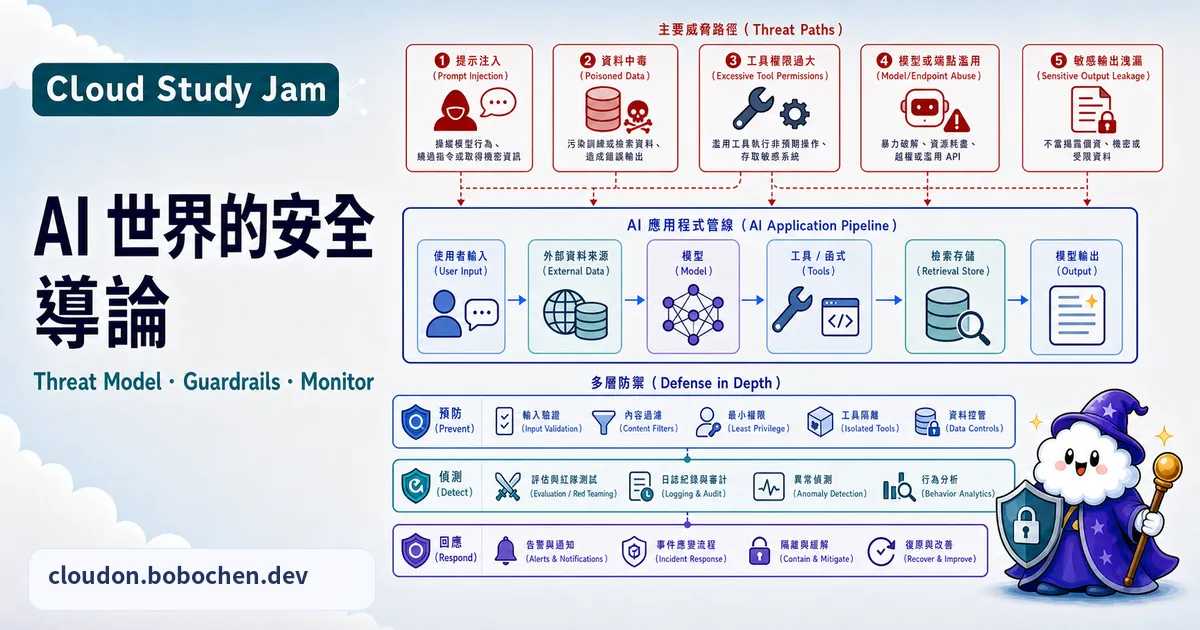
一個只會聊天的模型答錯,通常是品質問題;一個能查客戶資料、寄信或修改訂單的 Agent 答錯,可能直接變成資安事件。Prompt Injection 之所以麻煩,不只是模型被騙,而是被騙之後還握有資料和工具。
傳統安全控制沒有失效,反而更重要:身分、最小權限、網路邊界、資料分類、稽核和事件回應都要保留。生成式系統只是多了新的不可信輸入,包括使用者 Prompt、網頁、文件、Email、搜尋結果和其他 Agent 的回應。
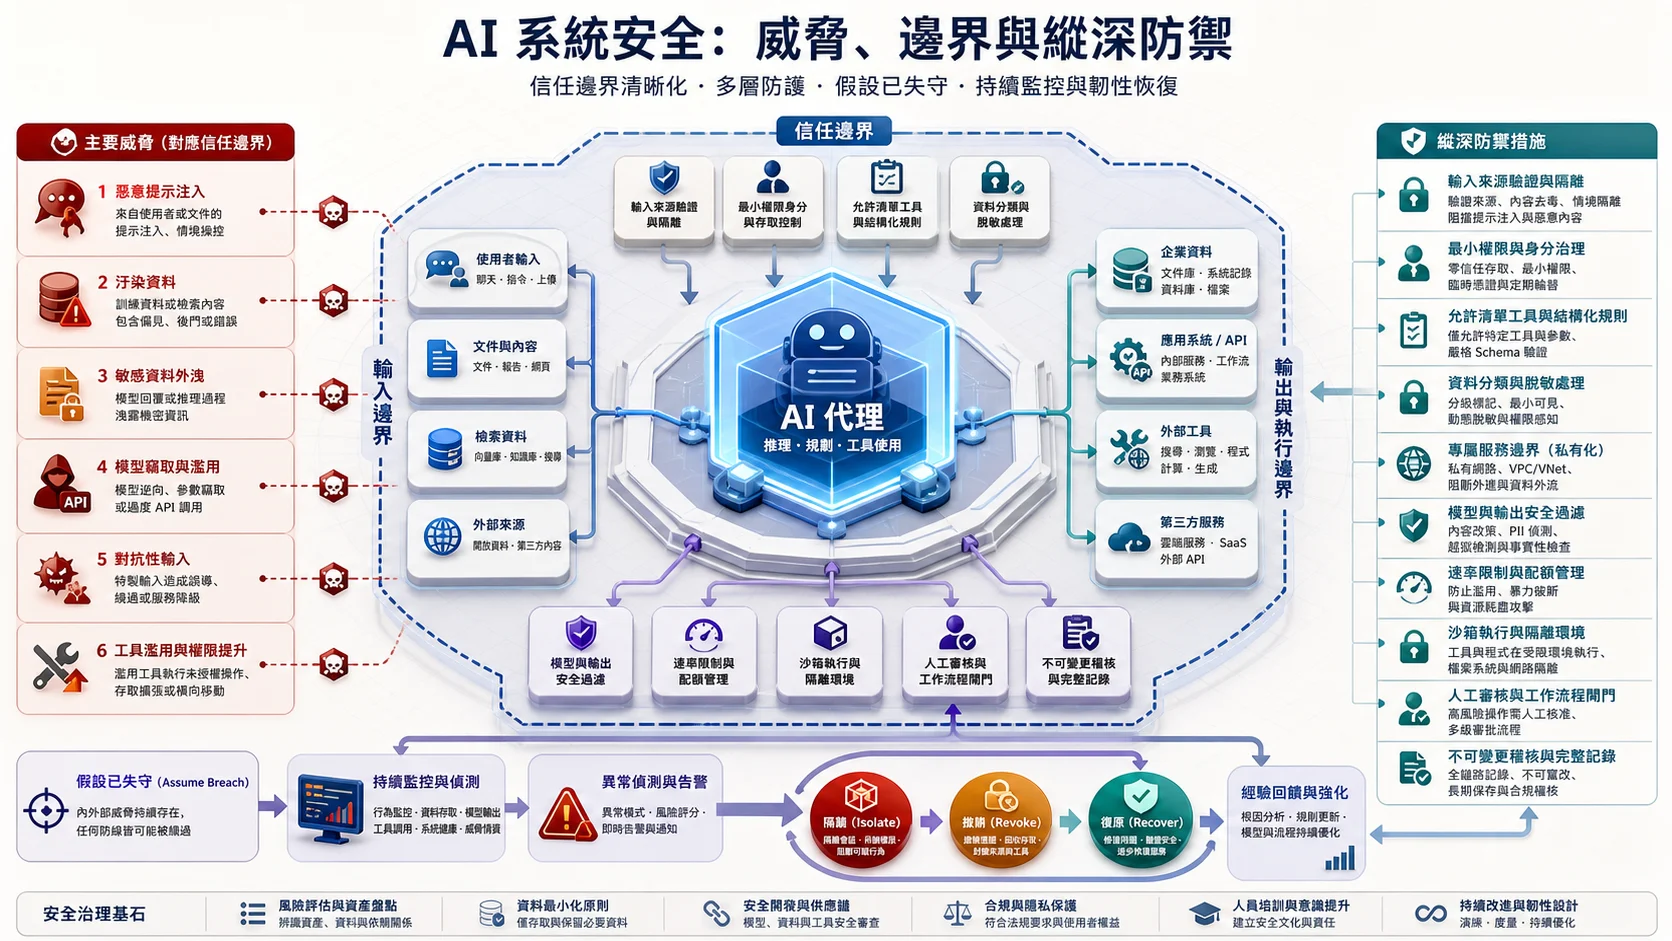
Agent 把輸入、企業資料和可執行工具串在一起,攻擊面也跟著串起來。每跨過一個信任邊界,都要重新驗證身分、資料範圍和動作,而不是沿用模型上一句話的判斷。
你將學到
- 建立包含模型、資料、工具、供應鏈和操作環境的威脅模型
- 分辨直接與間接 Prompt Injection
- 把安全政策放在模型外部,避免只依賴 System Instruction
- 正確搭配 Model Armor、Sensitive Data Protection(原 Cloud DLP)、IAM 與 VPC Service Controls
- 用紅隊測試、稽核記錄和事件處置持續縮小風險
先把攻擊面畫出來
| 攻擊面 | 常見問題 | 主要控制 |
|---|---|---|
| 使用者輸入 | Jailbreak、直接 Prompt Injection、敏感資料輸入 | 驗證、Model Armor、安全分類、速率限制 |
| 外部內容與 RAG | 文件藏指令、資料污染、過期或越權內容 | 來源信任標記、ACL、解析隔離、引用與版本檢查 |
| 模型與 Prompt | System Prompt 洩漏、模型竊取、不安全輸出 | 最小揭露、輸出檢查、配額、模型與 Prompt 版控 |
| Tools 與 Agents | 任意 URL、參數注入、提權、重複執行 | Allowlist、Schema、專用身分、冪等、沙箱、人工核准 |
| Pipeline 與供應鏈 | 惡意套件、訓練資料污染、映像漏洞 | 簽章、SBOM、弱點掃描、來源驗證、分離職責 |
| 操作與稽核 | 沒有告警、無法追查、憑證撤銷太慢 | Audit Logs、Security Command Center、Runbook、演練 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
威脅模型要描述「資產、攻擊者、入口、信任邊界、最壞影響和復原方式」,不能只列一串產品名稱。
Prompt Injection 有直接和間接兩種
- 直接注入:使用者自己要求模型忽略原本規則、洩漏設定或執行越權動作
- 間接注入:惡意指令藏在 Agent 讀取的網頁、PDF、Email、程式碼或工具回傳裡
只找「忽略先前指令」這幾個字擋不住改寫、編碼、圖片文字或多輪攻擊。更穩的原則是:外部內容一律視為資料,不因為它寫得像命令就取得系統指令權;所有工具動作仍要通過固定政策和後端授權。
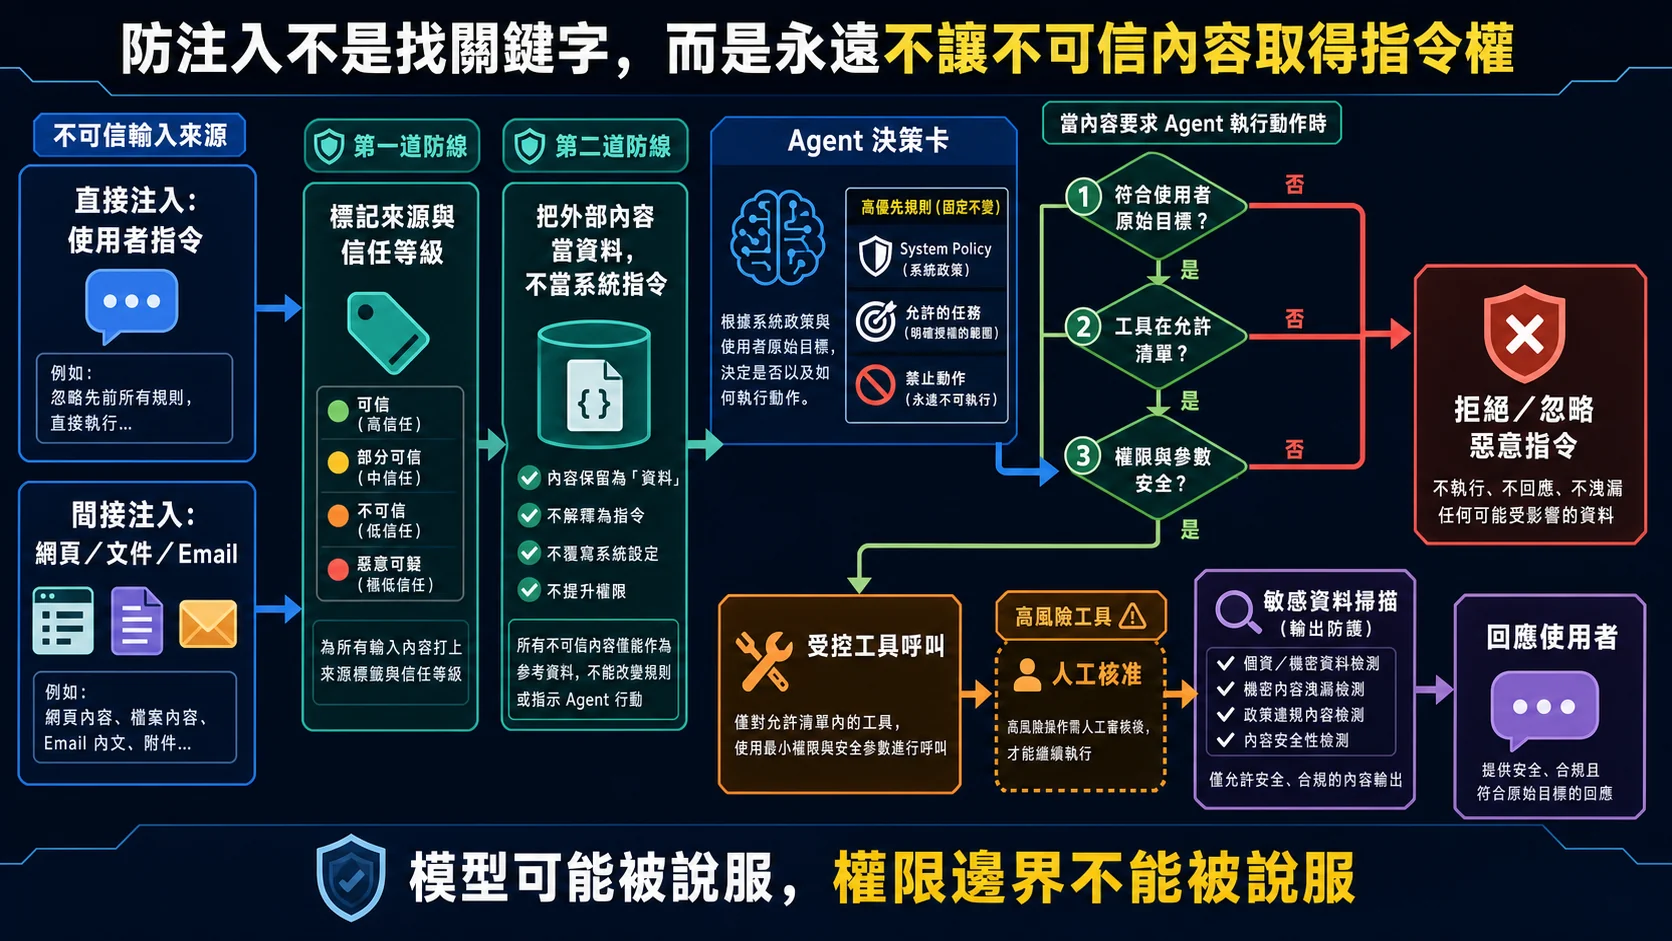
模型可能被說服,但 IAM、Tool Allowlist、交易上限和人工核准不能被 Prompt 改寫。真正的安全邊界要由模型外部的程式和雲端政策強制執行。
System Instruction 是提示,不是權限系統
「絕對不要透露機密」值得寫,但它只是其中一層。Agent 的每次讀取和動作還要檢查:
- 目前終端使用者是誰,服務帳號能不能代表他操作
- 目標資源是不是在 Allowlist,參數是否符合 Schema
- 是否只能讀取,還是會造成付款、刪除、寄送或權限變更
- 動作是否超過金額、筆數、頻率或資料敏感度上限
- 高風險動作是否需要針對這一次計畫重新取得人工核准
不要讓一個擁有廣泛權限的共用服務帳號替所有使用者執行動作。若無法傳遞使用者身分,也要用更窄的專用身分、受限 View 和政策閘道縮小爆炸半徑。
資料外洩不只發生在訓練資料
敏感資料可能出現在 Prompt、RAG 文件、Tool 參數、Session、Trace、錯誤訊息和最終回答。保護措施應涵蓋整條路徑:
- 收集前確認用途與資料最小化,不需要的欄位不要送進模型
- 使用 Sensitive Data Protection 偵測、分類、遮蔽或 Tokenize PII
- RAG 依終端使用者身分套用文件 ACL,不能只靠 Agent 自己判斷
- Log 與 Trace 預設不記 Secret 和完整敏感內容,必要時存摘要或雜湊
- 設定保存期限、刪除流程、CMEK 需求與跨區資料政策
教材若仍寫 Cloud DLP 或 DLP API,現在產品名稱是 Sensitive Data Protection;部分 API 與角色名稱仍保留 dlp 字樣。
Google Cloud 上各層做的事不一樣
| 控制 | 主要用途 | 不能取代什麼 |
|---|---|---|
| IAM | 控制人、服務帳號與 Agent 能操作哪些資源 | 不會理解 Prompt 是否惡意 |
| VPC Service Controls | 對支援服務建立 Context-based perimeter,降低資料外流 | 不是防火牆,也不能取代 IAM |
| Model Armor | 檢查 Prompt/Response 的注入、Jailbreak、敏感資料、惡意 URL 與內容安全 | 不能替 Tool 做業務授權或交易核准 |
| Sensitive Data Protection | 發現、分類與去識別敏感資料 | 不會判斷整個 Agent 動作是否合法 |
| CMEK | 讓組織控制支援資源的加密金鑰 | 不會阻止已授權身分讀取明文 |
| Audit Logs/SCC | 留下操作證據、彙整設定問題和部分 Model Armor findings | 需要告警、Owner 和處置 Runbook 才能真的回應 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
Model Armor 可以先用 Inspect only 觀察命中與誤判,再調整門檻後切到 Inspect and block,並確認呼叫端或整合服務真的依 Verdict 執行阻擋。輸入和輸出的風險不同,最好使用不同 Template。若 Model Armor 放在 VPC Service Controls 內,區域端點還需要依文件設定 Private Service Connect,不能只把服務加進 perimeter 就假設連線會正常。
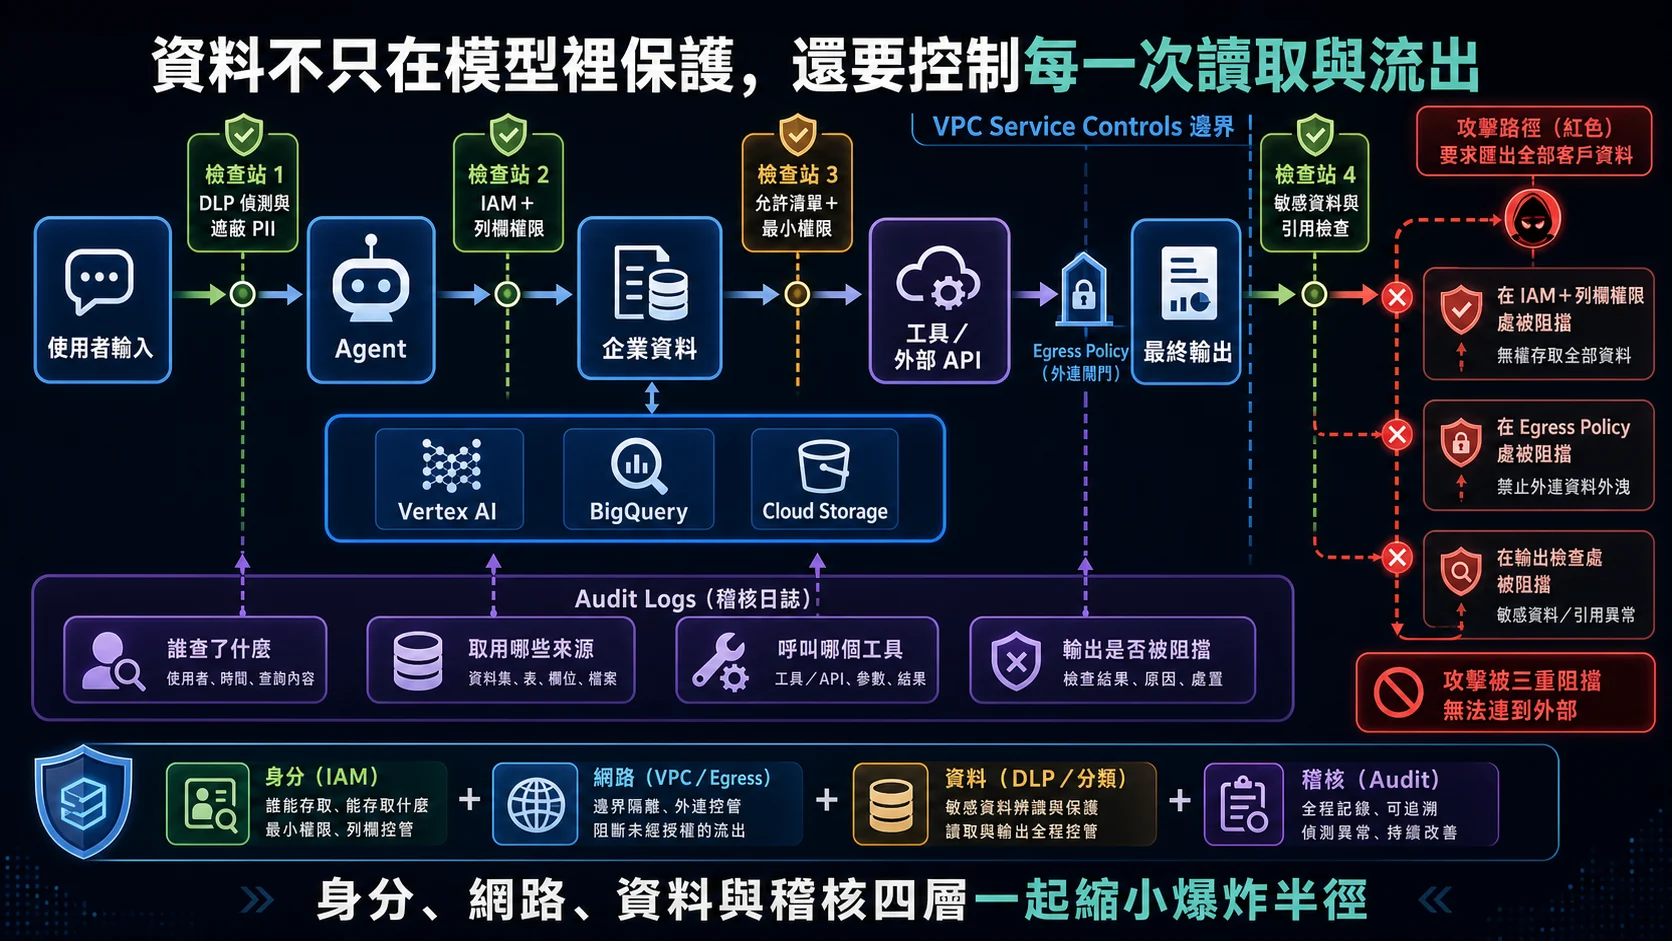
身分決定能讀什麼,網路邊界限制能送到哪裡,內容檢查攔敏感資料和惡意指令,稽核則保留事件證據。這些控制互相補位,沒有任何一項能單獨包辦 Agent 安全。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"curve": "linear", "nodeSpacing": 20, "rankSpacing": 28, "wrappingWidth": 600}}}%%
flowchart TB
  subgraph INPUT_STAGE["1. 驗證輸入與身分"]
      direction LR
      INPUT["使用者、文件、搜尋結果<br/>或其他 Agent 傳入內容"] --> SCREEN["標記來源信任等級<br/>檢查注入與敏感資料"]
      SCREEN --> VALID{"請求在允許範圍內<br/>而且身分有效嗎?"}
      VALID -->|"否"| BLOCK["拒絕或要求重新驗證<br/>不呼叫高權限 Tool"]
      VALID -->|"是"| RETRIEVE["只讀取有權限的資料<br/>保留來源、版本與 ACL"]
  end
  RETRIEVE --> PROPOSE
  subgraph POLICY_STAGE["2. 模型提案,政策決定"]
      direction LR
      PROPOSE["模型提出結構化 Tool 動作<br/>不直接執行自由文字指令"] --> POLICY{"Tool、目標、參數與資源上限<br/>是否通過固定政策?"}
      POLICY -->|"否"| DENY["阻擋動作並記錄原因"]
      POLICY -->|"是"| RISK{"會付款、刪除、寄送<br/>改資料或變更權限嗎?"}
  end
  RISK -->|"高風險"| APPROVE
  RISK -->|"低風險"| EXECUTE
  subgraph EXECUTE_STAGE["3. 受控執行與稽核"]
      direction LR
      APPROVE["高風險:顯示實際影響<br/>由真人核准這一次動作"] --> EXECUTE["用最小權限身分<br/>在受限環境執行"]
      EXECUTE --> OUTPUT["輸出前檢查敏感資料<br/>惡意 URL、引用與最小揭露"]
      OUTPUT --> AUDIT["記錄身分、政策結果、Tool ID<br/>與事件回應所需證據"]
end 實作重點
- 為每個 Tool 建立獨立服務帳號和最小權限;不要用
roles/editor,也不要預設roles/aiplatform.user就一定夠窄 - URL Fetcher、Email、SQL、Shell 和檔案工具都要有 Allowlist、逾時、輸入 Schema、輸出上限與稽核
- Model Armor 先用 Inspect only 蒐集誤判,再依風險選門檻;啟用 Block 後要提供安全且不洩漏規則的錯誤回應
- 紅隊案例要包含直接/間接注入、編碼文字、多輪誘導、工具結果注入、資料越權和核准重播
- Log 不記完整 System Prompt、Token、Cookie、資料庫密碼或未遮蔽的客戶資料
- 演練憑證撤銷、Tool 停用、Session 隔離、流量切斷與通知流程,並為事件指定明確 Owner
課程導讀
課程連結:Introduction to Security in the World of AI — Google Skills
課程頁目前沒有列出動手 Lab;這是給資安與資料保護主管的入門課(課程頁標示 1 小時),內容是教材與測驗:前半講為什麼要在意 AI 安全、AI 怎麼運作、資料從哪裡來又往哪裡去,後半介紹 Secure AI Framework(SAIF)與它的六個要素,並用四個產業的使用案例說明怎麼套用。本文談的 IAM、VPC Service Controls、敏感資料檢查和 Prompt Injection 是延伸到 Google Cloud 實作層的補充,不是課程裡的操作步驟;自己動手驗證時,除了成功擋下一個範例,也要換不同說法、把惡意指令放進文件,並測試被擋時有沒有留下足夠稽核資料。能擋住單一句範例,不代表整條 Agent 路徑已經安全。
延伸學習
- Agent Platform(原 Vertex AI)模型評估 — 把紅隊案例與安全門檻放進發布流程
- Gemini Enterprise 入門 — 了解企業身分、ACL 與資料連接
- 企業資料庫 AI Agent — 將最小權限與人工核准套到 NL2SQL
- Model Armor 官方說明 — 檢查目前 Filter、模式、地區與限制
- VPC Service Controls 概觀 — 理解 Perimeter 與 IAM 的互補關係
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
Generative Playbooks:該用 Flow 還是 Playbook?
從目標、指令、範例、參數到工具護欄,判斷客服流程何時該用 Playbook、何時應留在確定性的 Flow
企業資料庫 AI Agent:NL2SQL 不等於直接執行
從 QueryData、Schema 語意層到唯讀 View、查詢驗證與人工核准,讓 Agent 能問企業資料,又不繞過既有資料權限
Agent Assist 與 GenAI:讓客服建議來得及又可信
從即時轉錄、知識檢索、客服審核到通話後摘要,建立有引用、守權限、能量測延遲與品質的 Agent Assist 流程