
Data Store Agent:FAQ 準不準,先看資料
課程概述
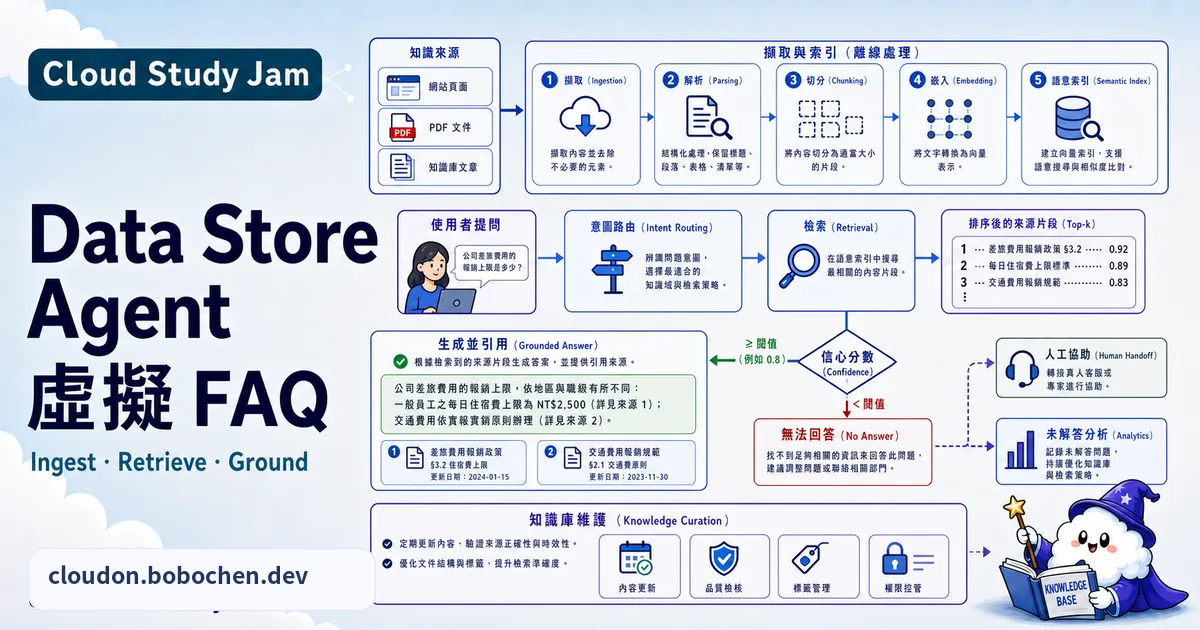
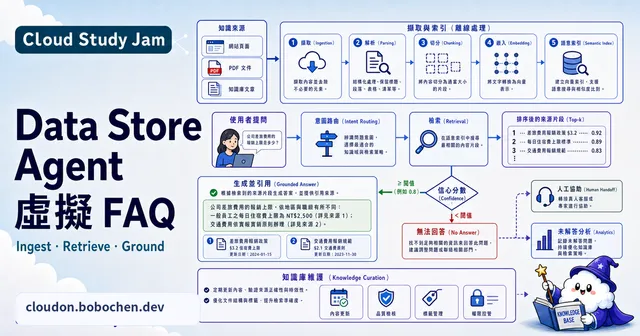
把公司文件丟進知識庫,再讓客服機器人回答問題,看起來很像「上傳完就收工」。真正上線後才會發現,答案準不準往往不是模型大小決定的,而是來源文件有沒有過期、段落切得好不好、權限有沒有跟著帶進索引,以及找不到答案時肯不肯停下來。
現行產品裡,網站、文件和資料庫內容會放進 Data Store,再由 Conversational Agents 的 Data Store Tool 搜尋並整理回答。底層搜尋能力來自 Agent Search。它幫你省下不少 RAG 基礎建設,但不會自動替公司完成資料治理。
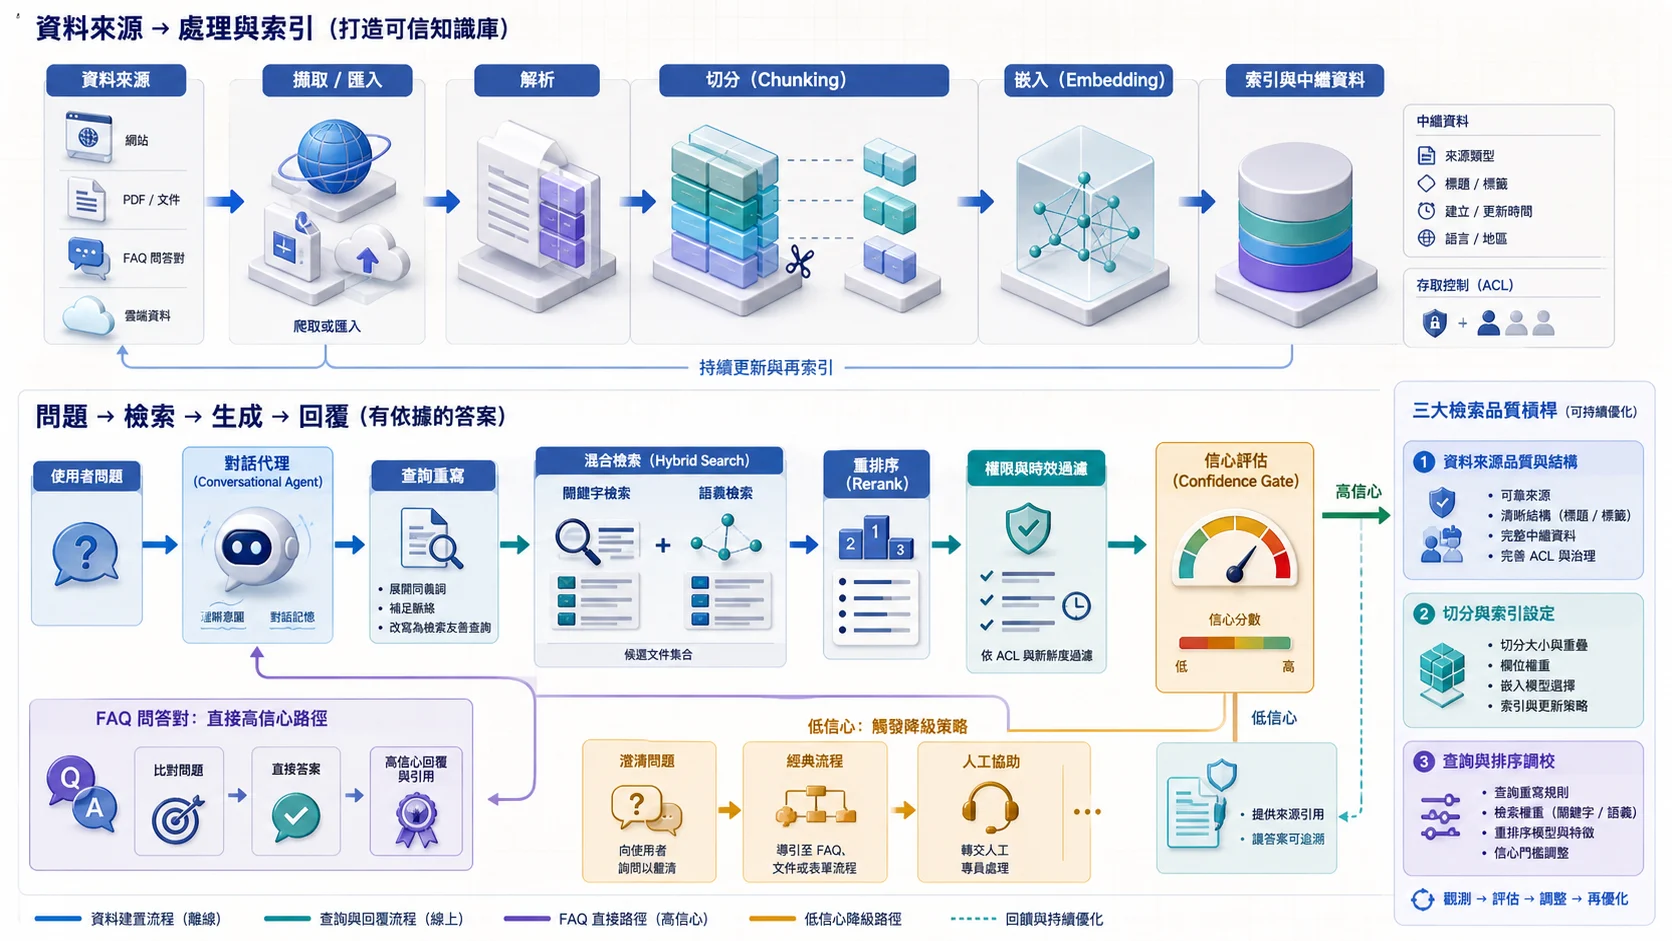
一個可信的 FAQ 回答,要能一路追到來源、版本與權限。檢索結果太弱時就澄清或轉人工,不要為了「每題都有答案」把缺少的內容補成看似合理的句子。
你將學到
- 釐清 Agent Search、Data Store 與 Data Store Tool 的分工
- 依網站、非結構化文件和結構化資料選擇匯入方式
- 在建立 Data Store 前決定解析、切片與資料來源 ACL
- 用查詢集檢查命中、引用、拒答和權限隔離
- 讓更新、刪除與權限變更真的反映到搜尋結果
它是一個受管 RAG 流程,不是「自動懂公司文件」
使用者提問後,大致會經過查詢改寫、搜尋、摘要、Grounding 和安全檢查。Data Store Tool 也能輸出執行追蹤與各階段延遲,方便分辨問題出在 FAQ 比對、搜尋、摘要還是安全檢查。
目前常見資料來源包括:
| 資料來源 | 常見內容 | 要先確認的事 |
|---|---|---|
| 網站 URL | 官網、Help Center、公開政策 | 網域驗證、可爬範圍、排除頁面與更新延遲 |
| Cloud Storage | PDF、HTML、DOCX、JSONL | 文件品質、Parser、Metadata 與 ACL 欄位 |
| BigQuery | FAQ、產品目錄、結構化知識 | Schema、欄位用途;原本 BigQuery 權限不會自動跟著匯入 |
| Google Cloud 資料庫 | AlloyDB、Bigtable、Firestore、Cloud SQL、Spanner | 支援方式、同步週期、資料範圍與服務帳號權限 |
| 第三方來源 | Drive、Confluence 等連接器 | IdP、群組同步、來源端 ACL 與連接器限制 |
Data Stores 功能目前不在 Dialogflow CX SLA 內。若它是客服正式服務的唯一知識來源,要把失敗時的快取、固定 FAQ 或人工轉接一起設計進去。
引用是證據線索,不是正確保證
Data Store Tool 會提供支援連結,Agent Search 的摘要也能開啟 Citation。引用能回答「這句話從哪裡來」,但不能保證:
- 文件本身是最新或正確版本
- 模型沒有把例外條款漏掉
- 使用者真的有權限看到來源內容
- 引用段落足以佐證整句結論
因此測試時不能只檢查 Citation 欄位有沒有值。要讓人工逐題確認答案主張、引用段落、來源版本和權限都對得上。
Chunk 要能獨立回答,不是愈小愈好
Agent Search 可在建立 Data Store 時啟用文件切片,並搭配 Layout Parser 保留標題、段落、表格和清單結構。這個選擇要早點做:文件切片建立後不能直接開關,既有文件改 Parser 也不會自動重新解析。
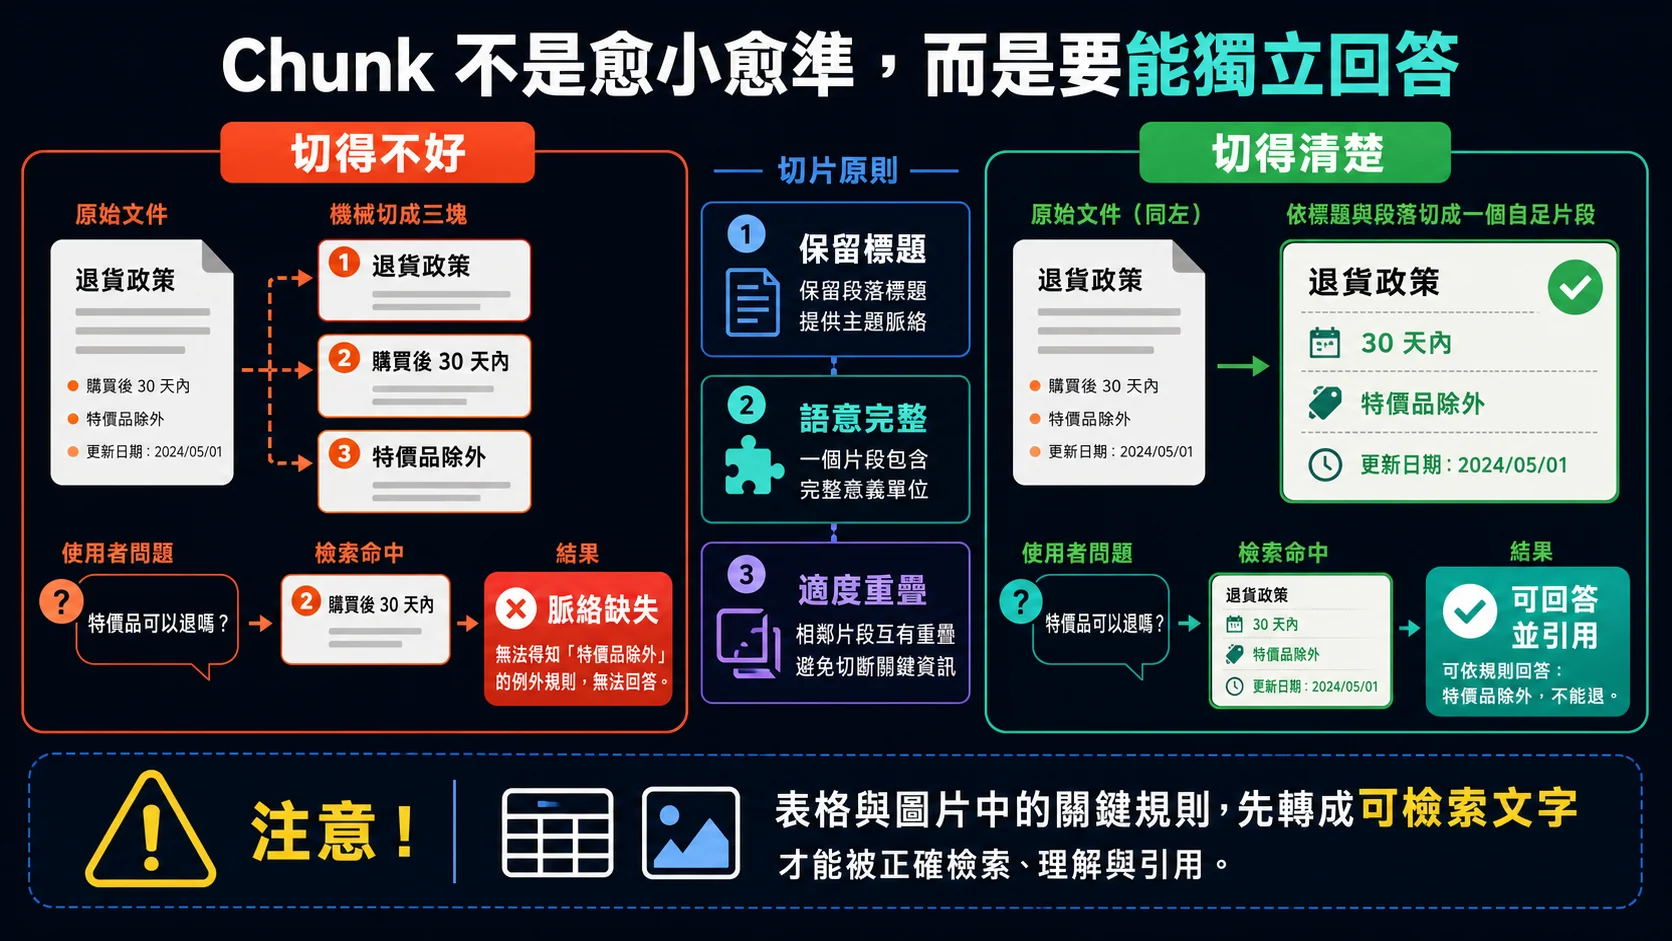
一個 Chunk 最好能帶著標題和必要條件獨立回答問題。若「可以退貨」與「特價品除外」被切開,檢索只命中前半段時,就會產生一個有引用但仍然錯誤的答案。
對複雜 PDF,Layout Parser 通常比單純 OCR 更適合 RAG,因為它能辨識標題、表格和版面結構。掃描品質差、跨頁表格或資訊藏在圖片裡時,仍要抽樣檢查解析結果,不能只看匯入狀態顯示成功。
ACL 要在建 Data Store 時決定
企業內部文件常有部門、專案或個人權限差異。Agent Search 的資料來源存取控制需要先設定 IdP,並在建立 Data Store 時啟用;不能等資料都進來後,再把既有 Data Store 改成 ACL 模式。
目前官方文件仍將這項資料來源存取控制標示為 Preview。正式採用前要確認服務條款、支援來源和地區,也要準備產品限制改變時的應對方式。
特別容易踩雷的是 BigQuery:把資料匯入 Agent Search,不代表 BigQuery 原本的資料集與資料表權限會一起複製過去。若內容不是公開資料,就要使用支援的 ACL Schema、傳入終端使用者身分,並準備正反兩組帳號測試同一題。
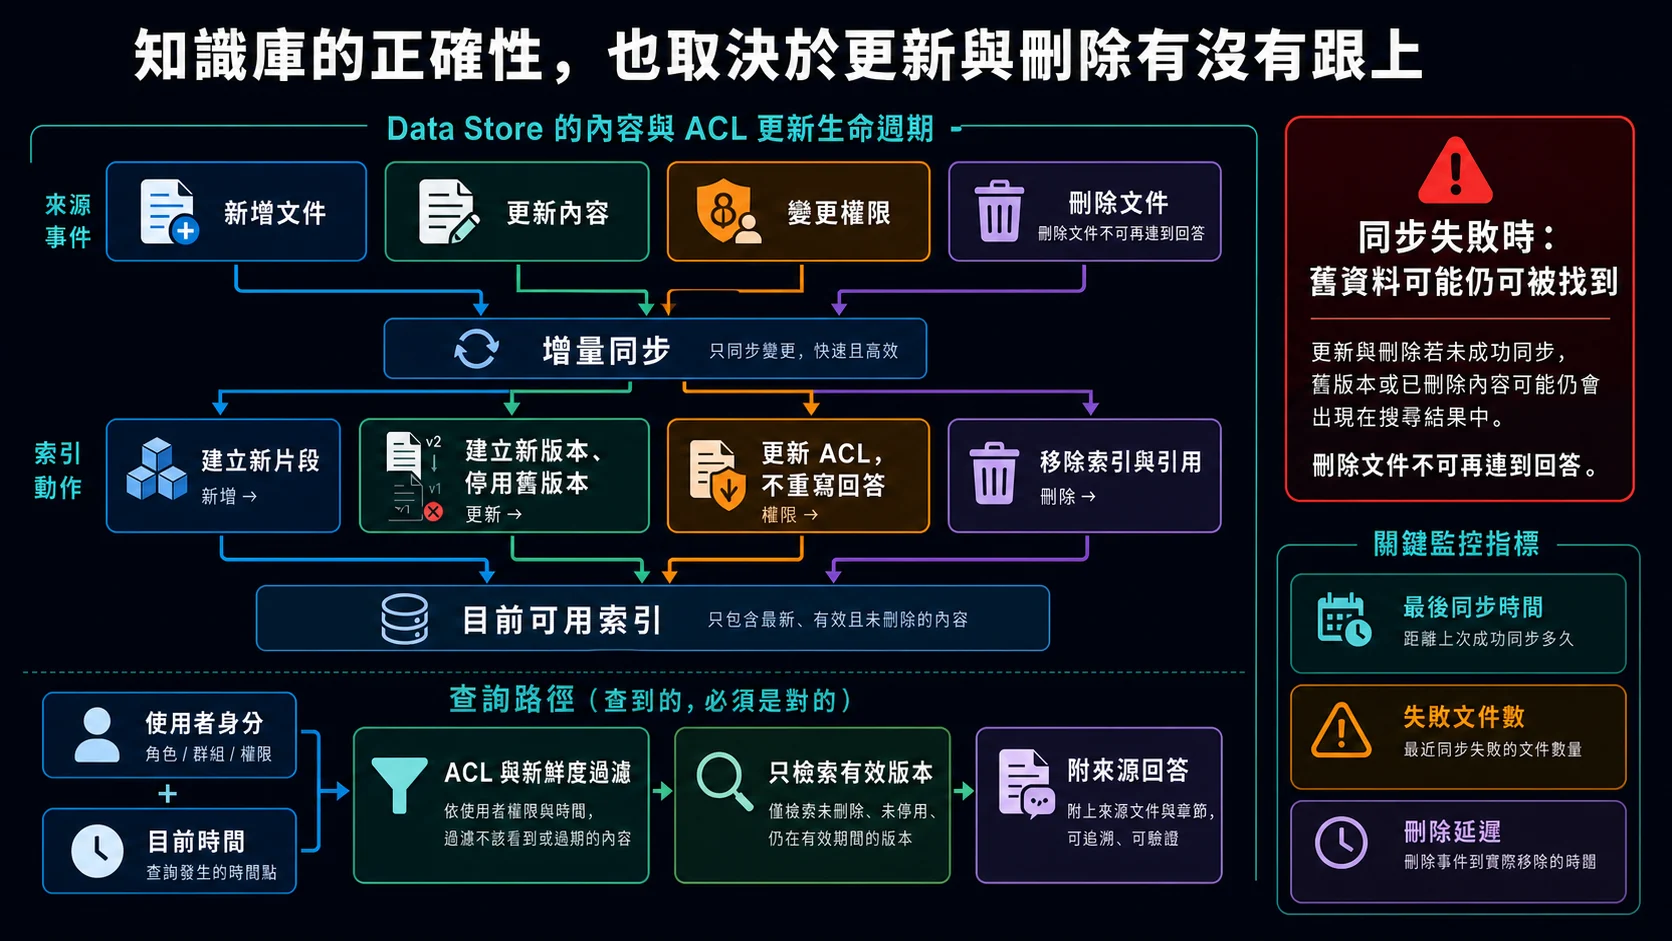
知識庫不是一次性匯入。新增、改版、權限變更和刪除都要能追蹤;監控最後成功同步時間、失敗文件與刪除延遲,才不會讓舊政策一直被找到。
FAQ 格式確實有優勢,但不是逐字回覆
成對的 Question/Answer 資料通常比把整份手冊丟進去更容易命中,因為每筆資料本身就有完整問法和答案。不過 Data Store Tool 仍可能改寫回答,並不保證逐字回傳 FAQ 原文。涉及法規、價格或承諾時,最好把精確文字交給確定性回覆或要求使用者查看原文。
流程圖暫時無法顯示,請重新整理頁面後再試。
實作重點
- 不要寫死「索引一定 5–30 分鐘完成」;資料量、來源與同步方式不同,應監控實際 Operation 和文件狀態
- 建立 Data Store 前先決定是否啟用文件切片與資料來源 ACL,這兩項都不是事後隨手切換的設定
- 使用 Metadata 表示文件類別、語系、地區、有效日期與版本,再搭配 Filter、Boost/Bury 控制結果
- 使用 Default、Optimized for voice 或 Customize 設定 Grounding、Rewriter 與 Summarization,不要沒有評估資料就亂調門檻
- 測試集要包含同義問法、例外條款、已刪除內容、無答案問題與「有權限/沒權限」帳號
- Conversation History、Cloud Logging 或 BigQuery tracing 可以協助定位搜尋、摘要和安全檢查的延遲與失敗
Lab 導讀
Lab 連結:Virtual FAQ with data store agents — Google Cloud Skills Boost
Lab 會從 Cloud Storage 匯入文件,再把 Data Store Tool 接進對話。實作時請另外記下三件事:哪個文件版本被引用、查不到時 Agent 做了什麼,以及使用不同身分查詢時結果是否真的不同。這三題比「看起來有回答」更接近正式環境。
延伸學習
- Gemini Enterprise 入門 — 擴大到企業搜尋、連接器與身分同步
- Generative Playbooks — 把 Data Store Tool 接進可控的對話任務
- Agent Assist 與 GenAI — 將知識問答放進真人客服工作台
- Agent Search 文件切片 — 確認 Parser、Chunk 與既有限制
- 資料來源存取控制 — 設定 IdP、ACL 與終端使用者權限
相關文章
您可能也會對這些文章感興趣
Data Store Agent:FAQ 準不準,先看資料
從資料來源、版控、ACL、解析與切片到引用驗證,整理一套能持續維護的企業知識問答上線流程
Generative Playbooks:該用 Flow 還是 Playbook?
從目標、指令、範例、參數到工具護欄,判斷客服流程何時該用 Playbook、何時應留在確定性的 Flow
Vertex AI 模型評估:不要讓平均分數決定上線
把離線切片、Gen AI 評估、Model Registry、線上實驗、護欄與回滾串成能真正擋住退化模型的發布流程
