
Vertex AI 模型評估:不要讓平均分數決定上線
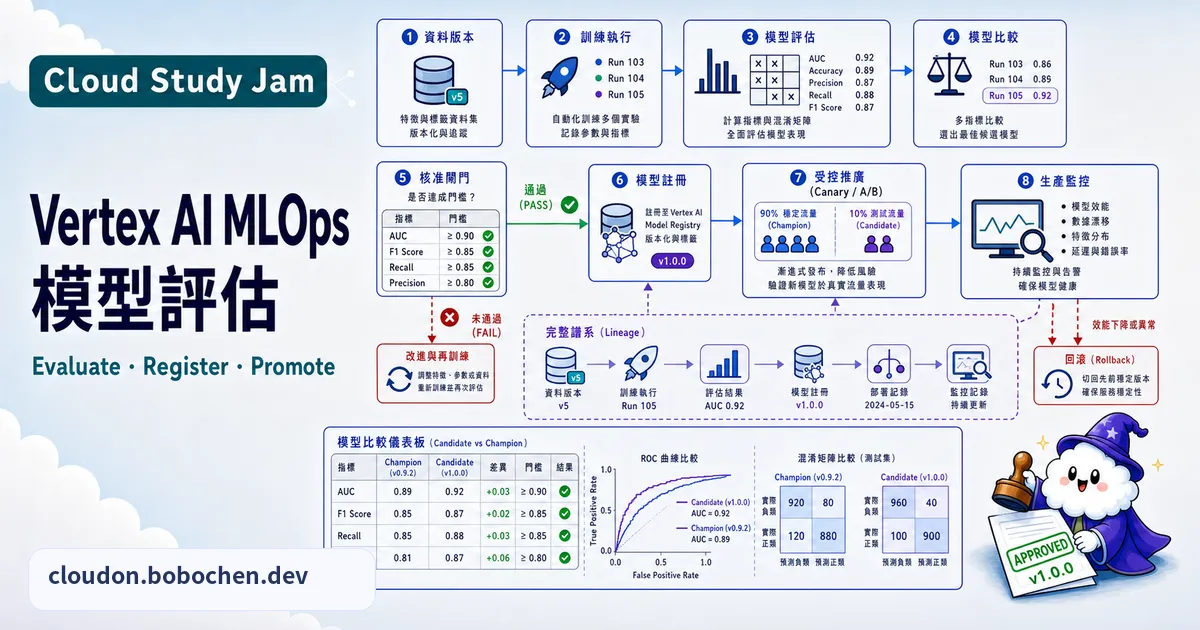
課程概述
模型在 Notebook 裡拿到漂亮分數,不代表它能直接上線。資料可能已經變了、平均分數可能把高風險族群的失敗藏起來,生成式模型還可能在回答品質、安全或工具呼叫上出現傳統指標看不到的問題。
這篇把「評估」當成發布流程的一部分:候選模型先和目前版本使用同一份資料、提示與評分規則比較;通過離線閘門後,才進 Model Registry 和小流量線上實驗。線上護欄一旦超標就回滾,而不是等週報開會才處理。
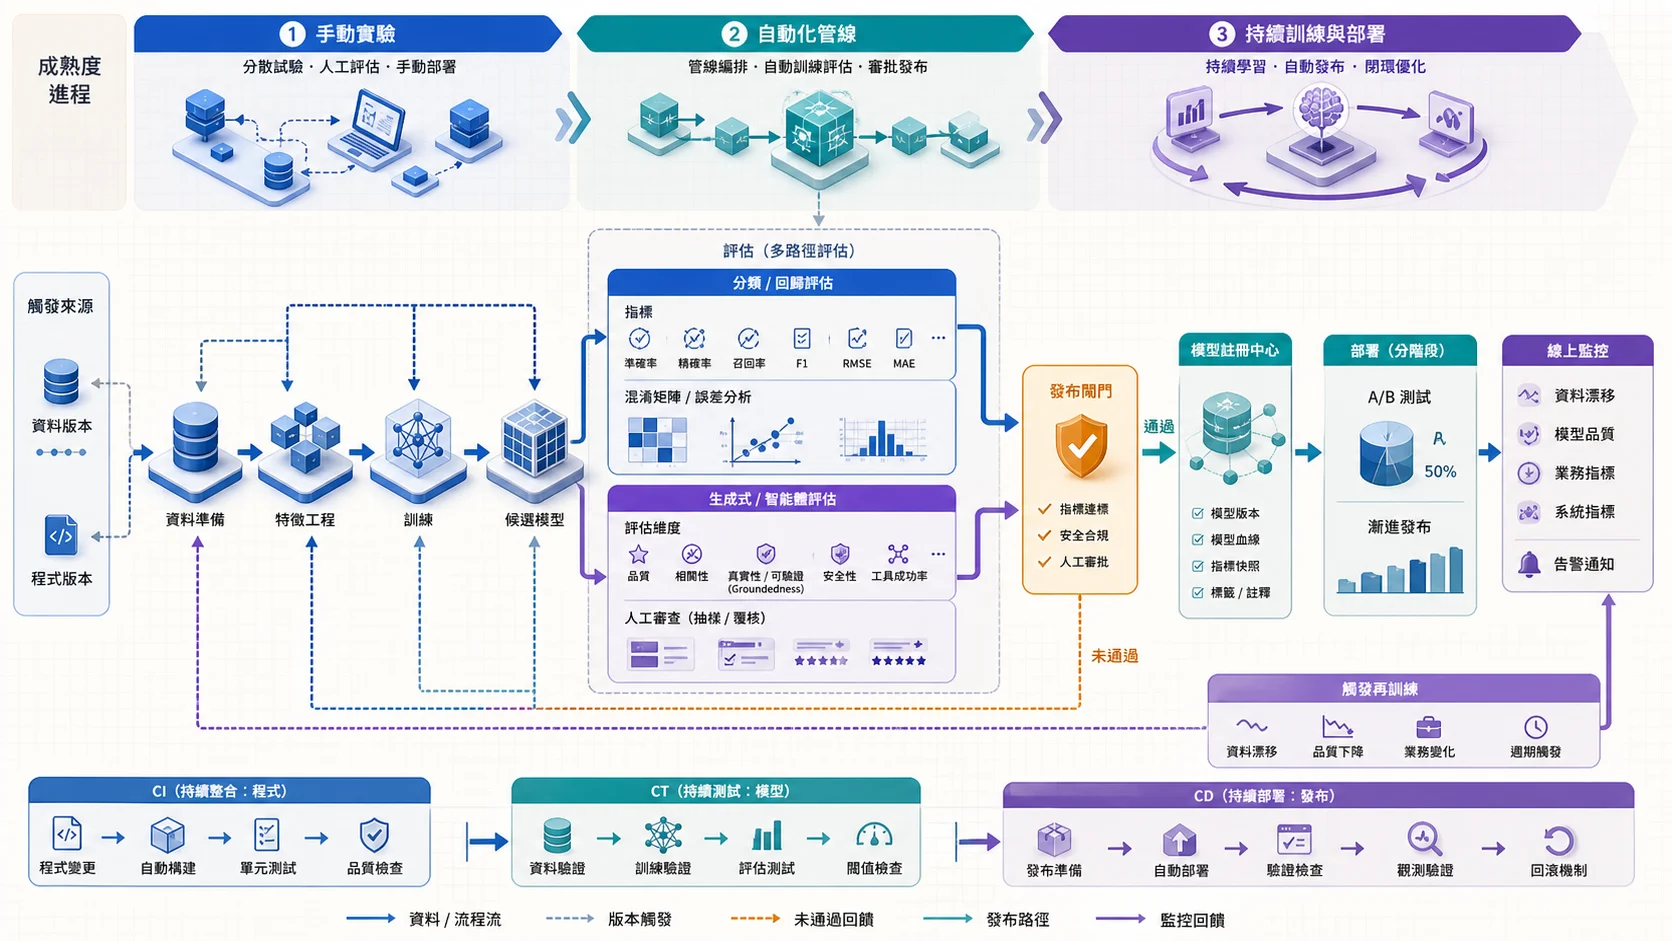
CI 檢查程式與元件,Pipeline 重現資料、訓練和評估,發布閘門則決定候選版本能不能碰正式流量。生成式應用還要把 Prompt、Tool Schema、檢索設定和評分規則一起版本化。
你將學到
- 分開設計傳統 ML、生成式模型與 Agent 的評估方式
- 用資料切片和失敗案例避免平均分數掩蓋風險
- 把評估結果、資料版本與模型版本留在可追溯的流程中
- 正確使用 Model Registry 的版本、Alias 與 Metadata
- 將流量分配、實驗設計、安全護欄和回滾拆開管理
MLOps 不是「把訓練腳本排程」而已
常見的成熟過程可以這樣看:
| 階段 | 平常怎麼工作 | 最容易出事的地方 |
|---|---|---|
| 手動實驗 | 人工準備資料、訓練、評估與部署 | 步驟無法重現,模型和資料版本對不起來 |
| Pipeline 自動化 | 將資料、訓練、評估拆成可重跑元件 | 只自動化流程,沒有品質閘門和失敗通知 |
| CI/CD/CT | 程式、模型、發布與重訓都有觸發條件 | 自動部署太快,錯誤也被更有效率地送上線 |
重點不是追求某個「Level」,而是每次模型變更都能回答:用了哪份資料和程式?跟哪個基準比?誰批准?目前哪些 Endpoint 正在用?出事怎麼退回去?
傳統模型和 Gen AI 不是同一套評估
Vertex AI 的傳統模型評估可以針對分類或迴歸模型,使用測試資料的 Ground Truth 與 Batch Prediction 結果建立 Evaluation,再比較同類型的模型或版本。
分類模型常見指標包括:
- Precision:被判成正類的案例裡,有多少真的為正
- Recall:所有正類案例裡,有多少被找出來
- F1:在 Precision 與 Recall 之間取平衡
- AUC-ROC/PR AUC:看不同門檻下的排序與辨識能力
生成式模型與 Agent 則要使用 Gen AI evaluation 的思路:
- Pointwise:每筆回答依 Rubric 給分,例如有據性、完整性或安全性
- Pairwise:讓候選回答和基準回答直接比較勝負
- Computation-based:Exact Match、ROUGE、BLEU 或自己定義的程式化檢查
- Agent 行為:最終答案品質、工具使用、任務完成率、幻覺、拒絕和升級是否正確
模型裁判可以擴大量測,但仍要拿人類標註校準。裁判模型、Rubric 或 Prompt 一改,分數尺度也可能跟著變;不能把兩次不同規則的分數直接排在同一張趨勢圖上。Agent 專用評估的現行文件仍標示為 Preview,採用前要再確認 Launch stage 和支援範圍。
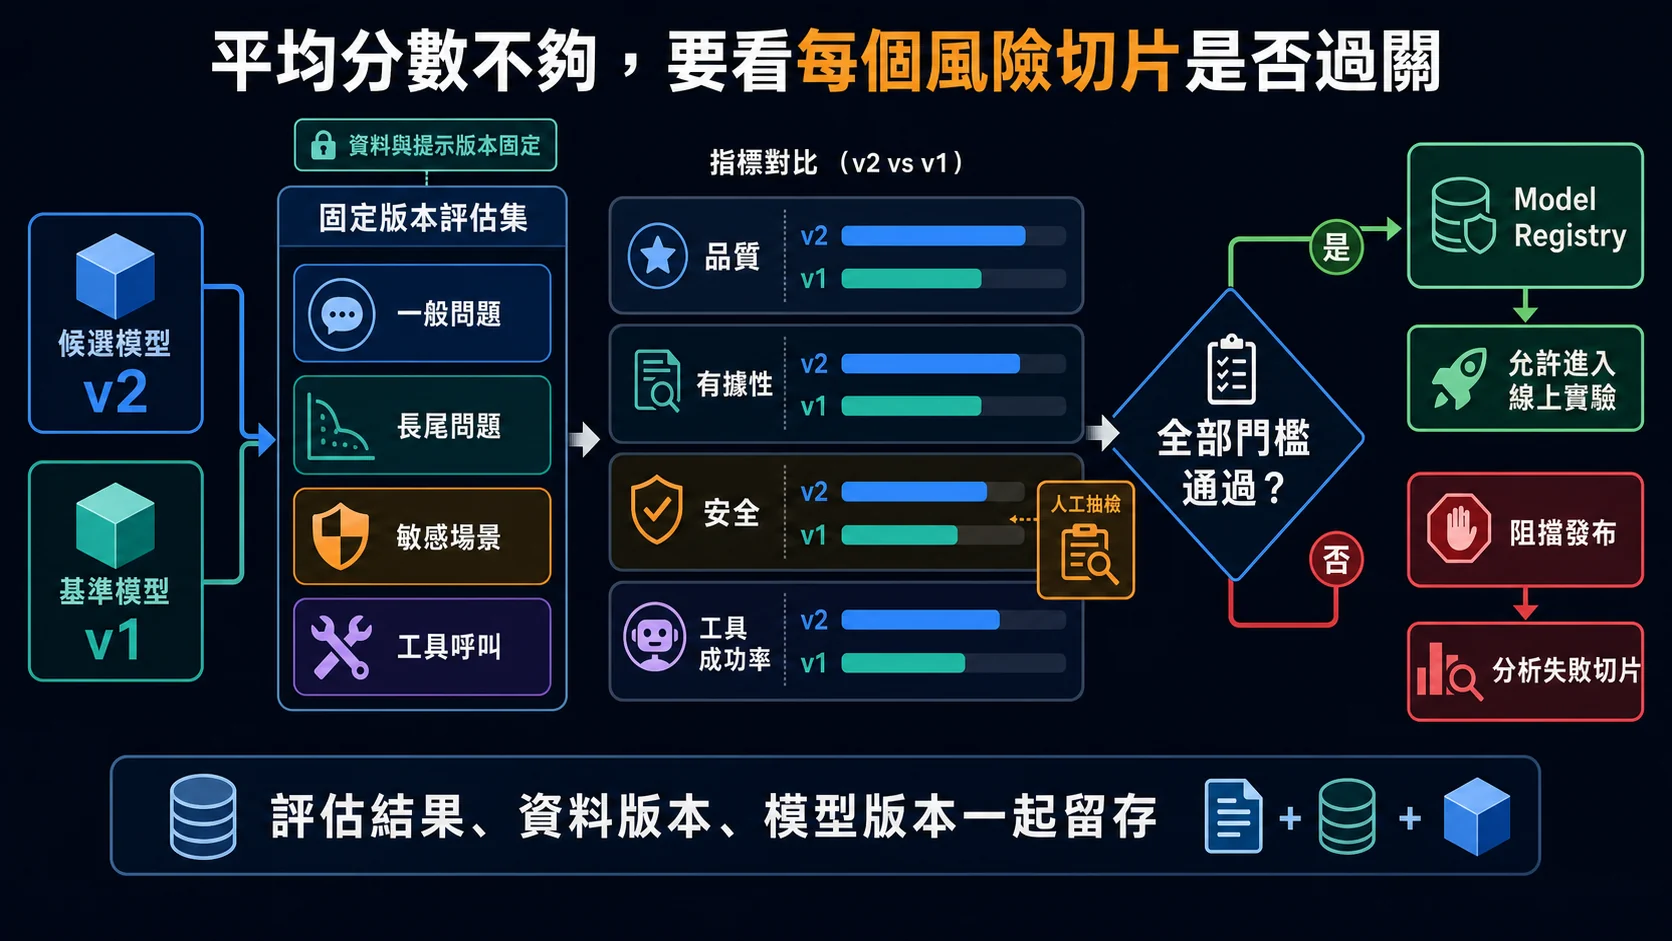
平均分數只能告訴你整體趨勢。真正的發布閘門要逐一檢查長尾、敏感資料、拒答、工具失敗與高價值任務,並保留每筆結果,才能追查是哪一類案例退步。
評估集要有切片,也要防止資料洩漏
至少把案例分成:一般、高頻、長尾、高風險、不同語系、工具成功、工具失敗和應拒絕場景。每個切片各自設門檻,不要只用總平均判斷。
同時確認評估資料沒有混進訓練或 Prompt 調整過程。若團隊反覆盯著同一份測試集修模型,測試集也會慢慢變成開發集。保留一份較少查看的最終驗收集,並定期從正式失敗案例補入新資料。
Pipeline 負責重現,品質閘門負責說不
Vertex AI Pipelines 可以使用 Kubeflow Pipelines SDK 或 TFX,把資料準備、訓練、Batch Prediction、評估和登錄拆成 DAG 元件。Pipeline 跑完不等於模型通過;條件元件應該明確比較基準與門檻,不符合時停止發布並輸出失敗切片。
每次執行至少留下:
- 程式與 Pipeline 版本
- 資料快照、Schema 與特徵版本
- 模型、Prompt、檢索設定和 Tool Schema
- 評估集、Metric/Rubric 和裁判模型版本
- 整體與切片結果、批准者和發布決策
Model Registry 管版本,不替你決定哪個版本安全
同一個 Model resource 可以有多個版本。Registry 的 Alias 是可移動的名稱,例如 candidate、staging 或 stable,作用比較像 Git branch 或容器 tag;它不是 v1.2.3 這種可隨意含小數點的語意化版號。需要不可變識別時,請保留 Model version ID 和對應 Metadata。
把 stable Alias 移到新版本之前,先確認評估、審核與部署狀態。Alias 很方便,也因為可以移動,所以稽核記錄不能只存 Alias。
Traffic split 是送流量的工具,不是一整套實驗平台
Vertex AI Endpoint 可以把流量百分比分配給多個 DeployedModel。這能支援 canary 或線上比較,但實驗還需要另外設計:
- 使用者是否要固定分組,避免同一個人一下看到 A、一下看到 B
- 主要指標、護欄和最小實際影響量是多少
- 樣本數、檢定方法、季節性與停止規則怎麼定
- 什麼情況立即回滾,不等統計顯著
不要把「至少跑一週」當成通則。流量低可能一個月都不夠,流量高也不能因為一天樣本很多就忽略週期效應。實驗時間應由樣本需求、風險和業務週期決定。
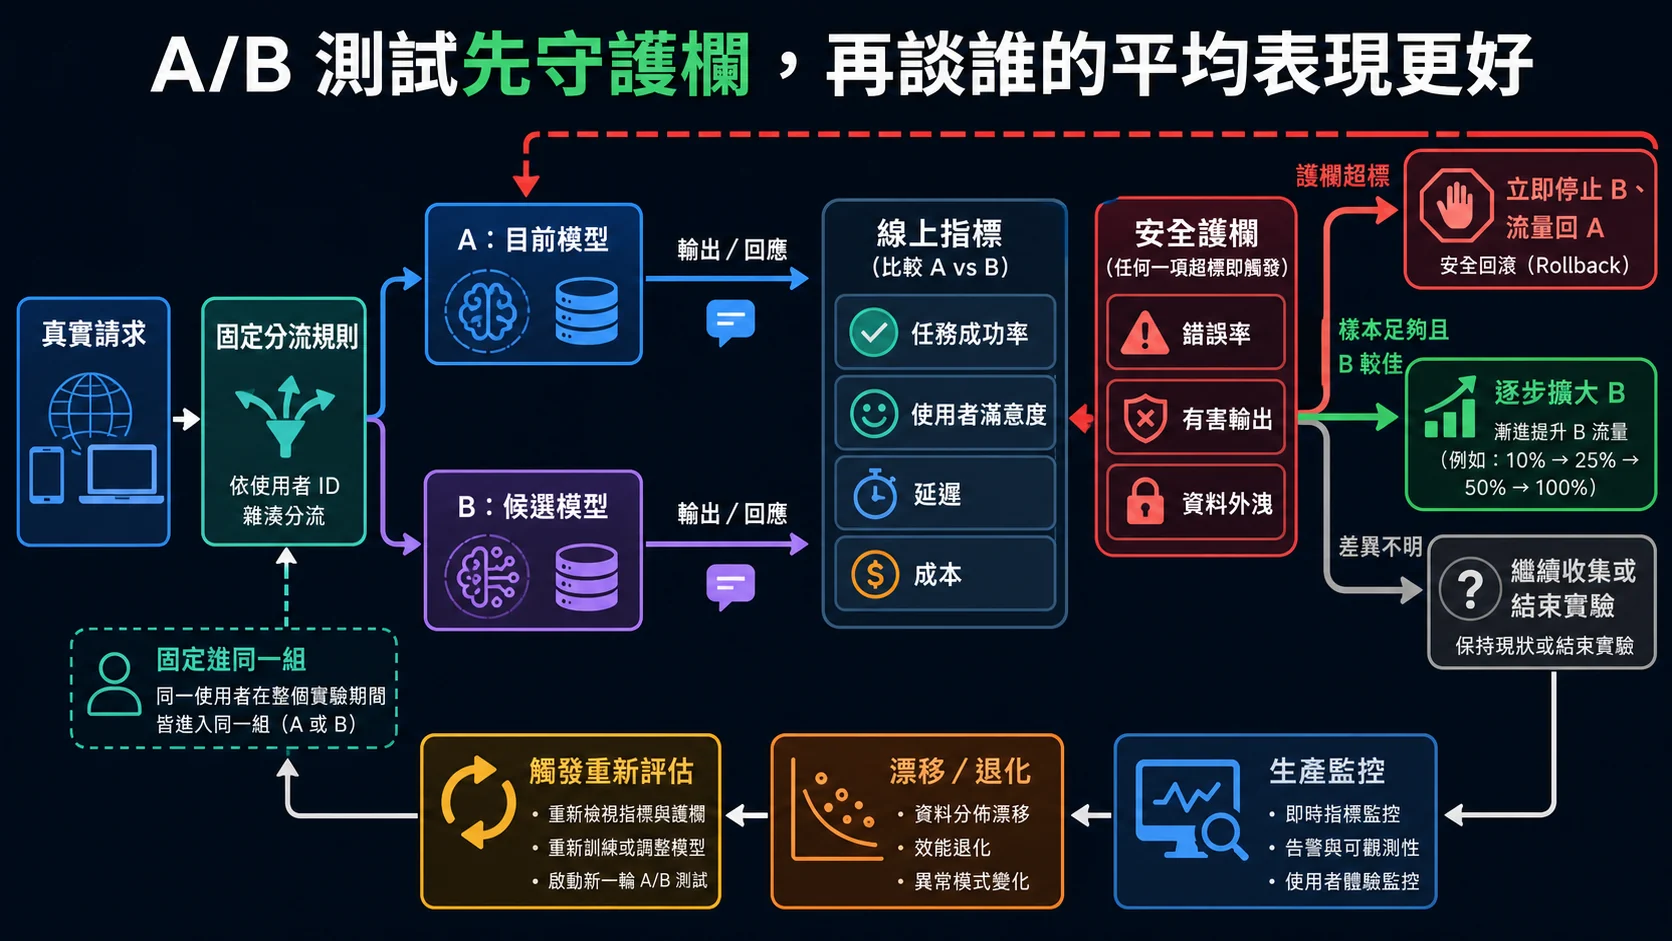
線上實驗先守安全、錯誤率和延遲護欄,再比較主要成效。護欄超標就回滾;候選版本只有在樣本與效果都足夠時才逐步放量。
流程圖暫時無法顯示,請重新整理頁面後再試。
實作重點
- Pipeline 元件固定 Container image 和套件版本,避免同一份定義隔週跑出不同環境
- 門檻同時比較絕對值與相對 Baseline,並為高風險切片設定不可退步條件
- 生成式評估保留逐筆回應、分數和說明;抽樣檢查裁判是否和人類標註一致
- Endpoint 流量比例總和必須是 100;需要使用者黏著分組時,在應用層設計實驗分派
- 回滾前先演練監控訊號、權限、指令和依賴資源,不要等事故發生才確認舊版本還能不能用
- 上線後同時看品質、任務成功率、拒答、工具錯誤、延遲、成本與資料漂移
Lab 導讀
Lab 連結:MLOps with Vertex AI: Model Evaluation — Google Cloud Skills Boost
Lab 會把訓練、評估和部署串進 Pipeline。做完預設步驟後,請再加一個「候選版本沒有勝過基準」的案例,確認 Pipeline 真的停止在評估關卡;如果失敗仍能一路部署,這條 Pipeline 只是自動化,不是品質閘門。
延伸學習
- 部署多代理系統 — 將評估延伸到工具與多代理交接
- AI Agent 安全 — 把安全測試和事件回應放進發布流程
- Agent Development Kit — 回顧 Agent Tool、Session 與部署邊界
- Vertex AI 模型評估 — 傳統模型的 Evaluation 流程
- Gen AI 評估結果 — Pointwise、Pairwise 與逐筆結果
相關文章
您可能也會對這些文章感興趣
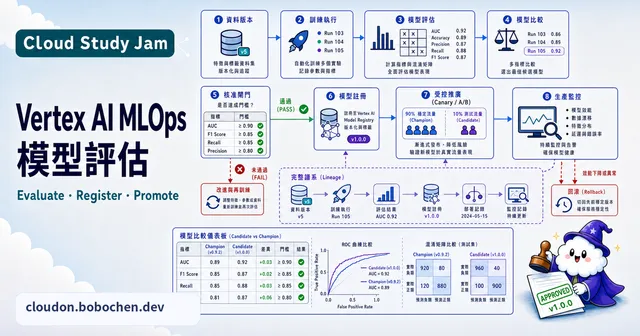
Vertex AI 模型評估:不要讓平均分數決定上線
把離線切片、Gen AI 評估、Model Registry、線上實驗、護欄與回滾串成能真正擋住退化模型的發布流程
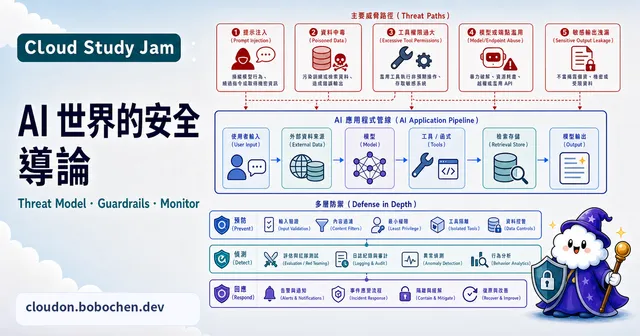
AI Agent 安全:別只叫模型「不要洩密」
從 Prompt Injection、工具越權與資料外洩,到 Model Armor、IAM、VPC Service Controls 和人工核准的分層防禦
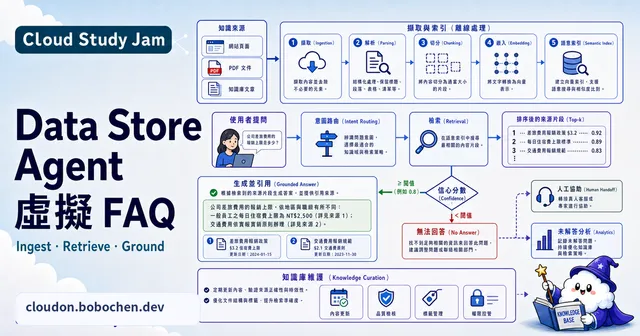
Data Store Agent:FAQ 準不準,先看資料
從資料來源、版控、ACL、解析與切片到引用驗證,整理一套能持續維護的企業知識問答上線流程
