
Gemini+Imagen 圖片應用:生成只是中間一步

課程概述
圖片 API 回傳一張圖,只代表「模型有產出」,離能公開發布還有一大段路。使用者有沒有上傳素材的權利?Prompt 是否帶個資?人物生成是否符合政策?圖片裡的 Logo、文字、手指和產品外觀有沒有跑掉?產出之後,誰核准、能用在哪裡、何時下架?
這篇把課程裡的 Gemini+Imagen 概念,更新成目前比較耐用的架構:Gemini 負責理解需求、追問缺少資訊和產生結構化視覺規格;圖片模型負責生成或編輯;模型前後再加上權利、安全、品質、人工審核與資產治理。生成不是終點,只是中間一站。
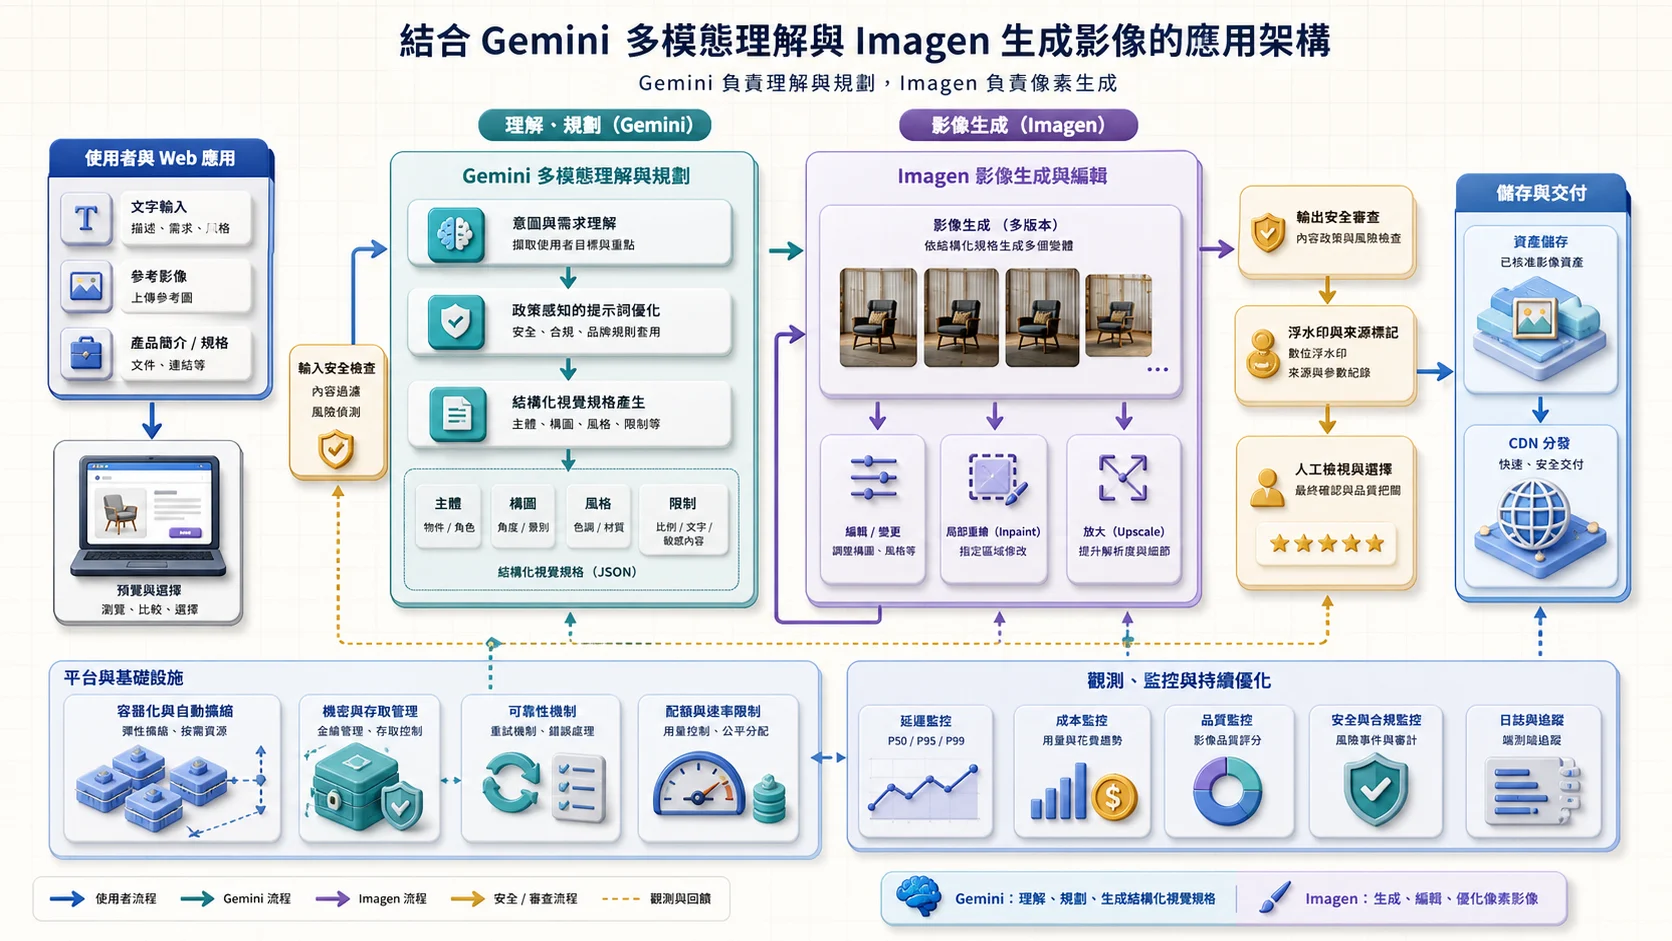
Gemini 負責理解與編排,圖片模型負責像素生成或編輯。生產應用還要處理輸入輸出安全、來源權利、人工選擇、重試、配額、成本和品質監控。
你將學到
- 將自然語言需求轉成可驗證的結構化視覺規格
- 依生成、編輯、品質、延遲與發布階段選擇圖片模型
- 在模型前檢查檔案、身分、同意、權利與安全政策
- 用非同步 Job、Idempotency、Quota 和成本上限扛住實際流量
- 為每張生成資產留下來源、版本、審核與下架紀錄
先處理模型版本,不要把 ID 寫死在文章裡
圖片模型變動很快。截至 2026 年 8 月,Google Cloud 已把多個舊 Imagen 3/4 GA 生成端點列為停止使用,建議遷移到 gemini-2.5-flash-image;較新的 gemini-3.1-flash-image 是 Preview。正式系統不要只因為版本號較新就直接換:
- GA 工作負載優先選仍受支援、符合地區與安全控制需求的穩定模型
- Preview 模型先確認 Pre-GA 條款、配額、SLA、資料治理和回退方案
- 把 Model ID、Region、Safety setting 和輸出參數放在設定層,不散落在程式碼
- 建立模型路由與 Feature flag,才能小流量比較品質、成本和延遲
- 每次上線前查 Model lifecycle 與 Deprecation,不沿用過期 Lab 範例
這篇仍用「Imagen」描述 Google 的圖片生成能力與課程脈絡,但實作時要以當下官方 Model lifecycle 為準。
Gemini 應該產生規格,不是幫 Prompt 堆形容詞
直接請模型把「幫我做一張產品廣告」改寫得更華麗,常會得到一串很長、卻不好驗證的英文 Prompt。更穩的做法是請 Gemini 輸出 Schema 固定的物件:
{
  "purpose": "首頁主視覺",
  "subject": "霧黑色智慧手錶",
  "scene": "台北清晨河濱,無可識別路人",
  "composition": "產品置中,右側保留標題留白",
  "style": "寫實商業攝影,柔和自然光",
  "aspectRatio": "16:9",
  "mustInclude": ["產品外觀與核准素材一致"],
  "mustAvoid": ["文字", "第三方商標", "可識別人物"],
  "reviewLevel": "marketing-human-review"
}
後端先用 JSON Schema 驗證欄位和允許值,再轉成目標模型的 Prompt。缺少用途、尺寸、受眾或人物同意時,讓 Gemini 追問,不要自行腦補。
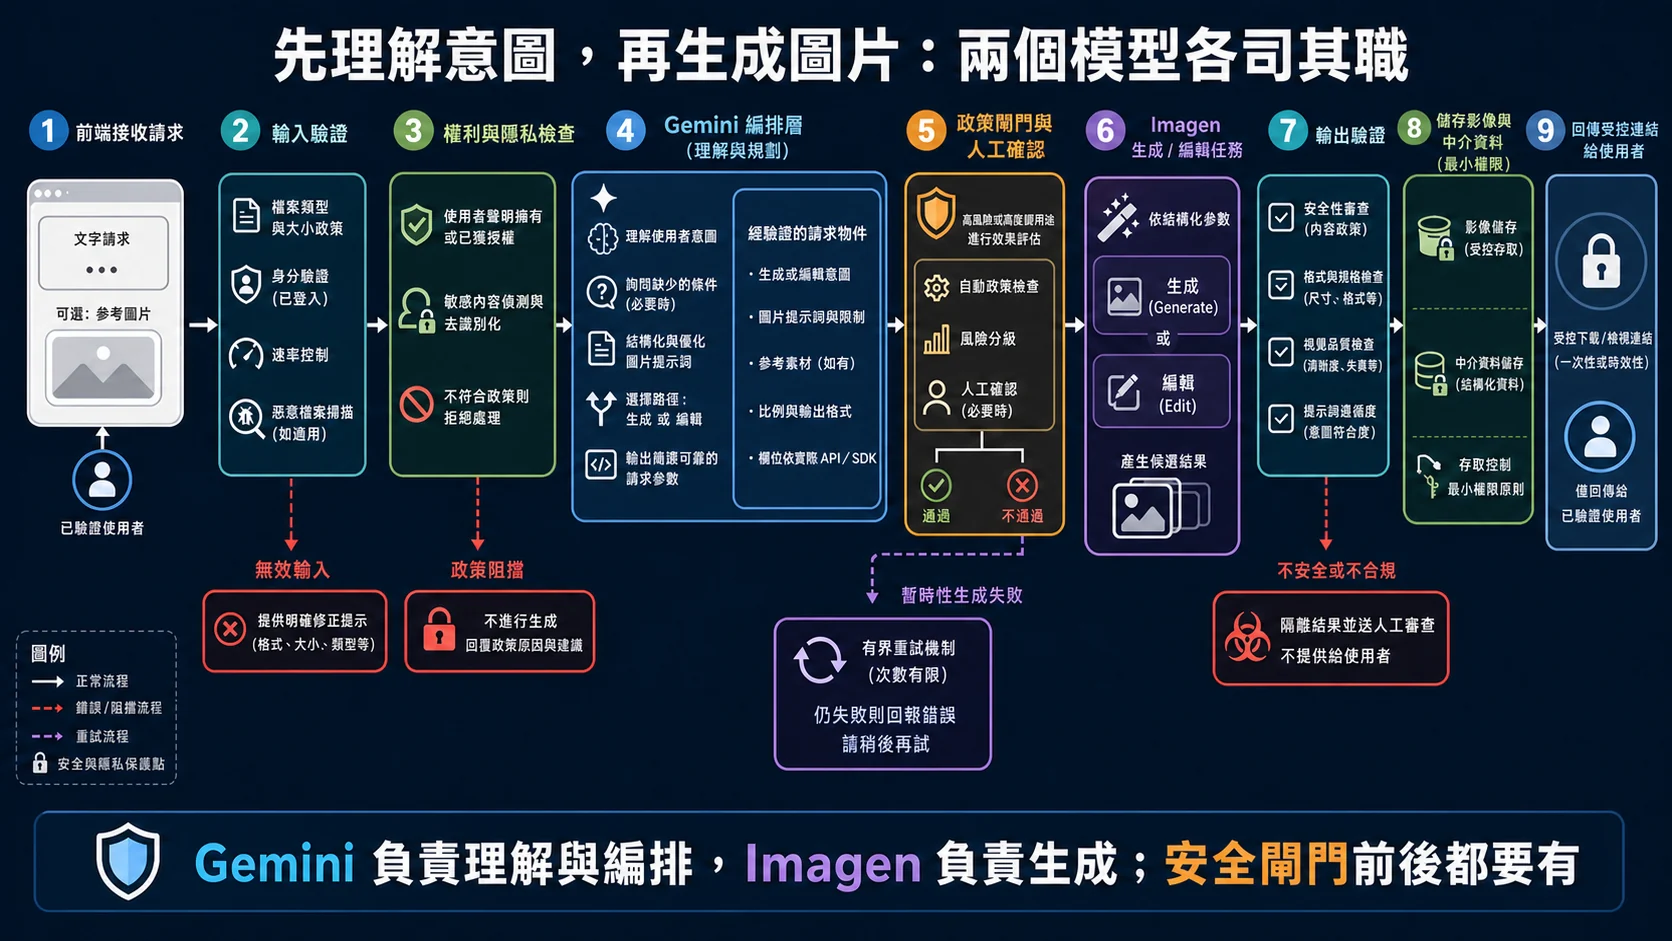
模型前先驗證檔案、身分、權利與政策;模型後再檢查安全、格式、品質和意圖符合度。輸入不合格就拒絕或追問,不能靠模型猜。
安全過濾是底線,不是發布核准
Imagen 對輸入 Prompt、上傳圖片和輸出圖片有內建安全過濾,部分模型也能調整安全與人物生成設定。生成圖片可帶 SynthID 數位浮水印,官方也建議清楚揭露 AI 生成內容。不過這些機制不會替你的公司處理所有情境:
- 使用者是否真的有權利上傳這張產品、人像或風格參考圖
- 人物是否同意被編輯,未成年人或公眾人物是否需要更嚴格限制
- 生成內容是否侵害商標、著作權、肖像權或廣告規範
- 圖片是否帶偏見、誤導,或在醫療、金融、新聞情境造成錯誤暗示
- 品牌 Logo、產品規格、包裝文字與法定警語是否正確
因此,應用要同時有供應商安全過濾、自家政策規則、自動品質檢查和依風險分級的人工審核。被模型擋下時,把原因轉成安全的錯誤類別;不要無限改寫 Prompt 來繞過過濾。
圖片生成適合非同步 Job
生成時間、輸出大小和配額會隨模型、Region、解析度、張數與流量改變,文章裡寫死「一定 5~15 秒」或「Cloud Run 至少 1 GiB」反而會誤導。比較穩的架構是:
- API 驗證使用者、檔案類型、像素、大小、Checksum 和權利聲明。
- 以 Idempotency key 建立 Job,避免前端重送造成重複扣費。
- Queue/Worker 依配額取件,設定 Timeout、有界重試和 Dead-letter queue。
- 呼叫模型時記錄 Model ID、Region、參數與版本化 Prompt,不記不必要的敏感內容。
- 輸出先進隔離 Bucket,跑安全、格式、解析度、品質和意圖符合度檢查。
- 通過人工審核後才複製到發布 Bucket,使用短效 Signed URL 或 CDN 交付。
容量要用壓力測試決定。觀察 Queue age、生成成功率、被擋比例、p95/p99 延遲、每張成本、重試率和人工退件原因,再調整 Cloud Run concurrency、CPU、Memory、Min instances 與配額。
每張圖都要能回答「它怎麼來的」
一筆可治理的生成資產,至少留下:
- Requester、用途、專案、成本中心與 Idempotency key
- 原始素材位置、Checksum、權利/同意聲明和保留期限
- 結構化視覺規格、Prompt 版本、Model ID、Region 與生成參數
- Safety filter、品質檢查與人工 Reviewer 的結果
- 發布位置、允許使用管道、到期日、替換與下架狀態
別把完整 Prompt、原圖和敏感 Metadata 塞進公開圖片。公開層只放需要揭露的 AI 標示和適合對外的來源資訊;內部稽核紀錄則用 IAM、Retention 和 Audit Log 保護。
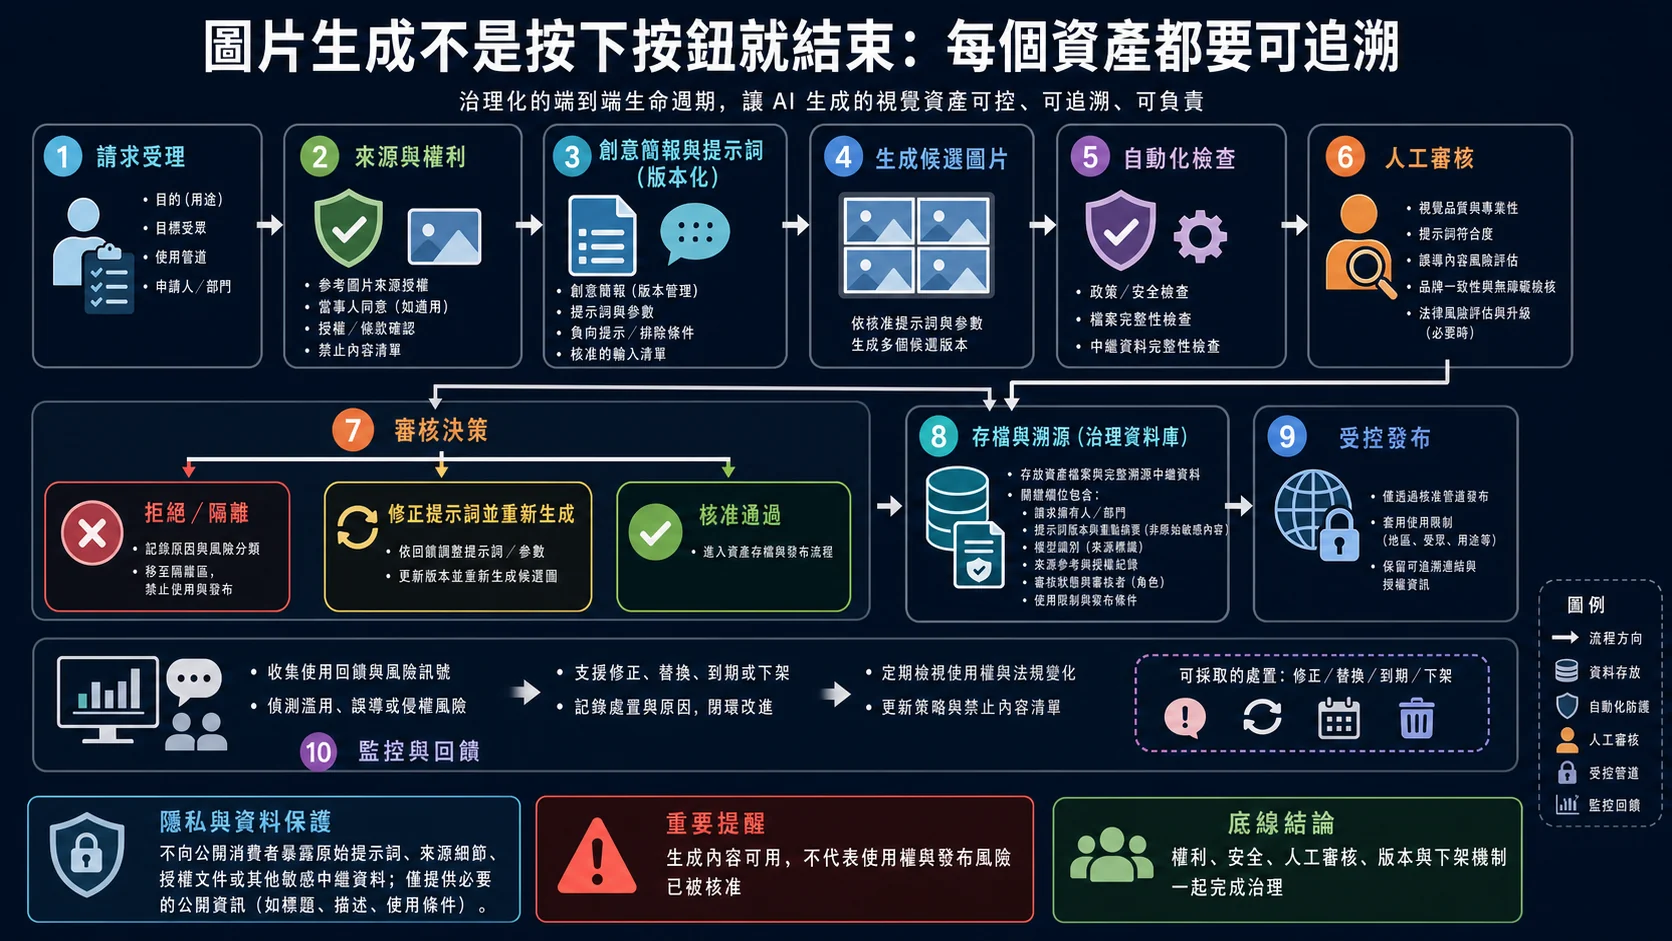
生成成功不等於獲准發布。每張圖要留下請求人、模型、規格、來源權利、審核狀態和使用限制;發布後也要能修正、替換、到期或下架。
流程圖暫時無法顯示,請重新整理頁面後再試。
實作重點
- 使用目前官方建議的
google-genaiSDK,並把 Model ID 留在設定層 - 上傳檔先檢查 Magic bytes、MIME、像素、大小與 Malware,不只看副檔名
- 用 Idempotency key、Queue 和 Dead-letter queue 避免重複扣費或無限重試
- 為單一使用者、租戶和專案設定 Quota、Rate limit 與每日成本上限
- 原始素材、隔離輸出與發布資產用不同 Bucket/Prefix 和 IAM 邊界
- 安全過濾被擋是正常結果,要有可觀測的錯誤碼和不洩漏內部規則的使用者訊息
- 上線前用自己的品牌、人群、語言和高風險案例做 Evaluation,不只看幾張漂亮 Demo
Skill Badge 指引
Lab 連結:Build Real World AI Applications with Gemini and Imagen — Google Cloud Skills Boost
如果 Lab 還使用舊 Model ID,把它當成理解流程的教材。實作前先查官方 Lifecycle,再把 Model ID、Region 和 Safety setting 抽成設定,順便練一次模型切換與回退。
延伸學習
- Gemini API 動手做 — 熟悉結構化輸出和多模態輸入
- Prompt Engineering 技巧 — 把需求寫成可測、可重現的規格
- GCP PCA:AI/ML 與 Vertex AI — 理解平台、權限、部署與 MLOps
- Vertex AI 生成式 AI 版本公告 — 上線前確認圖片模型的最新狀態
相關文章
您可能也會對這些文章感興趣
Gemini+Imagen 圖片應用:生成只是中間一步
從意圖、素材權利與安全政策,到圖片模型選擇、非同步生成、人工審核與資產治理,設計真正能上線的圖片應用
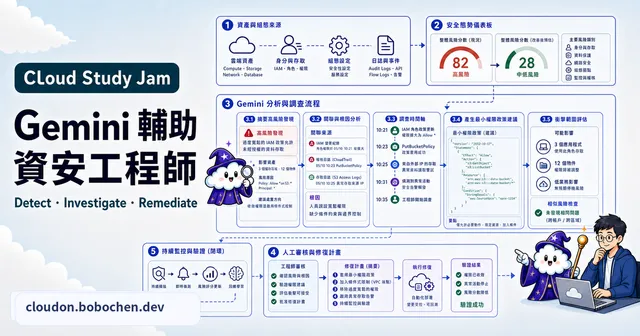
SCC Finding 分流:先查證,再讓 Gemini 幫忙
把 Security Command Center Finding、攻擊暴露、IAM 路徑與稽核日誌串成可查證的風險脈絡,再安全地縮權與修復
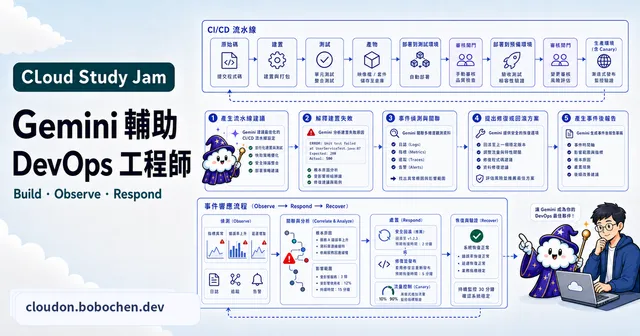
Gemini Cloud Assist 給 DevOps:先穩定,再找根因
用安全交付閘門、漸進發布與共同事件時間線,把 Gemini 的建議變成可查證、可回滾的 DevOps 與 SRE 行動
