
Gemini Cloud Assist 給 DevOps:先穩定,再找根因

課程概述
Gemini 可以很快寫出一份 cloudbuild.yaml、解釋 Stack trace,也能從 Log、Metric、Alert 和設定整理根因假設。問題是,「看起來很合理」不等於能直接上 Production。Pipeline 多放一個過寬的 Service account、Canary 沒綁 SLO,或事故中照著錯誤假設執行破壞性指令,速度越快,出事也越快。
比較穩的做法,是把 AI 放在兩條有護欄的流程裡:交付時協助草擬與解釋,但每個 Artifact 都要通過測試、安全、政策與發布閘門;事故時協助整理證據和候選根因,但由事件指揮官決定 Severity、緩解和回滾。先恢復服務,再慢慢把根因查清楚。
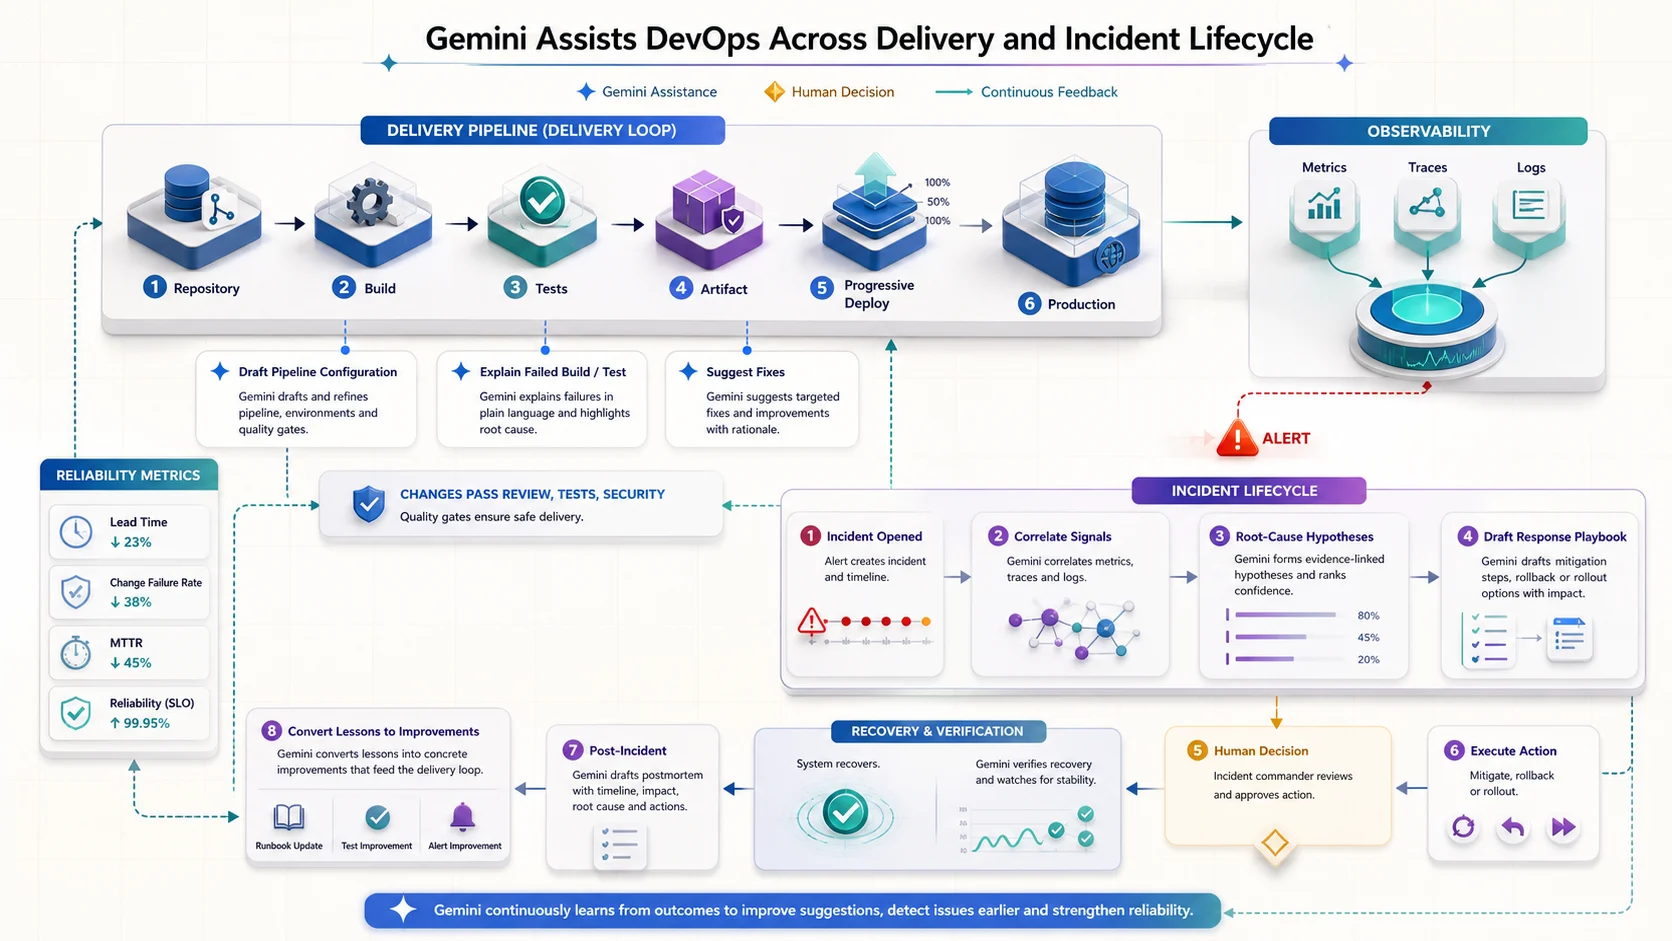
Gemini 可以縮短交付與調查時間,不能略過 Review、Test 和 Security Gate。事故中先關聯訊號、建立假設,再由人決定 Mitigation;事後把學到的事補回測試、告警和 Runbook。
你將學到
- 把 Gemini 產生的 Pipeline 設定當成待審查的 Patch
- 用不可變 Artifact、Provenance、SBOM 和弱點掃描守住供應鏈
- 用 Cloud Deploy Verification 與 Canary/Progressive Rollout 控制風險
- 從 Logs Explorer 或 Monitoring Alert 建立有來源的調查
- 在事故中分清楚影響、症狀、假設、緩解和根因
AI 產生的 Pipeline,第一步是 Review
請 Gemini 草擬 cloudbuild.yaml 時,至少要把這些限制說清楚:
- Source、Branch、Trigger 和執行環境
- 每一步使用的 Builder image 與固定版本
- 測試、Lint、型別檢查和整合測試的成功條件
- 哪個 Service account 執行 Build,各步驟最少需要哪些權限
- Secret 從哪裡取用,哪些內容不能進 Build log
- Artifact 要推到哪個 Registry,如何留下 Digest 和 Provenance
- 弱點、License、Policy 或測試失敗時,要不要阻擋發布
不要只問「幫我最佳化 Pipeline」。平行化錯誤的相依步驟、共用可被污染的 Cache,或把 Secret 直接塞進 substitution,都可能換到更快但更危險的 Build。
Build 成功,不代表 Artifact 可以發布
一次可追溯的交付,應該從同一個通過檢查的 Artifact 往後推,不要每個環境重新 Build。Cloud Build 與 Artifact Analysis 的 Security insights 可以呈現 Build log、Provenance、SBOM 和弱點資訊;真正要不要放行,則要由團隊明確寫成 Gate。
| Gate | 至少要回答的問題 | AI 可以幫什麼 |
|---|---|---|
| 程式品質 | 測試、Lint、型別與整合測試是否通過? | 解釋失敗、縮小可疑 Diff |
| 供應鏈 | Image Digest、Provenance、SBOM 是否完整? | 整理套件與來源差異 |
| 安全政策 | 弱點、License、Secret 與 IaC Policy 是否合規? | 排序修復候選,不自行豁免 |
| 發布條件 | 誰核准?Canary 看哪些 SLI?何時回滾? | 草擬檢查表和 Release note |
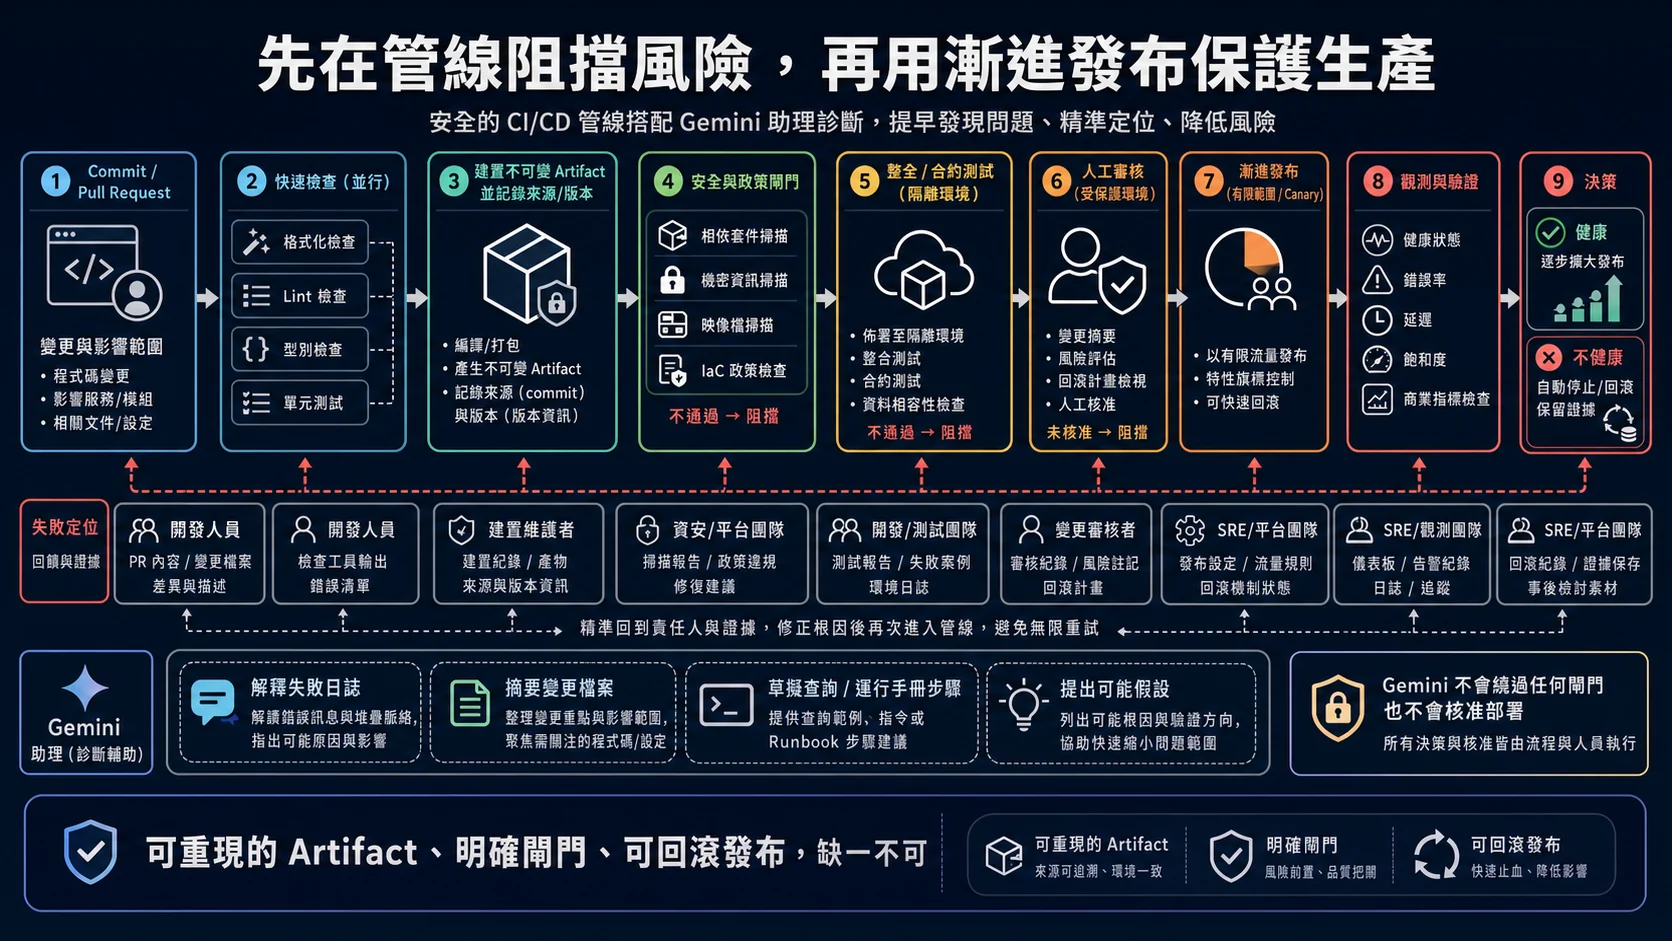
同一個不可變 Artifact 通過品質、供應鏈、安全與核准閘門後,才小範圍發布。Gemini 可以解釋失敗或整理變更,不能替團隊關掉 Gate。
Canary 要看訊號,不是等時間到
Cloud Deploy 支援 Standard 和 Canary 策略,也能在部署後執行你定義的 Verification task。Canary 每一階段應綁定可判斷的條件,例如:
- Error rate、Latency 和 Availability 是否仍在 SLO/Error budget 內
- 新舊版本的關鍵業務成功率是否有顯著落差
- 飽和度、Queue depth、Retry、Dependency error 是否惡化
- 資料庫 Migration 能否相容新舊版本並安全回復
- 觀察窗口內有沒有足夠流量,不要拿三筆請求宣布成功
AI 可以建議門檻,但不能憑一段 Dashboard 截圖決定擴到 100%。基準期間、低流量例外、Seasonality 和回滾條件要由服務團隊先訂清楚。
Gemini Cloud Assist 調查要從共同時間線開始
Gemini Cloud Assist 可以在 Cloud Observability 用自然語言探索 Metric、Log、Alert 和 Error。Investigations 會產生 Observation、Hypothesis 和建議,並附上部分來源連結,方便你回頭查證。
使用 Investigations 時要知道目前的邊界:它仍是 Preview;自 2026 年 4 月 10 日起,新建、執行和編輯調查只開放 Premium Support,或已透過 Account team 取得權限的使用者。調查也受操作者本身 IAM 權限和支援資源範圍限制,沒提到某個資源不等於那個資源沒問題。
不論用不用 Investigations,先整理這份最小事件包:
- 影響到哪個使用者旅程、Region、Tenant 或版本
- SLO/SLI 怎麼變,事故何時開始,現在還在不在
- 前後 30~60 分鐘的部署、設定、Flag、IAM 和依賴異動
- Alert、Metric、Trace、Log 與外部依賴的共同時間線
- 已試過哪些動作,結果如何,哪些動作不可逆
事故中先穩定,不要急著證明根因
Gemini 可以列出五個可能原因,但 Severity 和影響範圍仍要用真實 SLI、客服訊號和業務資料判斷。事件中的優先順序通常是:
- 指派 Incident Commander、Scribe 和技術負責人,建立單一溝通頻道。
- 確認使用者影響、事故起點和目前趨勢,不被單一 Error log 帶走。
- 建立按證據排序的假設,為每個假設指定下一個快速驗證。
- 選風險最低、可逆的緩解,例如停止 Rollout、回復 Flag、切換流量或降級功能。
- 服務穩定後保存證據,再區分 Trigger、Contributing factor 和 Root cause。
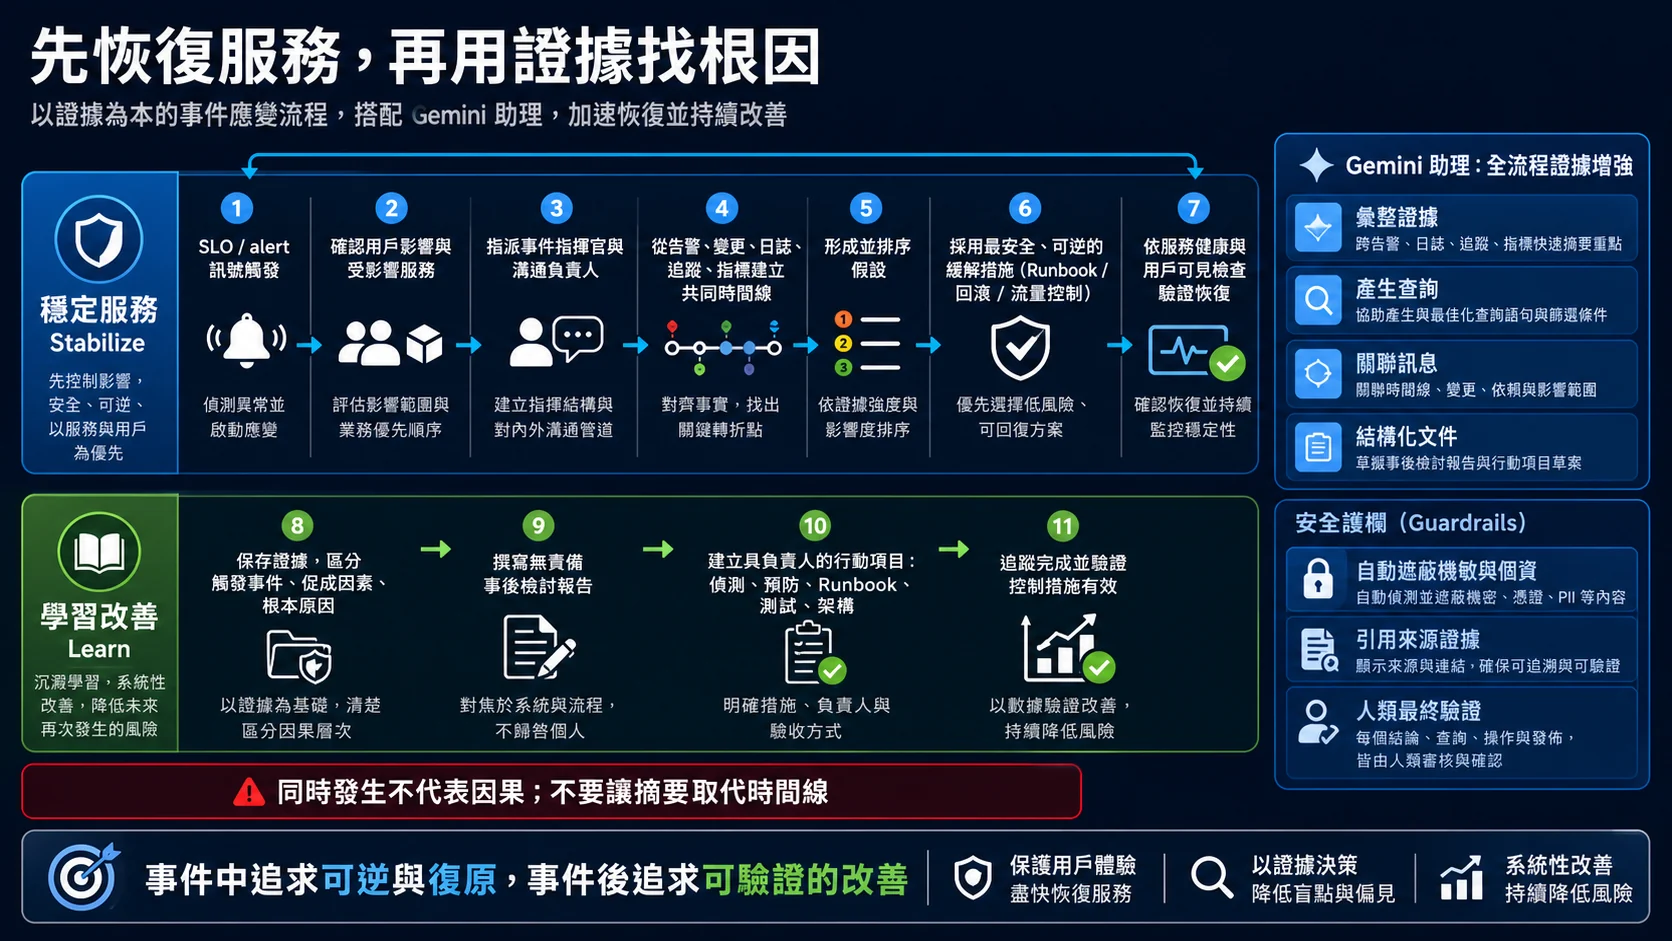
事件中先控制影響並恢復服務;事後才完整追根因。Postmortem 的改善項目要有 Owner、期限和可驗證結果,不是只寫「以後更小心」。
流程圖暫時無法顯示,請重新整理頁面後再試。
實作重點
- Gemini 產生的 YAML 先過 Schema、Lint、Plan 與非 Production 測試
- Builder image、Action 和依賴盡量固定版本或 Digest,避免供應鏈在無變更下漂移
- 建立一次 Artifact,使用同一 Digest 跨環境 Promotion
- Cloud Deploy Verification 要跑團隊自己的測試容器;Exit code 才是成功或失敗依據
- Log 摘要與調查結果要回點原始資料,並核對時間範圍、資源與時區
- 事故期間不要把 Secret、Token、個資或完整 Payload 貼進 Prompt
- Postmortem Action item 要能由測試、告警或演練驗證真的完成
Skill Badge 指引
Lab 連結:Gemini for DevOps Engineers — Google Cloud Skills Boost
做 Lab 時可以故意留一個會失敗的 Test 或 Verification,觀察 Gemini 怎麼解釋,再回原始 Log 找證據。練習的重點不是讓 AI 猜中,而是知道什麼時候可以採信、什麼時候要停下來查。
延伸學習
- GCP PCA:CI/CD 與 SDLC — 建立可追溯、可核准的交付流程
- GCP PCA:可觀測性與 SRE — 用 SLO 與 Error budget 管理可靠性
- Gemini Code Assist 上手 — 把 AI 建議納入日常 Patch Review
- Gemini Cloud Assist Investigations — 查閱資格、支援來源與 Preview 限制
相關文章
您可能也會對這些文章感興趣
Gemini Cloud Assist 給 DevOps:先穩定,再找根因
用安全交付閘門、漸進發布與共同事件時間線,把 Gemini 的建議變成可查證、可回滾的 DevOps 與 SRE 行動
Gemini+Imagen 圖片應用:生成只是中間一步
從意圖、素材權利與安全政策,到圖片模型選擇、非同步生成、人工審核與資產治理,設計真正能上線的圖片應用
SCC Finding 分流:先查證,再讓 Gemini 幫忙
把 Security Command Center Finding、攻擊暴露、IAM 路徑與稽核日誌串成可查證的風險脈絡,再安全地縮權與修復
