
PCA 雲端架構師之旅 12 — 災難復原 (DR)
前一步處理了單一元件或 Zone 故障。若整個 Region 都無法使用,或地端機房長時間中斷,就需要另外準備復原計畫;自動擴縮和健康檢查無法代替這一步。
先確認兩個數字:最多能停多久(RTO),以及最多能接受遺失多久的資料(RPO)。有了目標,才能比較備份還原、Pilot Light、Warm Standby 或 Active-Active 的成本與準備工作。
這是 PCA 雲端架構師之旅 的第 12 步。
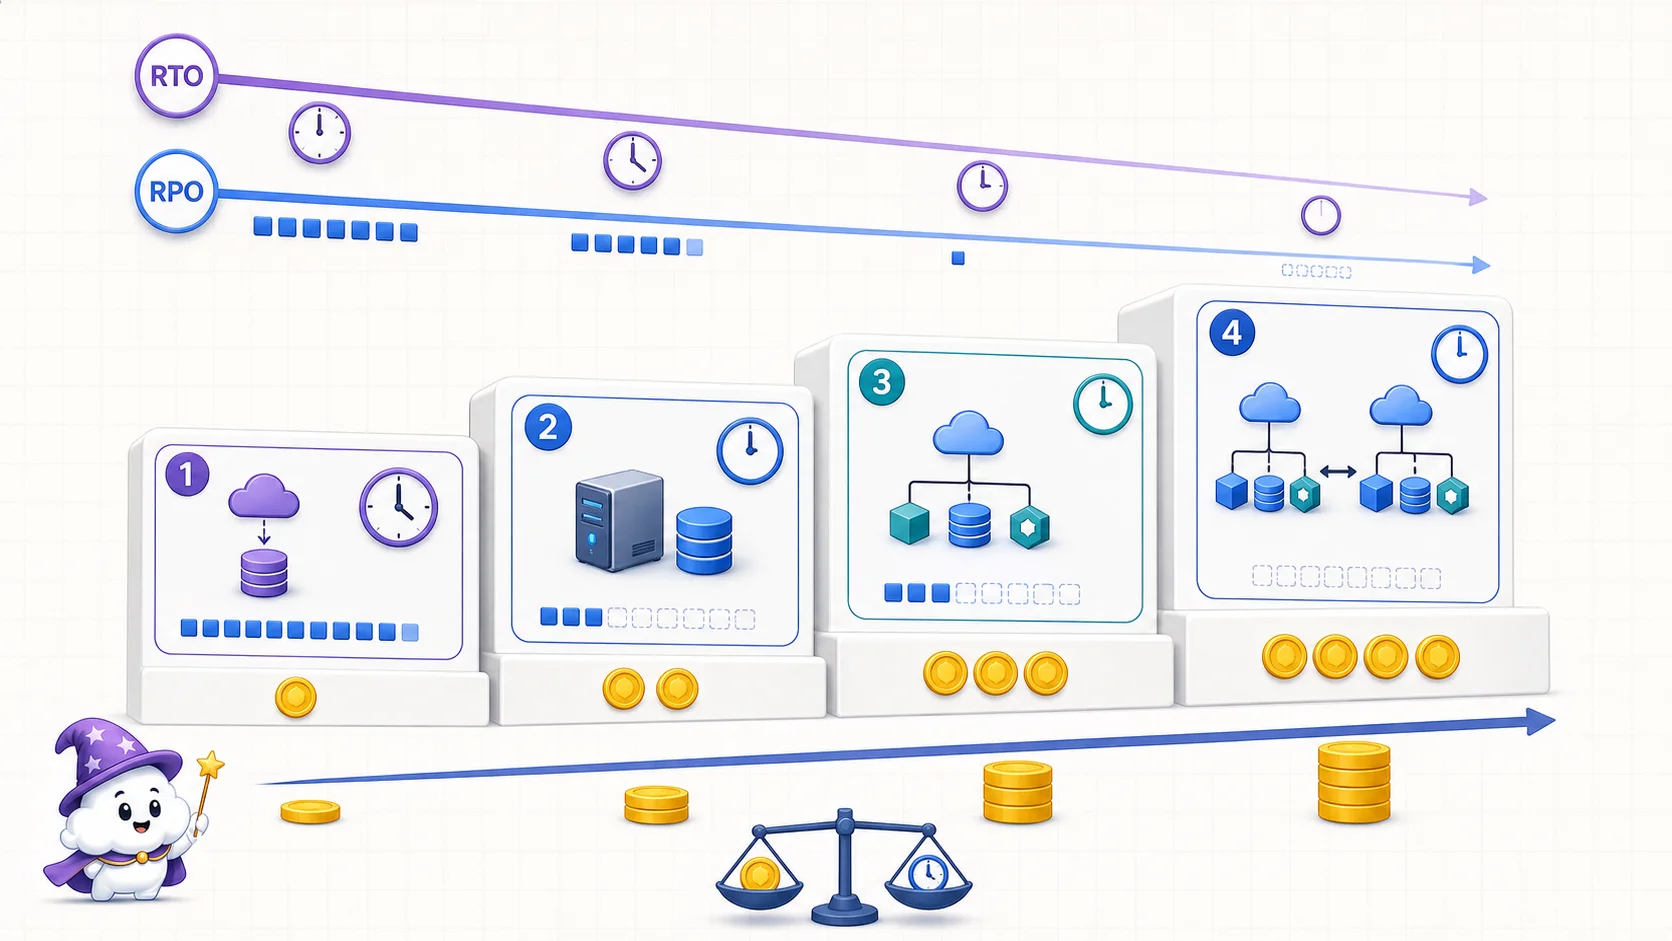
從備份還原到 Active-Active,常駐資源通常越來越多,故障時要啟動的工作則越來越少。但資料損失取決於複寫與提交方式,不能只看策略名稱;實際 RTO/RPO 要用演練驗證。
先分清楚:服務何時恢復,資料會退回多久?
RTO 和 RPO 常被放在一起講,但回答的是不同問題:
RTO(Recovery Time Objective)是「災難發生後,多久之內服務要重新跑起來」。RPO(Recovery Point Objective)是「恢復後的資料,最多可以退回到多久以前」。一個關心停機時間,一個關心資料落後的時間,兩者要分開訂。
case study 不會直接寫「RTO = 1 小時」這麼方便,它會包在情境句裡,等你自己翻譯:
- 「主 region 失效後,服務必須在 1 小時內恢復」→ 這是在講 RTO
- 「最多可以接受遺失 15 分鐘的交易資料」→ 這是在講 RPO
- 「金流系統不能遺失已確認的交易」→ 要討論 RPO = 0,以及哪些寫入才算已確認
零資料遺失不能只靠備份頻率保證。必須定義交易何時算提交,並確認複寫與故障切換能否保住已提交資料;同步複寫是可能的設計手段,但會增加延遲與成本。
只在 DR 文件裡填好 RTO、RPO 還不夠。要確認備份能還原、環境能啟動、流量能切換,並讓負責的人演練過流程。備份回答「資料救不救得回來」,DR 還要回答「服務多久能恢復」。
📝 考場提點
讀 DR 題時,把「多久恢復」和「最多能失去多久的資料」分別標出來。「1 小時內恢復」對應 RTO;「最多遺失 15 分鐘資料」對應 RPO。接著再問故障範圍與資料價值:金流不一定要 Active-Active,分析資料也未必只靠便宜備份就夠,仍得看題目給的服務要求。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  S[災難情境敘述] --> T{描述多久要恢復服務?}
  T -- 是 --> RTO[記為 RTO<br/>災難後的停機上限]
  T -- 否 --> D{描述最多能丟<br/>多久的資料?}
  D -- 是 --> RPO[記為 RPO<br/>災難前的資料缺口]
  D -- 否 --> Q[回查業務衝擊與資料重要性]
  RTO --> A[決定待命容量與切換自動化]
  RPO --> B[決定備份頻率與複寫模式]
  Q --> RTO
Q --> RPO 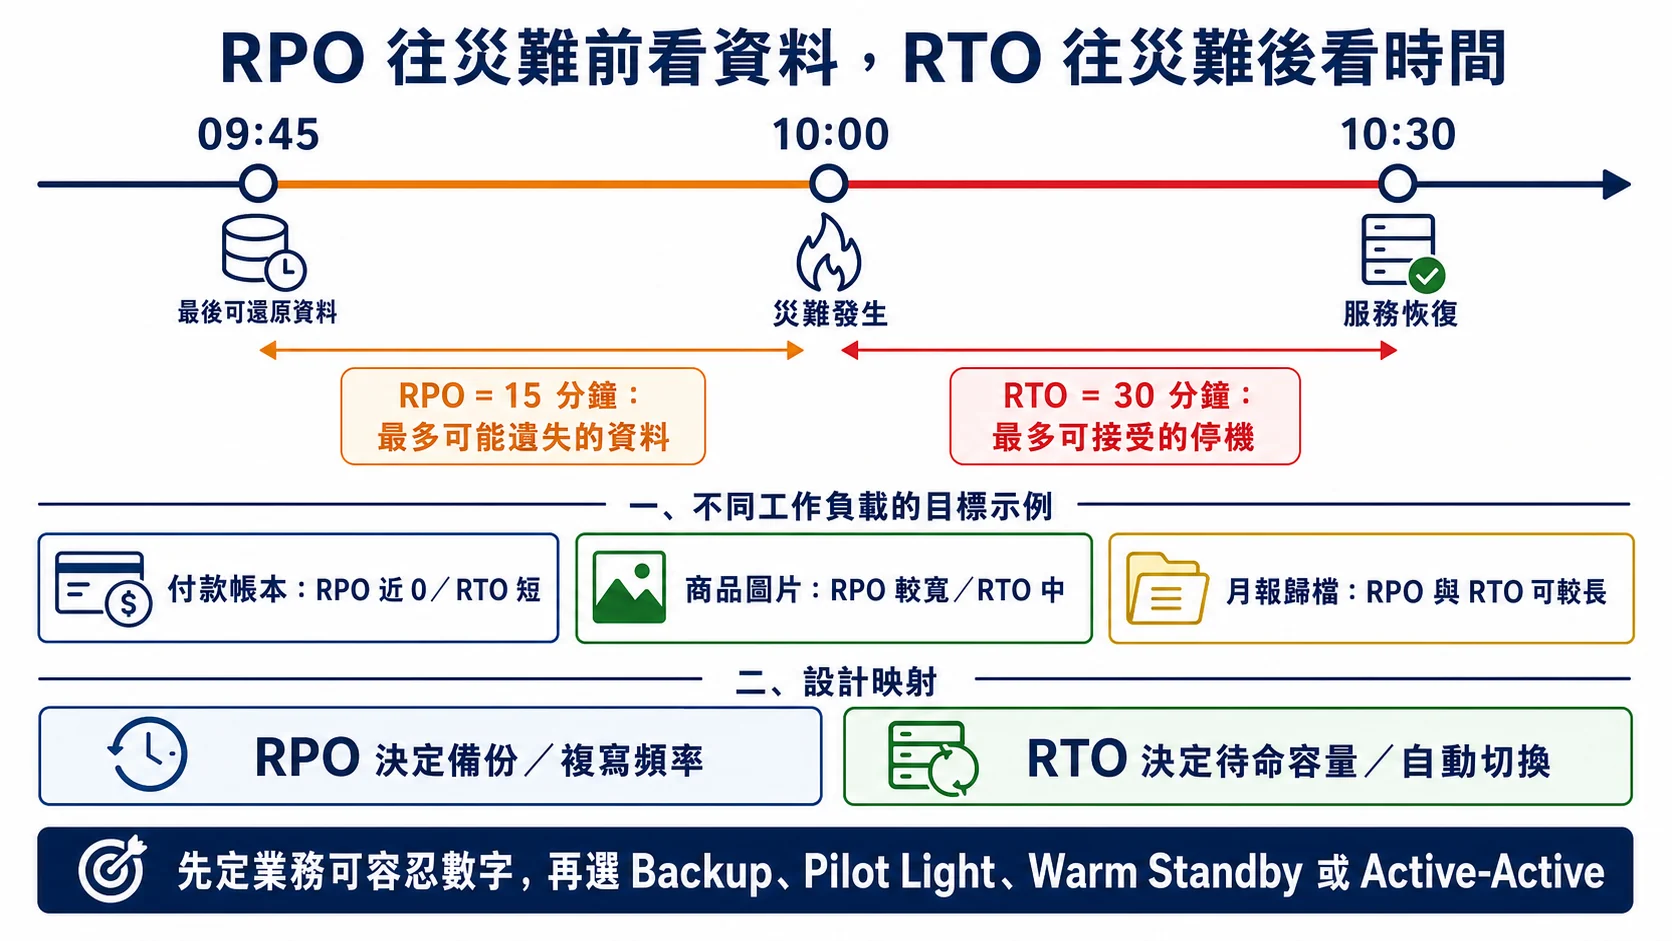
RPO 往災難發生前看,量的是最多可能遺失多久的資料;RTO 往災難後看,量的是服務最多能停多久。RPO 決定備份或複寫頻率,RTO 則影響待命容量與切換自動化程度,不同工作負載不該共用同一組數字。
四種 DR 策略,差在平時準備多少
四種常見策略的差別,不是貼上名稱後就有固定 RTO/RPO,而是平時保留多少資源、故障時還要完成哪些步驟:
| 策略 | 平時保留什麼 | 故障時還要做什麼 | 持續成本 |
|---|---|---|---|
| Backup & Restore | 備份、設定與復原程序 | 還原資料、部署並驗證服務 | 較低 |
| Pilot Light | 核心資料與最少必要基礎設施 | 擴大容量、啟動服務並切換流量 | 中低 |
| Warm Standby | 較小規模的可運行備援環境 | 擴容、確認資料狀態並切換流量 | 中高 |
| Multi-region Active-Active | 多個區域同時承接正式流量 | 隔離故障、重新分配流量並核對資料 | 較高 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
常駐資源和複寫越多,平時成本通常越高;只靠備份,則要把還原和驗證的時間算進去。每種策略能否達到指定 RTO/RPO,仍要看資料複寫方式並透過演練確認。
不是所有資料都需要 Active-Active。像可以重新產生的縮圖快取,可能不值得負擔跨區同步成本;交易紀錄則要依可容忍的資料遺失與停機時間設計。先替工作負載分級,再選對應的復原方式。
比較方案前,先把兩個指標分開:
- RTO(Recovery Time Objective):從災難發生到服務恢復的最長可容忍時間
- RPO(Recovery Point Objective):災難發生時最多可容忍遺失的資料時間窗
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  W[工作負載的 RTO/RPO] --> Z{接近零停機且<br/>零資料損失?}
  Z -- 是 --> A[Multi-region<br/>Active-Active]
  Z -- 否 --> M{必須在數分鐘恢復?}
  M -- 是 --> W1[Warm<br/>Standby]
  M -- 否 --> P{可接受數十分鐘<br/>且能自動放大?}
  P -- 是 --> L[Pilot Light]
  P -- 否 --> B[Backup & Restore]
  A --> C[估算常駐資源與複寫成本]
  W1 --> C
  L --> C
  B --> C
  C --> V{仍符合業務預算?}
  V -- 否 --> W
V -- 是 --> D[寫入 DR runbook] GCP 上你會用到哪些工具
策略選好了,落到 GCP 上就是這幾樣東西在撐:
- Cloud Storage 跨 region 複製——dual-region 或 multi-region bucket,物件自動跨地理位置存放。
- Cloud SQL cross-region read replica——使用非同步複寫,來源與副本之間可能有延遲。若 RPO 要更短,需另外評估資料架構與複寫語意。
- Spanner 多 region instance——同步複寫、全球單一邏輯資料庫,寫入經單一 leader region 協調,可做到跨 region 讀寫高可用。
- Cloud DNS failover routing policy——健康檢查掛了就自動把流量導去 DR region 的 LB。
- Persistent Disk snapshot 跨 region——multi-regional snapshot,VM 那一層的救命稻草。
Cloud SQL 的跨區 read replica 使用非同步複寫,來源與副本之間可能有延遲。因此不能只靠這個副本承諾 RPO = 0;若需求真的要求零資料遺失,還要另外評估能提供同步語意的資料架構,以及它對寫入延遲的影響。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  R[資料的 RPO 需求] --> Z{RPO 必須等於 0?}
  Z -- 是 --> S[同步跨 region 複寫<br/>例如 Spanner]
  Z -- 否 --> M{RPO 要壓到分鐘級?}
  M -- 是 --> A[非同步複寫+監控 lag<br/>或 Turbo Replication]
  M -- 否 --> B[定期備份/匯出]
  S --> L[承擔較高寫入延遲<br/>與成本]
  A --> V[持續驗證實際複寫延遲]
  B --> T[定期測試可還原性]
  L --> D[確認業務取捨]
  V --> D
T --> D 走一遍範例 — 登雲書店
登雲書店這種規模,最忌諱「整站一個 DR 等級」。書店裡的訂單金流跟首頁的商品縮圖,重要程度差了十萬八千里,DR 目標當然要分層。把系統拆開來看:
金流與訂單(極關鍵)
- 目標:RTO < 15 分鐘、RPO ≈ 0
- 策略:Multi-region Active-Active 或接近的方案
- 實作:RPO 要到 0,得用同步複寫的多區域資料庫,例如 Spanner 多 region 設定
asia1(讀寫區在東京與大阪、見證區在首爾);訂單服務部署在兩個 region,Global LB 自動路由 - 成本取捨:貴,但金流的錢一分都不能丟,這裡省不得
- 和前面選型的關係:第 8 步是在「目前只在台灣營運」的前提下,把訂單主檔放在 Cloud SQL。但 Cloud SQL 的跨區域副本是非同步複寫,區域故障時最近提交的交易可能遺失,RPO 做不到 0;金流若真的要求 RPO ≈ 0,這一層才需要換成 Spanner,費用要另外估,第 13 步的成本表也沒有算進去。
會員資料(關鍵)
- 目標:RTO < 1 小時、RPO < 5 分鐘
- 策略:Warm Standby
- 實作:Cloud SQL PostgreSQL HA 在
asia-east1,另加一個 cross-region read replica 在asia-northeast1。DR 啟動時 promote replica 成新 primary - 關鍵檢核:每季演練一次 failover,驗證 RTO 真的達標——別只在文件上寫達標
商品圖片與靜態資源
- 目標:RTO ≈ 0、RPO 15 分鐘(需啟用 turbo replication)
- 策略:dual-region Cloud Storage bucket
- 實作:bucket location 設為 configurable dual-region(asia-east1 彰化 + asia-southeast1 新加坡;兩個 region 必須屬於同一個 location code,
ASIA底下目前只有這一組可配,asia-northeast1 東京 + asia-northeast2 大阪則是預定義的asia1),並啟用 turbo replication 以取得 15 分鐘 RPO(設計目標,不是逐一物件的保證;SLA 以每月符合率計:複寫時間 ≥ 99.0%、複寫量 ≥ 99.9%);未啟用時預設複寫 RPO 為 12 小時(通常 1 小時內完成),自動雙向複寫
瀏覽紀錄(非關鍵)
- 目標:RTO < 24 小時、RPO < 4 小時
- 策略:Backup & Restore
- 實作:Bigtable 每 4 小時 export 到 GCS multi-region bucket。災難時重建 Bigtable cluster,從最近的 backup 匯入
- 理由:瀏覽紀錄掉幾小時不影響核心業務,不值得砸 active-active 的錢
流量切換機制
- Cloud DNS 設 failover routing policy,health check 探測主要入口(Global External Application LB 的 VIP;它是全域資源,不屬於單一 region),備援端點指向 DR region 的 regional external Application LB
- DR region 的備援入口(regional external Application LB)與後端平時只留最小配置,DR 時再手動或用 Terraform 把其餘容量布建起來——這就是 pilot light 的概念:平時只留最小骨架,需要時才放大
注意這幾層怎麼對應到前面那張表:金流是 Active-Active、會員是 Warm Standby、流量入口是 Pilot Light、瀏覽紀錄是 Backup & Restore,圖片則靠 dual-region bucket 的內建複寫。同一個案例裡好幾種策略並存,這才是真實架構長的樣子,也是設計 DR 時要練習分層的地方。
dual-region bucket 掛了一邊會怎樣
這個細節值得先弄清楚:「商品圖片的 dual-region bucket,如果 asia-east1 掛了,讀寫會怎樣?」
讀的部分會自動切到另一個 region 的副本,使用者大概無感。寫入也不需要手動切換:dual-region bucket 是單一 bucket,metadata 一律同步寫到多個 region,區域故障時服務不中斷。真正的風險在還沒完成非同步複寫的新物件,區域恢復前讀不到。
關鍵在於:dual-region 的複寫是非同步的。 所以 RTO 趨近於 0,因為已經複寫過去的資料在區域故障時還讀得到;但 RPO 沒辦法接近 0,因為區域一掛,那些還沒複寫完的資料在區域恢復前讀不到,實體毀損時還可能真的遺失。還沒複寫完的資料最多會累積多久,取決於你有沒有開 turbo replication:預設複寫的目標是 12 小時內全部完成(99.9% 的物件 1 小時內);開了 turbo 則是 15 分鐘的複寫目標(SLA 另訂符合率門檻,不是每個物件都保證 15 分鐘)。
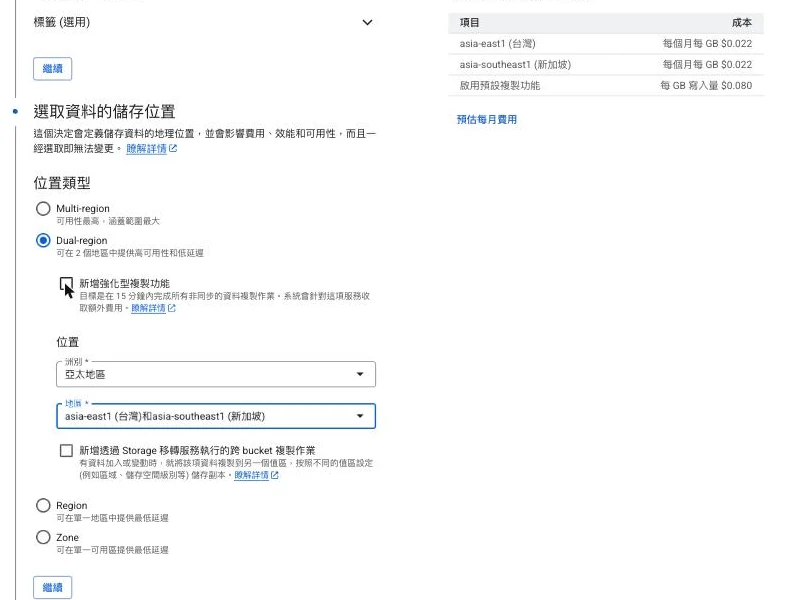
這一格就是把 DR 的 RPO 從口號變成數字的地方:預設的跨區複寫目標是 12 小時內完成,勾下「強化型複製(Turbo replication)」才把複寫目標縮到 15 分鐘——但複製費也跟著變貴:右邊列的 US$0.080 是還沒勾選時的預設複製費(每 GB 寫入量),依官方定價,亞洲 dual-region 啟用 Turbo 後是每 GiB US$0.11,所以這個勾不是每個 bucket 都值得打,只留給「頂多只能丟 15 分鐘」的資料。還有個容易忽略的細節:configurable dual-region 的兩個 region 必須屬於同一個 location code,這裡洲別選了亞太地區,地區選單列出的就是可以成對的組合(此圖是 asia-east1 台灣和 asia-southeast1 新加坡)——別以為隨便挑兩個 region 都能湊成一對。
如果題目要求非常短的 RPO,不能只看到 dual-region 就認定符合;要查複寫模式、目標時間與失敗時的資料損失範圍。案例裡金流與圖片採不同儲存方式,也是因為兩者可容忍的資料遺失不同。
📝 考場提點
Dual-region 與 multi-region bucket 會跨區非同步複寫,不能直接拿來承諾 RPO = 0。Cloud Storage 的預設複寫目標是 12 小時;dual-region bucket 可另外啟用 turbo replication,將目標縮到 15 分鐘,但仍不是零。物件能否讀取,也不等於整個應用已在 RTO 內恢復。資料庫則要另查其複寫和故障切換方式,例如 Cloud SQL 跨區 read replica 使用非同步複寫,不能單靠它保證已提交交易零遺失。(參考:Cloud Storage 資料可用性與耐久性、Cloud SQL 跨區複寫)
災難演練要檢查哪些事?
有些問題光看文件不容易發現,演練時可以特別檢查:
備份位置要對應你準備防的故障範圍。 如果主要系統和備份都只留在同一個 region,區域故障時可能一起無法使用。需要跨區復原時,應評估 dual-region、multi-region 或另一區的複本,並實際測試還原。
定期演練 DR 流程。 演練時確認備援區域的 IAM 權限、寫死的 endpoint、replica 提升步驟,以及 runbook 是否仍能照著執行。文件上寫的 RTO 要透過演練量測,才能知道是否真的做得到。
同步複寫會影響寫入路徑。 跨 region 確認通常需要更多網路往返;若應用對寫入延遲敏感,不能只看 RPO 改善,也要量測實際回應時間與吞吐量。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  P[DR 計畫與 Runbook] --> G[排定 Game Day]
  G --> F[模擬 region<br/>或關鍵依賴失效]
  F --> E[執行流量切換、<br/>資料提升與服務擴容]
  E --> M[量測實際 RTO、<br/>RPO 與資料完整性]
  M --> T{達到目標?}
  T -- 否 --> R[修正 IAM、endpoint、IaC<br/>與操作步驟]
  R --> P
T -- 是 --> U[更新證據與下次演練日期] 延伸閱讀
下一步:DR 把「整個 region 不見」也補上了,整套架構的可靠性骨架到這就齊了。最後一篇我們收尾,把安全與成本這兩條貫穿全程的主線一次講透。
系列導航
- 系列首頁:PCA 雲端架構師之旅
- 上一篇:PCA 雲端架構師之旅 11 — 可靠性與擴展性
- 下一篇:PCA 雲端架構師之旅 13 — 安全與成本
🎯 換你練習
理論讀完,換自己來。到 架構師設計工作坊 · 步驟 12 填入你的 case study,邊寫邊內化。
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
PCA 雲端架構師之旅 13 — 安全與成本
架構圖畫好了,權限與帳單也要交代清楚。從 IAM、網路邊界到主要服務費用,檢查方案能否落地。
PCA 雲端架構師之旅 10 — 網路拓樸
把 Region、Zone、VPC、Subnet、DNS 和負載平衡器畫在同一張圖上,檢查請求到底怎麼走。