PCA 雲端架構師之旅 07 — 儲存特性分析
「這份資料要放 Cloud SQL、Spanner,還是 Firestore?」選服務前,先把要存的資料和讀寫方式說清楚。同樣是大量資料,線上訂單與分析事件也可能需要不同的系統。
這篇先整理資料形狀、規模、讀寫比例、一致性與延遲需求,暫時不決定產品。下一篇再把這份需求表對到 GCP 服務。
這是 PCA 雲端架構師之旅 的第七步。上一篇 06 · REST API 設計。
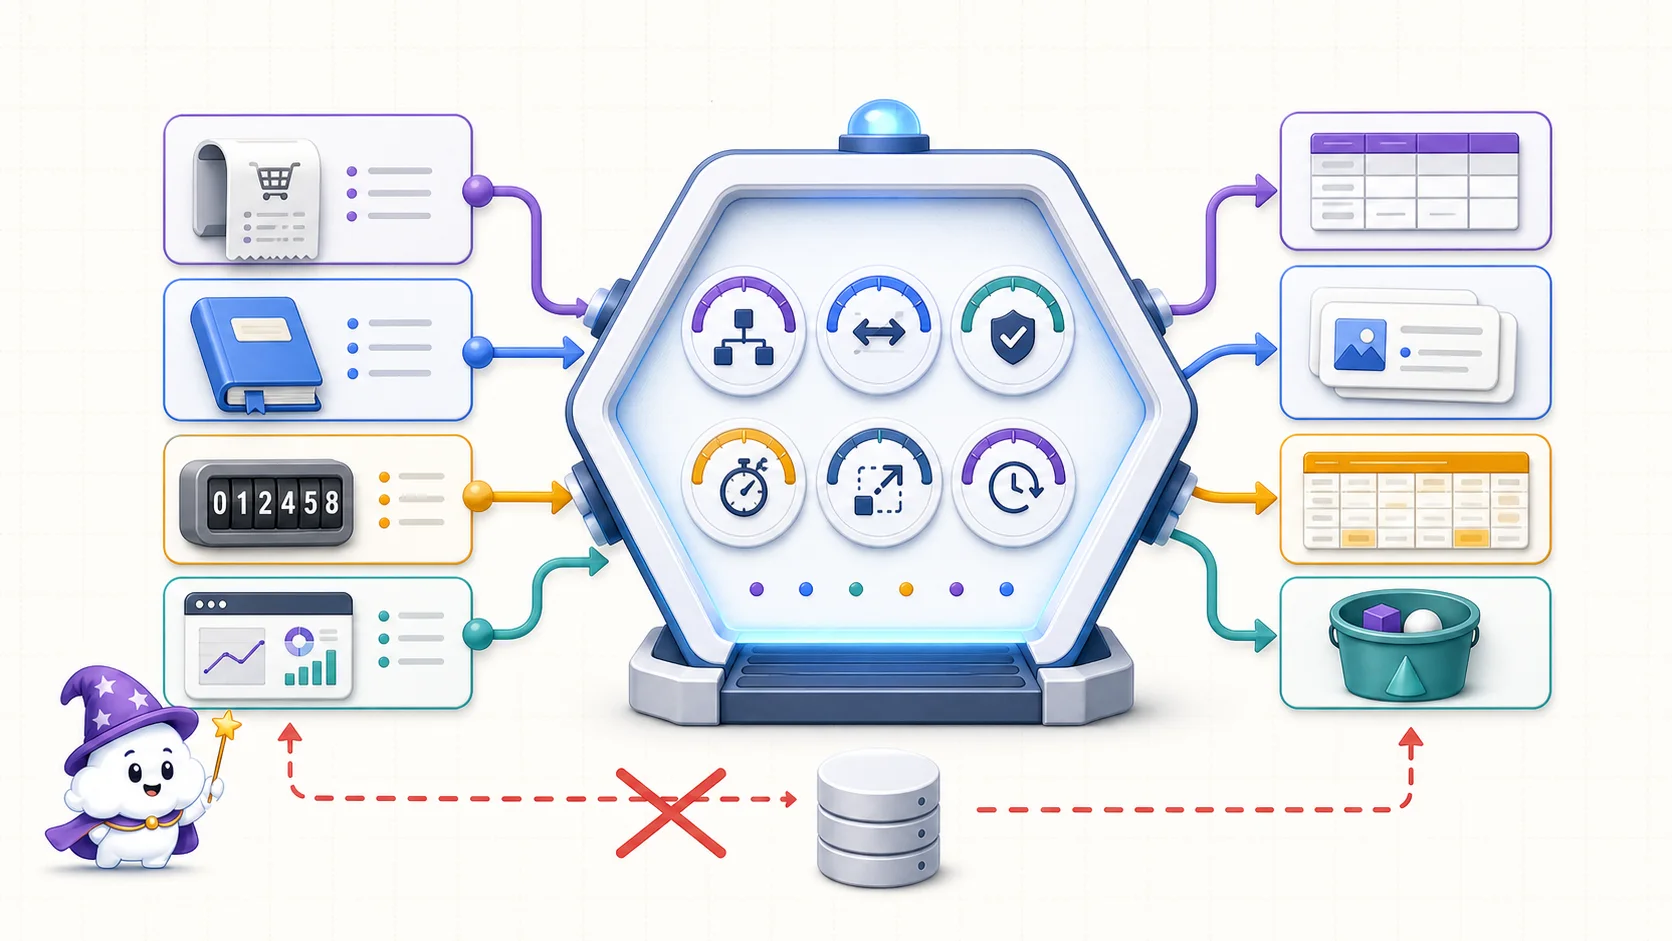
圖解:訂單、檔案、即時庫存與分析事件的脾氣不同。先檢查結構、讀寫模式、一致性、延遲、規模與生命週期,才會自然分流到關聯式、文件、寬欄或物件儲存;跳過這一步,常會把所有資料硬塞進同一個資料庫。
為什麼要先分析、後選型
白板上先寫「流量會爆,所以用 Spanner」,看似做了決定,其實還缺了關鍵資訊:是哪一種流量?資料怎麼查?要不要跨區域交易?需求未定,產品名稱只能算猜測。
例如把訂單交易和大量報表查詢都壓在同一台資料庫上,資料量增加後,分析工作可能擠掉線上交易需要的資源。問題未必是資料庫產品不夠好,而是兩種工作負載沒有分開評估。
把資料先分清楚,並不是為了把表格填漂亮。訂單、圖片和點擊紀錄的讀寫方式不同;如果一開始就把它們當成同一種工作負載,後面才會發現查詢互相搶資源。
PCA 目前公布的四份 case study 多半只用文字描述規模(例如 Cymbal Retail 提到商品目錄龐大、預期成長),不會直接列出資料量、成長率或保留年限的數字。若題目另外給了「訂單每年 2000 萬筆、保留 7 年、需要跨區強一致」或「點擊紀錄每日 5 億筆」這類條件,先把它們記下來。它們會影響資料庫類型、容量估算和成本,不能只當背景數字。
📝 考場提點
遇到資料量、保留年限和一致性要求,先問它們是硬性限制,還是仍有設計空間。例如每日 5 億筆要估尖峰寫入與保存成本;「跨區強一致」要確認是交易讀寫都需要,還是只要求跨區容錯;很少查的舊資料則可以評估分層保存。這樣比只靠一個關鍵字猜服務可靠。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  D[一類資料] --> S[結構與單筆大小]
  S --> V[總量、成長率與保留期]
  V --> W[讀寫比例與尖峰]
  W --> C[一致性與延遲]
  C --> Q[查詢模式]
  Q --> P[敏感度與駐留要求]
  P --> R[形成儲存需求輪廓]
  R --> X[下一步才做服務選型]
該從哪幾個角度看一筆資料
選儲存服務前,先描述資料長什麼樣、會怎麼讀寫,再看哪些限制會影響選型:
| 維度 | 你要問自己的問題 |
|---|---|
| 結構(Structure) | 結構化、半結構化、非結構化? |
| 規模(Size) | 單筆多大?總量多少?成長率? |
| 讀寫比(R/W Ratio) | 讀多寫少?寫多讀少? |
| 一致性(Consistency) | 強一致還是最終一致? |
| 延遲(Latency) | 毫秒級?秒級?分鐘級? |
| 查詢模式(Access Pattern) | 點查?範圍查?全文檢索?聚合? |
| 生命週期(Lifecycle) | 熱、溫、冷、歸檔的時程? |
| 敏感度(Sensitivity) | PII、PCI、PHI 合規要求? |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
這八個條件裡,讀寫比和保存期限特別容易漏掉。同樣是訂單資料,主要寫入和大量讀取需要處理的瓶頸不同;保留七年與保留七天,也會改變儲存與備份成本。先把這兩欄問清楚,別只用「關聯式資料」四個字完成分類。
先用一張表認識可能用到的 GCP 服務。現在不用急著選,只要知道各自擅長處理哪類需求:
| 服務 | 定位 | 關鍵字 |
|---|---|---|
| Cloud SQL | 中小型關聯式 | MySQL/PostgreSQL/SQL Server、zonal/regional HA |
| AlloyDB | 高效能 PostgreSQL | 高 OLTP + 分析工作負載 |
| Spanner | 全球強一致關聯式 | multi-region、horizontal scale、SQL |
| Firestore | 文件資料庫 | 行動/Web、即時同步、自動擴展 |
| Bigtable | 寬欄 NoSQL | 超大量時間序列、IoT、低毫秒延遲 |
| BigQuery | 分析型資料倉儲 | PB 級 OLAP、columnar、SQL |
| Memorystore | 記憶體快取 | Valkey/Redis、毫秒以下 |
| Cloud Storage | 物件儲存 | 大檔案、備份、靜態資產 |
| Filestore | 網路檔案系統 | NFS、legacy lift-and-shift |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
接著分清楚工作負載。OLTP(線上交易處理,Online Transactional Processing)常處理逐筆讀寫與交易,下單是典型例子;OLAP(線上分析處理,Online Analytical Processing)則會掃描大量資料並做聚合,例如每月銷售報表。兩種查詢可以來自同一批原始資料,卻不一定適合共用同一套即時處理資源。若報表查詢會影響結帳,就要評估讀副本、匯出或獨立分析系統。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  R[資料需求] --> U{主要服務線上交易?}
  U -- 是 --> T[OLTP<br/>單筆讀寫、低延遲、<br/>交易一致性]
  U -- 否 --> A[OLAP<br/>大範圍掃描、<br/>聚合、秒級查詢]
  T --> S[交易主儲存]
  S --> E[透過 CDC/<br/>事件複製必要資料]
  E --> W[分析讀模型]
  A --> W
  W --> Q[報表與趨勢查詢]
Q -. 不直接回打 .-> S 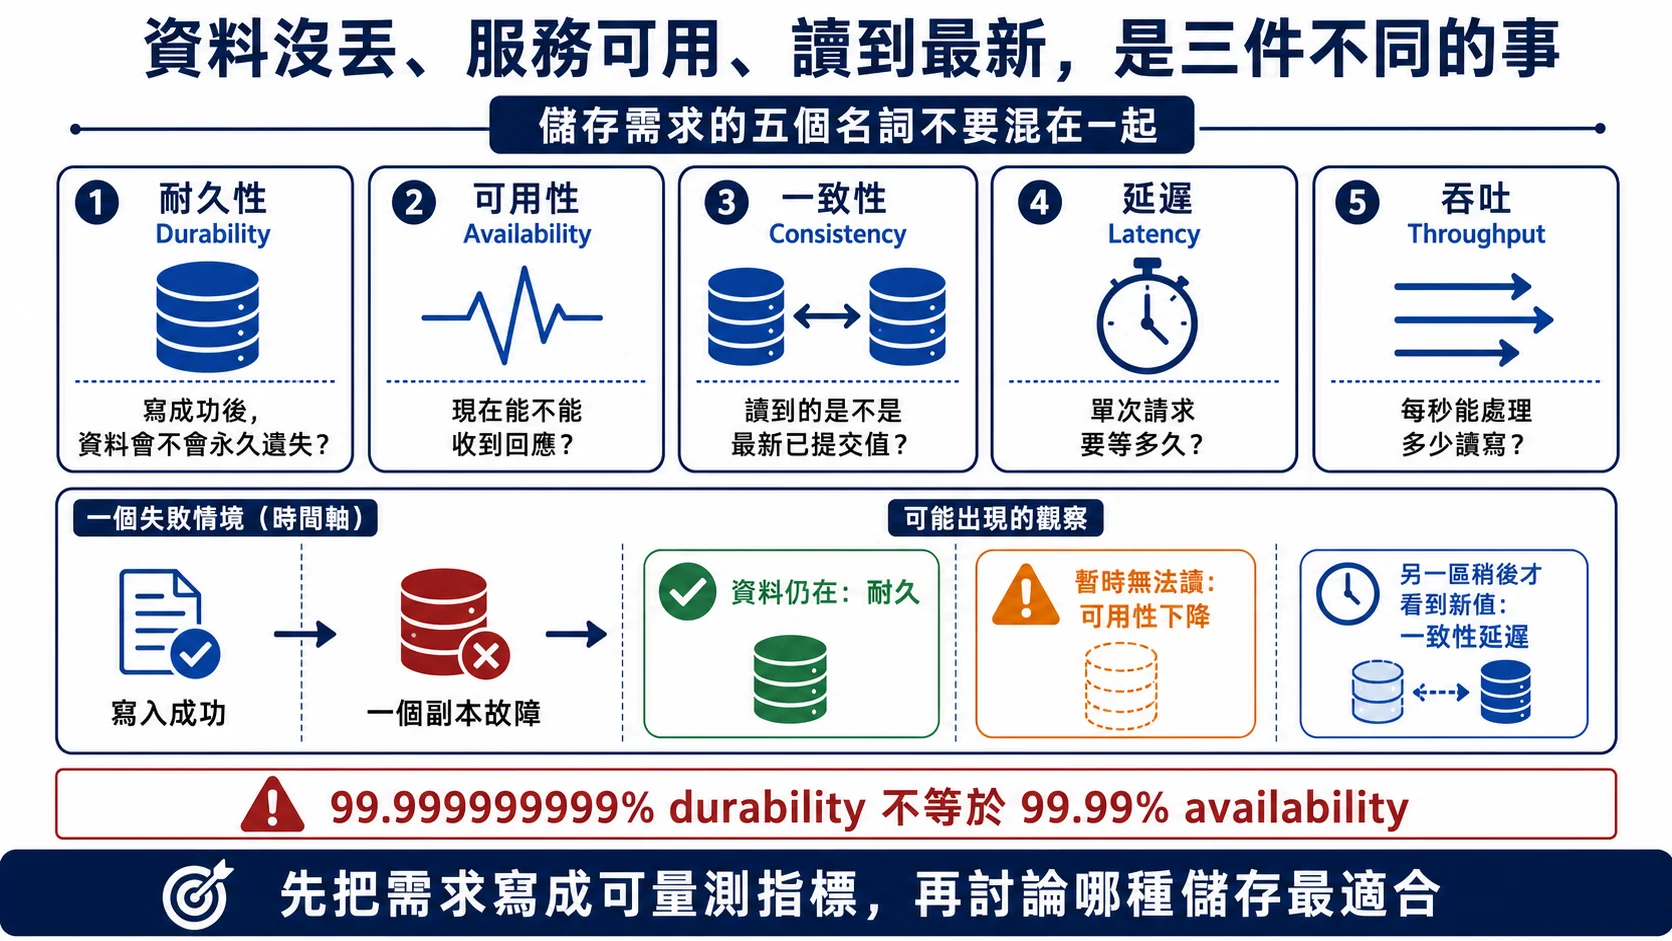
資料沒丟、服務現在能回應,以及讀者看到最新值,是三件不同的事。耐久性、可用性、一致性、單次延遲與每秒吞吐都要分別量化;例如極高耐久性不代表服務一定有同等可用性。
盤點資料時,先問哪些問題?
上面的維度很多,不必逐欄填完才開始思考。可以先問幾個會改變方向的問題,再把其餘欄位補齊:
這份資料主要用來處理交易,還是做分析?兩者對寫入、查詢和延遲的要求常常不同。接著確認哪些操作需要強一致,以及故障時要能容忍多大範圍的中斷;「跨區容錯」不等於每筆交易都得跨區同步。再看查詢是按 key 取單筆、掃描一段範圍,還是全文搜尋,因為這會影響資料模型與索引。最後補上保留期限、資料駐留、存取控制等要求。若涉及法遵,先查清楚具體義務,再決定是否需要 CMEK 或 VPC Service Controls 等額外控制。
這些問題不會直接給出唯一產品,但能讓後面的比較有依據。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  D[拿到一筆資料] --> T{交易還是分析?}
  T -- 分析 --> A[記錄掃描、<br/>聚合與新鮮度]
  T -- 交易 --> G{需要跨 region 強一致?}
  G -- 是 --> C[標記全球一致性需求]
  G -- 否 --> Q{點查、範圍查<br/>還是全文檢索?}
  Q --> K[記錄 access<br/>pattern 與 key]
  A --> L[熱資料多久變冷?]
  C --> L
  K --> L
L --> S[最後套用合規與成本限制] 走一遍範例 — 登雲書店
回到我們的老朋友。登雲書店上雲,到底有哪些資料要存?我把主要的幾類拉出來做特性分析。注意,下面這張表只到「結論」為止——還是不選服務,那是下一篇的事。先忍住手。
資料特性表
| 資料 | 結構 | 規模/成長 | 讀寫比 | 一致性 | 延遲要求 | 查詢模式 | 生命週期 | 敏感度 |
|---|---|---|---|---|---|---|---|---|
| 商品目錄 | 結構化 | 120 萬 SKU、年增 20% | 1000:1 | 最終一致可接受 | P95 < 50ms | 點查 + 關鍵字 + 分類 | 長期 | 低 |
| 商品全文索引 | 半結構化 | 同上 | 10000:1 | 最終一致 | P95 < 100ms | 全文、fuzzy | 可重建 | 低 |
| 庫存數量 | 結構化 | 120 萬列、少量更新 | 50:1 | 強一致(避免超賣) | P99 < 100ms | 點查 | 長期 | 中 |
| 購物車 | 半結構化 | 同時 5 萬台裝置 | 5:1 | 單裝置強一致即可 | P95 < 50ms | by userId | 30 天自動過期 | 中(PII) |
| 訂單 | 結構化 | 每年 600 萬筆、保留 7 年 | 2:1 | 強一致 + 跨區容錯 | P95 < 200ms | 點查 + 多條件 | 熱 90 天 / 溫 1 年 / 冷 7 年 | 高(PII) |
| 金流明細 | 結構化 | 每筆訂單 1–3 列 | 1:1 | 強一致 + 可稽核 | P95 < 300ms | 點查、範圍 | 永久、WORM | 高(PCI) |
| 閱讀進度 | 半結構化 | 每會員 × 每本書一筆 | 20:1 | 最後寫入優先 | P95 < 100ms | 點查(userId + bookId) | 熱到下次使用 | 中(PII) |
| 點擊與瀏覽紀錄 | 半結構化 | 每日 5 億筆、保留 18 個月 | 寫多(分析讀) | 最終一致 | 寫入 < 10ms、分析秒級 | 時間範圍、聚合 | 自動生命週期過渡 | 中(去識別) |
| 分析型事實表 | 結構化 | 每日 +100 GB、保留 3 年 | 讀多(D+1) | 最終一致 | 查詢秒級 | 大規模聚合 | 分割 + 壓縮 | 中 |
| 商品圖片 | 非結構化 | 單張 500KB、全量 5 TB | 極讀多 | 最終一致 | CDN 命中 < 50ms | by objectKey | 長期 + CDN | 低 |
| 批次匯入檔 | 非結構化 | 單檔最大 200MB | 一次性 | — | 分鐘級 | by jobId | 30 天保留稽核 | 中(商業敏感) |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
表格填完後,差異就比較清楚了。挑幾類資料來看:
訂單和金流明細都需要一致性與稽核能力,還要釐清跨區容錯的目標。庫存也要求一致性,但規模和查詢方式不同,不該只因為兩者都寫著「強一致」,就假設它們得用同一種方案。
點擊紀錄的寫入量高,主要供後續分析;除了寫入尖峰,也要估查詢頻率和保留成本。商品目錄讀取多、更新少,可以評估快取與搜尋索引是否要分開。商品圖片是大型非結構化檔案,則要另外考慮物件儲存、傳輸和快取。這裡先描述需求,下一篇再比較產品。
金流資料還要先確認是否包含持卡人資料,以及哪些系統因此落入 PCI DSS 範圍。隔離專案、CMEK、VPC Service Controls 都可能是設計選項,但不能把它們當成每個 PCI 系統一律必備的固定組合。此時先標出資料流、存取對象與稽核需求,後面設計安全邊界才有根據。(參考:Google Cloud 的 PCI DSS 架構指引)
順手把生命週期也分好層
訂單保留 7 年、點擊紀錄保留 18 個月,圖片則可能長期使用。保留期限不代表每一筆資料都要一直放在高頻存取的系統裡。可以先按存取方式列出可能的分層方向,再確認查詢需求與保存規定:
| 階段 | 訂單 | 點擊紀錄 | 圖片 |
|---|---|---|---|
| 熱 | 交易系統保留常查的訂單 | 供近期分析的資料 | 常看的圖片,搭配快取 |
| 溫 | 舊訂單依查詢需求保留或匯出 | 匯出較少查詢的原始事件 | 降低存取頻率後評估儲存級別 |
| 冷 | 以可查詢或可還原形式長期保存 | 依保留規定保存較舊原始資料 | 只需偶爾取回的圖片 |
| 到期 | 依政策刪除或去識別化 | 依政策刪除 | 依用途決定刪除或繼續保存 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
這張表還不是 Cloud Storage 的級別設定。訂單與點擊資料可能先存於資料庫或分析系統,只有匯出成物件後才需要比較 Standard、Nearline 等級。先決定資料何時轉換、多久會再讀,以及到期後怎麼處理,才不會把儲存級別和資料生命週期混為一談。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart LR
  N[資料建立] --> H[熱:頻繁存取]
  H -->|存取下降| W[溫:偶爾查詢]
  W -->|很少讀取| C[冷:長期保留]
  C -->|只為合規| A[歸檔]
  W -. 存取重新升高 .-> H
  C -. 查詢變頻繁 .-> W
  H -->|到期| D[安全刪除]
  W -->|到期| D
  C -->|到期| D
  A -->|法定期限結束| D
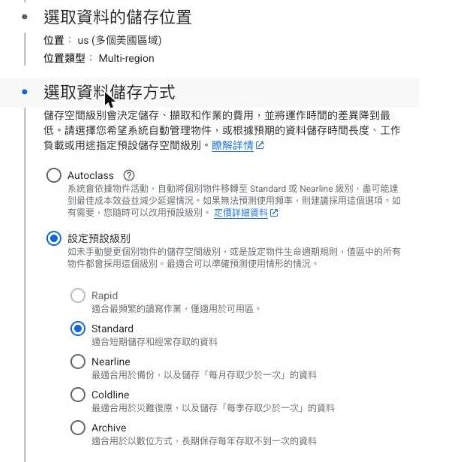
匯出到 Cloud Storage 的資料,可以再用這個選單挑儲存級別。Nearline/Coldline/Archive 分別有 30/90/365 天的最短儲存時間;如果太早刪除或轉出,仍可能產生提前刪除費用。因此要用實際存取頻率和保留時間試算,不是越快轉成 Archive 就越便宜。Autoclass 也能自動調整物件級別,但同樣要看它的計費方式是否符合這批資料。
走到這裡,還不用決定訂單要放哪個產品;先把哪些資料必須即時可用、哪些可以延後查詢、哪些到期要刪除說清楚。下一篇再把這些要求拿來比較服務。
選型前再檢查幾件事
第一個問題是把交易、分析和全文搜尋都塞進同一套資料庫。開始時也許方便,但負載一大,分析查詢可能拖慢交易,搜尋需求也會逼出不適合原本資料模型的索引。先分清工作負載,才知道哪些可以共用、哪些該拆開。
第二個是只估每天的寫入量,沒算保留期間的總量。「每日 5 億筆」保留 18 個月,粗估就有約 2700 億筆;還得再算每筆大小、索引、副本和查詢成本。光看單日流量,很容易低估幾年後的儲存需求。
第三個是忽略索引與查詢成本。Firestore Standard edition 預設會自動為每個欄位建立索引(Enterprise edition 預設不建立任何索引),不必要的索引會增加儲存成本,也可能拖慢寫入;Bigtable 則主要靠 row key 支援有效查詢。選型前先列出真正要查的欄位與範圍,否則上線後才調資料模型會很費工。
最後是把合規簡化成「資料有加密就好」。如果系統處理持卡人資料,還需要釐清適用範圍、存取權限、稽核紀錄與資料流。具體控制應按要求設計,不是把所有安全產品打開就算完成。
📝 考場提點
遇到合規題,先找出題目明確要求的資料類型、存取範圍、保留期限與稽核條件,再檢查候選服務是否在適用範圍內。不能只憑「用了 BigQuery」或「用了 CMEK」就判定合規與否;服務是否受認證,以及整套應用如何設定與操作,都要一起看。(參考:Google Cloud PCI DSS 服務範圍)
延伸閱讀
- Database resources(Architecture Center) — 官方資料庫主題文件索引。
- What is a relational database? — 官方入門頁面,說明關聯式資料庫的概念,文末列出 Cloud SQL、Spanner、AlloyDB。
- Bigtable schema design guidance — row key、column family 設計指南。
- Design an optimal storage strategy for your cloud workload — 儲存選擇官方指南。
資料特性整理好了,下一篇 儲存與資料庫選型 會用這些條件比較 GCP 服務。
🎯 換你練習
到 架構師設計工作坊 · 步驟 7 挑一類資料,寫下它的讀寫方式、保留期限,以及最難妥協的一項要求。
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
PCA 雲端架構師之旅 13 — 安全與成本
架構圖畫好了,權限與帳單也要交代清楚。從 IAM、網路邊界到主要服務費用,檢查方案能否落地。
PCA 雲端架構師之旅 12 — 災難復原 (DR)
整個區域無法使用時,多久要恢復、最多能丟多久的資料?用 RTO/RPO 比較幾種災難復原做法。