
GCP 資料與 AI 服務怎麼接?從資料進來到模型回答
假設網站每秒都有人下單,團隊想做即時銷售報表,還想讓客服機器人回答商品問題。Pub/Sub、Dataflow、BigQuery、Gemini Enterprise Agent Platform(簡稱 Agent Platform,原 Vertex AI)看起來都跟「資料」有關,卻不能直接排成一條每個專案都必備的流水線。
我會先問:資料是事件還是檔案?要原樣存起來,還是先清理、彙總?最後是給人查報表,還是讓模型回答問題?這三個問題比背產品名稱好用。
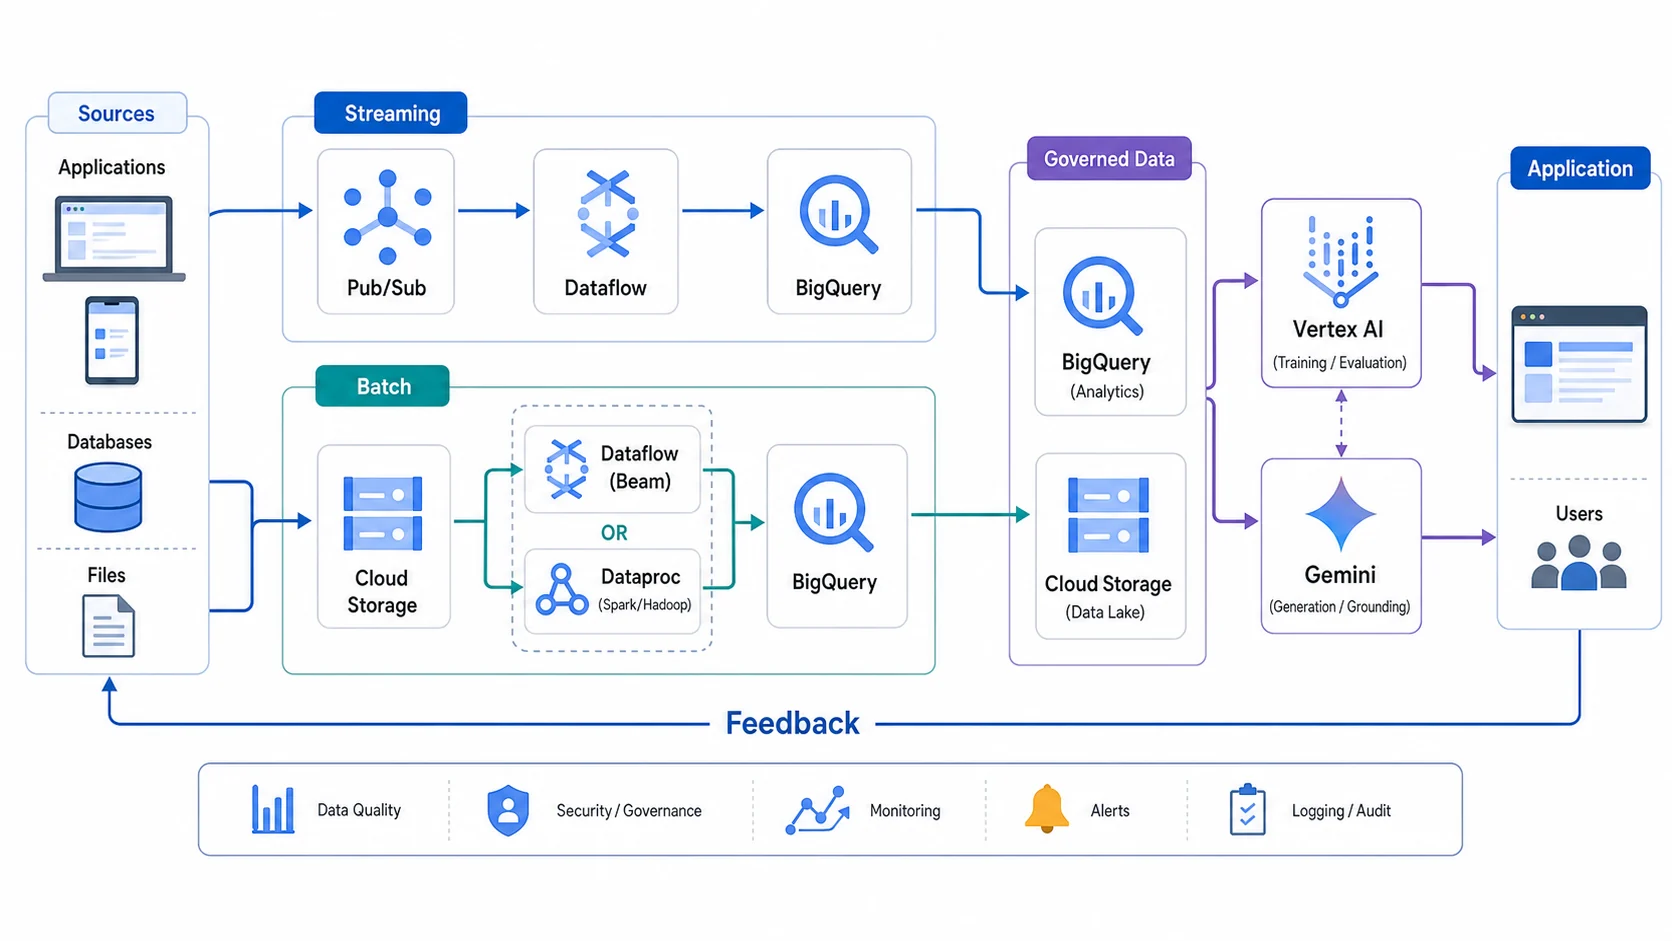
這張圖是可能的路徑,不是採購清單。事件若只要原樣寫進 BigQuery,可以跳過 Dataflow;批次作業也不一定要先進 Pub/Sub。圖中批次路徑上的 Managed Service for Apache Spark(原 Dataproc)印的還是舊名。
先把五個角色放對位置
| 你要做的事 | 先看哪個服務 | 它不會替你做什麼 |
|---|---|---|
| 把事件送給一個或多個消費者 | Pub/Sub | 不會自動替你清理、彙總事件 |
| 用 Apache Beam 清理批次或串流資料 | Dataflow | 不會替你決定資料品質規則 |
| 沿用 Spark/Hadoop 程式 | Managed Service for Apache Spark(原 Dataproc) | 不會讓現有程式免測試就能搬上雲 |
| 用 SQL 分析大量資料 | BigQuery | 不是低延遲、逐筆更新的交易資料庫 |
| 訓練模型或呼叫生成式模型 | Agent Platform(原 Vertex AI)/Gemini API | 不會自動把不可靠的資料變成可信答案 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
這些服務也不是互斥的。Pub/Sub 把事件送進來,Dataflow 整理資料,BigQuery 接住分析結果,完全合理;但如果中間沒有轉換需求,就不必為了「架構完整」硬加一個 Dataflow 工作。
Pub/Sub:先把事件交出去
以訂單成立為例,訂單服務發布一筆 order-created 事件。庫存、物流、分析系統各有自己的 subscription:物流暫時故障,不必要求訂單服務重新呼叫所有下游。發布者知道 topic 就好,不用知道現在有幾個消費者。
但「送出一次」不等於「下游只執行一次」。Pub/Sub 訂閱預設是至少一次傳遞,訊息可能重送;扣庫存、開發票這類操作應以訂單 ID 做冪等處理。特定 pull subscription 可以啟用 exactly-once delivery,但那是有條件的傳遞保證,不代表整套業務流程從此不會重複寫入。官方說明也列出訂閱類型與區域限制。
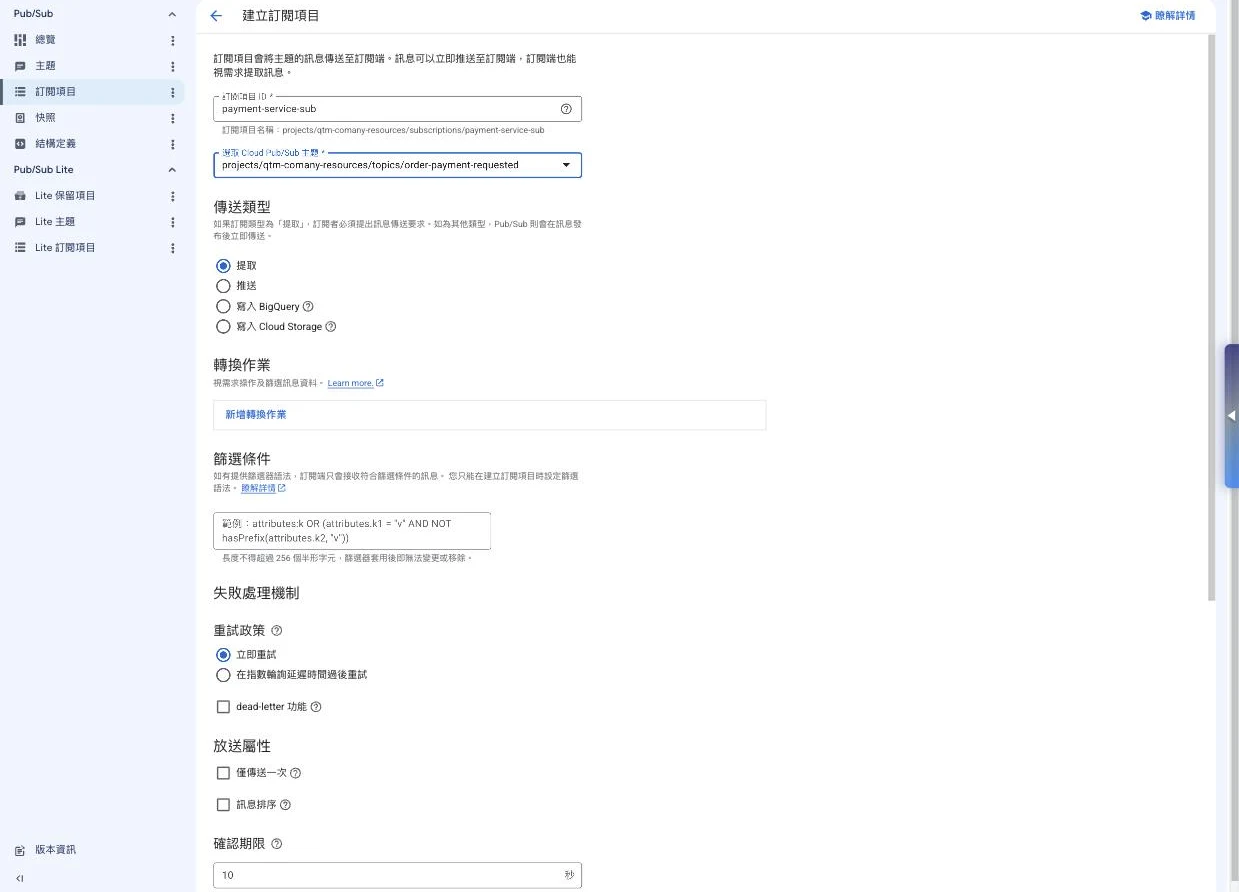
訂閱各自設定傳遞、重試和死信處理。畫面可能隨 Console 更新;記住「同一個 topic 可以接多個獨立訂閱」就好。
如果只是把事件欄位寫進 BigQuery,先評估 BigQuery subscription。它能直接匯出訊息,省下一條 Dataflow 管線;若要跨事件做時間視窗、清理或關聯,再考慮 Dataflow。直接匯出的路徑仍可能有重複資料,報表應有去重策略。訂閱類型、重試與死信怎麼設,ACE-209:Cloud Pub/Sub 入門有完整說明。
Dataflow 與 Managed Service for Apache Spark(原 Dataproc):選的是處理方式
Dataflow 執行 Apache Beam 管線,可以處理批次和串流。例如網站持續送出點擊事件,想算「每分鐘各頁面瀏覽次數」,Beam 的時間視窗可以把無止盡的事件分段計算,也能定義遲到事件如何影響結果。你寫資料怎麼讀、怎麼轉換、寫去哪裡;Dataflow 管理執行作業所需的 workers。串流工作會持續執行,不能把「全託管」誤會成「沒有持續費用」。
另一條路線的重點是 Spark/Hadoop 生態系。這個產品現在的正式名稱是 Managed Service for Apache Spark;舊教材和題庫寫的 Dataproc on Compute Engine、Serverless for Apache Spark,分別是它的叢集部署與 serverless 部署。團隊若已有 PySpark 作業,每天從 Cloud Storage 讀銷售檔、清理後寫回 BigQuery,沿用現有程式通常比為了換平台重寫 Beam 更有理由。需要控制叢集環境時可評估叢集部署;只想提交 Spark 工作、不想管理叢集,還有 serverless 部署。所以「跑 Spark 一定要長開叢集」也不是正確的選型口訣。
簡單記法:已有 Spark 程式,先查 Spark 路線;需要用 Beam 寫串流或批次管線,先查 Dataflow。 再比較延遲、資料來源、團隊熟悉度和實際費用。Pub/Sub 只負責把事件交給消費者,不能拿來代替這兩種處理工作。兩條路線的細部比較在 ACE-214:Dataflow 與 Managed Service for Apache Spark(原 Dataproc)怎麼選?。
BigQuery:資料進得去,查詢也要寫得好
BigQuery 適合用 SQL 分析大量資料。對 ACE 題目來說,比「能查幾十億筆」更重要的是:表怎麼分區、查詢掃了哪些欄位、這次會處理多少資料。以下假設 sales 表已依 order_date 這個 DATE 欄位分區,並依 customer_id 聚類:
SELECT customer_id, SUM(amount) AS total_amount
FROM `project.analytics.sales`
WHERE order_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY)
GROUP BY customer_id
ORDER BY total_amount DESC
LIMIT 10;
日期條件讓 BigQuery 有機會只讀近期分區;只選需要的欄位,也能減少按掃描量計費時的資料量。聚類欄位若出現在篩選條件中,還可能少掃部分資料區塊。分區裁剪和計價規則都有條件,不能保證「加了分區就省 99%」。而且 LIMIT 10 只是限制輸出列數,不會自動限制讀取量。
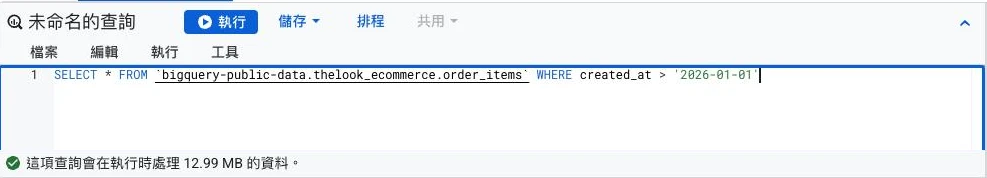
改查詢前後都看一次預估處理量,比猜「應該會比較快」可靠。也可用 dry run 驗證查詢並估算處理位元組;容量計價與外部資料來源仍要按各自規則判讀。
如果資料還留在 Cloud Storage,可以先評估外部表,不一定要先載入。反過來說,分析查詢需要穩定效能或頻繁存取時,也要比較直接載入 BigQuery 是否更合適。選項不是「能查就一定該查」。分區與叢集怎麼設計,接著讀 ACE-211:BigQuery 查詢與成本。
Agent Platform(原 Vertex AI)與 Gemini:先問要訓練,還是要使用模型
「我們想導入 AI」範圍太大。客服問答通常先試現成生成式模型與檢索資料;有標註好的車損照片、想做分類,才開始比較 AutoML 或自訂訓練。
先把名稱對齊:Google 在 2026 年 4 月把 Vertex AI 改名為 Gemini Enterprise Agent Platform,AutoML、訓練和 Gemini API 都改掛在新名字底下,官方對照表列出每一項的新舊名稱。舊教材、題庫和部分文件仍寫 Vertex AI,看到時先對回同一項功能。至於 ACE 現行考綱,實際點名的是 Agent Runtime(原 Vertex AI Agent Engine)和 Agent Platform Workbench(原 Vertex AI Workbench)這兩項。
| 需求 | 起點 | 真正要驗收的事 |
|---|---|---|
| 摘要文件、回答問題 | 透過 Gemini API 使用現成模型 | 答案是否有根據、延遲、費用、敏感資料處理 |
| 用標註資料做常見分類/預測任務 | Agent Platform 的 AutoML | 測試資料上的誤判、漏判與訓練成本 |
| 需要自行控制模型架構與訓練程式 | Agent Platform 的自訂訓練(Managed Training) | 程式、運算資源和後續部署維護 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
例如車損分類,模型說「受損」時有多少真的受損,是 precision;所有真正受損的照片中抓到多少,是 recall。若漏判代價很高,就不能只報一個「準確率 95%」當作上線理由。AutoML 影像分類流程也需要先準備資料、訓練、評估,並非按一下就保證得到可用模型。
呼叫 Gemini 時,Google 提供 Gemini Developer API 和 Agent Platform 上的 Gemini API。Google Gen AI SDK可連接兩者,但不代表兩邊的認證、配額、區域、資料治理與費用完全一樣。也別把它硬分成「開發一定用前者、正式環境一定用後者」;選擇取決於組織需要的 Google Cloud 整合和治理條件。
下面是 Agent Platform 路線的最小呼叫範例。先依官方快速入門啟用 API、設定專案與 Application Default Credentials,再把 MODEL_ID 換成該專案與區域可用的模型:
from google import genai

client = genai.Client(vertexai=True, project='PROJECT_ID', location='global')
response = client.models.generate_content(
    model='MODEL_ID',
    contents='請用三句話摘要這份客服政策。',
)
print(response.text)
參數名 vertexai 是改名前沿用下來的舊旗標,目前仍可用;新版 SDK 也接受 enterprise=True。
程式能回字,不代表答案就能直接交給客戶。文件可能過期、模型可能補出不存在的退款條件。正式應用還需要指定資料來源、檢查引用或依據、記錄錯誤案例,並讓高風險問題能轉人工。
把它串起來:客服問答與營運報表
假設使用者在網站問「商品可以退貨嗎?」API 收到問題後,先從目前有效的退貨政策找相關段落,再把問題和段落交給模型組織答案。這是同步回覆路徑:使用者在等,不能把報表整理也塞進同一個請求裡。
回答後,API 可另外發布一筆事件,例如時間、問題類別、是否找到依據、是否轉人工。這是非同步分析路徑:事件進 Pub/Sub;若欄位已合適,BigQuery subscription 可直接寫入 BigQuery;若要清理欄位、去識別或做每分鐘聚合,再用 Dataflow。最後用 SQL 查常見問題和未解決比例,提供團隊改善文件,而不只是畫一張漂亮儀表板。
這個例子還有幾件事不能省:
- 不要把完整對話、個資和模型回答無條件丟進分析事件。先決定哪些欄位真有必要、保存多久、誰能讀。
- 為每筆事件準備可追蹤的 ID,讓重送後能辨識重複資料;回答失敗時也要知道事件是否已記錄。
- 檢索不到可靠依據時,讓機器人說不知道或轉人工,比編一個退貨天數安全。
- 成本要分別估模型呼叫、檢索、持續運作的處理工作、BigQuery 儲存與查詢量。沒有流量、訊息大小和模型輸入輸出量,就沒有可信的「每月一萬次只要多少美元」。
如果只是在做第一版,先跑通「文件檢索 → 模型回答 → 人工檢查」即可。報表和串流管線可以等你確定要追哪些指標,再逐步接上。
ACE 題目怎麼判斷
- 服務間要一對多傳遞訂單事件? 先想 Pub/Sub,並記得訂閱者要處理重送。
- 連續事件要按分鐘彙總、處理遲到資料? 看 Dataflow/Apache Beam 的視窗處理。
- 既有 Spark 作業要上雲? 先看 Managed Service for Apache Spark 的叢集或 serverless 部署,不必預設重寫成 Beam。
- 歷史銷售資料只查最近七天? 看 BigQuery 的分區條件、掃描欄位與 dry run。
- 客服要根據公司文件回答? 先處理文件檢索、資料權限與答案驗證,別把「訓練自己的模型」當第一步。
說到底,這篇不是要你記住一整張雲端產品圖。把資料從哪裡來、在哪裡改變、最後由誰使用畫出來,才有辦法刪掉不需要的服務,也看得出缺了哪一步。
下一課 ACE-205:Google Cloud 資安架構與合規會接著看 IAM、KMS 和網路邊界怎麼保護這些資料與服務。
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
App Engine、Cloud Run、GKE 怎麼選?先看誰負責維運
同一個應用可以用好幾種方式部署。從程式怎麼交付、需要多少控制權和團隊願意維護什麼,選合適的平台。
GCP 高可用架構:一個 Zone 故障時服務怎麼繼續?
從健康檢查、MIG 和負載平衡器開始,設計 Zone 故障時仍能服務的架構,再看備份與跨區域復原。