GCP 高可用架構:一個 Zone 故障時服務怎麼繼續?
一台 VM 壞掉、整個 Zone 暫時不可用,或資料庫連不上,使用者看到的都是「網站打不開」。但這三種故障不能靠同一個開關解決。要談高可用,先說清楚你想扛住哪種故障,以及服務最多能停多久。
這篇以一個使用 VM 與 Cloud SQL 的購物網站為例,走一遍「某個 Zone 故障後會發生什麼事」。MIG、負載平衡器、備份與跨區域部署各有工作,不必一口氣把所有產品都堆進架構圖。
先把故障範圍說清楚
| 發生什麼事 | 先檢查哪一層 | 不能只靠什麼 |
|---|---|---|
| 一台 VM 的應用程式卡住 | 健康檢查、負載平衡器、MIG 自動修復 | 再開一台 VM,卻沒有導流和檢查 |
| 一個 Zone 故障 | 跨 Zone 的運算容量與資料庫區域 HA | 把所有 VM 放在同一個 Zone |
| 整個 Region 長時間不可用 | 另一個 Region 的應用、資料與切換程序 | 只有同區域的 HA 待命 |
| 資料被誤刪或程式寫壞 | 可還原的備份、時間點還原與演練 | 同步複寫;它可能把錯誤一起複製 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
SLA 是供應商在特定條件下的服務承諾,不是你的購物網站「保證不會停」的證書。比較貼近產品決策的是 RTO 和 RPO:前者是出事後最多能停多久,後者是最多能承受遺失多久的寫入。Google 的災難復原指引也從這兩個問題開始,而不是先選工具。幾個九換算成多少停機時間,可看 PCA-04:定義 SLO 與 SLI。
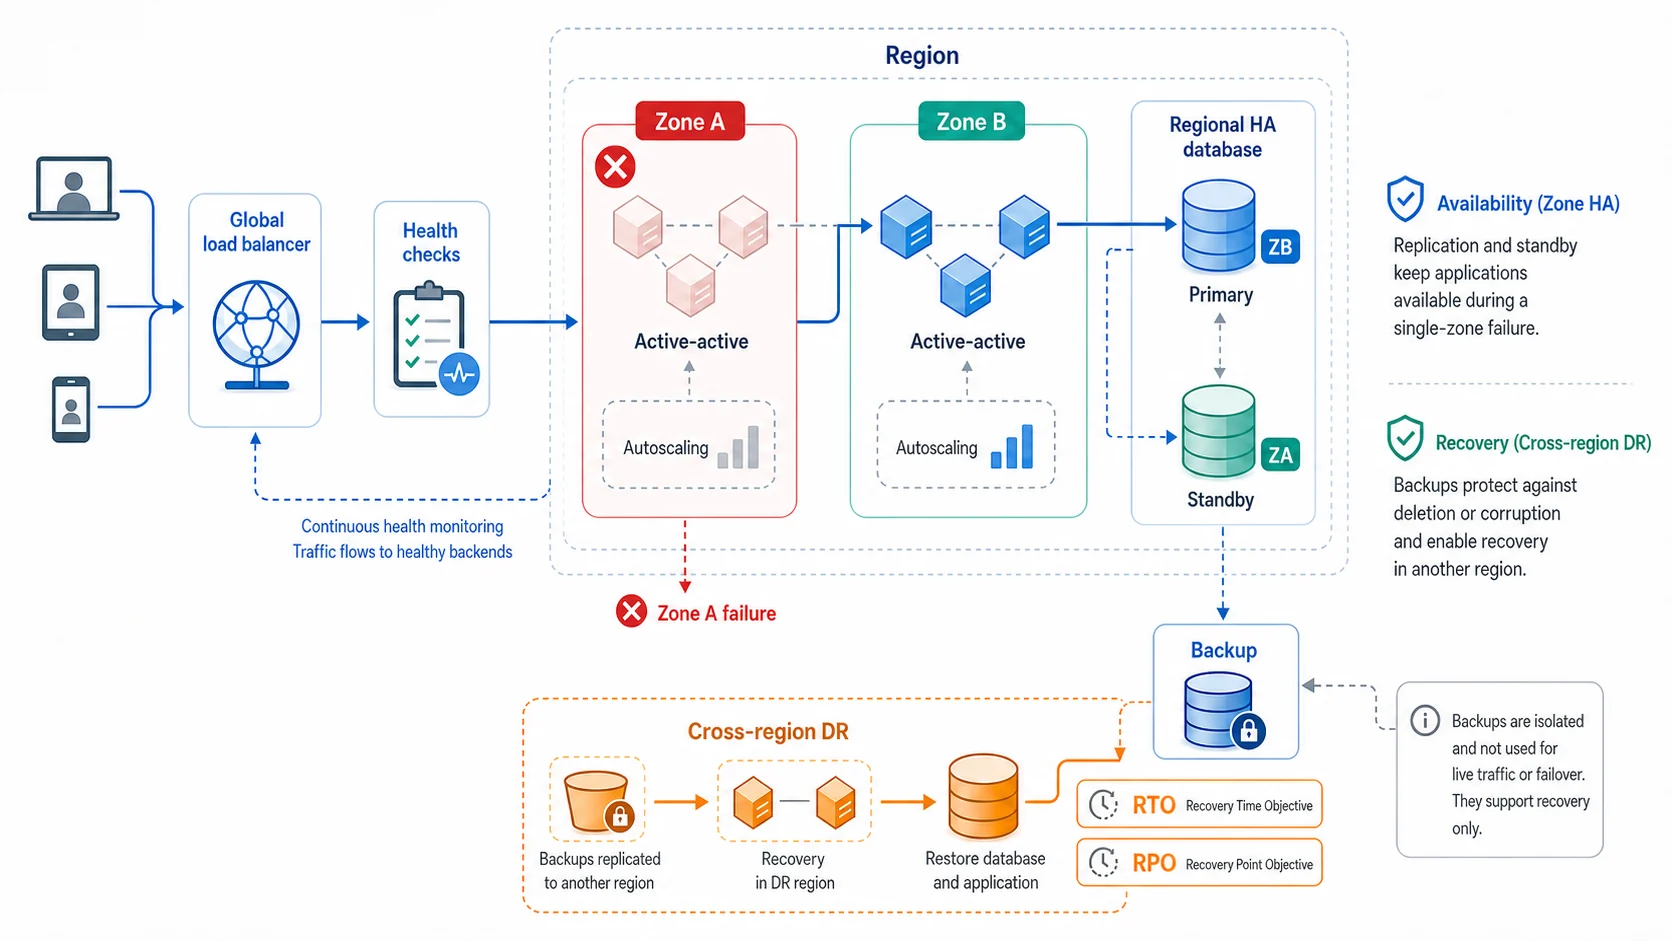
跨 Zone 的 MIG 與資料庫待命處理 Zone 故障;備份和另一個 Region 處理誤刪、毀損或區域災難。備份不接線上流量,也不等於故障切換。
一個 Zone 掛了,入口和 VM 怎麼接手?
先看網站的無狀態應用層。若使用 Compute Engine,把相同版本的 VM 放在區域型 Managed Instance Group(MIG),讓它跨同一個 Region 的多個 Zone 部署。MIG 可以依範本重建故障 VM、滾動更新,也能按負載擴縮;但它不會替你保存 VM 本機上的購物車或上傳檔案。這些狀態要放在適合的外部儲存,否則換一台 VM 就像換了一台空機。
MIG 的自動擴縮有三種做法:看當下指標(平均 CPU 使用率、負載平衡器的服務容量或 Cloud Monitoring 指標)、依歷史負載預先開機的預測式,以及指定某段時間至少要幾台的排程式。預測式只能搭配 CPU 使用率,適合有每日或每週週期、啟動又慢的應用;它靠的是歷史資料,不是 cron,照時間表開機的是排程式。
再把 MIG 接到負載平衡器。網站若要依 HTTP 路徑分流,通常先看 Application Load Balancer;若是其他 TCP/UDP 協定,再看合適的 Network Load Balancer。對外或內部、全域或區域,也要依實際使用者與後端位置選,不是「Global」聽起來比較強就一定選它。各類負載平衡器的差別,ACE-210:負載平衡器怎麼選有逐項說明。
動手建置時可以照請求路徑檢查:先做能重建相同應用版本的 instance template,建立跨 Zone 的 regional MIG;接著設定給負載平衡器使用的 backend service 和健康檢查,最後才接 URL map、前端 IP 與憑證。若範本還依賴某台 VM 上的手動設定,MIG 重建出來的機器可能根本無法服務,後面加再多導流規則也救不了。
當某台 VM 的應用程式不回應時,負載平衡器的健康檢查應把新請求送往其他健康 VM;MIG 的自動修復則負責重建故障 VM。兩件事先後接力,但速度和判斷標準不必一樣。官方 MIG 文件建議多數情況下把兩套健康檢查分開:導流要夠快,重建則應更謹慎,免得短暫抖動就把一批機器反覆刪掉。
健康檢查路徑也別只回一個固定的 200 OK,那只能證明程序還在;同樣地,也別把所有外部依賴都塞進同一個探針,讓一個非關鍵服務抖動時整群 VM 一起被判死。先定義「這台機器能不能接新請求」和「它是否真的需要重建」,再讓兩個探針各回答一題。MIG 新 VM 的啟動時間也要算進自動修復的初始延遲,否則還沒暖機就會被判為故障。
換成指令大致是三步。名稱、區域與數值都是示範,INSTANCE_TEMPLATE_URL 和 HEALTH_CHECK_URL 請換成自己建好的範本與健康檢查:
# 1. 建立跨 Zone 的 regional MIG
gcloud compute instance-groups managed create web-mig \
  --template INSTANCE_TEMPLATE_URL --size 3 --region asia-east1

# 2. 自動修復:綁定健康檢查,並設定初始延遲(秒)
gcloud compute instance-groups managed update web-mig \
  --health-check HEALTH_CHECK_URL --initial-delay 300 --region asia-east1

# 3. 自動擴縮:平均 CPU 目標 60%,最少 3 台、最多 10 台
gcloud compute instance-groups managed set-autoscaling web-mig \
  --min-num-replicas 3 --max-num-replicas 10 \
  --target-cpu-utilization 0.60 --region asia-east1
--initial-delay 可設 0 到 3600 秒,這段時間內的健康檢查失敗不會觸發重建;--max-num-replicas 是設定自動擴縮時的必要旗標。健康檢查的探測若被防火牆規則擋住,VM 會被判為不健康,要先放行。細節見自動修復與 CPU 擴縮的官方說明。
跨 Zone 部署只是把機器分開;還要試算「少掉一個 Zone,剩下的 VM 和配額撐不撐得住尖峰」。假設壓測發現一台 VM 能穩定處理 200 個每秒請求,尖峰是 1,200 個;需要 6 台。若三個 Zone 各放 2 台,少一個 Zone 後只剩 4 台,容量立刻不夠。這時要留備援容量,或確認擴容速度、區域配額與剩餘 Zone 都能補上缺口,而不是只看 MIG 有沒有設成「自動擴縮」。這組數字只是算式示範,實際容量要用自己的壓測結果。
資料庫不會因為網站有兩個 Zone 就自動安全
假設所有 VM 都連同一個 Cloud SQL 執行個體,資料庫便是另一個要檢查的環節。Cloud SQL 區域 HA會在同一個 Region 的兩個 Zone 配置主要與待命執行個體;主要端或 Zone 故障時,待命端可接手。但切換仍會讓連線短暫中斷,應用必須能重連,並安全地重試未完成的交易。
區域 HA、讀取副本、備份不要混為一談。HA 待命負責區域內的故障切換,不承擔平常讀流量;讀取副本能分流查詢,也可作為跨區復原的一部分,但跨區複寫通常是非同步的,提升副本可能少了最近的寫入;備份則處理誤刪、錯誤更新等需要回到過去狀態的問題。想更細看這幾種資料服務的分工,可讀上一篇 ACE-201:儲存策略。
因此,「有兩個 Zone」不等於「任何事故都零資料遺失」。要看你用的是哪種資料庫配置、事故發生在哪裡,並做一次真的還原演練。跨區讀取副本的官方說明也提醒,非同步複寫在區域事故時可能有資料落差。
如果連整個 Region 故障都要扛住
如果業務要求整個 Region 不可用時仍能繼續服務,運算層要在另一個 Region 有可用版本,資料層也得先決定怎麼複寫或還原。全域負載平衡器可以把流量導向其他健康的 VM 後端,但切換後應用是否能讀到資料、是否允許寫入、容量夠不夠,還得另外驗證。只在另一個 Region 多開幾台 VM,不算完成災難復原。
Cloud Run 也一樣:它是區域型服務,想跨區就得在多個 Region 部署。多區域服務文件特別提醒:單純把多個 Cloud Run 服務接到全域負載平衡器,不會在某區服務不回應時自動完成你想要的故障轉移。若要依區域健康狀態自動切換,還需設定Cloud Run service health所需的 readiness probe、最小執行個體、serverless NEG 與負載平衡器,並測試故障與回切。這項功能已於 2026-06-29 正式發布(GA);每個 Region 至少要有一個最小執行個體,而且要有兩個以上不同 Region 的服務,才有故障轉移可言。
跨區是成本與複雜度的選擇,不是預設要做。另一個 Region 的待命容量、資料複寫、跨區傳輸與演練都要花錢;若產品容許幾小時恢復,用經過測試的備份復原方案,也可能比一直維持雙區即時服務合適。
Cloud CDN 和 Cloud Armor 有用,但不是備援開關
Cloud CDN可以把可快取的圖片、CSS 等內容放到邊緣,減少回源請求。它不會替你修好資料庫,也不該把每位使用者的購物車或個人資訊強制快取成同一份;快取模式和 Cache-Control 要先設對。
Cloud Armor則用安全政策、WAF 規則等機制減少惡意流量對服務的衝擊。它能幫網站抵擋某些攻擊,不代表 Zone 故障時會自動生出健康的後端。若要同時用 CDN 與 Armor,還得看政策是在邊緣或後端哪一層執行,別假設所有快取命中都會走過同一套檢查。
上線前,做一次能看見結果的故障演練
先在測試環境挑一個情境,不必直接模擬整區停電。例如讓一台測試 VM 的應用健康檢查失敗,記錄負載平衡器多久不再送新請求、MIG 多久補上 VM、使用者看到了多少錯誤。再測 Cloud SQL 的切換或從備份還原,記錄真正的 RTO 和資料狀態。
我會把結果寫成一頁 runbook:故障訊號是什麼、誰決定切換、要執行什麼、如何確認服務真的恢復、如果新路徑也不正常要怎麼退回。做跨區設計時尤其要把資料的寫入位置與回切步驟寫清楚,避免兩邊同時收寫入卻無法對帳。
準備 ACE 時,可以用同一套問題檢查選型:故障範圍是 VM、Zone 還是 Region?流量由誰導開?資料靠什麼接手或還原?答案能串起來,才算是高可用架構。下一篇 ACE-203:App Engine、Cloud Run、GKE 怎麼選會接著看運算平台的維運取捨。
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
App Engine、Cloud Run、GKE 怎麼選?先看誰負責維運
同一個應用可以用好幾種方式部署。從程式怎麼交付、需要多少控制權和團隊願意維護什麼,選合適的平台。
GCP 資料與 AI 服務怎麼接?從資料進來到模型回答
Pub/Sub、Dataflow、BigQuery,加上兩個已改名的服務 Managed Service for Apache Spark(原 Dataproc)和 Agent Platform(原 Vertex AI),各做什麼?沿著一筆...