
Google Cloud 資料庫怎麼選?先看資料怎麼讀寫
前言
設計新系統時,資料庫名稱通常很早就會出現在白板上。但在挑產品之前,得先問資料會怎麼被讀寫、需不需要交易,以及查詢要多快。
Google Cloud 光是關聯式選項就有 Cloud SQL、AlloyDB 和 Spanner。服務選得不合工作負載,後面可能得為效能、成本或資料模型付出很大的調整代價。
下面把六種常見選項的用途、限制和費用放在同一套問題裡比較。決策樹只幫你縮小範圍;最後仍要用實際資料量和查詢方式驗證。
如果你只需要學習單一服務,可以直接跳到對應段落,或參考各服務的專門課程文章。
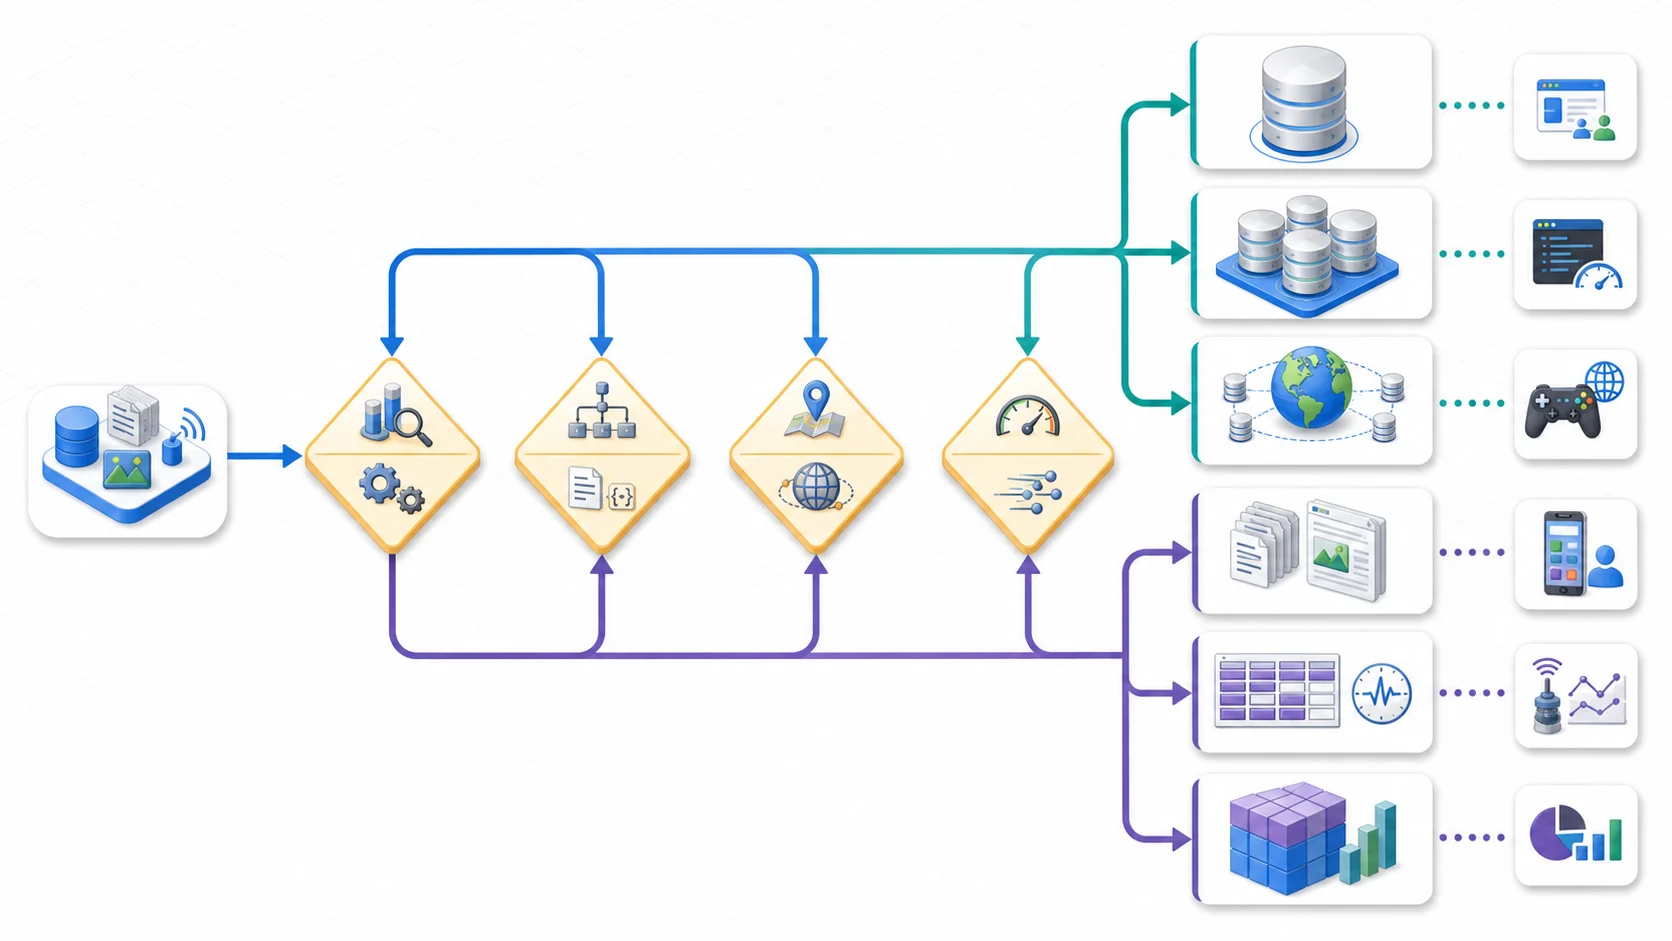
先分清這份資料是供線上服務讀寫,還是用來做分析;接著看交易、查詢方式和資料所在區域。圖上的分支能幫你縮小候選範圍,但同一套系統可能同時需要營運資料庫與分析倉儲。
六種服務,先看差異
先看全貌,再深入每一個服務:
| 先問什麼 | Cloud SQL | AlloyDB | Spanner | Firestore | Bigtable | BigQuery |
|---|---|---|---|---|---|---|
| 主要用途 | 一般關聯式交易 | PostgreSQL 交易與混合分析 | 需要分散式交易的關聯資料 | 文件型應用資料 | 依 Row Key 讀寫的大量資料 | 大量資料分析與報表 |
| 資料怎麼查 | SQL、JOIN、交易 | PostgreSQL 相容查詢 | GoogleSQL 或 PostgreSQL 介面 | 文件查詢、索引與即時監聽 | Key 查找與範圍掃描,也支援 SQL | GoogleSQL 掃描與聚合 |
| 擴充要注意 | 主執行個體的寫入能力 | 讀取集區與主要執行個體 | 主鍵分布、運算容量與區域 | 文件/索引熱點 | Row Key 熱點與節點容量 | 查詢量、Slot 與資料分區 |
| 費用先看 | 機型、HA、儲存與網路 | 執行個體、儲存與網路 | 運算、儲存與複寫 | 操作次數、儲存與網路 | 節點、儲存與複寫 | 查詢運算、儲存與網路 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
這張表用來縮小候選範圍,不是效能或可用性的承諾。延遲要用自己的資料與查詢實測;SLA 也要按實際區域、部署方式和官方條款確認。
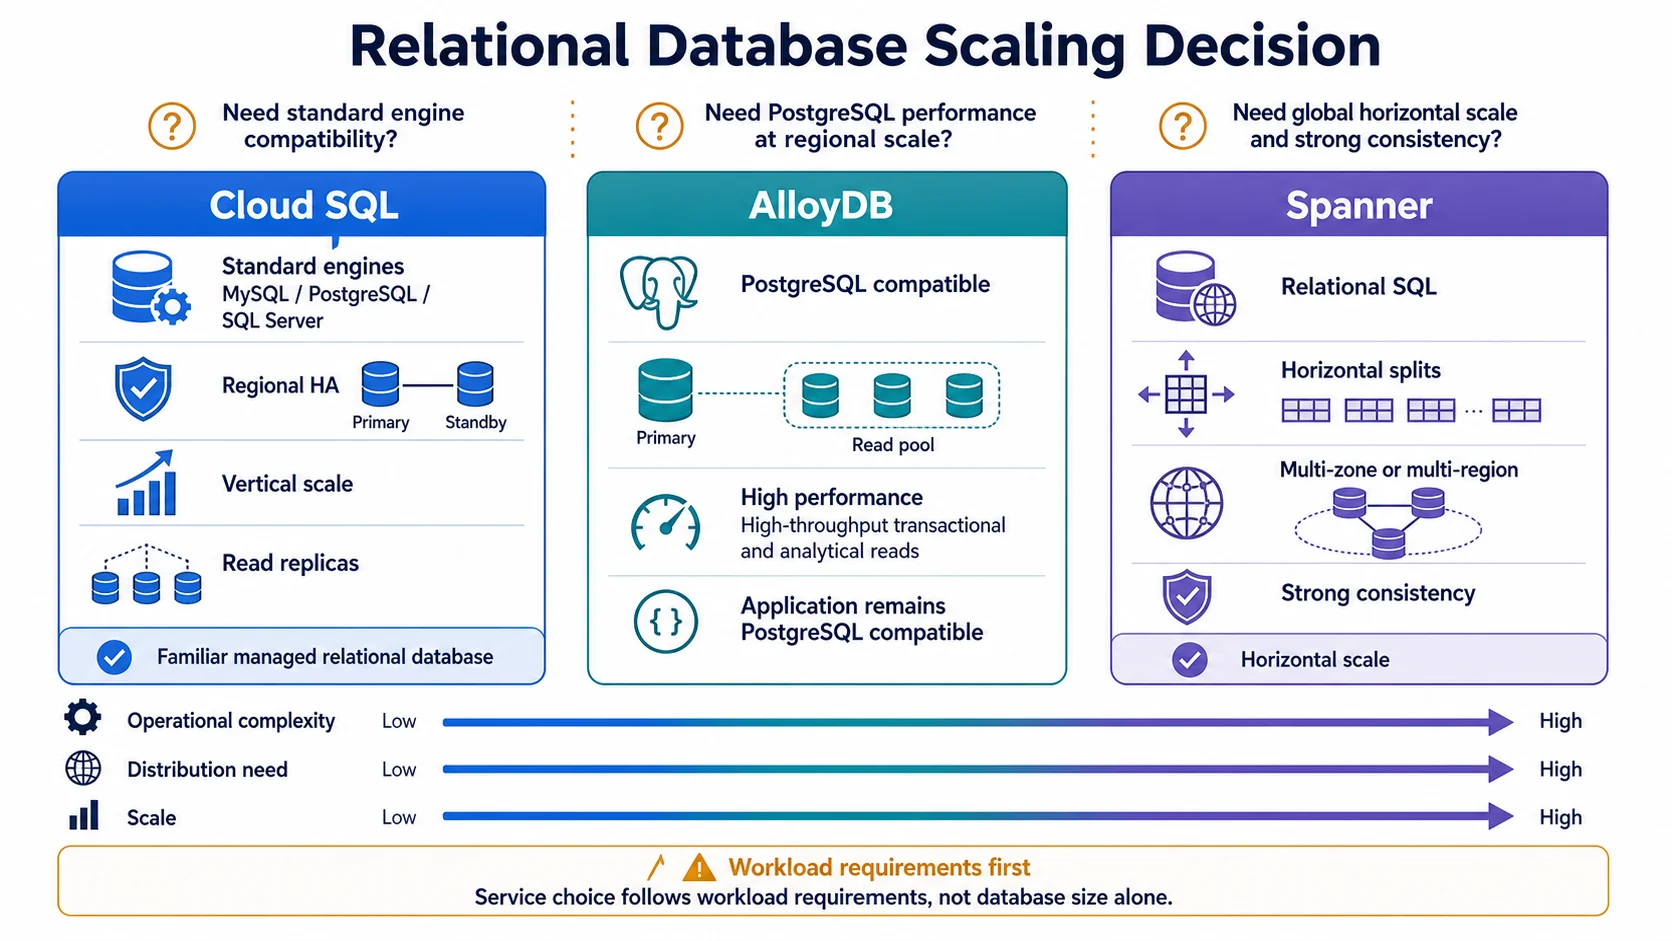
三者是不同需求下的替代選項,不是一條必然遷移路線。先確認是否需要關聯式交易,再依區域範圍、 PostgreSQL 相容性、寫入規模、一致性與維運成本,選 Cloud SQL、AlloyDB 或 Spanner。
Cloud SQL:先看既有引擎與交易需求
定位
Cloud SQL 提供受管的 MySQL、PostgreSQL 和 SQL Server,團隊不用自行管理資料庫主機的作業系統與修補。若應用目前是一般關聯式交易需求,可以先把它列入候選;但備份、可用性和擴充方式仍要依工作負載設定,不能只因為「受管」就當成全都不用管。
核心特性
- 三種引擎:MySQL、PostgreSQL、SQL Server(可選的主版本依 edition 而定,以官方 editions 頁為準)
- 垂直擴展:上限依 edition 而定,Enterprise Plus edition 的 N2 機型最大 128 vCPU、864 GB RAM,Enterprise edition 的專用核心(dedicated core)機型最大 96 vCPU、624 GB RAM
- 高可用(HA):跨可用區自動容錯移轉,SLA 99.95%
- 讀取副本:每個主要執行個體最多 10 個 Read Replicas(SQL Server 為 8 個),支援跨區域
- Private networking:可用 Private Services Access、Private Service Connect,或讓兩條私網路徑並存
- 自動儲存擴充:最大 64 TB(此為專用核心(dedicated-core)機型上限;共用核心(shared-core,如 db-f1-micro)儲存上限較低,約 3 TB)
適用場景
- 中小型 Web 應用的後端資料庫
- 既有 MySQL / PostgreSQL 應用的雲端遷移(lift-and-shift)
- 需要標準 SQL 語法的 OLTP 工作負載
- 開發 / 測試環境
限制
- 不能水平寫入擴展——寫入效能受限於單一主執行個體
- 無法跨區域高可用——HA 只在同一 Region 內的兩個 Zone
- 單一寫入點——讀取副本是唯讀的
gcloud CLI 快速建立
# 建立 PostgreSQL 執行個體
gcloud sql instances create my-pg-instance \
  --database-version=POSTGRES_18 \
  --tier=db-custom-2-8192 \
  --region=asia-east1 \
  --availability-type=REGIONAL \
  --storage-auto-increase

# 建立資料庫
gcloud sql databases create myapp --instance=my-pg-instance

# 設定使用者密碼
gcloud sql users set-password postgres \
  --instance=my-pg-instance \
--password=YOUR_SECURE_PASSWORDAlloyDB:PostgreSQL 交易與分析一起跑時
定位
AlloyDB 是 PostgreSQL 相容的託管資料庫,運算和儲存可以分開配置,也提供讀取集區與欄式引擎。如果現有 PostgreSQL 的交易或分析查詢碰到瓶頸,值得拿實際查詢測試;不要把產品頁上的倍數當成自己系統一定能達到的結果。
核心特性
- PostgreSQL 相容:可沿用常見的驅動程式與管理工具;遷移前仍要檢查版本、擴充套件和 SQL 用法
- 運算與儲存分離:運算層可獨立擴展
- 欄位引擎(Columnar Engine):自動將常查詢的欄位載入記憶體,加速分析
- ML 整合:內建
google_ml_integration擴充,可直接在 SQL 內呼叫 Gemini Enterprise Agent Platform(原 Vertex AI)上的模型 - 智慧快取:跨層級智慧快取,減少 I/O
- SLA:99.99%
適用場景
- 高效能 OLTP + 即時分析的混合工作負載(HTAP)
- 從標準 PostgreSQL 遷移但需要更好效能的系統
- 需要在資料庫層做 AI/ML 推論的應用
- 需要比 Cloud SQL 更高 SLA 但不到 Spanner 規模的系統
限制
- 只支援 PostgreSQL——如果你用 MySQL 或 SQL Server,不適用
- 固定資源成本較高——Primary、HA 節點、Read Pool 與儲存都要納入估算,通常高於入門 Cloud SQL
- 區域性——目前支援的區域比 Cloud SQL 少
- 不支援水平寫入擴展——寫入仍為單一主要執行個體
gcloud CLI 快速建立
# 建立 AlloyDB 叢集
gcloud alloydb clusters create my-alloydb-cluster \
  --region=asia-east1 \
  --password=YOUR_SECURE_PASSWORD

# 建立主要執行個體
gcloud alloydb instances create my-primary \
  --cluster=my-alloydb-cluster \
  --region=asia-east1 \
  --instance-type=PRIMARY \
  --cpu-count=2

# 建立讀取集區
gcloud alloydb instances create my-read-pool \
  --cluster=my-alloydb-cluster \
  --region=asia-east1 \
  --instance-type=READ_POOL \
  --read-pool-node-count=2 \
  --cpu-count=2
如果現有 PostgreSQL 應用遇到交易效能或分析查詢瓶頸,可以把 AlloyDB 納入候選;但仍要先量測瓶頸,並比較 Cloud SQL 的調整空間、遷移成本和所需功能。
Cloud Spanner:需要跨區強一致時再評估
定位
Spanner 適合需要關聯式交易、跨區域部署,且單一寫入執行個體不夠用的系統。它透過分散式架構與 TrueTime 提供強一致的交易能力;代價是主鍵、區域配置、延遲和費用都要一併設計。
核心特性
- 水平擴展:可增加運算容量,但吞吐量仍取決於主鍵分布與工作負載
- 可用性 SLA:多區域配置的目標可達 99.999%;適用條件請看官方 SLA
- 全球分散式 ACID:跨洲交易也能保證一致性
- 雙 SQL 介面:Google SQL + PostgreSQL 介面(PGAdapter)
- Change Streams:即時捕捉資料變更事件
- Editions:Standard / Enterprise / Enterprise Plus 三種等級
適用場景
- 全球部署的金融交易系統(跨國轉帳、支付)
- 遊戲排行榜(全球一致性排名)
- 供應鏈管理系統(跨區域庫存同步)
- 需要水平擴展又不能犧牲 SQL 和 ACID 的系統
限制
- 成本模型不同:可從 100 PU 細粒度配置起步,但多區域、吞吐、儲存與備份會共同放大正式環境成本
- 主鍵設計要求嚴格:高寫入表若把單調遞增的時間或整數放在主鍵最前方,會產生熱點;可改用 UUIDv4、Hash 前綴或 Spanner 的 bit-reversed sequence
- 不支援原生 DDL 鎖:Schema 變更是非同步的
- 需要重新設計與測試:主鍵、交易範圍、運算容量和存取區域都要納入規劃
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  WRITE["大量並行寫入"] --> KEY["主鍵第一欄如何分布?"]
  KEY -->|"時間戳或單調遞增 ID"| MONO["新資料持續落在 Keyspace 尾端"]
  MONO --> HOT["單一 Split/Server 過熱<br/>延遲、Abort 與擴展瓶頸"]
  KEY -->|"UUIDv4、Hash 前綴<br/>或 bit-reversed sequence"| DISTRIBUTE["Key 均勻散布到不同範圍"]
  DISTRIBUTE --> SPLITS["多個 Split 平行承接寫入"]
  SPLITS --> SCALE["增加 PU/Node 才能有效提高吞吐"]
Spanner 支援自動產生主鍵,但「能產生」不代表單調遞增值適合高寫入表。先讓 Keyspace 均勻分布,再增加運算容量;否則擴容也可能只是在旁邊增加用不到的資源。
gcloud CLI 快速建立
# 建立單區域 Spanner 執行個體
gcloud spanner instances create my-spanner \
  --config=regional-asia-east1 \
  --processing-units=100 \
  --description="My Spanner Instance"

# 建立資料庫(Google SQL)
gcloud spanner databases create mydb \
  --instance=my-spanner

# 建立資料庫(PostgreSQL 介面)
gcloud spanner databases create mydb-pg \
  --instance=my-spanner \
  --database-dialect=POSTGRESQL
💡 選型提醒:跨區域交易、強一致性與水平擴展若同時是硬需求,可以評估 Spanner,並檢查資料模型、區域配置與費用。
深入學習:Cloud Spanner 深度解析
Firestore:需要文件查詢與即時同步時
定位
Firestore 是 GCP 的全托管 NoSQL 文件資料庫(Document Database),主打行動應用和 Web 應用。資料以類 JSON 的文件格式存放,支援即時同步跟離線快取。
核心特性
- 每個資料庫可選一種模式:
- Native mode:即時監聽、離線支援、安全規則——適合行動 / Web 前端
- Datastore mode:供現有 Datastore API 應用延續使用;不提供 Native mode 的即時監聽
- 同專案可建立多個資料庫:不同資料庫可依需求選 Native 或 Datastore mode;Client 未指定時會連到
(default)資料庫 - 受管服務:不用管理資料庫主機,但仍需設計索引、權限與讀寫量
- 即時監聽:資料變更時主動推播給客戶端
- 離線支援:行動端可在無網路時繼續讀寫,上線後自動同步
- 強一致性:所有查詢都是強一致的(自 Firestore 起,不同於舊 Datastore 的最終一致)
- 免費層:Standard edition 每天 50,000 次讀、20,000 次寫、20,000 次刪除;每個專案只有一個資料庫套用免費額度
適用場景
- 行動應用 / PWA 的後端資料儲存
- 即時聊天、即時協作工具
- 使用者個人資料、設定、偏好
- 遊戲玩家狀態管理
- 小到中型的 Web 應用後端
限制
- 單一文件大小:最大 1 MiB
- 熱點與競爭:單一文件能承受的更新速率取決於工作負載、索引數與競爭程度;高頻更新會造成延遲或錯誤,並非固定「每秒 1 次」
- 查詢限制:不支援 JOIN;多欄位範圍/不等式與複合排序可用,但要建立對應索引並遵守查詢限制
- 匯出/匯入:大量資料操作需透過 GCS
- 不適合複雜分析:原生支援 count / sum / avg 聚合查詢,但這些是 read-time 計算(需建索引、不支援即時更新與快取),複雜分析仍建議匯入 BigQuery
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 26, "nodeSpacing": 18}}}%%
  flowchart TB
  START["建立一個 Firestore Database"] --> CLIENT["主要 Client 與相容性需求?"]
  CLIENT -->|"行動/Web:即時監聽、離線與 Security Rules"| NATIVE["Native mode"]
  CLIENT -->|"既有 Datastore API/純後端相容性"| DATASTORE["Datastore mode"]
  NATIVE --> WRITE["檢查文件 ID、索引與寫入分布"]
  DATASTORE --> WRITE
  WRITE -->|"集中更新同一文件<br/>或循序 ID/時間索引"| HOT["競爭或熱點:延遲與錯誤上升"]
  WRITE -->|"分散 Document Key、移除不必要索引<br/>逐步提升流量"| SCALE["Firestore 自動分片與擴展"]
HOT --> REDESIGN["拆分聚合文件、分散計數器<br/>或改用 Bigtable 等寫入模型"] 模式是每個資料庫的屬性,不是整個專案只能二選一;同一專案可有多個資料庫,但免費額度只套用其中一個。效能上也不要背「單文件每秒 1 次」,應直接檢查是否有文件競爭、循序 Key 與索引熱點。
gcloud CLI 快速建立
# 建立 Firestore 資料庫(Native mode)
gcloud firestore databases create \
  --location=asia-east1 \
  --type=firestore-native

# 匯出資料到 GCS
gcloud firestore export gs://my-backup-bucket/firestore-export

# 匯入資料
gcloud firestore import gs://my-backup-bucket/firestore-export
如果應用需要文件查詢、即時監聽與離線支援,可以先試 Firestore Native mode。若已有 Datastore API 相依,再評估 Datastore mode;不能只因為「後端程式會查 Key-Value」就直接選它。同一個資料庫只能用一種模式,同一專案則可建立多個資料庫。
Bigtable:大量資料要按 Row Key 讀寫時
定位
Bigtable 是寬列型 NoSQL 資料庫,適合資料量大、主要依 Row Key 找單列或掃描相近資料的工作負載。要不要用它,還得看實際查詢、寫入分布與節點成本;不是資料多就一定適合。
核心特性
- 大量資料:依 Row Key 範圍分片,儲存仍受節點容量與配額限制
- 低延遲存取:SSD 適合線上讀寫,實際 p99 要以自己的負載測試
- 可增加節點處理更多流量:前提是讀寫沒有集中在少數 Key 範圍
- HBase API 用戶端:可協助 Java 應用遷移,但仍需檢查 API 差異
- 自動擴縮:根據 CPU 使用率自動調整 Node 數量
- Change Streams:即時擷取資料變更
- 複製叢集:支援跨區域複製,SLA 可達 99.999%
- GoogleSQL 查詢:可從 Bigtable Studio 或支援的 Client Library 執行 SQL,但仍遵循 Row Key、無 JOIN 與單列交易的資料模型
適用場景
- IoT 感測器資料(數十億筆時間序列)
- 金融市場資料(行情、逐筆交易)
- 使用者行為分析(推薦引擎的特徵儲存)
- 大規模時序資料庫(監控指標、日誌索引)
- AdTech(廣告技術的即時出價資料)
限制
- 正式環境最低 1 Node:即使閒置仍有節點與儲存成本;官方有期間限定的試用 Instance,但不是永久免費層
- 不是關聯式 SQL:GoogleSQL 能查詢 Bigtable,但不提供 JOIN、外鍵或跨列 ACID 交易
- Row Key 設計關鍵:設計不當會導致熱點,效能暴跌
- 次級索引需另行設計:可用 Continuous Materialized View 建立非同步次級索引,讀取仍應以 Row Key Prefix 與 Range 為核心
- 小資料量也要算成本:如果讀寫量不高、又需要關聯式或文件查詢,Cloud SQL 或 Firestore 可能更合適;沒有固定的 1 TB 分界線
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  QUERY["列出最常見查詢:<br/>查單一裝置最近資料,或掃描一段時間?"] --> KEY["設計可用 Prefix/Range 讀取的 Row Key"]
  KEY --> BAD["不佳:timestamp#device_id"]
  BAD --> END["所有最新寫入集中在 Keyspace 尾端"]
  END --> HOT["單一 Node/Tablet 熱點"]
  KEY --> GOOD["較佳:device_id#reverse_timestamp<br/>必要時再加 Hash/Bucket"]
  GOOD --> RANGE["同裝置資料相鄰,<br/>最近資料可用範圍讀取"]
  RANGE --> EVEN["不同裝置/Bucket 將寫入分散"]
  EVEN --> TEST["用真實 Key 分布與吞吐壓測<br/>再設定 Autoscaling"]
Bigtable Schema 由讀取方式決定;時間戳可放在 Row Key 後段,但不要單獨放在最前面。GoogleSQL 讓查詢語法更熟悉,並不會消除 Row Key 與熱點設計責任。
gcloud CLI 快速建立
# 建立 Bigtable 執行個體
gcloud bigtable instances create my-bigtable \
  --display-name="My Bigtable" \
  --cluster-config=id=my-cluster,zone=asia-east1-a,nodes=1,storage-type=SSD

# 建立資料表
cbt -instance=my-bigtable createtable my-table

# 建立 Column Family
cbt -instance=my-bigtable createfamily my-table metrics

# 啟用自動擴縮
gcloud bigtable clusters update my-cluster \
  --instance=my-bigtable \
  --autoscaling-min-nodes=1 \
  --autoscaling-max-nodes=5 \
  --autoscaling-cpu-target=60
若資料持續大量寫入,而且讀取主要沿著 Row Key 走,Bigtable 值得測試;若需要 JOIN、多列交易或另一種查詢方式,就先比較其他資料庫。
BigQuery:分析大量資料,不承接逐筆交易
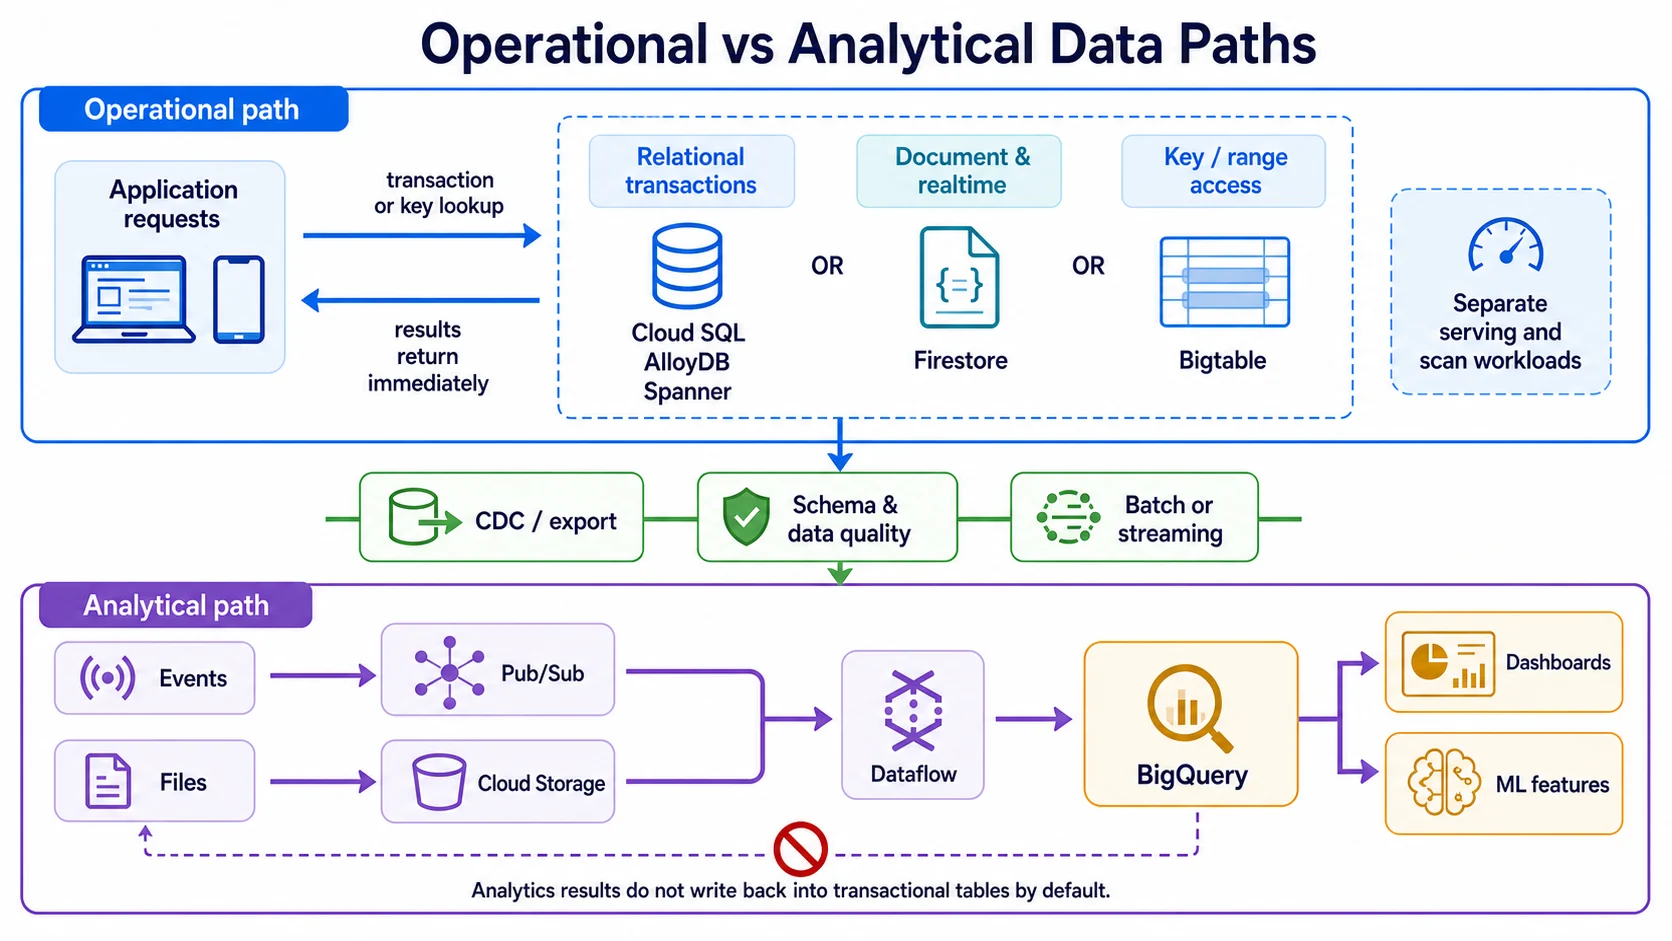
線上服務的低延遲讀寫與分析掃描是兩種工作。營運資料留在適合交易或低延遲存取的資料庫;事件與檔案另外經 Pub/Sub、Cloud Storage 與 Dataflow 進 BigQuery,避免把資料倉儲當作 API 的交易後端。
定位
BigQuery 是託管的分析平台,擅長用 SQL 掃描、彙總大量資料。查詢時間取決於資料量、分區、查詢寫法和運算配置;它支援資料異動與多語句交易,但通常不該承接 API 每次請求的逐筆交易。
核心特性
- 無伺服器:不需要管理叢集、節點或索引
- 欄位式儲存(Columnar):天生適合分析查詢(只讀取需要的欄位)
- 儲存與運算分離:Dremel 引擎 + Colossus 儲存
- 定價彈性:On-demand(按查詢量計費)或 Editions(預留 Slot 容量)
- BigQuery ML:直接用 SQL 建立和訓練 ML 模型
- 免費額度:是否適用與當期額度以官方定價頁為準
- 跨雲查詢:BigQuery Omni 可查詢 AWS S3 和 Azure Blob 的資料
適用場景
- 商業智慧(BI)報表和儀表板
- 大規模日誌分析(應用日誌、稽核日誌)
- 資料湖(Data Lake)上的 SQL 分析
- ML 特徵工程和模型訓練
- 行銷分析、使用者漏斗分析
限制
- 不適合逐筆交易後端:查詢有啟動、排程與掃描成本,不宜拿來承接每次 API 請求
- DML 併行與速率限制:每個資料表的 INSERT 與 mutating DML 有併行、排隊與速率配額,適合批次/分析資料異動,不是高頻逐筆交易
- 串流寫入限制:Storage Write API (REST)(原 legacy 串流寫入
tabledata.insertAll)有每秒位元組數配額(us/eu 多區域每專案預設 1 GB/秒,其他位置 300 MB/秒),單次請求上限 50,000 列 - 交易範圍不同:支援具 ACID 與 Snapshot Isolation 的多語句交易,也能
BEGIN TRANSACTION/COMMIT,但交易需遵守表數、分割區與併行限制,不能把它當 OLTP 後端 - 查詢成本難預測:On-demand 模式依掃描量計費;每月前 1 TiB 分析量免費,超出後應以當下區域定價估算
gcloud CLI 快速範例
# 建立 Dataset
bq mk --dataset \
  --location=asia-east1 \
  --description="Sales Analytics" \
  my-project:sales_analytics

# 從 GCS 載入資料
bq load \
  --source_format=CSV \
  --autodetect \
  sales_analytics.transactions \
  gs://my-bucket/sales/*.csv

# 執行查詢
bq query --use_legacy_sql=false \
  'SELECT region, SUM(revenue) as total
   FROM `my-project.sales_analytics.transactions`
   WHERE DATE(order_date) >= "2026-01-01"
   GROUP BY region
   ORDER BY total DESC'

# 查看花費預估
bq query --dry_run --use_legacy_sql=false \
  'SELECT * FROM `my-project.sales_analytics.transactions`'
若需求是使用者登入、購物車或逐筆庫存更新,先看交易資料庫;若是跨大量歷史資料做報表或探索查詢,再評估 BigQuery。這只是縮小候選範圍,還要確認資料怎麼進來、多久更新一次,以及查詢成本。
深入學習:BigQuery 實戰指南
選型決策樹
不知道從哪裡比起,可以先沿著這張圖問下去。它幫你找出值得試的服務,不是走到某個方框就能直接定案。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 24, "nodeSpacing": 18}}}%%
  flowchart TB
  START["這份資料主要如何被使用?"] --> WORKLOAD["大量掃描、聚合、BI/ML,<br/>而非每次 API 的逐筆交易?"]
  WORKLOAD -->|"是:OLAP"| BQ["BigQuery"]
  WORKLOAD -->|"否:OLTP/低延遲存取"| MODEL["需要 JOIN、關聯式 Schema<br/>或跨資料列交易?"]
  MODEL -->|"是"| GLOBAL["需要跨區域強一致交易,<br/>且單一寫入執行個體不夠用?"]
  GLOBAL -->|"是"| SPANNER["Spanner"]
  GLOBAL -->|"否"| PG["PostgreSQL 相容,且需要高效能<br/>交易加即時分析?"]
  PG -->|"是"| ALLOY["AlloyDB"]
  PG -->|"否/MySQL/SQL Server"| SQL["Cloud SQL"]
  MODEL -->|"否:文件/Key-Value/寬列"| CLIENT["需要文件查詢、即時監聽、離線同步,<br/>或已有 Datastore API 相依?"]
  CLIENT -->|"是"| FIRESTORE["Firestore"]
  CLIENT -->|"否"| SCALE["大量讀寫能依 Row Key 分布,<br/>且需要低延遲查找或範圍掃描?"]
  SCALE -->|"是"| BIGTABLE["Bigtable"]
SCALE -->|"否"| RECHECK["重新比較資料模型與查詢方式,<br/>先別為想像中的規模過度設計"] 先分清交易與分析,再看資料模型和讀寫方式。若一路走到「重新比較」,可能是需求還不夠清楚, 也可能是 Cloud SQL 或 Firestore 已經夠用;不用為了把圖走完而硬選 Bigtable。
圖沒辦法替你回答的,是「現有系統能改多少」和「用自己的流量跑起來會怎樣」。例如,同樣是大量時序資料,若查詢都在做跨年的彙總,先看 BigQuery;若每次都要依裝置 ID 迅速取回近期紀錄,Bigtable 才更值得試。資料量本身不會決定答案。
定價比較
固定月費很容易因區域、Edition、承諾折扣與產品更新而過時。架構評估時先比較「成本形狀」,再把實際區域、 HA、複本、儲存、備份與網路流量輸入 Google Cloud Pricing Calculator:
| 服務 | 主要計費形狀 | 最常漏算的項目 |
|---|---|---|
| Cloud SQL | 執行個體時間 + 儲存 | HA 備援、Read Replica、備份與外部 IP |
| AlloyDB | Primary/Read Pool vCPU + 儲存與 I/O | 多節點 HA、Read Pool、備份與跨區複寫 |
| Spanner | PU/Node + 儲存 | 多區域配置、備份、網路與閒置容量 |
| Firestore | 文件讀寫刪除 + 儲存與網路 | Listener 重複讀取、索引寫入與跨區流量 |
| Bigtable | 每個 Cluster 的 Node + 儲存 | 複寫會增加 Cluster 與儲存、低利用率節點 |
| BigQuery | 掃描 TiB 或 Slot-hour + 儲存 | SELECT *、未分割資料、串流與資料傳輸 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 18, "nodeSpacing": 18}}}%%
  flowchart TB
  START["確認候選產品與部署區域"] --> MODEL["主要計費模式?"]
  MODEL -->|"配置型"| PROVISIONED["Cloud SQL/AlloyDB/Spanner/Bigtable<br/>Instance/PU/Node 在低流量時仍計費"]
  MODEL -->|"用量型"| USAGE["Firestore/BigQuery<br/>依讀寫、Listener、掃描 TiB 或 Slot 估算"]
  PROVISIONED --> HA["加入 HA、Read Replica、<br/>多 Cluster/多區域倍數"]
  USAGE --> ACCESS["套用真實 Query/存取模式,<br/>不要只看資料容量"]
  HA --> COMMON["加入儲存、備份、網路、監控<br/>與成長緩衝"]
  ACCESS --> COMMON
COMMON --> CALC["用 Calculator/Billing Export 驗證<br/>設定 Budget 與 Alert"] 免費額度適合原型,不應拿來代表正式環境成本。配置型服務最怕忘記 HA 與複本倍數;用量型服務則最怕錯估 Listener、索引寫入或掃描範圍。備考時把重點放在相對成本與管理模型,不必背即時單價。
用情境練習選型
以下都只是在四個選項中找最合理的起點。實際導入前,還是要拿自己的查詢、流量與預算測試。
地端 MySQL 要搬到雲端
電商平台目前用地端 MySQL。團隊想先把資料庫搬到 Google Cloud,應用程式盡量少改。下面哪個服務最適合先評估?
- A. Cloud Spanner
- B. Cloud SQL for MySQL
- C. AlloyDB
- D. Firestore
查看答案
答案:B
Cloud SQL for MySQL 延續現有引擎,通常是改動較少的起點;但版本、擴充功能、連線方式與停機窗口仍要逐項確認。AlloyDB 走 PostgreSQL 路線,Spanner 也不是直接替換 MySQL 的方案。
跨區域帳戶交易
一套跨區域服務會更新帳戶餘額。不同地區的使用者都不能因讀到舊資料而重複扣款,而且交易量會繼續增加。四個選項裡,哪個最值得先評估?
- A. Cloud SQL with Cross-Region Replicas
- B. AlloyDB
- C. Cloud Spanner(多區域配置)
- D. Bigtable
查看答案
答案:C
Spanner 能處理跨區域的強一致交易,也能隨工作負載增加運算容量。Cloud SQL 的跨區域讀取副本採非同步複寫,不能拿來當同步寫入節點。正式選型還得檢查 Spanner 的可用區域配置、交易延遲與成本;它們不會因為選了「多區域」就自動符合業務要求。
行動 App 需要離線使用
行動 App 要讓使用者離線時也能修改個人設定,重新上線後再同步。哪個服務最貼近這個需求?
- A. Cloud SQL
- B. Firestore(Native mode)
- C. Firestore(Datastore mode)
- D. Bigtable
查看答案
答案:B
Firestore Native mode 的用戶端支援離線存取與重新上線後同步,適合先做原型。仍要決定同一份設定在多台裝置被修改時如何處理衝突;離線同步不是替你定義業務規則。Datastore mode 不提供這套行動端體驗。
大量感測器資料要即時查詢
IoT 平台持續寫入大量感測器資料。線上畫面通常指定裝置 ID,讀取它最近一段時間的紀錄;歷史彙總會另外處理。哪個服務最值得先測試?
- A. Cloud SQL
- B. BigQuery
- C. Bigtable
- D. Firestore
查看答案
答案:C
Bigtable 可以把裝置 ID 與時間設計進 Row Key,讓相近紀錄容易一起讀取。先測寫入分布、查詢範圍與 p99 延遲,再決定節點容量。若需求其實是跨設備做長期統計,BigQuery 可能更適合那條分析路徑。
用 SQL 分析 GCS 上的報表資料
銷售資料已經以 Parquet 放在 Cloud Storage。團隊想用 SQL 做月報和季報,應先試哪個服務?
- A. Cloud SQL
- B. Cloud Spanner
- C. Bigtable
- D. BigQuery
查看答案
答案:D
BigQuery 能查詢 Cloud Storage 上的 Parquet 外部表,也能把資料載入原生表格。先用報表查詢比較兩種方式的速度與費用,再決定要不要搬資料;不必為了產生月報,把分析工作塞進交易資料庫。
PostgreSQL 交易與即時分析互相干擾
PostgreSQL 應用的交易和即時分析查詢開始互相搶資源。團隊想先維持同一套資料庫介面,又需要改善分析查詢。四個選項裡,下一步最值得評估什麼?
- A. 升級 Cloud SQL 機器規格
- B. 遷移到 AlloyDB
- C. 遷移到 Cloud Spanner
- D. 加入 BigQuery 做分析
查看答案
答案:B
AlloyDB 提供 PostgreSQL 相容介面與欄式引擎,值得用實際查詢試跑。不過,先檢查慢查詢、索引與 Cloud SQL 容量;若瓶頸只是配置不足,升級規格也可能合理。遷移前還得確認擴充套件、SQL 行為和費用,不能把「相容」當成免測試。
跨區域遊戲道具交易
遊戲開放不同地區玩家互相交易道具。現有資料是關聯式的;每筆交易都要同時更新買賣雙方的餘額與道具持有紀錄,且各地不能看到互相矛盾的結果。哪個服務值得先評估?
- A. Firestore
- B. Cloud SQL
- C. Cloud Spanner
- D. Memorystore for Redis
查看答案
答案:C
Spanner 適合評估這類跨區域、跨多筆關聯資料的交易。它不是因為「全球遊戲」四個字就必選:交易量、玩家所在區域和一致性範圍,都會影響是否值得承擔多區域延遲與費用。Memorystore 可以加速熱門讀取,但不該是道具歸屬的唯一真實來源。
線上服務按使用者讀取特徵
模型服務每次收到 user_id,都要讀取該使用者的一組特徵值;資料量大、請求頻繁,也需要穩定的線上延遲。這不是找相似向量的搜尋題。哪個服務最值得先測?
- A. BigQuery
- B. Cloud SQL
- C. Bigtable
- D. Firestore
查看答案
答案:C
Bigtable 可用 user_id 作為 Row Key,先測單一使用者特徵的讀取量與延遲。資料更新若集中在少數使用者,還要留意熱點;如果需求改成「找最相似的向量」,就要重新選工具,不能把 Key 查找和向量搜尋混為一談。
幾個容易選錯的地方
把 BigQuery 當成每次 API 請求的資料庫
假設登入驗證、購物車更新都要先查 BigQuery:查詢能跑,不代表延遲、併發量和費用適合這條路。這類資料通常應留在交易資料庫,報表再從事件或批次資料進 BigQuery。真正要確認的是資料多久同步一次,而不是「能不能寫 SQL」。
只看資料量就選 Bigtable
「目前 50 GB,所以不能用 Bigtable」和「未來會有 50 TB,所以現在就要用 Bigtable」都太快下結論。先列出線上查詢會不會依 Row Key 找資料、寫入能否分散,再把節點與複寫費用算進去。若資料量和流量都不高,Cloud SQL 或 Firestore 可能更省事;若只是快取,還可以評估 Memorystore。
把 Cloud SQL 讀取副本當成同步寫入節點
跨區域讀取副本能讓部分讀取靠近使用者,但寫入仍回到主執行個體,而且副本採非同步複寫。若庫存或餘額不能讀到舊值,就要設計讀取路徑與一致性策略;若還需要跨區域的關聯式交易,再評估 Spanner。Cloud SQL 不是不能服務跨國使用者,關鍵是能否接受這些限制。
Firestore 的時序寫入碰到熱點
如果感測器資料使用循序文件 ID,或在大量文件上索引持續增加的時間欄位,寫入可能集中到同一小段 Key 範圍。先檢查文件 ID、索引與流量爬升方式;若線上查詢主要是「某裝置最近一段時間的紀錄」,再用這個模式測 Bigtable。不是 IoT 資料一律要搬家。
還沒量需求就上 Spanner
Spanner 的跨區域一致性與水平擴展很有用,但也要承擔資料模型設計、區域間延遲和配置成本。如果現有 Cloud SQL 已滿足交易量與可用性要求,不必為尚未出現的瓶頸提前遷移;反過來說,若跨區域強一致交易是明確需求,也別只因目前資料量小就排除 Spanner。
快速回顧:先比什麼
| 你的情況 | 先評估 | 接著確認什麼 |
|---|---|---|
| 既有 MySQL/PostgreSQL 要搬遷 | Cloud SQL | 版本、相容性與停機窗口 |
| PostgreSQL 同時跑交易與即時分析 | AlloyDB、Cloud SQL | 慢查詢能否先改善;欄式引擎是否有幫助 |
| 跨區域的關聯式交易需要強一致性 | Spanner | 區域配置、交易延遲與費用 |
| 行動端要離線存取與即時同步 | Firestore Native mode | 衝突處理、索引與安全規則 |
| 大量資料依 Key 查找或範圍掃描 | Bigtable | Row Key 分布、p99 延遲與節點成本 |
| 大量歷史資料要做 SQL 分析與報表 | BigQuery | 資料更新頻率、查詢成本與儲存位置 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
這張表沒有把每個產品的所有用途列完。當需求橫跨線上交易與歷史分析時,通常要比較兩條資料路徑,而不是硬找一個服務全部包辦。
進階:混合架構模式
實務上很少只用一個資料庫,下面是幾種常見的混合架構:
電商平台
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  USER["使用者/前端"] --> API["電商 API"]
  API --> SQL["Cloud SQL/AlloyDB<br/>訂單、付款、商品庫存"]
  API --> CACHE["Memorystore<br/>商品快取、Session"]
  API --> FIRESTORE["Firestore<br/>偏好、購物車、即時狀態"]
  SQL -. "CDC/批次" .-> PIPELINE["Pub/Sub/Dataflow"]
  FIRESTORE -. "事件/匯出" .-> PIPELINE
  PIPELINE --> BQ["BigQuery<br/>銷售分析、漏斗與報表"]
  BQ --> BI["BI/營運決策"]
訂單與庫存留在關聯式真實來源;Memorystore 只負責可重建的快取與 Session;偏好或即時文件狀態可用 Firestore。分析資料另走 CDC、事件或批次管線進 BigQuery,不讓報表掃描干擾線上交易。
全球遊戲
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  PLAYER["全球玩家"] --> REGION["就近 Region 的遊戲服務"]
  REGION --> SPANNER["Spanner<br/>帳號、道具、持久排名真實來源"]
  REGION --> CACHE["Memorystore<br/>Session、熱門排行與短期狀態"]
  REGION --> EVENTS["Pub/Sub"]
  EVENTS --> BIGTABLE["Bigtable<br/>遊戲事件與近期行為查詢"]
  EVENTS --> DATAFLOW["Dataflow"]
  DATAFLOW --> BQ["BigQuery<br/>玩家分析與 A/B 測試"]
  SPANNER -. "Change Streams" .-> DATAFLOW
Spanner 保存需要全球一致性的持久資料,快取服務熱門讀取但不是唯一來源;高頻事件先進 Pub/Sub, Bigtable 支援低延遲行為查詢,BigQuery 則承接歷史分析與實驗結果。
IoT 平台
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
flowchart TB
  SENSOR["大量感測器"] --> PUBSUB["Pub/Sub<br/>解耦與緩衝"]
  PUBSUB --> DATAFLOW["Dataflow<br/>驗證、Window、聚合與路由"]
  DATAFLOW --> BIGTABLE["Bigtable<br/>近期時序資料與低延遲查詢"]
  DATAFLOW --> BQ["BigQuery<br/>長期歷史分析與模型訓練"]
  OPS["裝置管理 API"] --> SQL["Cloud SQL<br/>裝置、租戶、韌體與設定"]
  SQL -. "裝置 Metadata" .-> DATAFLOW
  BIGTABLE --> DASH["即時監控/告警"]
  BQ --> REPORT["容量規劃/趨勢分析"]
感測器資料先經 Pub/Sub 與 Dataflow 分流:近期低延遲查詢進 Bigtable,長期掃描與模型訓練進 BigQuery。裝置與租戶設定是低頻關聯式資料,留在 Cloud SQL,避免把控制面與遙測洪流混在一起。
總結
選資料庫時,先說清楚資料怎麼寫、怎麼查,以及查詢要多快。大量掃描和報表分析可以先評估 BigQuery;逐筆更新、訂單交易等工作負載,則要看交易與一致性需求。別只憑「有沒有 SQL」決定:文件資料、時序資料與關聯式資料,即使資料量相近,適合的模型也可能不同。
需求輪廓明確後,再用下面的方向縮小範圍:
- 需要跨區域強一致的關聯式交易:評估 Spanner。
- 以 PostgreSQL 相容性與較高效能需求為主:比較 AlloyDB 和 Cloud SQL。
- 現有關聯式資料庫遷移、一般 OLTP:先看 Cloud SQL。
- 行動端同步與文件資料:評估 Firestore。
- 大量鍵值或時序資料,需要低延遲存取:評估 Bigtable。
最後,把候選服務放到同一組實際查詢、延遲目標與預算下比較。這一步往往比背產品定位更快找出不合適的選項。
延伸閱讀
- Cloud SQL 入門:版本、HA、連線與備份怎麼選 — 關聯式資料庫的設定與維運
- Firestore 入門:文件資料、即時更新與存取規則 — 文件資料庫與用戶端同步
- Cloud Bigtable 入門:大量資料的 Row Key 怎麼設計? — 大量鍵值資料的讀寫設計
- Cloud Spanner 深度解析 — 全球分散式關聯資料庫
- BigQuery 查詢與成本:分區、叢集怎麼用? — 分析查詢與費用控制
- Memorystore 入門 — 托管快取服務
- 儲存策略 — GCP 儲存服務全方位比較
- ACE 認證準備 — 考試準備攻略
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
GCP 資料該放哪?從存取方式選儲存服務
照片、訂單和事件紀錄不必擠在同一種資料庫。從讀寫方式、復原需求與帳單,選 Cloud Storage、Cloud SQL 等服務。
PCA 雲端架構師之旅 08 — GCP 儲存服務選擇
資料的讀寫需求已經列好了,下一步怎麼選服務?沿著檔案、交易、文件、分析等路徑縮小範圍。
Cloud Bigtable 入門:大量資料的 Row Key 怎麼設計?
時序或感測器資料量很大時,Bigtable 適合嗎?從 Row Key、叢集容量與資料保留策略看起。