
十種 GCP 架構模式:先看需求,再挑組合
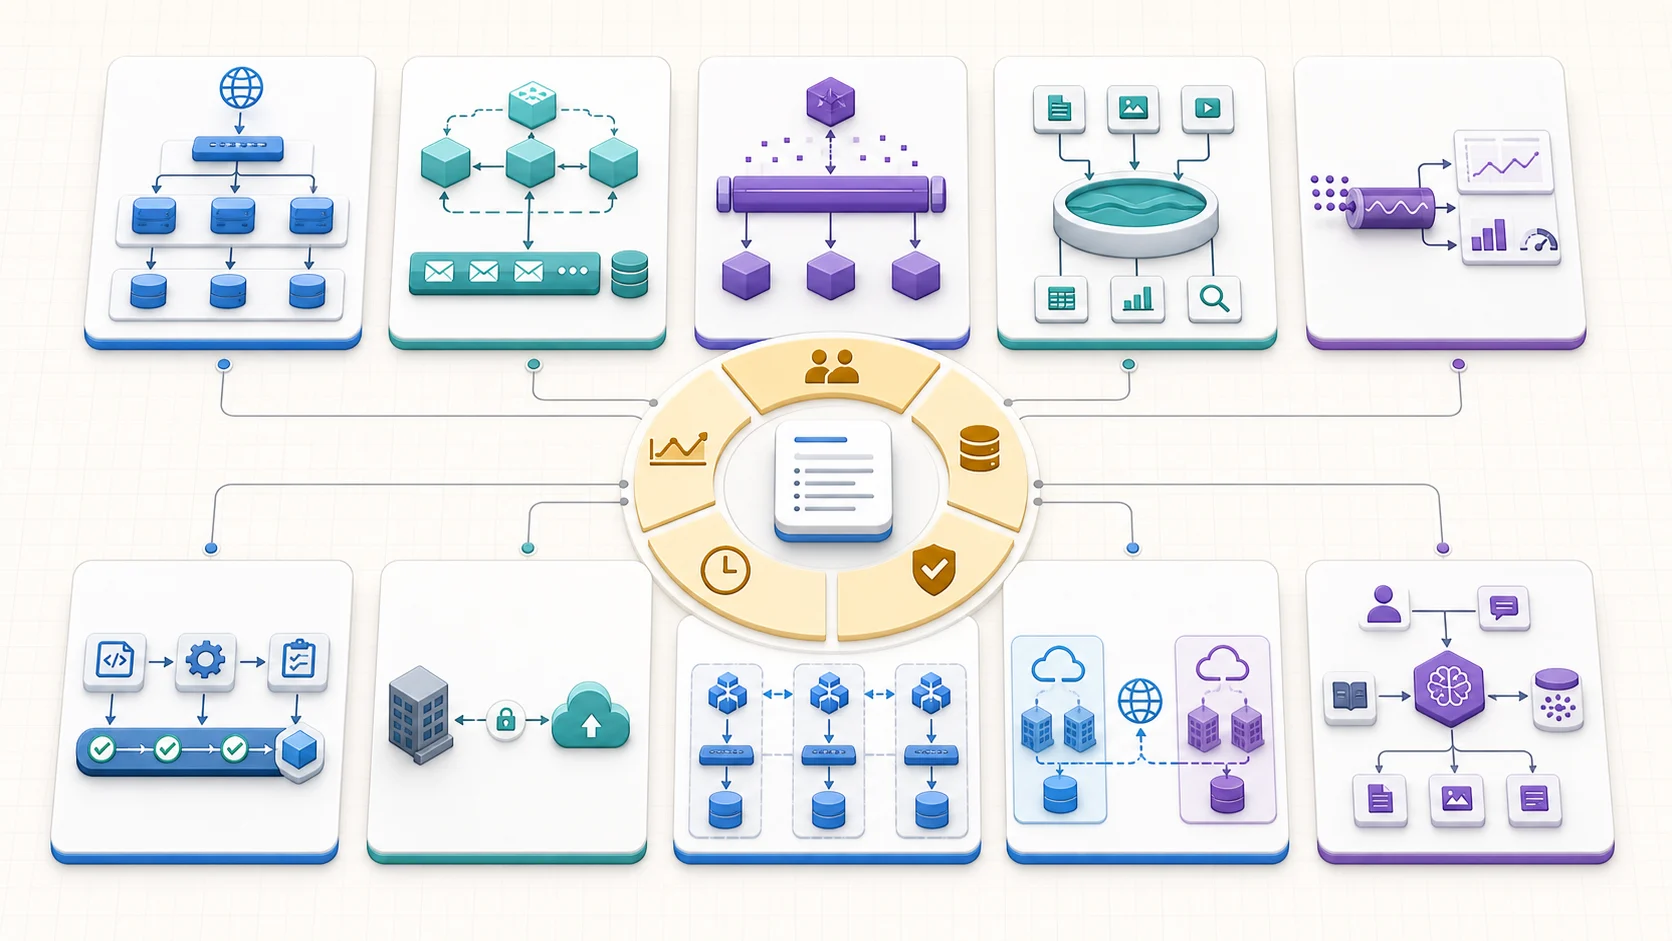
架構模式比較像可組合的積木庫,不是十張互斥菜單。中央先用流量形狀、資料形狀、延遲、可靠度與團隊能力描述問題,再挑三層 Web、微服務、事件、資料、交付、混合雲、HA/DR 或 AI 等模式;一個真實系統通常會同時組合其中好幾塊。
前言
準備畫架構圖時,很容易從「要用哪些 GCP 服務」開始。但同一個服務可以出現在好幾種架構裡;先問流量怎麼進來、資料要怎麼存、故障能容忍多久,組合才有依據。
下面整理十種常見模式,每種都附上適用情境、架構圖、主要決策和成本來源。真實系統常會混用好幾種,讀的時候可以拿手上的專案對照:哪些部分已經有了,哪些其實不需要。
模式一:Web 三層架構
場景描述
這是最經典、最常見的架構模式,大多數 Web 應用都適合:公司官網、電商平台、SaaS 產品後台。前端接使用者請求,中間層處理商業邏輯,後端負責存資料。
在 GCP 上,可以用 Cloud Run 取代傳統的 VM,好處是自動擴縮容、按用量計費。
架構圖
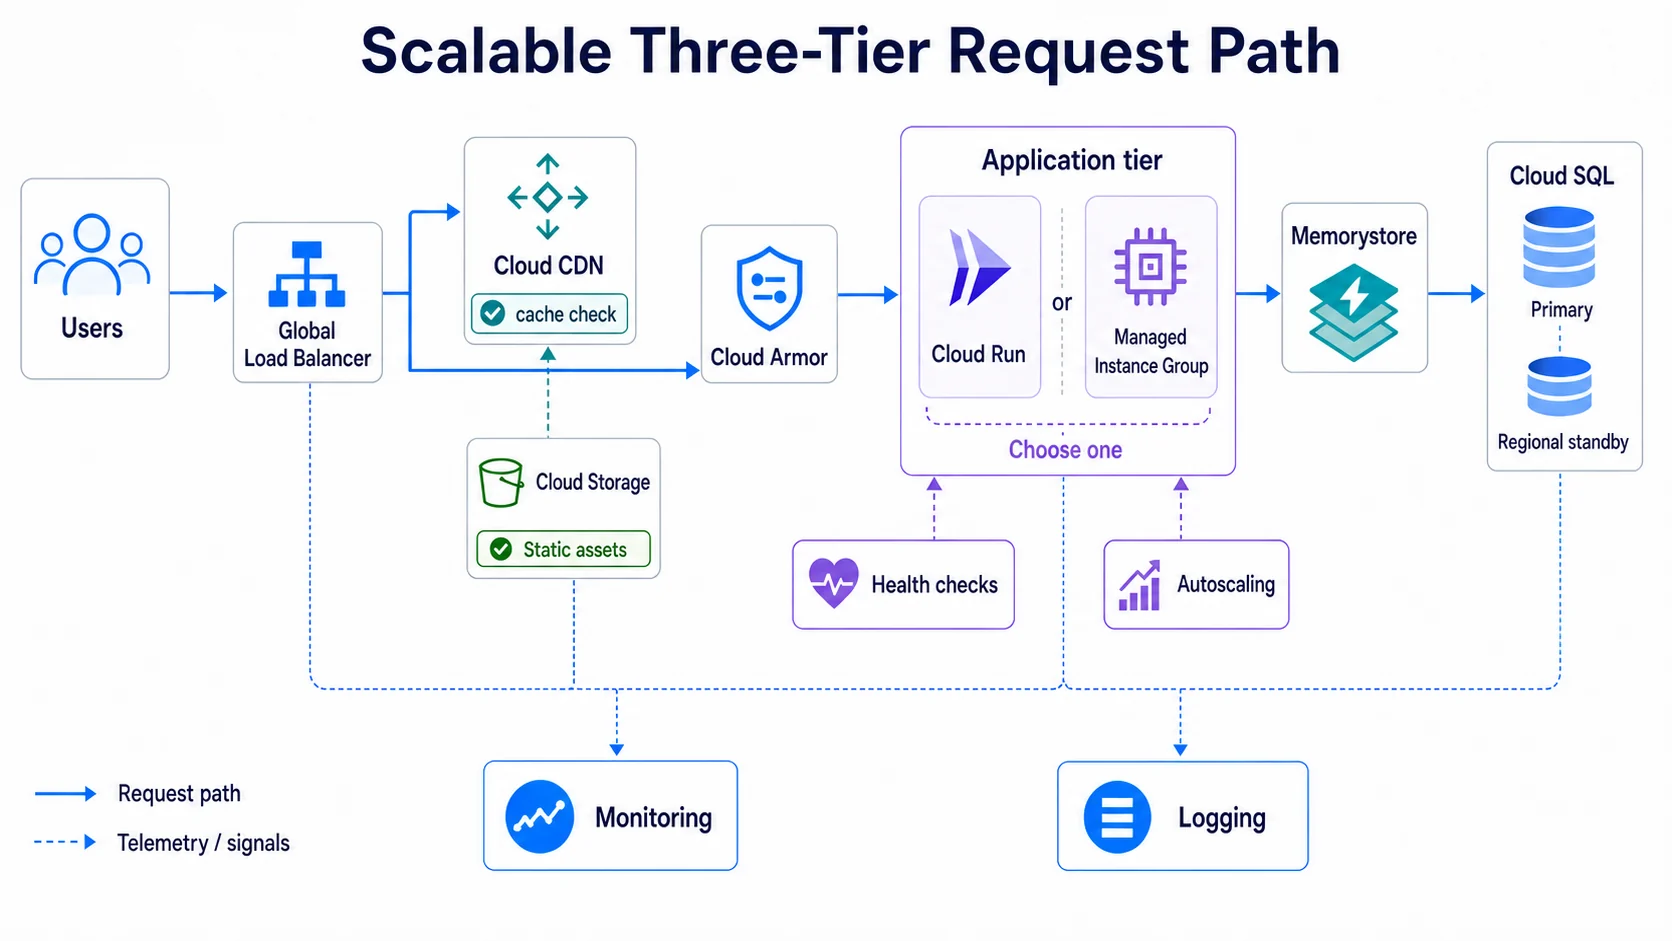
先把靜態與動態路徑分開:Cloud Storage 的靜態內容由 CDN 快取,動態流量經 Cloud Armor 進入應用層;Cloud Run 與 MIG 是依工作負載選擇的替代方案,不是每套架構都要同時部署。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 28, "nodeSpacing": 22}}}%%
  flowchart TB
  USER["使用者"] --> LB["全域外部 Application Load Balancer<br/>TLS 終止、Anycast IP"]
  LB --> ARMOR["Cloud Armor<br/>WAF 與流量防護"]
  ARMOR --> ROUTE{"內容路徑"}
  ROUTE -->|"靜態內容"| CDN["Cloud CDN<br/>邊緣快取"]
  CDN -->|"Cache miss"| STATIC["Cloud Storage<br/>靜態資源"]
  ROUTE -->|"動態請求"| APP["Cloud Run<br/>Web/API 應用層"]
  APP --> CACHE["Memorystore<br/>快取/短期狀態"]
  APP --> SQL["Cloud SQL HA<br/>關聯式交易資料"]
APP --> UPLOAD["Cloud Storage<br/>使用者上傳"] 負載平衡器是共同入口;Cloud CDN 只處理可快取內容,動態請求才進 Cloud Run。應用層保持無狀態, Session 與共享資料放進託管儲存,才能安全地水平擴展。
使用的 GCP 服務
| 服務 | 角色 | 替代方案 |
|---|---|---|
| Global external Application Load Balancer | 流量分配、TLS 終止 | — |
| Cloud Armor | WAF 防護、DDoS 防禦 | — |
| Cloud CDN | 靜態資源快取 | — |
| Cloud Run | 前端 + API 無伺服器運算 | GKE / App Engine |
| Cloud SQL (PostgreSQL) | 關聯式資料庫 | AlloyDB / Cloud Spanner |
| Memorystore (Redis) | 快取、Session 管理 | — |
| Cloud Storage | 靜態檔案儲存 | — |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
關鍵設計決策
- 用 SLO 決定
min-instances:設為 0 可降低閒置成本;保留最小執行個體可降低冷啟動延遲。不要在量測前固定寫死數量 - Cloud SQL 開啟 HA:同一區域內跨 Zone 自動容錯;跨區域韌性則要另設非同步副本與可演練的提升流程,兩者不是同一件事
- 私網與資料庫連線分開設計:Cloud Run 可用 Direct VPC egress 或 Serverless VPC Access 連入 VPC;再搭配 Cloud SQL Connectors、私有 IP、連線池與最小權限
- Global Load Balancer 使用 Anycast IP:單一 IP 全球接入,自動路由到最近的後端
成本估算等級
$$ — 中等成本
| 主要驅動因素 | 控制方式 |
|---|---|
| Cloud Run 執行個體時間、CPU/記憶體與請求量 | 調整並行度、最小/最大執行個體與資源尺寸 |
| Cloud SQL 機型、HA、儲存與備份 | 從實際連線數、IOPS 與 SLO 選型 |
| 負載平衡、CDN 與網路流量 | 提高快取命中率,避免不必要的跨區流量 |
| Memorystore 容量與拓撲 | 只快取高價值資料,設定淘汰與失效策略 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
適合場景 & 不適合場景
| 適合 | 不適合 |
|---|---|
| 中小型 Web 應用 | 超低延遲需求(< 10ms) |
| 快速原型開發 | 超高寫入吞吐量 |
| 流量有波動的網站 | 無法處理重連與外部狀態的長連線 |
| 團隊較小、不想管 K8s | 複雜的有狀態服務 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
模式二:微服務架構
場景描述
當系統功能越來越複雜,不同業務模組需要獨立交付、擴展與承擔故障時,單體應用可能變成協作瓶頸。微服務架構把系統沿著清楚的業務邊界拆成獨立服務,每個團隊能各自部署與擴展;代價則是跨服務通訊、資料一致性與可觀測性都更難。
架構圖
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 30, "nodeSpacing": 20}}}%%
  flowchart TB
  USER["使用者"] --> EDGE["全域負載平衡器"] --> GATEWAY["API Gateway/Apigee<br/>驗證、配額、路由"]
  GATEWAY -->|"同步 API"| USERS["使用者服務<br/>Cloud Run"]
  GATEWAY -->|"同步 API"| ORDERS["訂單服務<br/>Cloud Run 或 GKE"]
  USERS --> USERSDB[("使用者資料庫<br/>Cloud SQL")]
  ORDERS --> ORDERSDB[("訂單資料庫<br/>Spanner/Cloud SQL")]
  ORDERS -->|"發布 OrderCreated"| BUS["Pub/Sub<br/>非同步事件匯流排"]
  BUS --> NOTIFY["通知服務<br/>Cloud Run"]
  NOTIFY --> NOTIFYDB[("通知狀態<br/>Firestore")]
  USERS -. "Trace/Log/Metric" .-> OBS["Google Cloud Observability"]
  ORDERS -. "Trace/Log/Metric" .-> OBS
NOTIFY -. "Trace/Log/Metric" .-> OBS 需要立即回答的操作才走同步 API;後續副作用用事件解耦。每個服務擁有自己的資料模型,跨服務交易則要用 Saga、Outbox、冪等消費與補償流程處理,不能靠跨庫 JOIN 假裝仍是單體。
使用的 GCP 服務
| 服務 | 角色 | 替代方案 |
|---|---|---|
| Cloud Run | 無狀態微服務 | App Engine Flex |
| GKE | 需要 Kubernetes 控制面的複雜服務 | — |
| Cloud Pub/Sub | 非同步訊息通訊 | — |
| API Gateway / Apigee | API 管理、流量控制 | Cloud Endpoints |
| Cloud SQL / Spanner | 各服務獨立資料庫 | AlloyDB |
| Firestore | NoSQL 文件資料庫 | Bigtable |
| Cloud Trace | 分散式追蹤 | — |
| Cloud Logging | 集中日誌 | — |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
關鍵設計決策
- Database per Service:每個微服務擁有自己的資料庫,避免資料耦合。使用者服務用 Cloud SQL,通知服務用 Firestore,選擇最適合的儲存方案
- 非同步優先:服務間優先使用 Pub/Sub 非同步通訊,只有需要即時回應的才用 HTTP/gRPC 同步呼叫
- Cloud Run vs GKE:一般 HTTP/事件服務先評估 Cloud Run;需要 Kubernetes API、DaemonSet、複雜網路/排程或既有平台標準時再選 GKE。有狀態不等於一定要自管在 GKE
- Observability 三支柱:Cloud Trace(追蹤)、Cloud Logging(日誌)、Cloud Monitoring(指標)缺一不可
成本估算等級
$$$ — 中高成本
微服務數量越多,基礎設施與「每個服務都要具備」的交付、監控、安全及待命容量成本越高。評估時要把平台團隊與事故協調成本一起算進去,不能只看運算帳單。
適合場景 & 不適合場景
| 適合 | 不適合 |
|---|---|
| 有清楚業務邊界與獨立生命週期 | 小型專案或 MVP |
| 多團隊並行開發 | 團隊無法承擔分散式系統維運 |
| 各模組需要獨立擴展 | 初期業務邏輯不明確 |
| 已有容器化經驗 | 沒有 DevOps 經驗 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
延伸閱讀:GKE 入門
模式三:事件驅動架構
場景描述
使用者上傳一張圖片,系統要做的事有:壓縮圖片、產生縮圖、寫入資料庫、發通知。這幾步彼此獨立,沒必要塞在同一個請求裡做完。事件驅動架構用「事件」把各步驟串起來,真正做到解耦,也更有彈性。
架構圖
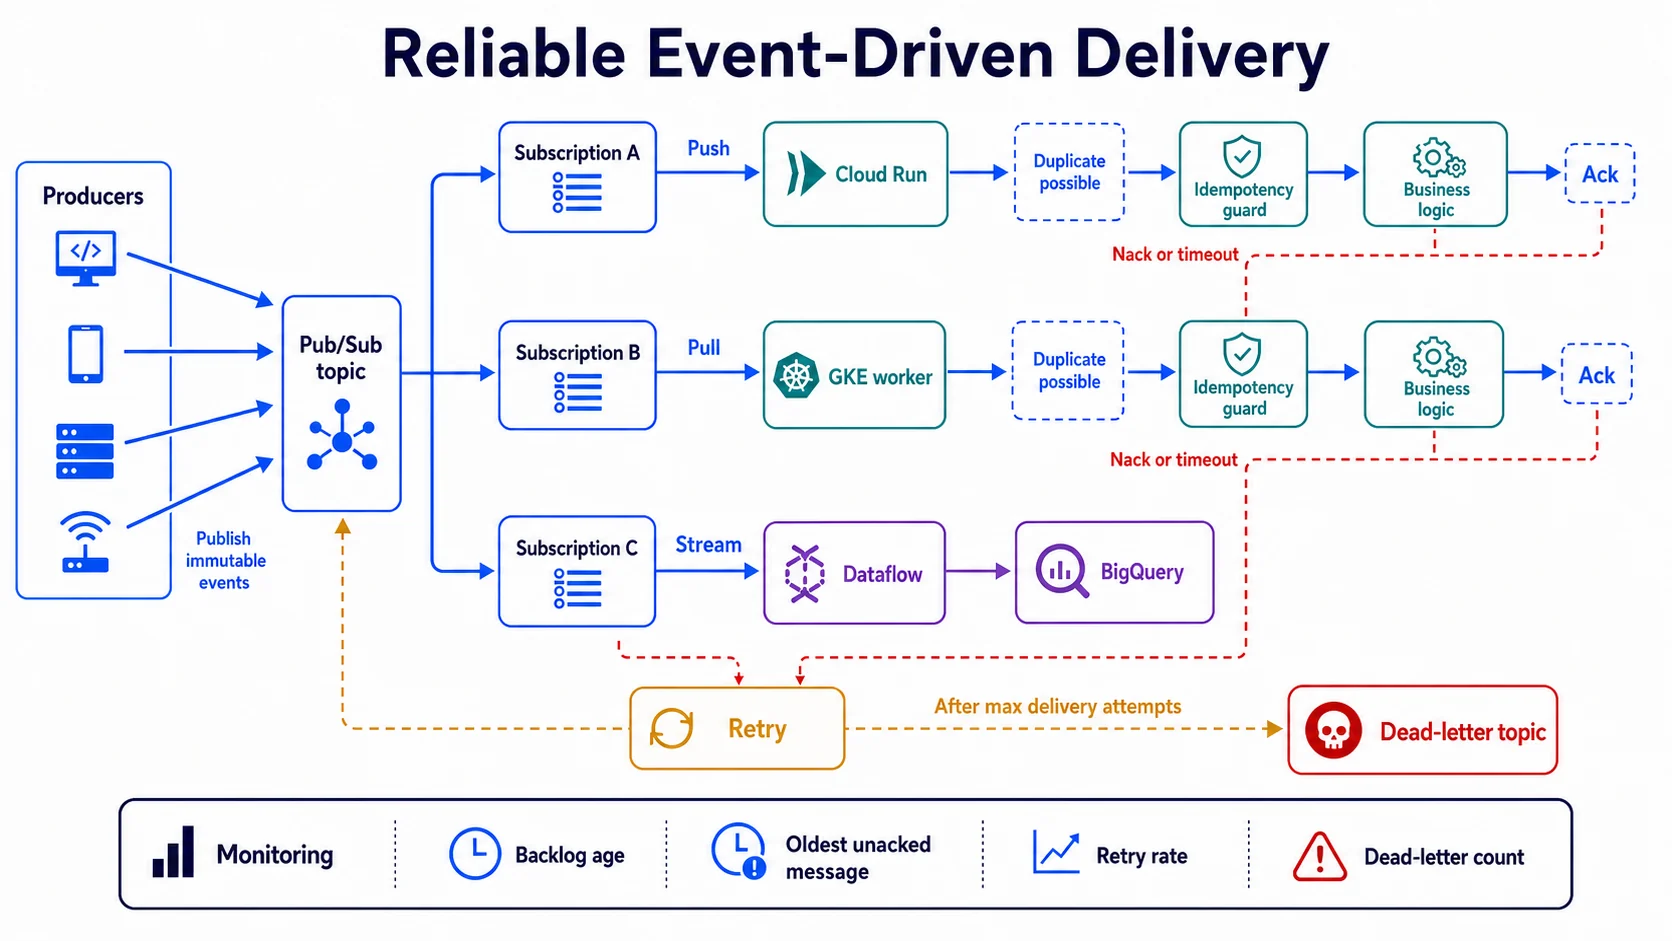
事件系統要把「可能重送」當正常情況:消費者先以事件 ID 或業務鍵去重,再執行可冪等的寫入;成功後才 Ack,持續失敗的訊息則進入 Dead-letter Queue,避免卡住主流程。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 28, "nodeSpacing": 18}}}%%
  flowchart TB
  UPLOAD["使用者上傳圖片"] --> RAW["Cloud Storage<br/>原始圖片"]
  RAW --> EVENTARC["Eventarc<br/>路由 Object Finalized 事件"]
  EVENTARC --> COMPRESS["Cloud Run function<br/>壓縮圖片"]
  EVENTARC --> THUMB["Cloud Run service/function<br/>產生縮圖"]
  EVENTARC --> RECORD["Cloud Run function<br/>寫入媒體紀錄"]
  COMPRESS --> DERIVED["Cloud Storage<br/>衍生檔案"]
  THUMB --> DERIVED
  RECORD --> META[("Firestore<br/>事件 ID 與處理狀態")]
  RECORD -->|"發布 MediaReady"| TOPIC["Pub/Sub<br/>通知事件"]
  TOPIC --> MAIL["通知消費者<br/>寄送 Email"]
  COMPRESS -. "重試耗盡" .-> DLQ["Dead-letter topic<br/>告警與人工重送"]
  THUMB -. "重試耗盡" .-> DLQ
MAIL -. "重試耗盡" .-> DLQ Eventarc 負責把來源事件送到處理器,Pub/Sub 負責可重試的後續通知。每個消費者先檢查事件 ID,寫入採冪等或 可補償設計;重試耗盡才進死信主題,不把失敗訊息悄悄丟掉。
使用的 GCP 服務
| 服務 | 角色 | 替代方案 |
|---|---|---|
| Cloud Run functions | 事件處理函式 | Cloud Run service |
| Eventarc | 事件路由 | — |
| Cloud Pub/Sub | 事件匯流排 | — |
| Cloud Storage | 事件來源 + 儲存 | — |
| Firestore | 事件驅動的 NoSQL 儲存 | — |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
關鍵設計決策
- Eventarc vs 直接觸發:Eventarc 提供統一的事件路由,比直接用 Cloud Storage trigger 更靈活、更好管理
- 冪等性設計:事件可能重複投遞,每個函式都必須設計成冪等的(執行多次結果相同)
- Dead Letter Topic:設定死信主題,處理失敗的事件不會永久遺失
- 依觸發類型檢查逾時:Cloud Run functions 的 HTTP、排程/Task queue 與事件觸發有不同上限;事件驅動函式不是 60 分鐘。更久的工作拆成工作流、Cloud Run jobs 或批次服務
成本估算等級
$ — 低成本
按呼叫次數計費,沒有事件就不花錢。流量不確定、或波峰波谷很明顯的場景特別適合。
| 主要驅動因素 | 控制方式 |
|---|---|
| 函式執行時間、CPU/記憶體與呼叫量 | 縮短處理路徑、批次化、限制最大執行個體 |
| Pub/Sub 吞吐、保留期與跨區流量 | 只保留必要時間,壓縮事件且不要塞大型 payload |
| Storage/Firestore 容量與操作次數 | 設生命週期、避免熱點與重複寫入 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
適合場景 & 不適合場景
| 適合 | 不適合 |
|---|---|
| 非同步處理(圖片、影片、文件) | 需要即時回應的 API |
| IoT 資料蒐集 | 複雜的交易流程 |
| 流量波動大的工作負載 | 需要嚴格順序處理 |
| 自動化工作流程 | 長時間運行的批次工作 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
模式四:資料湖架構
場景描述
企業常有大量結構化、非結構化資料散落在不同系統。資料湖架構先把所有原始資料集中存起來,再用 ETL 管線清洗、轉換,最後載入分析引擎,讓商業決策有資料可依。
架構圖
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 28, "nodeSpacing": 18}}}%%
  flowchart TB
  SOURCES["應用資料庫<br/>IoT/SaaS/檔案"] --> INGEST["批次或串流擷取"]
  INGEST --> RAW["Cloud Storage<br/>Raw:不可變原始資料"]
  RAW --> ENGINE["Dataflow 或<br/>Managed Service<br/>for Apache Spark<br/>(原 Dataproc)<br/>驗證、清洗、轉換"]
  ENGINE --> PROCESSED["Cloud Storage<br/>Processed:標準化資料"]
  PROCESSED --> CURATED["Curated data products<br/>品質與業務定義已驗證"]
  CURATED --> BQ["BigQuery<br/>分區、叢集與語意模型"]
  BQ --> BI["Looker/Data Studio<br/>(原 Looker Studio)<br/>分析與決策"]
  CATALOG["Knowledge Catalog<br/>目錄、血緣、治理與品質"] -. "治理所有資料資產" .-> RAW
  CATALOG -.-> PROCESSED
  CATALOG -.-> CURATED
CATALOG -.-> BQ Raw 層保留可重播的事實,Processed 層統一格式,Curated 層才承諾商業語意與品質。目錄、血緣、敏感資料政策 與資料品質橫跨各層,不應等到 BI 報表出錯才補。
使用的 GCP 服務
| 服務 | 角色 | 替代方案 |
|---|---|---|
| Cloud Storage | 資料湖儲存(原始/處理後) | — |
| Dataflow | 串流 + 批次 ETL 處理 | Managed Service for Apache Spark |
| BigQuery | 資料倉儲、SQL 分析 | — |
| Looker / Data Studio | 商業智慧視覺化 | — |
| Knowledge Catalog | 資料目錄、血緣與治理 | — |
| Sensitive Data Protection | 敏感資料偵測與遮罩 | — |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
關鍵設計決策
- 三層資料分區:raw(原始)→ processed(清洗後)→ curated(商業可用),每層有不同的存取權限
- Cloud Storage 生命週期:依實際讀取頻率、最短儲存期、法規與重播需求設定儲存類別轉換,別把 30/90 天當通用答案
- BigQuery 分區表:依日期分區,查詢時只掃描需要的分區,大幅降低費用
- Dataflow vs Managed Service for Apache Spark:新專案用 Dataflow(託管式、自動擴展),已有 Spark 程式碼則用後者
成本估算等級
$$$ — 中高成本
| 主要驅動因素 | 控制方式 |
|---|---|
| Storage 容量、儲存類別、操作與取回 | 生命週期、壓縮、刪除重複資料 |
| Dataflow/Managed Service for Apache Spark 運算時間與 Shuffle | 自動擴展、批次尺寸、避免資料傾斜 |
| BigQuery 掃描量或 Slot、儲存與串流寫入 | 分區、叢集、物化結果與查詢配額 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
適合場景 & 不適合場景
| 適合 | 不適合 |
|---|---|
| 多來源資料整合 | 資料量很小(< 100 GB) |
| 歷史資料分析 | 需要即時查詢(< 1 秒) |
| 機器學習資料準備 | 只有單一資料來源 |
| 合規性需求(資料留存) | 預算極為有限 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
延伸閱讀:BigQuery 資料分析 | Dataflow 與 Managed Service for Apache Spark(原 Dataproc)
模式五:即時串流分析
場景描述
電商平台要即時盯詐騙交易、遊戲公司要即時追玩家行為、物聯網系統要即時抓出異常的感測器。這些場景都得在資料進來的「當下」就分析、反應,不能等到隔天跑批次報表。
架構圖
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 28, "nodeSpacing": 20}}}%%
  flowchart LR
  EVENTS["App 事件<br/>IoT 遙測<br/>API/系統紀錄"] --> PUBSUB["Pub/Sub<br/>耐久緩衝與背壓"]
  PUBSUB --> DATAFLOW["Dataflow Streaming<br/>事件時間、Watermark、Window<br/>去重與狀態處理"]
  DATAFLOW -->|"分析與歷史查詢"| BQ["BigQuery<br/>Storage Write API<br/>(gRPC)"]
  DATAFLOW -->|"Key-based 低延遲查詢"| BT["Bigtable<br/>即時服務狀態"]
  DATAFLOW -->|"異常事件"| ALERT["告警 Topic/服務<br/>通知與自動處置"]
  BQ --> LOOKER["Looker<br/>即時營運儀表板"]
  DATAFLOW -. "處理延遲、Backlog、錯誤" .-> MON["Cloud Monitoring"]
PUBSUB -. "未 Ack 訊息與最舊年齡" .-> MON Pub/Sub 吸收突發流量,Dataflow 依事件時間而非到達時間做視窗聚合。BigQuery 回答分析問題,Bigtable 服務低延遲 Key 查詢;兩者角色不同,不要為了「即時」就把資料全部寫兩份。
使用的 GCP 服務
| 服務 | 角色 | 替代方案 |
|---|---|---|
| Cloud Pub/Sub | 訊息接收、緩衝 | — |
| Dataflow (Streaming) | 即時串流處理 | — |
| BigQuery Storage Write API (gRPC) | 即時分析查詢 | — |
| Bigtable | 低延遲時序資料 | — |
| Data Studio | 即時儀表板 | Looker |
| Cloud Monitoring | 告警、異常偵測 | — |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
關鍵設計決策
- Pub/Sub 作為緩衝:即使 Dataflow 暫時無法處理,未 Ack 訊息仍可依訂閱設定保留;31 天是可設定上限,不是預設值,也不能取代來源重播與 DR
- Dataflow Windowing:使用滑動視窗(Sliding Window)做即時聚合,例如「過去 5 分鐘的平均值」
- BigQuery Storage Write API (gRPC):新串流工作負載優先評估 Storage Write API (gRPC);預設 Stream 是 at-least-once,需要 exactly-once 時使用應用建立的 Stream 與 Offset
- Bigtable 用於低延遲:需要毫秒級讀取的場景(如即時推薦),用 Bigtable 取代 BigQuery
成本估算等級
$$$$ — 高成本
串流處理通常要持續維持運算與緩衝容量,成本取決於事件量、處理複雜度、狀態/Shuffle、Pub/Sub 保留、BigQuery 寫入與查詢,以及 Bigtable 節點。先從業務可接受的新鮮度反推,不需要秒級就用微批次或批次。
適合場景 & 不適合場景
| 適合 | 不適合 |
|---|---|
| 即時詐騙偵測 | 可以等隔天出報表的分析 |
| IoT 即時監控 | 資料量很小的系統 |
| 即時推薦系統 | 預算有限的新創 |
| 遊戲即時排行榜 | 資料不需要即時處理 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
模式六:CI/CD Pipeline
場景描述
開發團隊每天都在提交程式碼,要是每次部署都得手動操作,不只浪費時間,還很容易出錯。CI/CD Pipeline 把從提交程式碼到上生產的整段流程都自動化:自動測試、自動建容器映像、自動部署到目標環境。
架構圖
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 28, "nodeSpacing": 18}}}%%
  flowchart TB
  COMMIT["Git push/Pull request"] --> CI["Cloud Build<br/>Lint、Test、Build、SBOM、Scan"]
  CI -->|"通過"| AR["Artifact Registry<br/>以 Digest 鎖定不可變映像"]
  CI -->|"失敗"| STOP["阻擋合併/通知開發者"]
  AR --> POLICY["Binary Authorization/<br/>政策檢查"]
  POLICY -->|"允許"| STAGE["Cloud Deploy<br/>部署 Staging"]
  POLICY -->|"拒絕"| STOP
  STAGE --> VERIFY["整合測試、SLO 與安全驗證"]
  VERIFY -->|"通過+核准"| CANARY["Cloud Run/GKE<br/>Production Canary"]
  VERIFY -->|"失敗"| STOP
  CANARY --> OBSERVE{"錯誤率、延遲<br/>與關鍵指標健康?"}
  OBSERVE -->|"是"| PROMOTE["逐步提高流量至 100%"]
OBSERVE -->|"否"| ROLLBACK["停止推進/回滾舊版本"] 同一個 Artifact Digest 從 Staging 推進到 Production,避免每個環境重新建置出不同成品。金絲雀比例不是固定 10%;應依流量、風險、觀察窗與可回滾性設計自動或人工 Gate。
使用的 GCP 服務
| 服務 | 角色 | 替代方案 |
|---|---|---|
| Cloud Build | CI/CD 執行引擎 | GitHub Actions |
| Artifact Registry | 容器映像、套件儲存 | — |
| Cloud Deploy | 持續交付管線 | — |
| Cloud Run / GKE | 部署目標 | — |
| Binary Authorization | 映像簽章驗證 | — |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
關鍵設計決策
- Artifact Registry 取代 Container Registry:Container Registry 已於 2025 年正式關閉(停寫、停讀),新專案一律使用 Artifact Registry
- Cloud Deploy 漸進式部署:Cloud Run services/worker pools 與 GKE 可做金絲雀;比例與階段應由風險、流量和觀察窗決定,Cloud Run jobs 不適用流量金絲雀
- Binary Authorization:只允許經過簽章的映像部署到生產環境,防止未經測試的程式碼上線
- 多環境策略:dev → staging → prod,每個環境獨立的 GCP 專案,透過 IAM 控管權限
成本估算等級
$ — 低成本
| 主要驅動因素 | 控制方式 |
|---|---|
| Cloud Build 機型、建置分鐘與網路 | 快取依賴、平行化、避免重複建置 |
| Artifact Registry 儲存與跨區傳輸 | 清理舊 Artifact、部署到就近區域 |
| Cloud Deploy 活躍多目標 Pipeline 與底層服務 | 合併合理階段、追蹤實際部署頻率 |
| Staging/Canary 待命資源 | 依 SLO 保留最小但足夠的驗證容量 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
適合場景 & 不適合場景
| 適合 | 不適合 |
|---|---|
| 所有需要自動化部署的專案 | 極少更新的靜態網站 |
| 容器化應用 | 完全不用容器的 legacy 系統 |
| 多環境(dev/staging/prod) | 個人 side project |
| 需要合規審計的企業 | — |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
延伸閱讀:Cloud Build CI/CD
模式七:混合雲架構
場景描述
大型企業不可能一夜之間把所有系統搬上雲。混合雲架構讓地端資料中心和 GCP 並存:核心銀行系統留在地端,新功能放到雲端,兩邊透過安全的網路連線互通。PCA 考試指南在 Section 1.3 與 2.1 都列了和地端、多雲環境整合的項目。
架構圖
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 30, "nodeSpacing": 20}}}%%
  flowchart LR
  subgraph ONPREM["地端資料中心"]
    LEGACY["Legacy Apps/VM"]
    DB[("地端資料庫")]
    GDC["Google Distributed Cloud<br/>或既有 Kubernetes"]
    LEGACY --> DB
  end
  subgraph CONNECT["冗餘連線平面"]
    ROUTER["Cloud Router/BGP"]
    LINK["HA VPN 或<br/>Interconnect + HA VPN"]
  end
  subgraph GCLOUD["Google Cloud"]
    GKE["GKE"]
    RUN["Cloud Run<br/>新服務"]
    BQ["BigQuery<br/>分析"]
  end
  ONPREM <--> LINK <--> ROUTER <--> GCLOUD
  FLEET["GKE fleet 管理<br/>身分、政策、設定與觀測"] -. "一致管理" .-> GDC
  FLEET -. "一致管理" .-> GKE
  DNS["Cloud DNS<br/>Inbound/Outbound forwarding"] -. "混合名稱解析" .-> ONPREM
DNS -.-> GCLOUD 連上雲不等於完成混合雲:路由、DNS、身分、政策與觀測都要端到端設計。正式環境應建立冗餘連線與 BGP 路徑,並先演練單一 Tunnel、Router、Circuit 或站點故障。
使用的 GCP 服務
| 服務 | 角色 | 替代方案 |
|---|---|---|
| GKE fleet 管理 | 多叢集 / 混合雲容器管理 | — |
| Cloud VPN | 地端到 GCP 加密通道 | Cloud Interconnect(頻寬更大) |
| Cloud Interconnect | 專用線路(10/100 Gbps) | Partner Interconnect |
| Cloud DNS | 混合 DNS 解析 | — |
| Config Management | 統一政策管理 | — |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
關鍵設計決策
- Cloud VPN vs Interconnect:低成本、較低頻寬或快速導入可選 HA VPN;需要企業級高吞吐、可預測路徑與相應 SLA 時評估 Dedicated/Partner Interconnect。不能只用 10 Gbps 一條線切答案
- GKE 的 fleet 管理:統一管理地端和雲端的 Kubernetes 叢集,一致的安全政策和觀測能力。這組多叢集功能原本屬於 GKE Enterprise,官方在 2025-09-02 宣布併入標準 GKE,之後不再使用 GKE Enterprise 這個名稱;地端叢集用 Google Distributed Cloud(software only)建立,再註冊到 fleet
- 逐步遷移策略:先遷移無狀態服務,再遷移有狀態服務,最後遷移核心資料庫
- 網路設計:先盤點既有與未來 CIDR,避免地端、VPC、Pod 與 Service 範圍重疊;網段大小由容量模型決定,不是所有環境都固定使用
/16
成本估算等級
$$$$ — 高成本
Dedicated Interconnect 的月費,加上把地端叢集納入 GKE 管理的費用(Google Distributed Cloud software only 按叢集 vCPU 數計時收費),基礎成本是所有模式裡最高的。適合那種已經在地端投了一大筆的企業。
適合場景 & 不適合場景
| 適合 | 不適合 |
|---|---|
| 大型企業漸進式雲端遷移 | 全新系統(直接雲原生) |
| 法規要求資料留在地端 | 小型團隊 / 新創 |
| 已有地端 Kubernetes 投資 | 預算有限 |
| 多雲策略 | 沒有專職 DevOps 團隊 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
延伸閱讀:混合雲與連線方案
模式八:高可用多區域架構
場景描述
單一區域也可能發生長時間事故。當業務的可用性目標與失效範圍要求系統承受整個 Region 中斷時,才需要跨區域架構。真正的難點通常不在「多放一份運算」,而在資料寫入權威、非同步複寫延遲、容量、相依服務與可演練的切換流程。
架構圖
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 30, "nodeSpacing": 22}}}%%
  flowchart TB
  USERS["全球使用者"] --> LB["全域外部 Application Load Balancer<br/>Anycast、Health Check、Cloud Armor"]
  subgraph R1["Region A:主要寫入區"]
    APP1["Cloud Run 或 Regional MIG<br/>跨 Zone 容量"]
    CACHE1["區域型快取"]
    PRIMARY[("Cloud SQL HA<br/>Primary:唯一寫入點")]
    APP1 --> CACHE1
    APP1 -->|"Read/Write"| PRIMARY
  end
  subgraph R2["Region B:跨區應用容量"]
    APP2["Cloud Run 或 Regional MIG<br/>跨 Zone 容量"]
    CACHE2["區域型快取"]
    REPLICA[("Cloud SQL HA Read Replica<br/>DR 候選")]
    APP2 --> CACHE2
    APP2 -->|"Local Read"| REPLICA
  end
  LB -->|"健康流量"| APP1
  LB -->|"健康流量"| APP2
  APP2 -->|"Write:跨區到 Primary"| PRIMARY
  PRIMARY -->|"非同步複寫:可能有 Lag"| REPLICA
  HEALTH["SLO、複寫 Lag、容量與合成探測"] -. "監控/切換訊號" .-> LB
  HEALTH -.-> PRIMARY
HEALTH -.-> REPLICA 應用層可以 Active/Active,但 Cloud SQL 跨區副本仍是非同步唯讀。Region 故障時要先判斷複寫落後與資料損失風險,再提升副本並切換應用寫入端點;這不是負載平衡器能自動替資料庫完成的事。
使用的 GCP 服務
| 服務 | 角色 | 替代方案 |
|---|---|---|
| Global external Application Load Balancer | 跨區域流量分配(Anycast IP) | — |
| Managed Instance Group (MIG) | 自動擴縮容 VM 群組 | Cloud Run |
| Cloud SQL HA(區域內 zone 容錯)+ Cross-region Read Replica(跨區域唯讀副本) | 主要 + 跨區域唯讀副本 | Cloud Spanner(原生多區域) |
| Memorystore | 區域級快取 | — |
| Cloud Monitoring | 健康檢查、自動容錯切換 | — |
| Cloud Armor | DDoS 防護 | — |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
關鍵設計決策
- Global LB + Anycast IP:使用者連到同一個 IP,Google 網路自動路由到最近、最健康的後端
- 容量依故障情境計算:每個區域要跨 Zone,並確認失去一個區域後剩餘區域能承接預期流量;固定「每區 2 台」不代表容量足夠
- Cloud SQL Cross-region Replica:可分擔容許延遲的讀取;複寫是非同步,提升前要檢查 Lag,並預先演練連線端點與寫入切換
- Cloud Spanner 替代方案:如果工作負載需要跨區域強一致交易與水平擴展,評估 Spanner;先驗證資料模型、延遲與成本,不只看「多區域寫入」標籤
成本估算等級
$$$$ — 高成本
所有資源都得開兩份(兩個區域),再加上跨區域資料同步的流量費。
適合場景 & 不適合場景
| 適合 | 不適合 |
|---|---|
| 必須承受 Region 故障的關鍵服務 | 內部工具系統 |
| 電商平台、金融服務 | 成本敏感的新創 |
| 全球使用者 | 僅服務單一國家的小型應用 |
| 法規要求業務持續性 | MVP / 實驗性專案 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
模式九:災難復原架構
場景描述
高可用是「預防停機」,災難復原則是「停機後怎麼救回來」。就算你做了多區域高可用,還是得有一套災難復原計畫:萬一資料被誤刪、勒索軟體把資料庫加密了,要怎麼恢復?GCP 有不同等級的 DR 策略,從冷備份到熱待機都有。
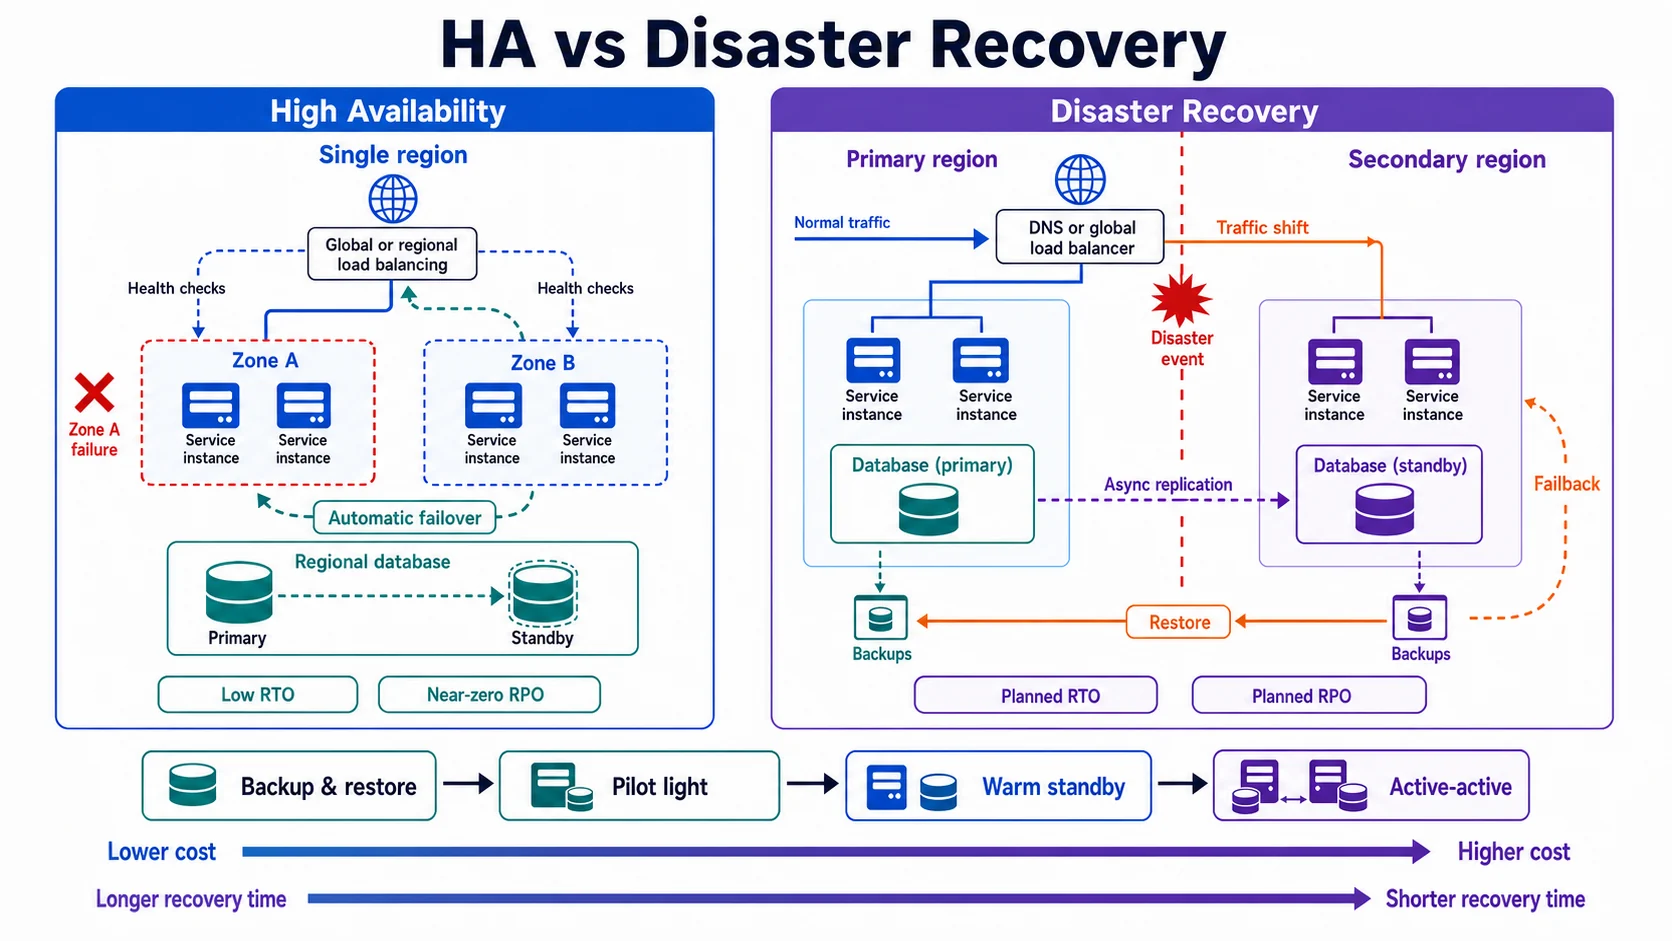
HA 解決日常元件或 Zone 故障,DR 解決整個 Region、資料損毀或操作事故。從備份還原、Pilot Light、Warm Standby 到多區域熱備,成本逐步提高,但 RTO/RPO 通常能縮短;兩者不能互相取代。
架構圖
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 30, "nodeSpacing": 20}}}%%
  flowchart LR
  subgraph PRIMARY["主要區域"]
    APP1["Cloud Run/GKE<br/>Active"]
    DB1[("Cloud SQL HA<br/>Primary")]
    OBJ1["Cloud Storage<br/>營運資料"]
    APP1 --> DB1
    APP1 --> OBJ1
  end
  subgraph RECOVERY["復原區域"]
    APP2["Cloud Run/GKE<br/>Pilot Light/Warm Standby"]
    DB2[("Cloud SQL HA<br/>Cross-region Replica")]
    OBJ2["Dual-region/複寫資料"]
  end
  DB1 -->|"非同步複寫"| DB2
  OBJ1 -->|"依位置策略複寫"| OBJ2
  DB1 --> BACKUP["Backup and DR/備份<br/>隔離、保留、不可變與還原測試"]
  IAC["Terraform/Artifact Registry<br/>版本化環境與應用"] --> APP2
  DETECT["事件指揮:確認失效範圍<br/>資料損毀、Region 故障或誤操作"] --> DECIDE{"Promote 副本<br/>或從乾淨備份 Restore?"}
  DB2 --> DECIDE
  BACKUP --> DECIDE
  DECIDE --> VALIDATE["驗證資料、相依服務與容量"]
  VALIDATE --> ROUTE["全域負載平衡/DNS<br/>切換使用者流量"]
ROUTE --> APP2 Region 故障可提升健康副本;誤刪或勒索軟體可能已複寫到副本,此時要從乾淨備份還原。兩條路都必須透過版本化基礎設施、明確權限、資料驗證與定期演練,才能把文件上的 RTO/RPO 變成實際能力。
使用的 GCP 服務
| 服務 | 角色 | 替代方案 |
|---|---|---|
| Cloud SQL Cross-region Replica | 資料庫跨區域複製 | Cloud Spanner |
| Cloud Storage (dual-region) | 物件儲存自動跨區域複製 | Multi-region |
| Cloud Run | 可縮至零或保留容量的 DR 待命服務 | GKE |
| Cloud DNS | DNS 容錯切換 | Global LB |
| Cloud Scheduler | 定期 DR 演練 | — |
| Backup and DR Service | 集中備份管理 | 自建快照排程 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
關鍵設計決策
- RTO/RPO 決定策略:先問業務「可以接受多久不能用」和「可以丟多少資料」,再選擇 DR 等級
- 依位置與復原需求選 Storage:Dual-region 可指定一對位置,Multi-region 提供較大的地理範圍;選擇要同時考慮資料落地、Turbo Replication、網路、取回與價格
- DR 演練:頻率由風險與變更速度決定;每次都量測實際 RTO/RPO、驗證資料與相依服務,並把缺口回寫 Runbook
- 待命容量是取捨:Cloud Run 可把最小執行個體設為 0 以降低運算閒置,但仍有資料與周邊成本,也要接受啟動、配額與剩餘區域容量風險
用 RTO/RPO 選 DR 等級
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 28, "nodeSpacing": 18}}}%%
  flowchart TB
  START["列出關鍵業務流程與相依服務"] --> RPO["RPO:最多可丟失多少已提交資料?"]
  RPO -->|"可接受一個備份週期"| BACKUP["備份還原<br/>最低待命成本、復原較慢"]
  RPO -->|"需要接近即時"| REPLICA["持續跨區複寫<br/>監控 Lag 與損毀傳播"]
  BACKUP --> RTO["RTO:最多可停機多久?"]
  REPLICA --> RTO
  RTO -->|"可等待重建與擴容"| PILOT["Pilot Light<br/>資料與核心元件常駐"]
  RTO -->|"只能短暫切換"| WARM["Warm Standby<br/>縮小版環境持續運行"]
  RTO -->|"幾乎不能中斷"| HOT["Hot/Active-Active<br/>完整容量與最高複雜度"]
  PILOT --> TEST["演練、量測、修正"]
  WARM --> TEST
  HOT --> TEST
TEST --> START 表格裡常見的「24 小時、10 分鐘、零資料損失」都不是產品保證。目標必須由業務核准,再用完整演練量到; RTO 越短、RPO 越小,持續運行的容量、複寫與操作複雜度通常越高。
成本估算等級
$$ ~ $$$$ — 視策略而定
備份還原只多花一點儲存費,熱待機則要養一整套雙倍的基礎設施。
適合場景 & 不適合場景
| 適合 | 不適合 |
|---|---|
| 任何生產環境(至少需要備份還原) | 開發 / 測試環境 |
| 金融、醫療等法規要求 | 可以接受長時間停機的系統 |
| 資料無法重新產生的系統 | 資料可以重新蒐集的系統 |
| 跨國企業 | 個人專案 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
模式十:AI 應用架構
場景描述
客服問答、文件摘要、企業搜尋和影像分析都可能用到 AI,但要先釐清資料來源、使用者權限與答案如何驗證。Google Cloud 提供模型 API、Agent 開發工具和搜尋元件,讓團隊不必從零訓練模型;真正上線前,仍要把檢索、評估與安全邊界設計清楚。
架構圖
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 30, "nodeSpacing": 18}}}%%
  flowchart TB
  DOCS["Cloud Storage/<br/>企業資料來源"] --> PARSE["解析、分段、版本<br/>與敏感資料分類"]
  PARSE --> ACL["附加 ACL<br/>與中繼資料"]
  ACL --> EMBED["Embedding 模型"]
  EMBED --> INDEX["Agent Search 或<br/>Vector Search<br/>(原 Vertex AI<br/>Vector Search)"]
INDEX -. "定期品質評估與增量更新" .-> PARSE 索引時保留文件版本、權限與中繼資料,才能在查詢階段做 ACL 過濾與來源引用;更新流程也要能刪除過期文件, 避免模型持續引用已撤回的內容。
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"sequence": {"actorMargin": 34, "messageMargin": 24}}}%%
  sequenceDiagram
  autonumber
  actor U as 使用者
  participant A as Cloud Run 應用
  participant G as Model Armor
  participant R as Agent Search/Vector Search
  participant M as Gemini 3.1
  participant D as 狀態/評估資料
  U->>A: 問題+身分
  A->>G: 檢查 Prompt injection、內容與敏感資料
  G-->>A: 允許或清理後的 Prompt
  A->>R: 查詢改寫+ACL Filter+Top-k
  R-->>A: 已授權片段+來源
  A->>M: 指令+問題+檢索內容
  M-->>A: 回答草稿
  A->>G: 檢查模型回應
  G-->>A: 安全回應+命中規則
  A->>D: 寫入 Firestore/BigQuery:工作階段、Token、延遲與回饋
A-->>U: 回答+引用來源,或無答案策略 RAG 不只是「向量搜尋接 LLM」:線上路徑還要驗證使用者、套用文件權限、檢查輸入與輸出,並在缺乏可靠來源時拒絕猜測。正式上線前要用代表性資料集量測正確性、延遲、安全與成本。
使用的 GCP 服務
| 服務 | 角色 | 替代方案 |
|---|---|---|
| Gemini 3.1 API | 文字生成、摘要、翻譯 | Model Garden 合作夥伴模型 |
| Agent Search(前身 Vertex AI Search) | 企業級搜尋(結合 LLM) | — |
| Vector Search | RAG 向量搜尋 | — |
| Cloud Run | AI 應用後端 | GKE |
| Firestore | 對話紀錄、使用者偏好 | Cloud SQL |
| BigQuery | AI 使用量分析 | — |
| Cloud Storage | 文件、圖片儲存 | — |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
關鍵設計決策
- 先用代管模型與評估選型:透過 Gemini Enterprise Agent Platform(原 Vertex AI)的 Gemini API 最快上手;只有代管模型與 Prompt/RAG 無法滿足需求時,才評估調校或自訂模型 Serving
- 企業搜尋改名了:原本的 Vertex AI Search 已更名為 Agent Search,現在隸屬 Gemini Enterprise Agent Platform。看舊文件或舊教材還是會碰到舊名,知道是同一個東西就好
- RAG 架構:Agent Search 適合整合式企業搜尋;需要自行控制索引、檢索與排序時可用 Vector Search。兩者都要保留 ACL、引用來源並量測檢索品質
- Firestore 存對話紀錄:NoSQL 文件模型天然適合存儲不固定結構的對話歷史
- 成本控制:設定 Gemini API 的每分鐘 token 上限,避免異常流量導致帳單暴增
- 安全防護:用 Model Armor 分別檢查 Prompt 與模型回應,並搭配最小權限、資料分類、稽核與人工升級流程;過濾器不能保證模型永遠正確
成本估算等級
$$ ~ $$$ — 視呼叫量而定
| 主要驅動因素 | 控制方式 |
|---|---|
| 模型輸入/輸出 Token、模型級別與快取 | 縮短上下文、Prompt cache、路由到合適模型 |
| Embedding、索引大小、部署節點與查詢量 | 增量索引、調整維度與副本、只取必要片段 |
| Cloud Run、Firestore 與 BigQuery | 限流、TTL、批次寫入與分區查詢 |
| Model Armor、評估與觀測 | 分層抽樣,安全關鍵路徑維持完整檢查 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
適合場景 & 不適合場景
| 適合 | 不適合 |
|---|---|
| 客服聊天機器人 | 不需要 AI 的 CRUD 系統 |
| 文件摘要、智慧搜尋 | 需要 100% 精確結果 |
| 內容生成、翻譯 | 高度機密資料(需額外考量) |
| 影像分析、分類 | 預算極為有限 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
延伸閱讀:GCP AI 與大數據服務
如何選擇架構模式?
接到新專案,不確定該選哪種架構模式?下面這張快速決策樹可以幫你定位:
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 28, "nodeSpacing": 18}}}%%
  flowchart TB
  START["先寫下主要使用者流程、資料形狀、延遲與 SLO"] --> KIND{"主要工作負載是什麼?"}
  KIND -->|"Web/API"| WEB{"需要獨立業務生命週期<br/>與團隊自治嗎?"}
  WEB -->|"還不需要"| P1["模式一:Web 三層"]
  WEB -->|"需要,且能承擔分散式維運"| P2["模式二:微服務"]
  KIND -->|"非同步副作用/自動化"| P3["模式三:事件驅動"]
  KIND -->|"資料分析"| FRESH{"資料新鮮度要求?"}
  FRESH -->|"分鐘到天"| P4["模式四:資料湖/批次"]
  FRESH -->|"秒到分鐘,需持續處理"| P5["模式五:即時串流"]
  KIND -->|"生成式 AI/企業搜尋"| P10["模式十:AI 應用"]
  START --> BOUNDARY{"有地端/其他雲部署邊界?"}
  BOUNDARY -->|"有"| P7["模式七:混合雲"]
  START --> DELIVERY["模式六:CI/CD<br/>所有可持續交付系統都要評估"]
  START --> FAILURE{"失效範圍與復原目標?"}
  FAILURE -->|"承受 Zone/Region 元件故障"| P8["模式八:高可用多區域"]
FAILURE -->|"資料損毀、誤刪或區域災難後復原"| P9["模式九:災難復原"] 先選一個主要工作負載模式,再獨立回答部署邊界、交付與失效問題。HA 與 DR 不是只有大系統才要問,但實作強度必須跟業務衝擊、RTO/RPO 與預算相稱。
重要提醒:實際專案通常是好幾種模式混著用。例如一個電商平台,可能同時用到模式二(微服務)+ 模式六(CI/CD)+ 模式八(高可用)+ 模式五(即時分析)。
模式不是十選一:用分層方式組合
流程圖暫時無法顯示。可先查看下方的流程與節點文字,或重新整理頁面後再試。
查看流程與節點文字
箭頭表示流程方向;方括號與引號內是節點名稱,可搭配下方圖解閱讀。
%%{init: {"flowchart": {"rankSpacing": 26, "nodeSpacing": 18}}}%%
  flowchart TB
  EXPERIENCE["使用者體驗與 API"] --> CORE["核心應用<br/>模式一三層,或模式二微服務"]
  CORE --> ASYNC["非同步整合<br/>模式三事件驅動"]
  ASYNC --> DATA["資料平台<br/>模式四資料湖+模式五串流"]
  DATA --> AI["可選 AI 能力<br/>模式十 RAG/Agent"]
  DELIVERY["模式六 CI/CD<br/>Artifact、政策、漸進部署"] -. "支撐每一層變更" .-> CORE
  DELIVERY -.-> ASYNC
  DELIVERY -.-> DATA
  DELIVERY -.-> AI
  RELIABILITY["模式八 HA+模式九 DR<br/>依 SLO、RTO、RPO 設計"] -. "保護端到端使用者旅程" .-> EXPERIENCE
  RELIABILITY -.-> CORE
  RELIABILITY -.-> DATA
  BOUNDARY["模式七混合雲<br/>只在部署/資料邊界存在時加入"] -. "限制與連接各層" .-> CORE
BOUNDARY -.-> DATA 產品模式回答「系統如何提供價值」,事件與資料模式回答「資料如何流動」,CI/CD、HA、DR 與混合雲則是橫切能力。先畫端到端使用者旅程,再逐層加入有明確需求與 Owner 的能力,避免把產品清單當架構。
ACE / PCA 考試與架構設計
架構設計是 Professional Cloud Architect (PCA) 考試指南的主軸(Section 1「設計與規劃雲端解決方案架構」約占 25%);Associate Cloud Engineer (ACE) 考試指南則以選型、部署與維運的工作項目為主。
ACE 考試重點
準備 ACE 時,架構相關的內容可以從這三件事練起:
- 服務選型:給定場景,選擇正確的 GCP 服務組合
- 成本優化:選擇最經濟的架構方案
- 基本高可用:區域 vs 多區域的選擇
題目關鍵字與架構模式的對照:
| 題目關鍵字 | 對應模式 | 重點服務 |
|---|---|---|
| 「無伺服器」「自動擴展」 | 模式一 / 三 | Cloud Run, Cloud Run functions |
| 「解耦」「非同步」 | 模式二 / 三 | Pub/Sub, Eventarc |
| 「即時分析」「串流」 | 模式五 | Dataflow, BigQuery Storage Write API (gRPC) |
| 「CI/CD」「自動部署」 | 模式六 | Cloud Build, Artifact Registry |
| 「地端」「混合」 | 模式七 | GKE fleet 管理, Cloud VPN |
| 「RTO」「RPO」 | 模式九 | Cross-region replica |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
PCA 考試重點
PCA 考試指南涵蓋得更深,備考時要練:
- 架構的 trade-off:為什麼選擇這個架構而不是另一個?
- 案例分析:給定一家公司的業務需求,設計完整架構
- 成本 vs 效能 vs 安全性的三角取捨
- 遷移策略:如何從地端遷移到雲端
備考建議:
- 熟悉每種模式的 GCP 服務組合
- 理解每種模式的適用場景和限制
- 練習在「成本」和「效能」之間做取捨
- 多做 Google Cloud 官方的架構案例練習
延伸閱讀:ACE 認證考試準備攻略 | 雲端遷移策略
總結
以下是 10 個架構模式的速查表:
| # | 模式 | 核心服務 | 成本 | 複雜度 |
|---|---|---|---|---|
| 1 | Web 三層架構 | Cloud Run + Cloud SQL | $$ | 低 |
| 2 | 微服務架構 | GKE + Cloud Run + Pub/Sub | $$$ | 高 |
| 3 | 事件驅動架構 | Cloud Run functions + Eventarc | $ | 中 |
| 4 | 資料湖架構 | Cloud Storage + Dataflow + BigQuery | $$$ | 中高 |
| 5 | 即時串流分析 | Pub/Sub + Dataflow + BigQuery | $$$$ | 高 |
| 6 | CI/CD Pipeline | Cloud Build + Artifact Registry | $ | 低 |
| 7 | 混合雲架構 | GKE fleet 管理 + Cloud VPN | $$$$ | 很高 |
| 8 | 高可用多區域 | Global LB + Cloud Run/MIG + 跨區資料策略 | $$$$ | 高 |
| 9 | 災難復原架構 | Cross-region Replica + Storage | $$ ~ $$$$ | 中高 |
| 10 | AI 應用架構 | Gemini 3.1 + Agent Search/Vector Search | $$ ~ $$$ | 中 |
表格超出欄寬時,可左右捲動;鍵盤可聚焦表格後用左右方向鍵查看。
提醒一下:
$到$$$$只表示相對成本與待命複雜度,不是報價。實際費用會隨區域、流量、容量、SLO 與折扣改變,規劃預算前請用 Google Cloud Pricing Calculator 代入自己的工作負載。
使用這些模式時,先確認三件事:
- 從簡單開始:先用模式一,真的卡住了再演進到更複雜的模式,別一開始就上微服務
- 成本意識:貴的架構不代表好,能撐住業務需求又不燒錢的才是對的
- 持續演進:架構很少一次到位,多半是隨著業務長大慢慢調出來的
這十種模式是討論架構的起點,不是套進專案就能直接上線的範本。選定候選方案後,還要用實際流量、資料需求、SLO、團隊維運能力和預算重新檢查;條件改變時,設計也可能跟著調整。
更多學習資源
讀完後,留一個學習紀錄
試著用自己的話說出一個重點,以及你會如何運用。實作文章請先核對結果與清理資源,再標記為讀完。
文章進度以你確認讀完的標記為準,可隨時取消。舊版造訪紀錄保留,但不計入讀完;這份自評不代表已掌握內容。
相關文章
您可能也會對這些文章感興趣
GKE Autopilot 適合你的工作負載嗎?先看幾個限制
Autopilot 代管節點,但計費、Pod 權限和擴容方式都有取捨。部署前先對照現有工作負載。
PCA 雲端架構師之旅 13 — 安全與成本
架構圖畫好了,權限與帳單也要交代清楚。從 IAM、網路邊界到主要服務費用,檢查方案能否落地。